October 15, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 12, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Caching klingt einfach, bis Sprache ins Spiel kommt. Herkömmliche Caches prüfen, ob zwei Anfragen identisch sind. Bei KI-Anwendungen geht es oft darum, ob zwei Anfragen dasselbe bedeuten. „Wie setze ich mein Passwort zurück?“ und „Ich habe mein Passwort vergessen – was nun?“ sind unterschiedliche Zeichenfolgen, könnten aber dieselbe Support-Antwort erfordern.
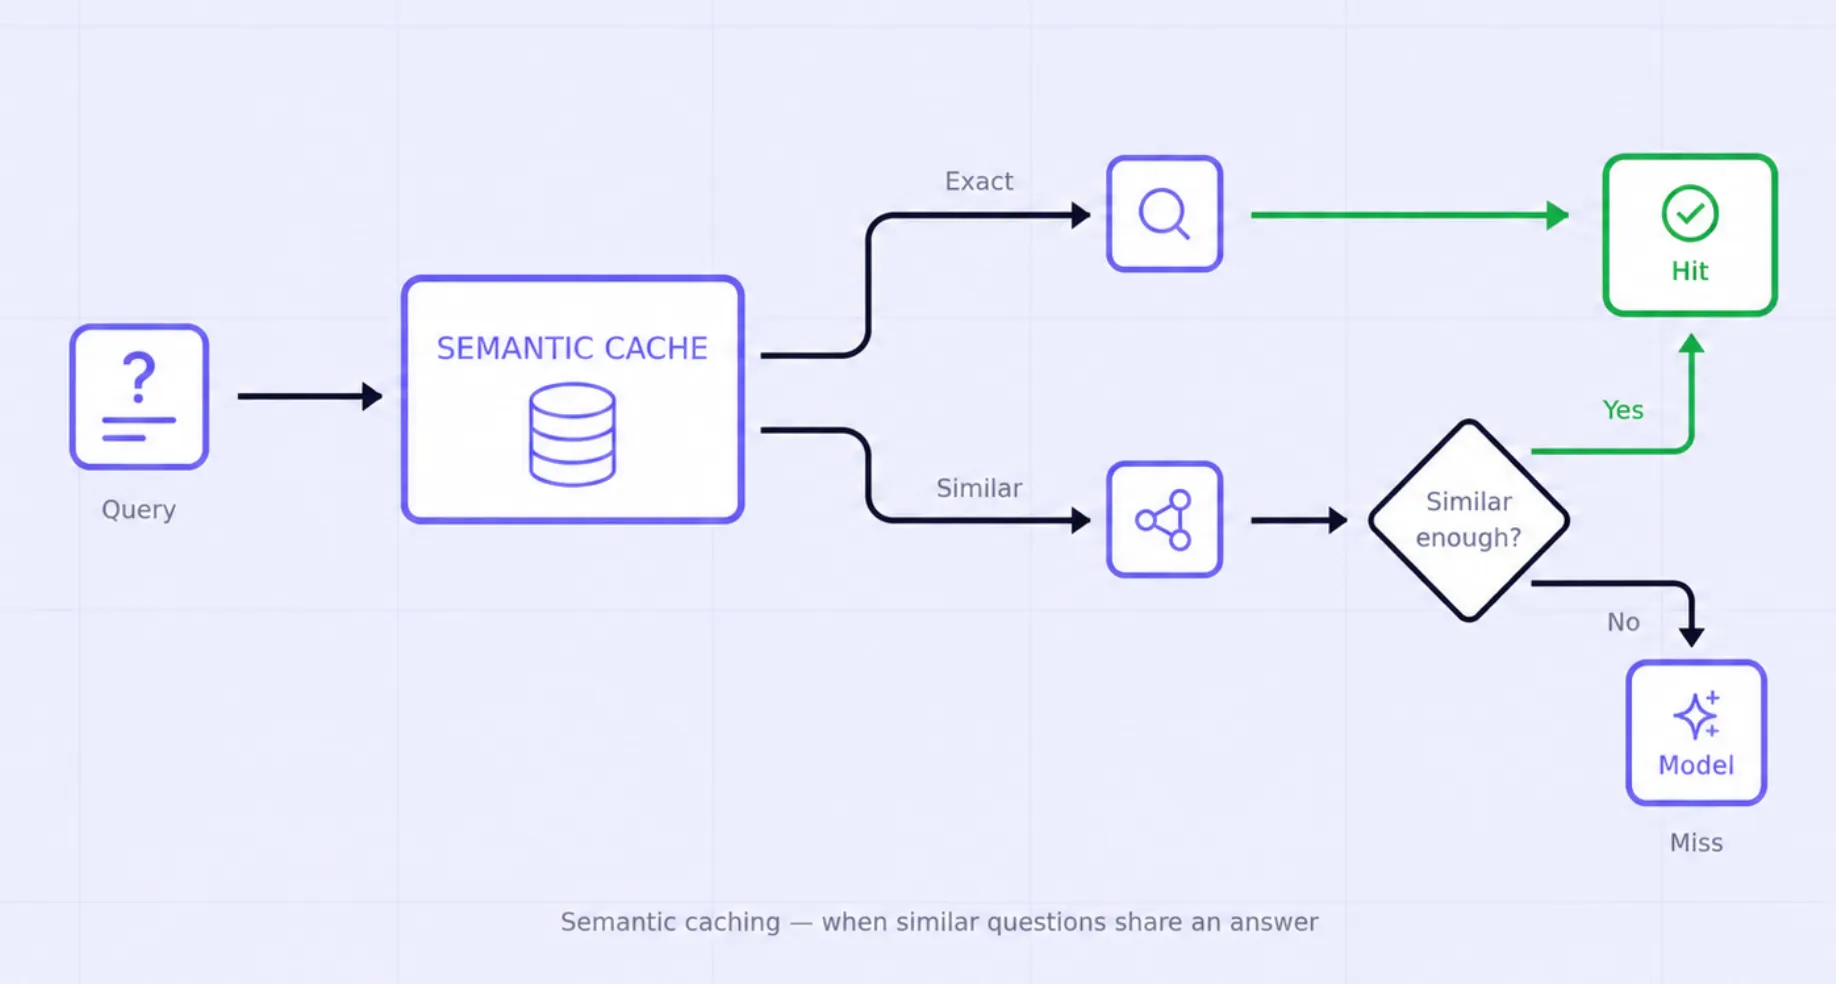
Das ist die Idee hinter semantischem Caching: Eine Anfrage einbetten, sie mit zuvor zwischengespeicherten Anfragen vergleichen und eine frühere Antwort zurückgeben, wenn die Ähnlichkeit hoch genug ist. Der Gewinn kann enorm sein, da ein Cache-Treffer den Modellaufruf komplett überflüssig macht. Die Gefahr ist ebenso offensichtlich: Eine fast identische Anfrage kann semantisch nah beieinander liegen und dennoch eine andere Antwort erfordern.
Dies sind drei konzeptionelle Caching-Aufgaben, nicht zwingend drei separat bereitgestellte Caches. In TrueFoundry ist semantisches Caching eine Obermenge des Exakt-Match-Cachings: Der semantische Modus kann auch exakte Treffer zurückgeben, sodass Sie nicht beide Gateway-Modi gleichzeitig ausführen müssen. Wählen Sie den Exakt-Match-Modus, wenn nur die Wiederverwendung identischer Anfragen akzeptabel ist; wählen Sie den semantischen Modus, wenn Sie die Wiederverwendung auf Basis von Ähnlichkeit explizit zulassen. Das Prompt-Caching des Anbieters kann bei Gateway-Fehlern mit beiden kombiniert werden, wobei der Modellanbieter die Anfrage weiterhin erhält.
new query
   ↓
embedding
   ↓
nearest cached queries
   ↓
similarity ≥ threshold?
   ├─ no → call model → cache response
   └─ yes → verify cache scope + exact state match → return cached response
Der entscheidende Schritt, der in Diagrammen oft übersprungen wird: die vollständige Äquivalenzgrenze verifizieren. In TrueFoundry bezieht sich die semantische Ähnlichkeit nur auf die letzte Nachricht; die restlichen Anfrageparameter müssen exakt per Hash übereinstimmen, und Cache-Einträge werden automatisch auf den aufrufenden Benutzer oder das virtuelle Konto begrenzt. Anwendungszustände, die nicht in die Anfrage einfließen – zum Beispiel ein nachgelagerter Mandant hinter einem gemeinsam genutzten virtuellen Konto, eine Berechtigungsprüfung, eine Revisionsprüfung oder ein externer Kontostatus –, können den Cache nicht beeinflussen, es sei denn, Sie kodieren dies in der Anfrage, im Namespace, in der Versionsgrenze oder in der Richtlinie zur Cache-Berechtigung.
Unterteilen Sie Caches überall dort, wo die korrekte Antwort über eine Grenze hinweg variieren kann. In TrueFoundry gibt es zwei Ebenen: Die Isolierung von Benutzern/virtuellen Konten erfolgt automatisch, und ein optionaler Namespace sorgt für eine weitere Unterteilung innerhalb dieses Bereichs. Die zweite Ebene ist wichtig, wenn ein virtuelles Konto mehrere nachgelagerte Mandanten, Endbenutzer, Umgebungen, Prompt-Versionen oder andere Kontexte bedient, die niemals zwischengespeicherte Antworten teilen dürfen. Ein gemeinsamer Cache ist nur dann sinnvoll, wenn die zugrunde liegende Antwort tatsächlich identisch ist.
Eine zwischengespeicherte Antwort auf die Frage „Wie konfiguriere ich SSO?“ kann tagelang korrekt bleiben. „Ist Dienst X derzeit beeinträchtigt?“ kann schon nach Minuten falsch sein. Nutzen Sie die Aktualität der Domäne, um TTLs festzulegen, und invalidieren Sie aggressiv, sobald sich die zugrunde liegende Richtlinie oder der Inhalt ändert.
Messen Sie Trefferquote, eingesparte Kosten, End-to-End-Latenz, Cache-Lookup-Overhead, Fehlmeldungen und Cache-Fehler. Eine hohe Trefferquote ist nicht automatisch gut; ein zu weit gefasster Schwellenwert kann eine beeindruckende Kennzahl erzeugen, während die Korrektheit der Antworten leidet.
Die zentrale Frage beim semantischen Caching lautet nicht: „Welchen Kosinus-Schwellenwert sollten wir verwenden?“, sondern: „Welche Anfragen dürfen sich eine Antwort teilen?“ Diese Äquivalenzklasse kann enger gefasst sein als die semantische Ähnlichkeit. Zwei Support-Anfragen können dasselbe bedeuten, aber unterschiedliche Antworten erfordern, weil die Nutzer verschiedenen Tarifen, Regionen, Mandanten oder Produktversionen angehören. Der Cache sollte diese Grenzen berücksichtigen, bevor die Ähnlichkeit überhaupt geprüft wird.
Ein praktischer Ansatz ist die Trennung von semantischer Identität und Zustandsidentität. Die semantische Identität umfasst den Teil, der in der Formulierung variieren darf. Die Zustandsidentität umfasst alles, was identisch sein muss, damit eine Wiederverwendung sicher ist. TrueFoundry implementiert dies konkret: Die letzte Nachricht wird eingebettet, während Modell, vorherige Nachrichten, Temperatur und die übrigen Anfrageparameter gehasht werden und exakt übereinstimmen müssen. Zudem werden Einträge automatisch nach Nutzer oder virtuellem Konto isoliert. Was das System nicht ableiten kann, ist der Anwendungszustand, der nicht in der Anfrage enthalten ist. Wenn Gebietsschema, nachgelagerter Mandant, Berechtigung, Dokumentenrevision, Tool-Verfügbarkeit oder Richtlinienversion die Antwort ändern, müssen Sie diesen Zustand in der Anfrage oder im Namespace abbilden, den Cache versionieren oder die Route als nicht wiederverwendbar markieren.
Es gibt keinen universell „guten“ Ähnlichkeitswert. TrueFoundry nennt 0.9 als Ausgangspunkt, mit strengeren Schwellenwerten für hochpräzise Anwendungsfälle. Dies ist jedoch eher ein Standardwert für den Betrieb als eine Garantie für Korrektheit. Ein FAQ für den Kundensupport verträgt möglicherweise ein breiteres semantisches Matching als ein Workflow für Preise, Berechtigungen oder Richtlinien. Noch wichtiger ist: Kein Schwellenwert kann eine fehlende Zustandsabgrenzung ausgleichen. Zwei Fragen können in der Einbettung nah beieinander liegen, sich aber in einer Entität, einem Datum, einem Mandanten, einer Berechtigung oder einer Richtlinienversion unterscheiden, die die Antwort ändern. Stimmen Sie den Schwellenwert erst dann anhand eines markierten Datensatzes von Paaren (gleiche Antwort vs. unterschiedliche Antwort) ab, nachdem diese strukturellen Grenzen definiert wurden.
Verfolgen Sie falsch-positive Ergebnisse getrennt von Fehlversuchen. Ein Fehlversuch kostet Latenz und Token; ein falsch-positives Ergebnis kann eine falsche Antwort liefern, ohne das Modell überhaupt aufzurufen. Diese Asymmetrie bedeutet in der Regel, dass Produktionsschwellenwerte zuerst auf Präzision ausgerichtet sein sollten und erst dann erweitert werden dürfen, wenn Prüfdaten zeigen, dass die zusätzlichen Treffer tatsächlich austauschbar sind.
Wenn eine Antwort von sich ändernden Dokumenten oder Tools abhängt, verknüpfen Sie die Cache-Gültigkeit mit der Version der Beweisgrundlage. Eine Knowledge-Base-Deployment-ID, Richtlinienrevision, Katalogversion oder ein Datenaktualitäts-Zeitstempel können in der Anfrage, einem expliziten Namespace oder einer anderen Invalidierungs-/Versionsgrenze abgebildet werden. Dies verhindert einen subtilen Fehler, bei dem eine perfekt passende Frage eine Antwort liefert, die auf dem Wissensstand von gestern basiert, obwohl sich die zugrunde liegende Quelle geändert hat.
Seien Sie bei agentenbasierten Systemen besonders vorsichtig mit zwischengespeicherten Zwischenentscheidungen. Die Wiederverwendung von „Rufe Tool X mit Argumenten Y auf“ ist folgenschwerer als die Wiederverwendung einer FAQ-Antwort. In den meisten Fällen gehört semantisches Response-Caching zu stabilen Informationsschritten, während Aktionen weiterhin über aktuelle Richtlinien und Autorisierungen laufen sollten.
Semantisches Caching erfordert die Generierung von Einbettungen sowie Cache-/Vektor-Lookups, unabhängig davon, ob diese Arbeit lokal gehostet oder für Sie verwaltet wird. Dieser Overhead ist im Vergleich zu einer teuren Generierung oft gering, aber nicht kostenlos. Messen Sie das Gesamtergebnis: Cache-Lookup-Latenz, Kosten für die Einbettungsinfrastruktur oder den Anbieter, Trefferquote, eingesparte Generierungskosten und Auswirkungen auf die Korrektheit. TrueFoundry zeigt die durch Cache-Lookups verursachte durchschnittliche Latenz in der Ansicht „Cache Metrics“ an; nutzen Sie diese gemessenen Werte, anstatt davon auszugehen, dass der Cache für jede Route automatisch schneller ist. Ein kostengünstiges Modell mit kurzen Antworten rechtfertigt semantisches Caching möglicherweise nicht, selbst wenn die Trefferquote attraktiv aussieht.
TrueFoundrys AI Gateway Caching unterstützt sowohl Exact-Match- als auch semantisches Response-Caching. Die aktuelle Dokumentation unterscheidet dies vom Prompt-Caching der Anbieter: Gateway-Treffer geben die gespeicherte Antwort zurück, ohne das Modell aufzurufen, während beim Prompt-Caching der Anbieter weiterhin eine Vervollständigung generiert wird.
Für semantisches Caching dokumentiert TrueFoundry eine auf Embeddings basierende Ähnlichkeitsprüfung der letzten Nachricht, während die übrigen Anfrageparameter gehasht werden; diese nicht-semantischen Parameter müssen exakt übereinstimmen. Die Cache-Isolierung erfolgt ebenfalls auf zwei Ebenen: Einträge werden automatisch auf den aufrufenden Benutzer oder das virtuelle Konto begrenzt, und ein optionaler, benutzerdefinierter Namespace kann innerhalb dieses Bereichs eine weitere Unterteilung vornehmen – zum Beispiel, wenn ein virtuelles Konto mehrere nachgelagerte Mandanten oder Umgebungen repräsentiert. Response-Header geben den Cache-Status, die ursprüngliche Trace-ID des Cache-Eintrags und bei semantischen Treffern den Ähnlichkeitswert an. Diese Details sind wichtig, da sie das Cache-Verhalten transparent und nachvollziehbar machen, anstatt es als unsichtbare Optimierung zu belassen.
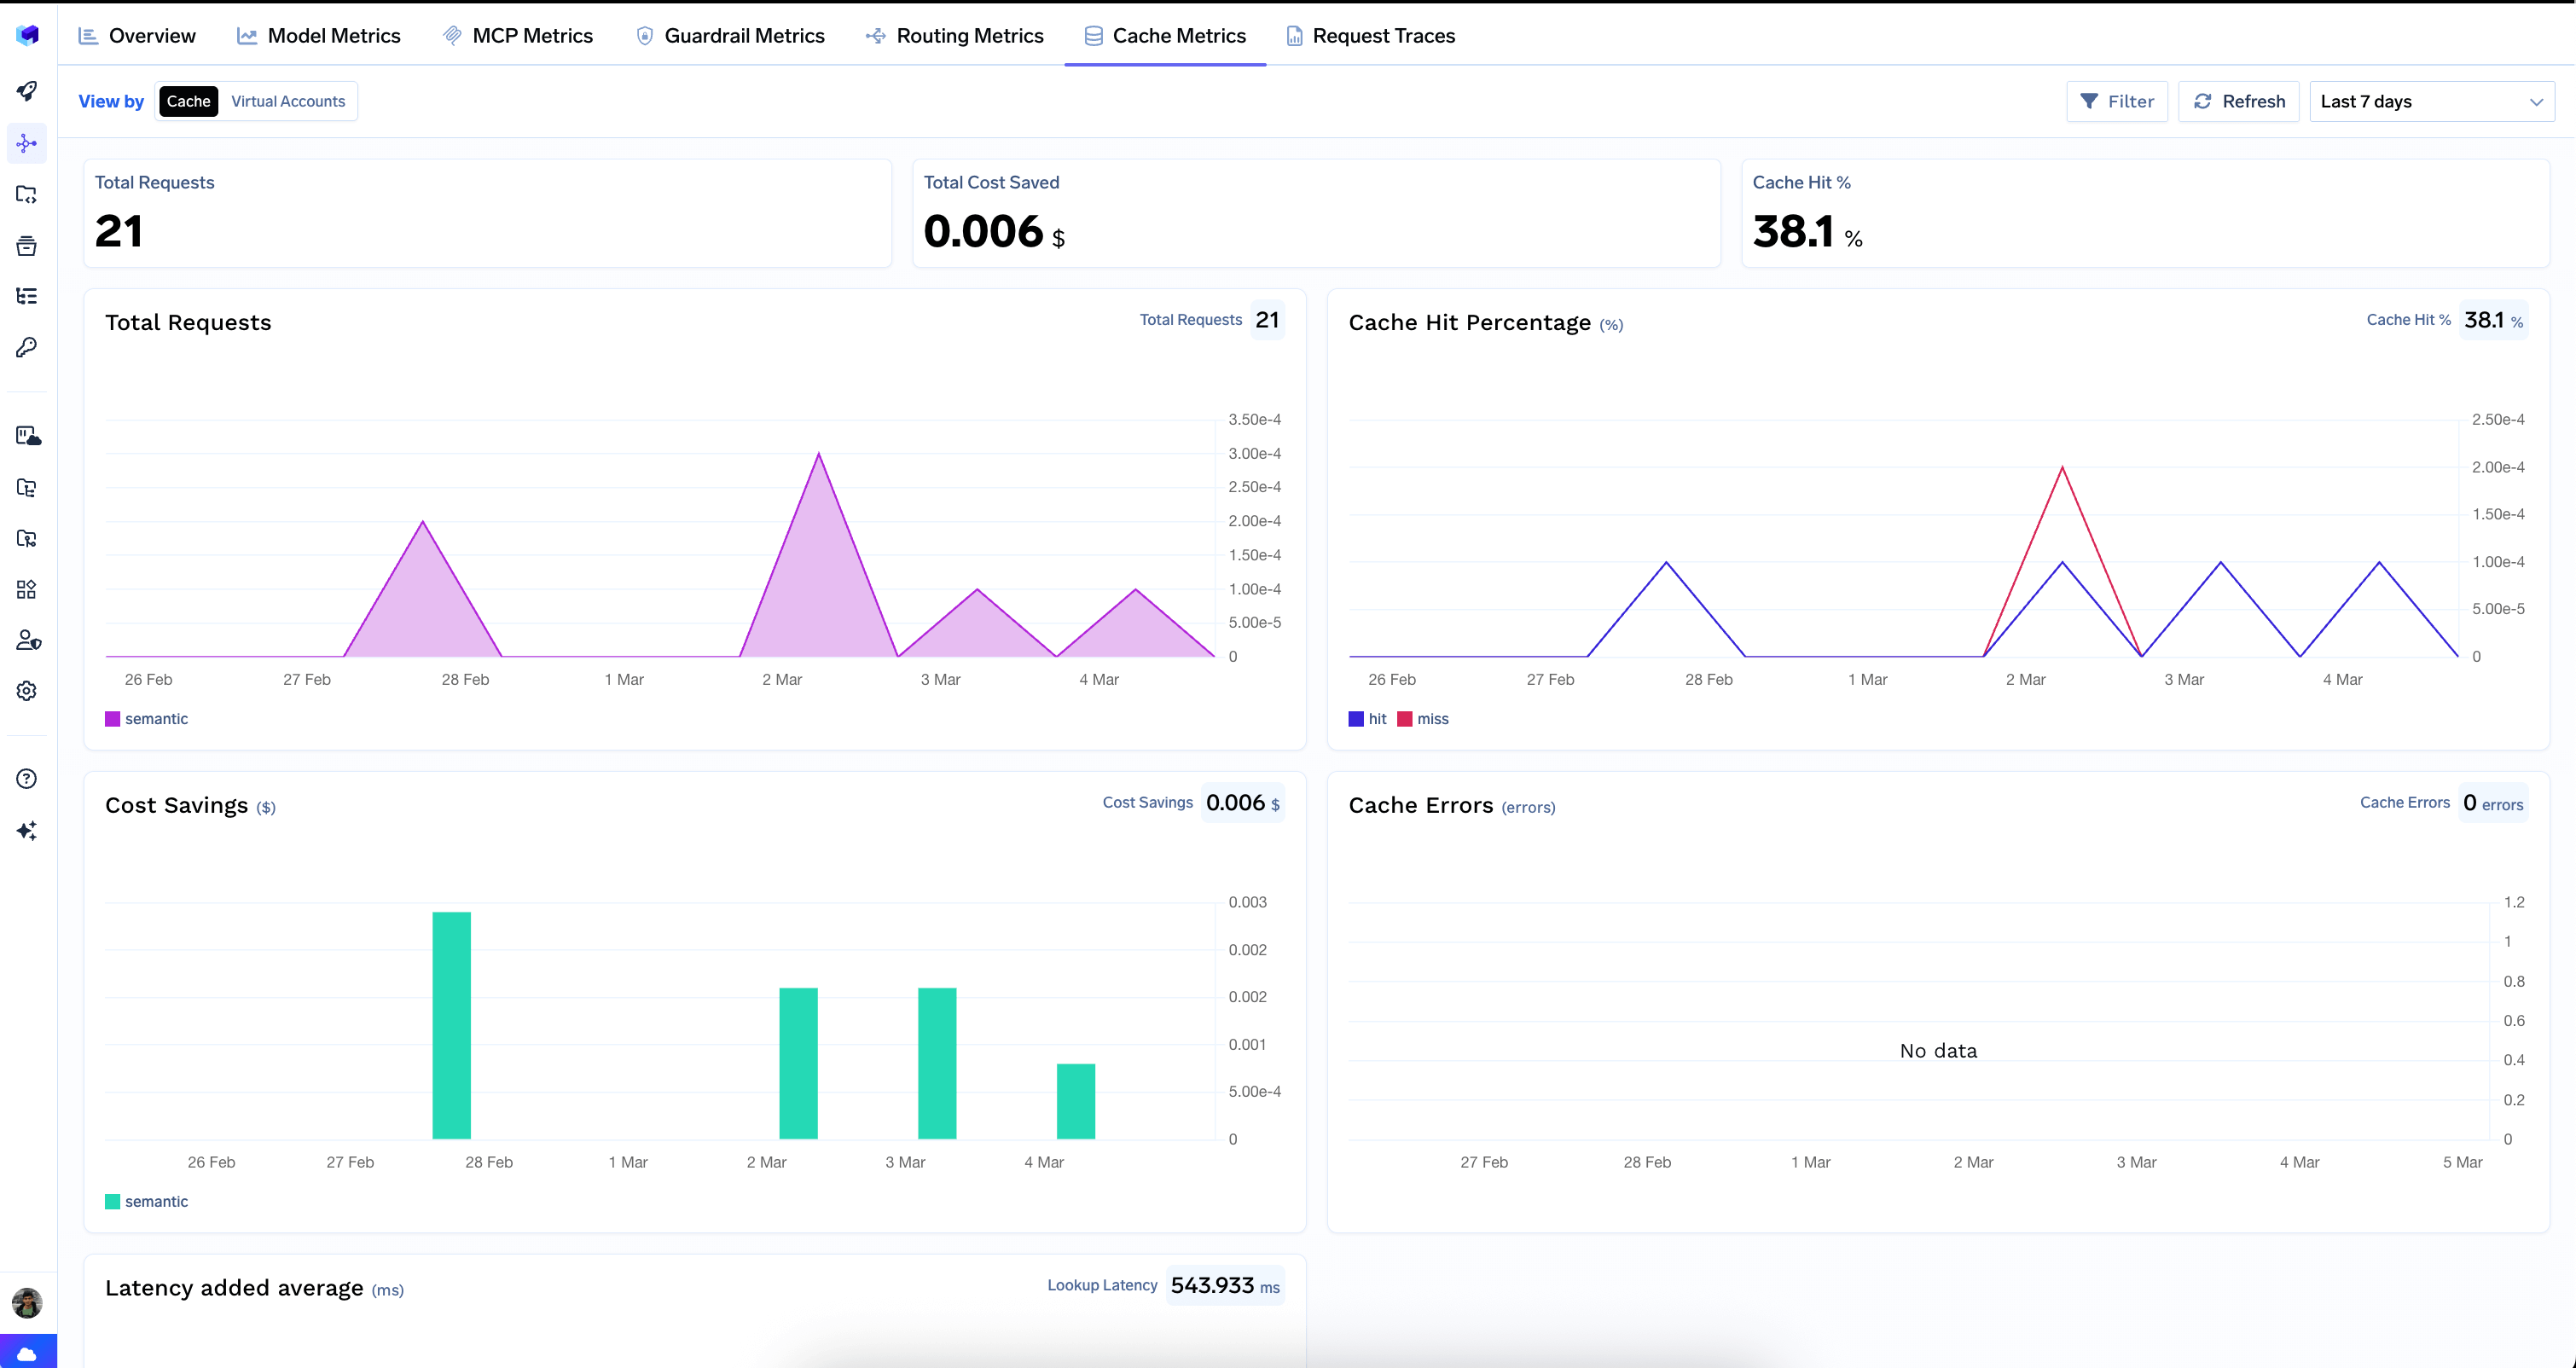
Das Metrics Dashboard dokumentiert eine Ansicht für Cache-Metriken mit der Gesamtzahl der Cache-Anfragen, der Cache-Trefferquote, den insgesamt eingesparten Kosten, Cache-Fehlern und der durchschnittlichen Latenz durch Cache-Lookups. Dies ist die richtige operative Feedbackschleife, um zu entscheiden, ob Caching wirtschaftlich sinnvoll ist. Die Korrektheit erfordert dennoch ein anwendungsseitiges Signal – zum Beispiel durch Überprüfung von Fehl-Treffern oder eine routenspezifische Bewertung der Antwortqualität –, da Trefferquote und Kosteneinsparungen allein nicht aussagen, ob zwei Anfragen dieselbe Antwort hätten teilen dürfen.
Ein Implementierungsdetail ist deployment-spezifisch. TrueFoundry SaaS verwaltet die Caching-Infrastruktur und dokumentiert derzeit OpenAI text-embedding-3-small als Standardmodell für semantische Cache-Embeddings. Selbst gehostete Deployments können das Embedding-Modell konfigurieren, und der dokumentierte On-Premise-Cache-Speicher ist Redis oder ein Redis-kompatibler Speicher wie Valkey. Dies ist wichtig für Performance- und Datengrenzen-Prüfungen: Der Pfad für semantisches Caching umfasst sowohl den Speicher als auch das Embedding-Modell. Bewerten Sie daher, wo die einzelnen Komponenten in Ihrem tatsächlichen Deployment ausgeführt werden.
Semantisches Caching ist ungeeignet für hochgradig personalisierte Antworten, sich schnell ändernde Daten, stochastische kreative Aufgaben oder folgenschwere Entscheidungen, bei denen eine annähernde Übereinstimmung inakzeptabel ist. Exact-Match-Caching vermeidet semantische Fehl-Treffer, ist aber nur dann angemessen, wenn die vollständige Anfrage identisch ist und die zwischengespeicherte Antwort unter den aktuellen Bedingungen hinsichtlich Aktualität, Autorisierung, Nachweisen und Richtlinienvorgaben weiterhin gültig bleibt.
Caching sollte ein expliziter Produktvertrag sein: Diese Anfrageklassen sind unter diesen Zustandsgrenzen für diese Dauer wiederverwendbar. Alles andere ist ein beabsichtigter Cache-Miss.
Semantische Ähnlichkeit ist keine Garantie für Korrektheit. Eine exakte Übereinstimmung ist keine Garantie für Aktualität. TrueFoundry isoliert Cache-Einträge automatisch nach Benutzer oder virtuellem Konto; benutzerdefinierte Namespaces ermöglichen eine weitere Unterteilung innerhalb dieses Bereichs. Die Cache-Berechtigung, Grenzen des Anwendungszustands, Regeln für die Invalidierung/Versionierung sowie die Überprüfung auf Fehl-Treffer bleiben Entscheidungen der Anwendung.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet