


November 13, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Ein Judge ist ein Modell, dem drei Dinge übergeben werden: eine zu bewertende Ausgabe, eine Rubrik, die beschreibt, was „gut“ bedeutet, und die Anweisung, ein maschinenlesbares Urteil zurückzugeben — Bestanden/Fehlgeschlagen, einen Score oder eine Präferenz zwischen zwei Kandidaten.
Es existiert, weil die Alternative nicht skaliert. Exakte Vergleichsmetriken funktionieren, wenn es eine einzige richtige Antwort gibt; sie sind wertlos für eine Support-Antwort, bei der fünf verschiedene Antworten korrekt sind. Menschen bewerten diese gut, aber langsam. Ein Judge ordnet sich dazwischen ein: schlechter als ein sorgfältiger Mensch, weit besser als ein bloßer String-Vergleich, schnell genug für Tausende von Stichproben. Betrachten Sie ihn als günstiges, verrauschtes, aber mit menschlicher Bewertung korrelierendes Substitut.
Der häufigste Fehler besteht darin, Offline-Evaluierung und Online-Gating als dieselbe Sache mit zwei verschiedenen Deployment-Zielen zu behandeln.
Die Zeile zum Fehlermodus sollte man sich verinnerlichen. Offline kostet ein falscher Score eine Entscheidung, die Sie im nächsten Sprint korrigieren; online bedeutet es, dass ein Nutzer vor einer Fehlermeldung steht. Stimmen Sie einen Online-Judge daher auf Präzision ab, selbst auf Kosten des Recalls. Das blinde Übernehmen einer Rubrik über beide Modi hinweg führt dazu, dass Teams mehrere Prozent ihres regulären Datenverkehrs blockieren.
Judges eignen sich hervorragend für Kriterien, die beschreibbar, aber nicht berechenbar sind — zum Beispiel, ob eine Antwort im abgerufenen Kontext fundiert ist oder ob der Tonfall für ein klinisches Umfeld angemessen ist. Sie können die Regel in einem Absatz formulieren, aber nicht als Regex. Sie scheitern jedoch auf drei Arten.
Position Bias (Positionsverzerrung). Werden zwei Kandidaten vorgelegt, bevorzugen Judges eine bestimmte Position; kehrt man die Reihenfolge um, kippt ein erheblicher Teil der Urteile. Die Abhilfe besteht darin, jedes Paar zweimal mit vertauschten Positionen zu bewerten und nur Übereinstimmungen zu zählen, was die Kosten verdoppelt.
Verbosity Bias (Längenverzerrung). Längere Antworten erhalten höhere Bewertungen, nahezu unabhängig davon, ob die zusätzlichen Wörter einen Mehrwert bieten. Dies treibt Produktions-Prompts schleichend in Richtung künstlicher Aufblähung: Sie optimieren gegen den Judge, der Judge belohnt Länge, die Token-Rechnung steigt, und niemand stellt den Zusammenhang her.
Self-preference (Eigenpräferenz). Ein Modell bewertet Texte höher, die seinen eigenen Generierungen ähneln. Wenn GPT die Ausgaben von GPT bewertet, fällt der Score zu optimistisch aus — das stärkste Argument für einen Judge aus einer anderen Modellfamilie als das zu testende Modell.
Judges sind zudem auf kontinuierlichen Skalen schlecht kalibriert: Fragt man nach einer Bewertung von 1 bis 10, clustern die Ergebnisse fast immer bei 7 und 8. Ein binäres Bestanden/Fehlgeschlagen anhand eines präzisen Kriteriums ist deutlich verlässlicher. Zudem kann ein Judge keine Fakten überprüfen, die ihm nicht vorliegen — ohne Referenzmaterial erhalten Sie lediglich seine Prior-Annahmen, keine Faktenprüfung.
Wählen Sie eine andere Modellfamilie als die des zu testenden Modells, da Eigenpräferenz real und leicht zu vermeiden ist. Wählen Sie das Modell kleiner als gedacht, da Jurieren einer Klassifizierung anhand eines langen Prompts entspricht und kein komplexes Reasoning erfordert. Verwenden Sie gepinnte statt dynamischer Versionen, da ein sich automatisch aktualisierender Provider-Alias Ihre Qualitätsmesslatte ohne Codeänderung verschiebt. Und achten Sie auf eine niedrigere p99-Latenz als das abgesicherte System, da der Judge sonst zum Engpass Ihrer Gesamtlatenz wird.
Nun zur Mathematik. Ein Inline-Judge entspricht einem zweiten Inferenzaufruf; prüft man sowohl Prompt als auch Antwort, sind es zwei. Das ist kein Overhead, den man wegingenieuren kann. Die Frage lautet also, welcher Teil des Datenverkehrs geprüft wird:
Wenn Sie eine Regel als Code ausdrücken können, drücken Sie sie als Code aus.
Die Offline-Rubrik wird in den Request-Pfad übernommen. Eine Rubrik mit zehn Dimensionen, die in einem nächtlichen Testlauf funktioniert, wird in der Produktion zu einem langsamen Blockadefaktor mit hoher Varianz. Online-Rubriken sollten aus einem einzigen Kriterium bestehen, binär sein und so präzise formuliert werden, dass ein kleines Modell sie konsistent beantworten kann.
Der Judge wird selbst nie evaluiert. Es handelt sich um ein Modell in Produktion ohne eigene Evaluierung. Labeln Sie einige Hundert reale Beispiele manuell und analysieren Sie Präzision und Recall getrennt. Wenn Sie die Falsch-Positiv-Rate nicht nennen können, wissen Sie nicht, welcher Anteil der Nutzer fälschlicherweise blockiert wird.
Es wird direkt auf Blockieren umgestellt. Ein Judge mit 90 % Genauigkeit blockiert an dem Tag, an dem Sie ihn aktivieren, eine von zehn guten Antworten. Führen Sie erst ein Audit durch, werten Sie eine Woche lang Traces aus und schalten Sie erst dann auf Durchsetzung um.
Gestreamte Antworten werden vergessen. Wenn Token an den Browser gestreamt werden, hat ein Output-Judge nichts zu bewerten, bis der Stream endet. Die meisten Gateways, einschließlich TrueFoundry, überspringen Output-Guardrails bei Streaming-Requests.
TrueFoundry bietet kein eigenes Eval-Produkt an. Keine Eval-Oberfläche, keine Datensätze, kein Experiment-Tracking, kein Scoring-UI. Offline-Evaluierung gehört auf dafür gebaute Plattformen. Die Rolle von TrueFoundry besteht darin, Traces über OpenTelemetry zu exportieren — Traces, keine OTEL-Metriken. Für bewertete Datensätze und Leaderboards nutzen Sie Braintrust, Arize oder ein Äquivalent und richten den Exporter darauf aus.
TrueFoundry implementiert die Online-Hälfte: Einen Judge, der als Guardrail im Request-Pfad läuft und dessen Urteil, Latenz sowie Token-Verbrauch auf demselben Trace wie der abgesicherte Request erfasst werden.

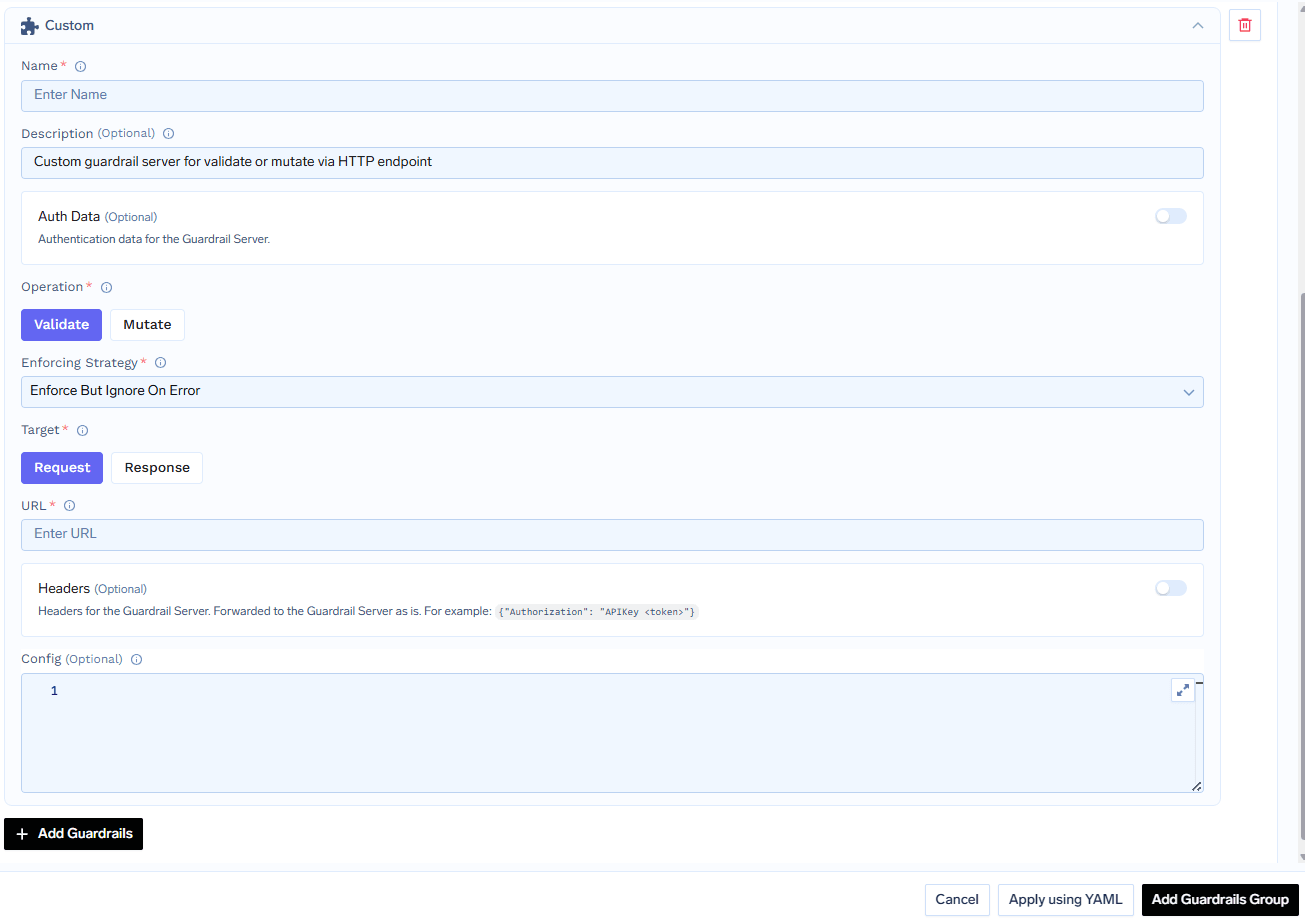
Jeder nachfolgend genannte Judge ist ein kleiner Microservice, den Sie bereitstellen und den das Gateway als Rail über den Custom-Guardrail-Vertrag aufruft. Dieser Vertrag hat eine wesentliche Regel: HTTP 2xx bedeutet, dass die Guardrail vollständig ausgeführt wurde; die Richtlinienentscheidung befindet sich ausschließlich im JSON-Body. Die Dokumentation warnt davor, dass ein als HTTP 400 signalisiertes „Blockiert“ als Laufzeitfehler interpretiert und durchgewunken werden könnte. Geben Sie daher 2xx mit verdict: false zurück.
NeMo läuft als FastAPI-Wrapper auf TrueFoundry — keine nativen NeMo SDK-Aufrufe vom Gateway, keine Änderungen am Client-SDK Ihrer Anwendung. Intern nutzt es ein kleines Judge-LLM zusammen mit Colang, einer domänenspezifischen Sprache, um Prompts und Antworten über die Rails self_check_input und self_check_output zu evaluieren. Die Rubrik befindet sich im Colang-Bundle, in dem config/prompts.yml Few-Shot-Beispiele enthält, die in v1 Rollenspiele im DAN-Stil, „Ignoriere vorherige Anweisungen“, System-Prompt-Extraktionen und Policy-Bypass-Muster erkennen.
Das betrieblich entscheidende Detail: Das Judge-LLM ruft wieder über dasselbe TrueFoundry Gateway auf. Die .env-Datei des Wrappers enthält TFY_BASE_URL, TFY_API_KEY und JUDGE_MODEL — das Beispiel in der Dokumentation verwendet openai-main/gpt-4o-mini. Da die Inferenz des Judges regulärer Gateway-Datenverkehr ist, landen Token, Kosten und Latenz in denselben Dashboards wie alles andere. So behalten Sie die Guardrail-Kosten direkt im Blick. Der Wechsel des Judges erfolgt in einer Zeile: JUDGE_MODEL anpassen (z. B. auf openai-main/gpt-4o) und neu deployen.
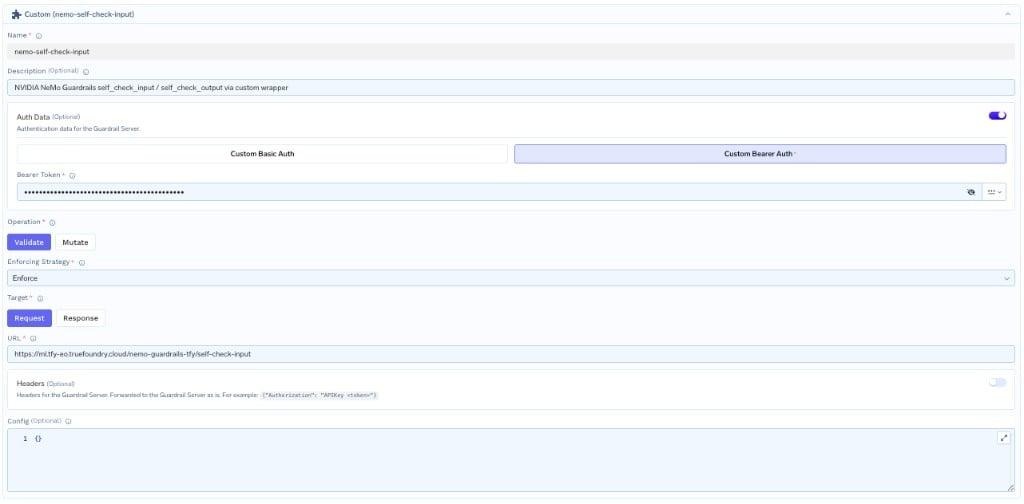
Registrieren Sie zwei Custom Guardrail Configs, beides Validate — Selektoren nemo-self-check/nemo-self-check-input und .../nemo-self-check-output — wobei Enforce But Ignore On Error empfohlen wird. Das Format des Urteils ist minimal: HTTP 200 plus {"verdict": bool, "message": Optional[str]}; ein tatsächlicher Systemfehler wird als 5xx übermittelt.
Das Gateway führt den Input-Rail-Aufruf und den Modellaufruf parallel aus, sodass der Judge nicht zur Time-to-First-Token beiträgt; bei einer Blockierung wird der laufende Modellaufruf abgebrochen. Die Output-Rail läuft zwingend sequentiell.
Die Dokumentation benennt die Kosten transparent. Unter den bekannten Einschränkungen heißt es: Jeder abgesicherte Request erfordert ein bis zwei zusätzliche LLM-Aufrufe, einen pro Richtung. Zudem wird darauf hingewiesen, dass es keine streaming-fähigen Guardrails gibt, da der Vertrag gepuffert arbeitet und der In-Memory-Status pro Replikat gilt.
Patronus kommt einer schlüsselfertigen Judge-Lösung im Katalog am nächsten und ist Validate-only — die Operation ist wortwörtlich "validate", und laut Dokumentation kann sie keine Mutationen durchführen.
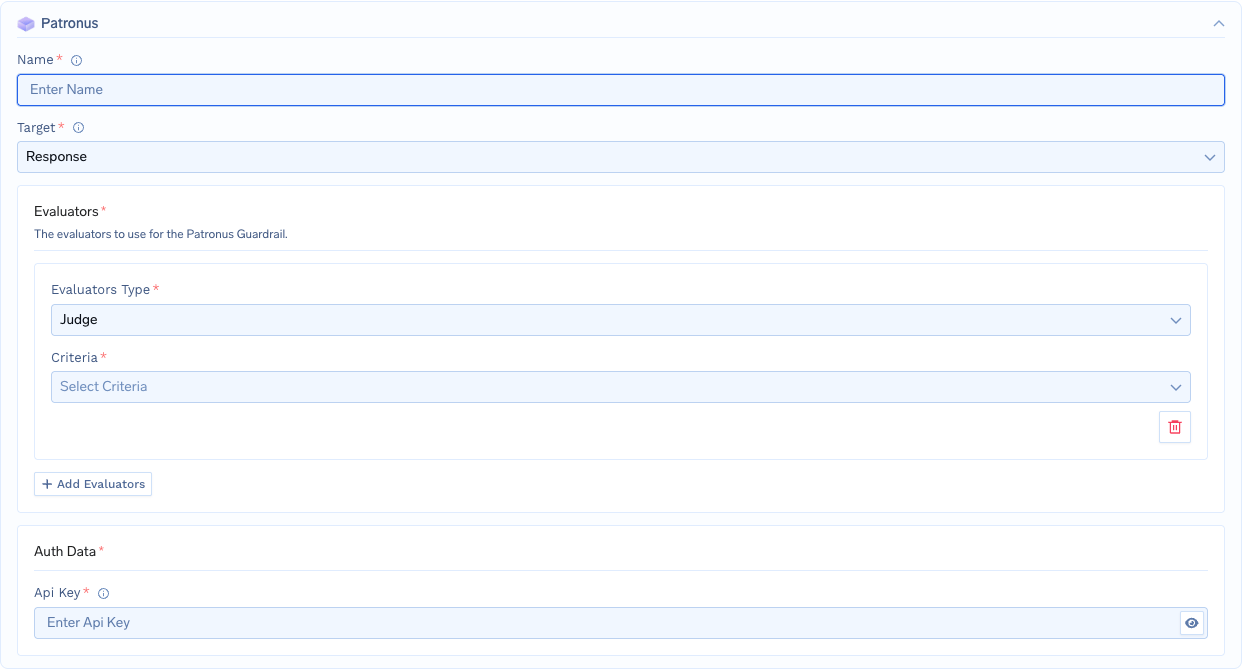
Der Konfigurationstyp ist integration/guardrail-config/patronus. Setzen Sie target auf request oder response und listen Sie anschließend die Evaluatoren auf. Es existieren sechs Typen: answer-relevance, glider, judge, pii, phi, toxicity. Der Typ judge entspricht der LLM-as-a-Judge-Variante, bei der das Feld criteria erforderlich ist. Alle fünfzehn dokumentierten Werte im Überblick:
Die verwandte glider-Familie ergänzt fünf weitere Kriterien: patronus:is-compliant, patronus:is-factually-consistent, patronus:is-good-summary, patronus:is-harmful-advice, patronus:is-informal-tone.
Verglichen mit der obigen Entscheidungstabelle ist die Aufteilung eindeutig: is-json und is-csv sind Formatprüfungen, die ein Validator besser und günstiger durchführt, während no-harmful-therapeutic-guidance und is-good-summary reine Textkriterien sind, für die ein Judge gedacht ist.
Wenn data.results[].evaluation_result.pass den Wert false hat, wird der Request blockiert und ein Status 400 zurückgegeben. Die Beispiel-Antwort in der Dokumentation zeigt evaluator_id: "judge-large-2024-08-08", evaluator_family: "Judge", profile_name: "patronus:prompt-injection", pass: false, score_raw: 0, evaluation_duration: "PT4.44S", usage_tokens: 687 sowie evaluation_metadata.highlighted_words. Während auf der Seite mit Antwortzeiten von bis zu 100 ms geworben wird, zeigt dieses 4,44-Sekunden-Beispiel deutlich, dass die Latenzspitzen (Tail-Latenz) eines Judges weit über seinem Median liegen können.
Der Großteil von Guardrails AI ist bewusst nicht als LLM-Judge konzipiert. Das v1-Bundle — bestehend aus DetectPII, SecretsPresent, ToxicLanguage und ProfanityFree über sieben Endpunkte hinweg — läuft lokal im Wrapper-Pod ohne zusätzlichen LLM-Netzwerk-Aufruf pro Request bei einer Dauerstrich-Latenz von unter 100 ms.
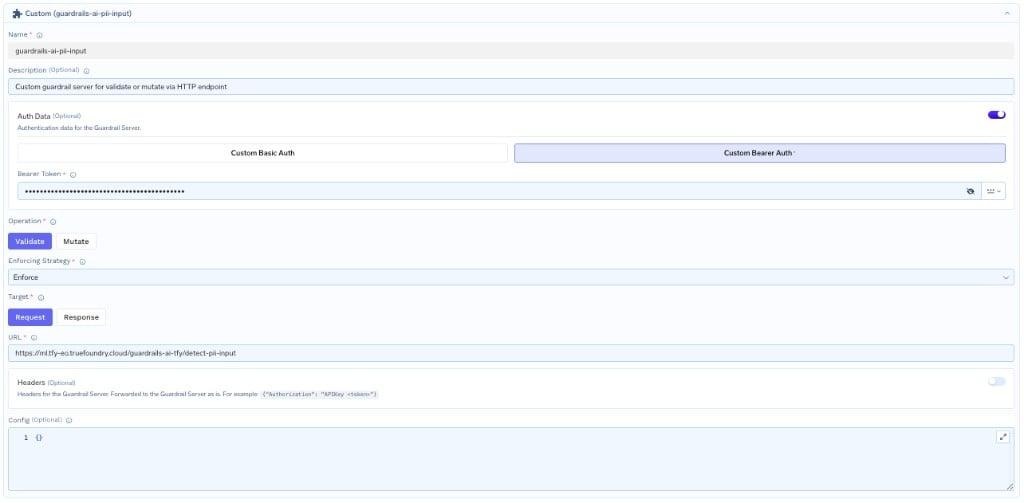
Die Judge-basierten Validatoren bilden eine optionale Kategorie im Hub: hub://guardrails/restricttotopic (LLM-bewertet), hub://guardrails/provenance_llm — in der Dokumentation als kostenintensiv gekennzeichnet — sowie hallucination_check. Diese werden über LITELLM_*-Umgebungsvariablen konfiguriert und für einheitliche Observability durch Ihr Gateway geroutet, analog zum Muster bei NeMo für JUDGE_MODEL. Günstige Alternativen stehen direkt daneben zur Verfügung: competitor_check basiert auf Allowlists, regex_match ist, wie die Dokumentation betont, extrem günstig.
Die TrueFoundry-Dokumentation zur Halluzinationserkennung beschreibt vier Arten — faktisch, kontextuell, logisch und quellenbezogen — und nennt genau zwei Wege zur Implementierung: AWS Bedrock Guardrails, wo Sie Grounding und Relevance aktivieren, die Guardrail Action auf Block stellen und Schwellenwerte definieren, oder eine eigene Guardrail auf Basis des Template-Repositories.
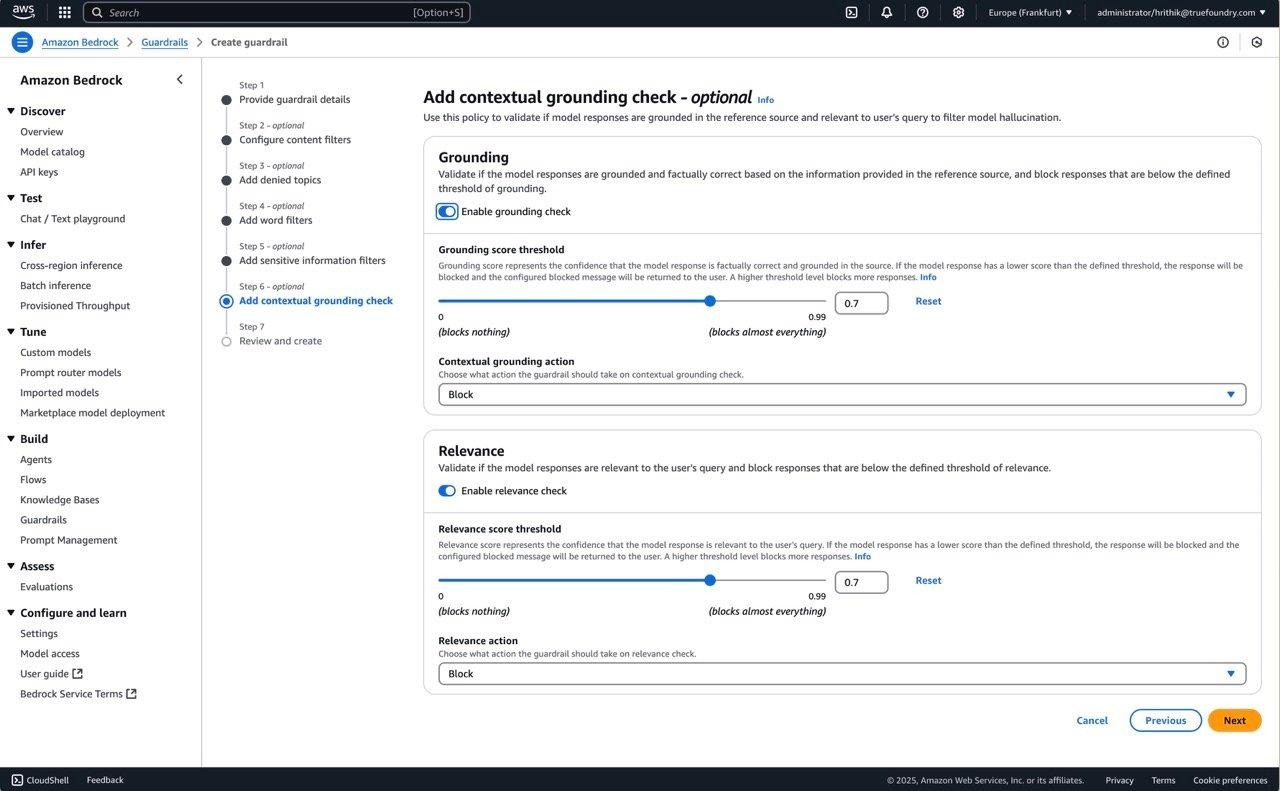
In der Dokumentation wird ausdrücklich darauf hingewiesen, dass das Template-Repository derzeit keine Guardrail zur Halluzinationserkennung out-of-the-box enthält — es stellt Beispiele wie PII-Schwärzung und NSFW-Filterung bereit. Der benutzerdefinierte Weg erfordert somit eigenständigen Entwicklungsaufwand.
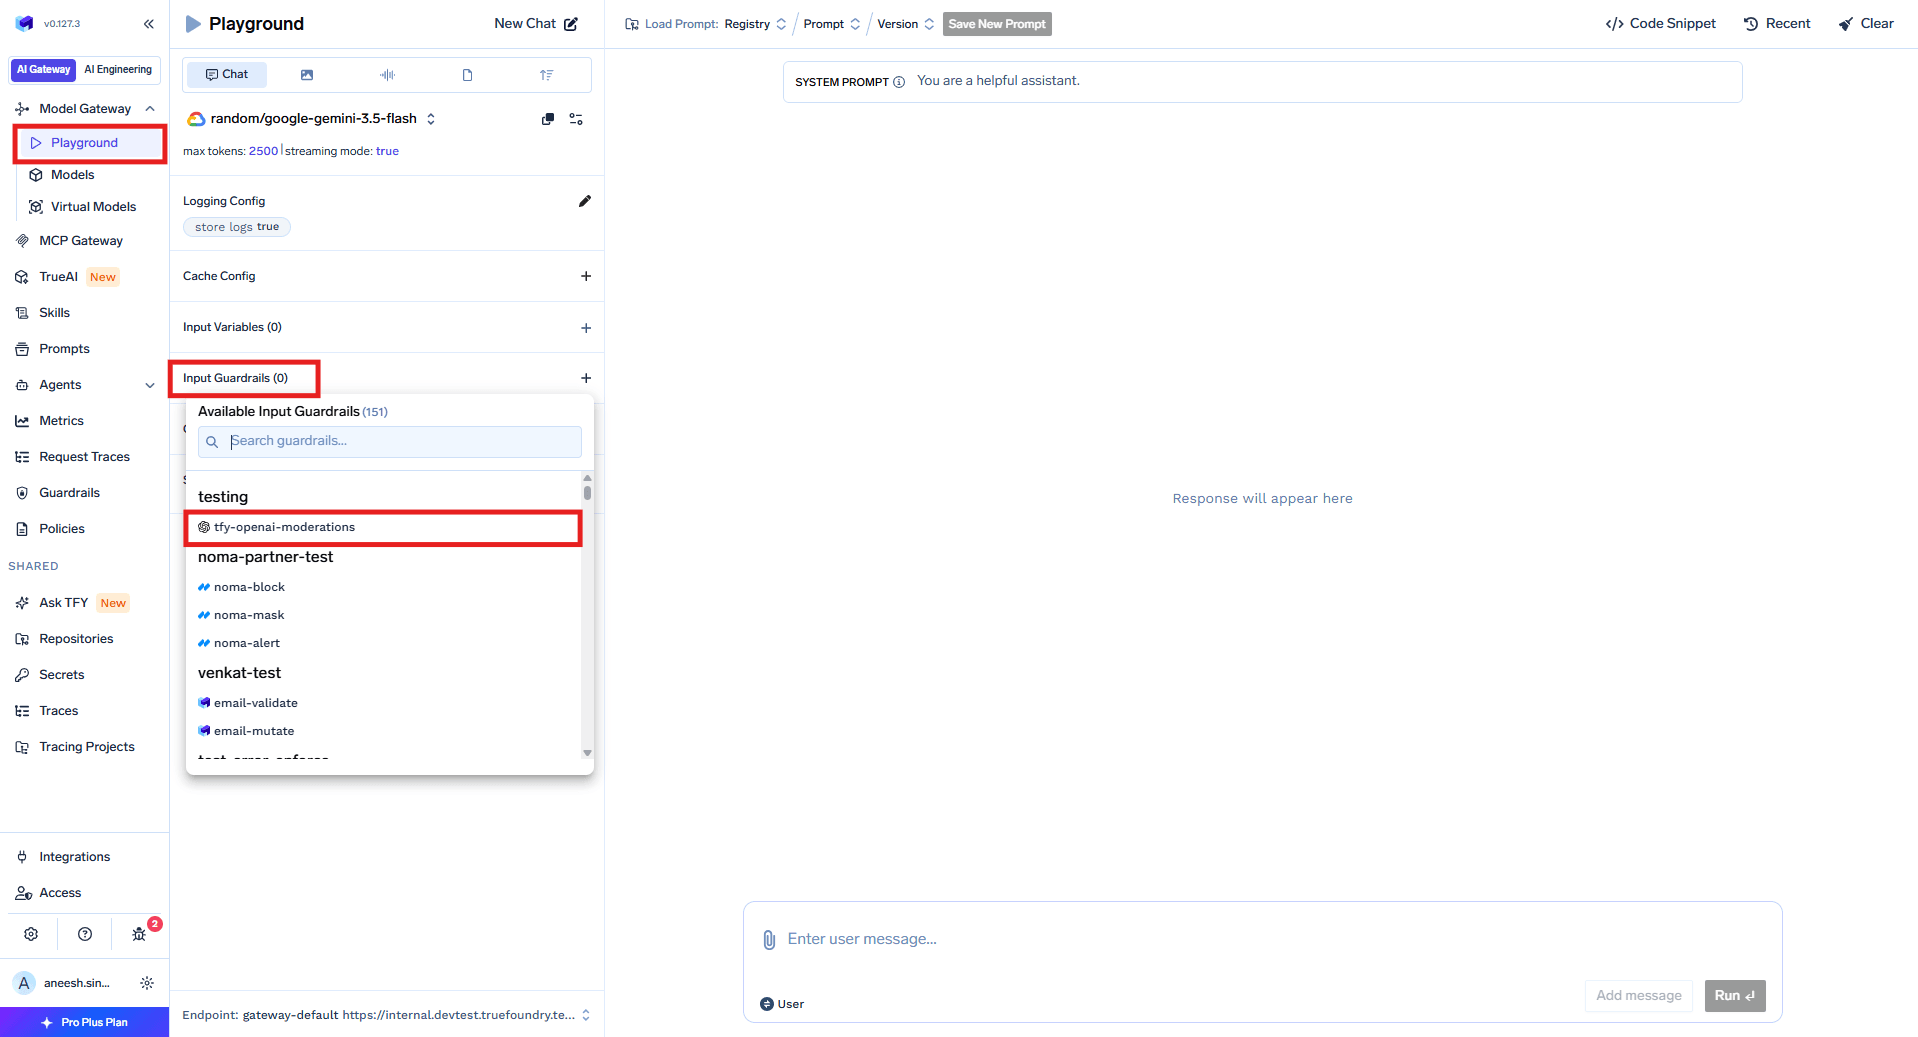
Der Playground führt alle vier Hooks aus, sodass Sie Adversarial Prompts gegen die Input-Rail testen können, noch bevor eine globale Richtlinie aktiv ist.
Nach der Aktivierung wird jede Guardrail-Evaluierung als eigener Span unter Monitor → Request Traces erfasst — inklusive Ausführungszeit, Ergebnis, Scope, Input und Output. Dies gilt auch für blockierte Requests, sodass eine abgelehnte Anfrage als nachvollziehbares Ereignis protokolliert wird.

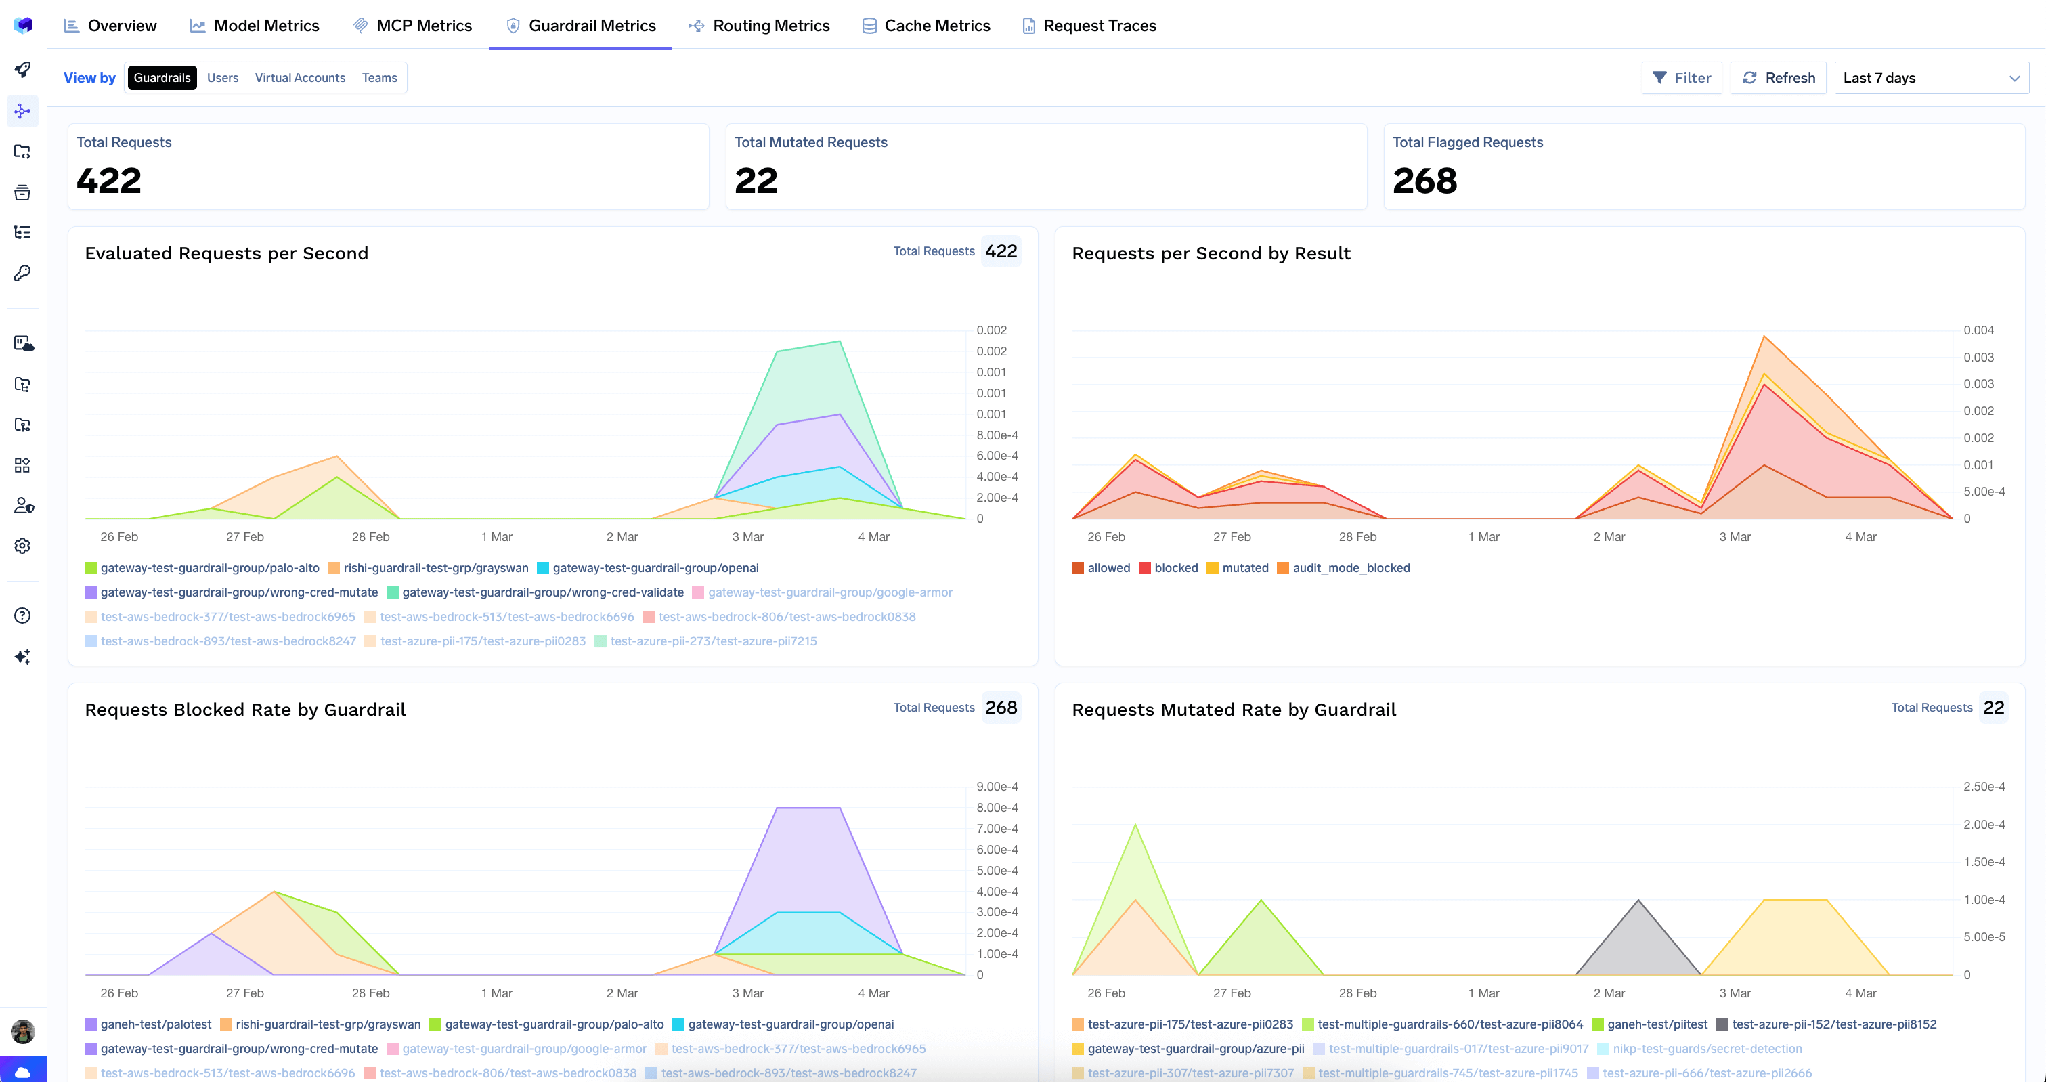
Aggregiert schlüsselt die Guardrail-Ansicht im Metrics Dashboard die Anfragen pro Sekunde nach allowed, blocked, mutated und audit_mode_blocked auf. Sie zeigt Block- und Mutationsraten pro Guardrail sowie die Guardrail-Latenz in den Perzentilen P50, P75, P90 und P99. Anhand des letzten Diagramms erkennen Sie sofort, ob ein Judge mit hohen Latenzspitzen die Gesamtlatenz des Systems nach oben zieht.
Das Urteil eines Judges ist eine Hypothese über die Qualität. Die einzige Möglichkeit, sie zu überprüfen, ist der Abgleich mit einer menschlichen Bewertung für denselben Request. Jede Antwort des AI Gateways enthält den Header x-tfy-feedback-target-id. Senden Sie diesen per POST an https://{control_plane_url}/api/svc/v1/gateway-feedback mit dem Payload {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} — die Skala reicht von 1 (niedrigste) bis 5 (höchste) — und Sie erhalten {"data": {"id": "..."}} zurück. Korrekturen erfolgen über PUT .../gateway-feedback/{feedback_id}, Löschungen über DELETE. Das Feedback erscheint direkt neben dem Span, und die Gesamtliste ist unter Raw Data bei tfyGatewayFeedbacks einsehbar.
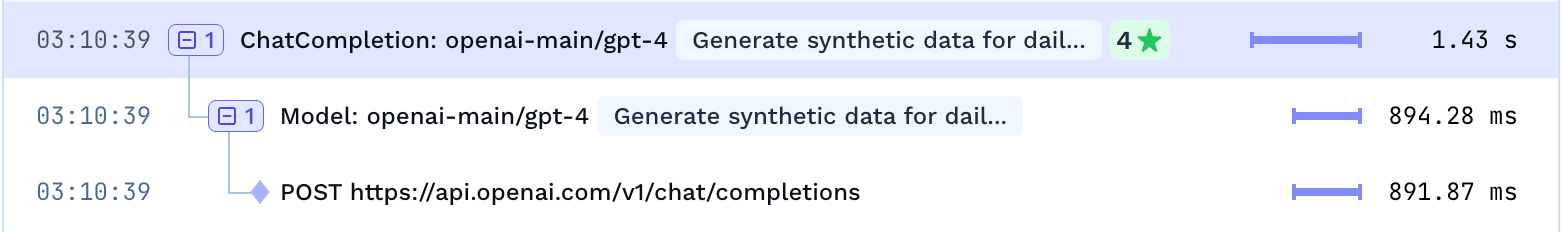
Eine Einschränkung: Die Target-ID adressiert ausschließlich den Root-Span. Das Feedback bezieht sich somit auf den Gesamtrequest und nicht auf einzelne Zwischenschritte.
Ein interner Assistent beantwortet Fragen von Pflegekoordinatoren. Die Compliance fordert zwei Dinge: Keinesfalls schädliche therapeutische Empfehlungen und einen klinisch angemessenen Tonfall. Beides lässt sich nicht als Regex ausdrücken — ein klarer Fall für einen Judge.
1. Die präziseste Rubrik wählen. Nutzen Sie zwei Patronus-Judge-Kriterien anstelle von zehn — patronus:no-harmful-therapeutic-guidance und patronus:clinically-inappropriate-tone mit target: response. Der Rest der Compliance-Anforderungen wird an günstigere Detektoren übergeben.
2. Im Audit-Modus starten. Eine Regel unter AI Gateway → Policies → Guardrails schränkt die Ausführung auf die Modelle des Assistenten und das Team der Pflegekoordinatoren ein. Wählen Sie als Durchsetzungsstrategie Audit: Das Urteil wird protokolliert, aber nichts wird blockiert.
3. Traces einer Woche analysieren. audit_mode_blocked zeigt, wie viele reale Requests diese Regel blockiert hätte; evaluation_metadata.highlighted_words liefert die Begründung. Häufig schlägt das Tonfall-Kriterium bei guten, aber knapp formulierten Antworten an.
4. Mit menschlichen Bewertungen abgleichen. Die Thumbs-Up/Down-Funktion des Assistenten ist über x-tfy-feedback-target-id mit der Feedback-API verbunden. Wenn die markierten Requests genau jene sind, die von Menschen mit 1 oder 2 bewertet wurden, arbeitet der Judge effektiv. Falls nicht, passen Sie die Rubrik an, nicht den Schwellenwert.
5. Auf Durchsetzung umstellen und Kosten überwachen. Wechseln Sie zu Enforce But Ignore On Error. Bei einem Ausfall von Patronus wird das System dann ohne Guardrail ausgeführt, anstatt selbst auszufallen. Patronus gibt usage_tokens pro Evaluierung zurück und die Judge-Inferenz läuft durch das Gateway. Dadurch sind die Evaluierungskosten transparent sichtbar — und dieser Wert bestimmt letztlich Ihre Sampling-Rate.
Output-Guardrails werden bei gestreamten Antworten übersprungen. Bei "stream": true werden keine Output-Rails ausgeführt; Input-Rails laufen hingegen immer. Wenn Ihr Produkt Antworten streamt, schützt Ihr Judge ausschließlich den Prompt.
System-Prompts sind für Guardrails nicht sichtbar. Das Gateway entfernt System-Prompts, bevor der Inhalt an Guardrails übergeben wird. Die einzige dokumentierte Read-Only-Ausnahme bildet CrowdStrike AIDR. Ein Judge kann daher nicht prüfen, ob Ihre Anweisungen befolgt wurden.
Output-Validierung verursacht dennoch Modellkosten. Schlägt eine Input-Rail während der Ausführung fehl, kann das Gateway den Request abbrechen. Eine Output-Rail läuft erst, nachdem die Antwort vollständig generiert wurde. Die Modellkosten sind zu diesem Zeitpunkt bereits entstanden.
LLM as a Judge ist eine leistungsfähige Methode für ein klar abgegrenztes Einsatzgebiet. Es ist die einzige Möglichkeit, subjektive Texte in großem Maßstab zu bewerten. Allerdings neigt es zu Verzerrungen zugunsten langer Antworten, zugunsten von Modellen der eigenen Familie und zugunsten der jeweils zuerst genannten Option. Wer nur das Potenzial sieht, riskiert die Bereitstellung von Guardrails, die unbemerkt valide Nutzeranfragen blockieren.
Die saubere Trennung entspricht der Einleitung dieses Artikels: Offline-Scoring ist ein Datensatz-Problem, das auf eine spezialisierte Evaluation-Plattform gehört, an die TrueFoundry Traces per OTEL exportiert. Online-Gating ist ein Problem des Request-Pfads: Ein präzises Kriterium, ein kleines, fest definiertes Modell aus einer anderen Familie, Start im Audit-Modus, Priorität von Präzision vor Recall und volle Kostentransparenz.
Schreiben Sie Regeln als Code, wo immer es möglich ist. Wo Regeln nur als Text formuliert werden können, nutzen Sie einen Judge — und evaluieren Sie ihn mit derselben Sorgfalt wie jedes andere Produktionsmodell.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




Dabei bewertet ein Sprachmodell die Ausgabe eines anderen anhand einer schriftlichen Rubrik und liefert ein maschinenlesbares Urteil – bestanden/nicht bestanden, eine Punktzahl oder eine Präferenz zwischen Kandidaten. Das Verfahren existiert, weil es für offenen Text keine berechenbare Korrektheitsmetrik gibt, und es wird am besten als günstiger, verrauschter Ersatz für einen menschlichen Bewerter behandelt.
Bei eng gefassten, binären und präzise formulierten Kriterien oft ja; bei breiten Qualitätsrubriken meist nicht. Messen Sie zuerst Precision und Recall getrennt anhand manuell gelabelter Beispiele – ein Judge mit 90 % Genauigkeit blockiert etwa jede zehnte legitime Antwort ab dem Tag, an dem Sie ihn scharf schalten.
Mindestens einen zusätzlichen Modellaufruf pro abgesicherter Anfrage und zwei, wenn Sie sowohl Prompt als auch Antwort bewerten – die NeMo-Dokumentation von TrueFoundry nennt diese Rechnung ausdrücklich. Der einzige Hebel ist die Abdeckung: Nehmen Sie für die Telemetrie Stichproben und reservieren Sie die vollständige Abdeckung für die Prüfungen, die nie etwas übersehen dürfen.
Ja. TrueFoundry läuft in Ihrer VPC, On-Prem, Air-Gapped oder hybrid, sodass Prompts und Antworten Ihre Domäne nie verlassen, auch wenn Sie über viele Anbieter hinweg routen.
Etwa 3–4 ms, bei dauerhaft mehr als 350 RPS auf einer einzelnen vCPU über mehr als 1.000 LLMs hinweg. Die Guardrail-Zeit wird separat erfasst und als P50, P75, P90 und P99 ausgewiesen.
Ja. Das Gateway ist OpenTelemetry-konform und exportiert Traces an externe Backends; auf diesem Weg gelangen Gateway-Daten zu Plattformen wie Braintrust, Langfuse oder Arize. TrueFoundry selbst führt keine Offline-Scoring-Jobs aus.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















