



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Aktualisiert: November 3, 2026
Published: April 20, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die Welt der künstlichen Intelligenz (KI) entwickelt sich rasant weiter und bewegt sich weg von isolierten Modellen hin zu vernetzten Systemen, die gemeinsam komplexe, vielschichtige Probleme lösen. Ein Compound-KI-System ist als ein System definiert, das KI-Aufgaben mithilfe mehrerer interagierender Komponenten bewältigt. Dazu können verschiedene KI-Modelle, Mechanismen zur Datenabfrage und externe Tools gehören. Diese Komponenten arbeiten zusammen, um spezifische Ziele zu erreichen, was einen nuancierteren und effektiveren Ansatz zur Problemlösung ermöglicht.
Häufige Beispiele für Compound-Systeme sind:
Dieses Designprinzip, das von Institutionen wie dem Berkeley AI Research (BAIR) Lab gefördert wird, unterstreicht die Bedeutung der Systemarchitektur bei der Bewältigung komplexer KI-Aufgaben. Anstatt sich ausschließlich auf große, monolithische Modelle zu verlassen, nutzen Compound-KI-Systeme verschiedene spezialisierte Komponenten, um Leistung, Flexibilität und Anpassungsfähigkeit zu verbessern.
Ein aktuelles Video von Stanford skizzierte die Entwicklung der Skalierung in der KI über verschiedene Epochen hinweg und konzentrierte sich darauf, wie sich der Schwerpunkt von der modellzentrierten Entwicklung hin zur systemweiten Integration verlagert hat.
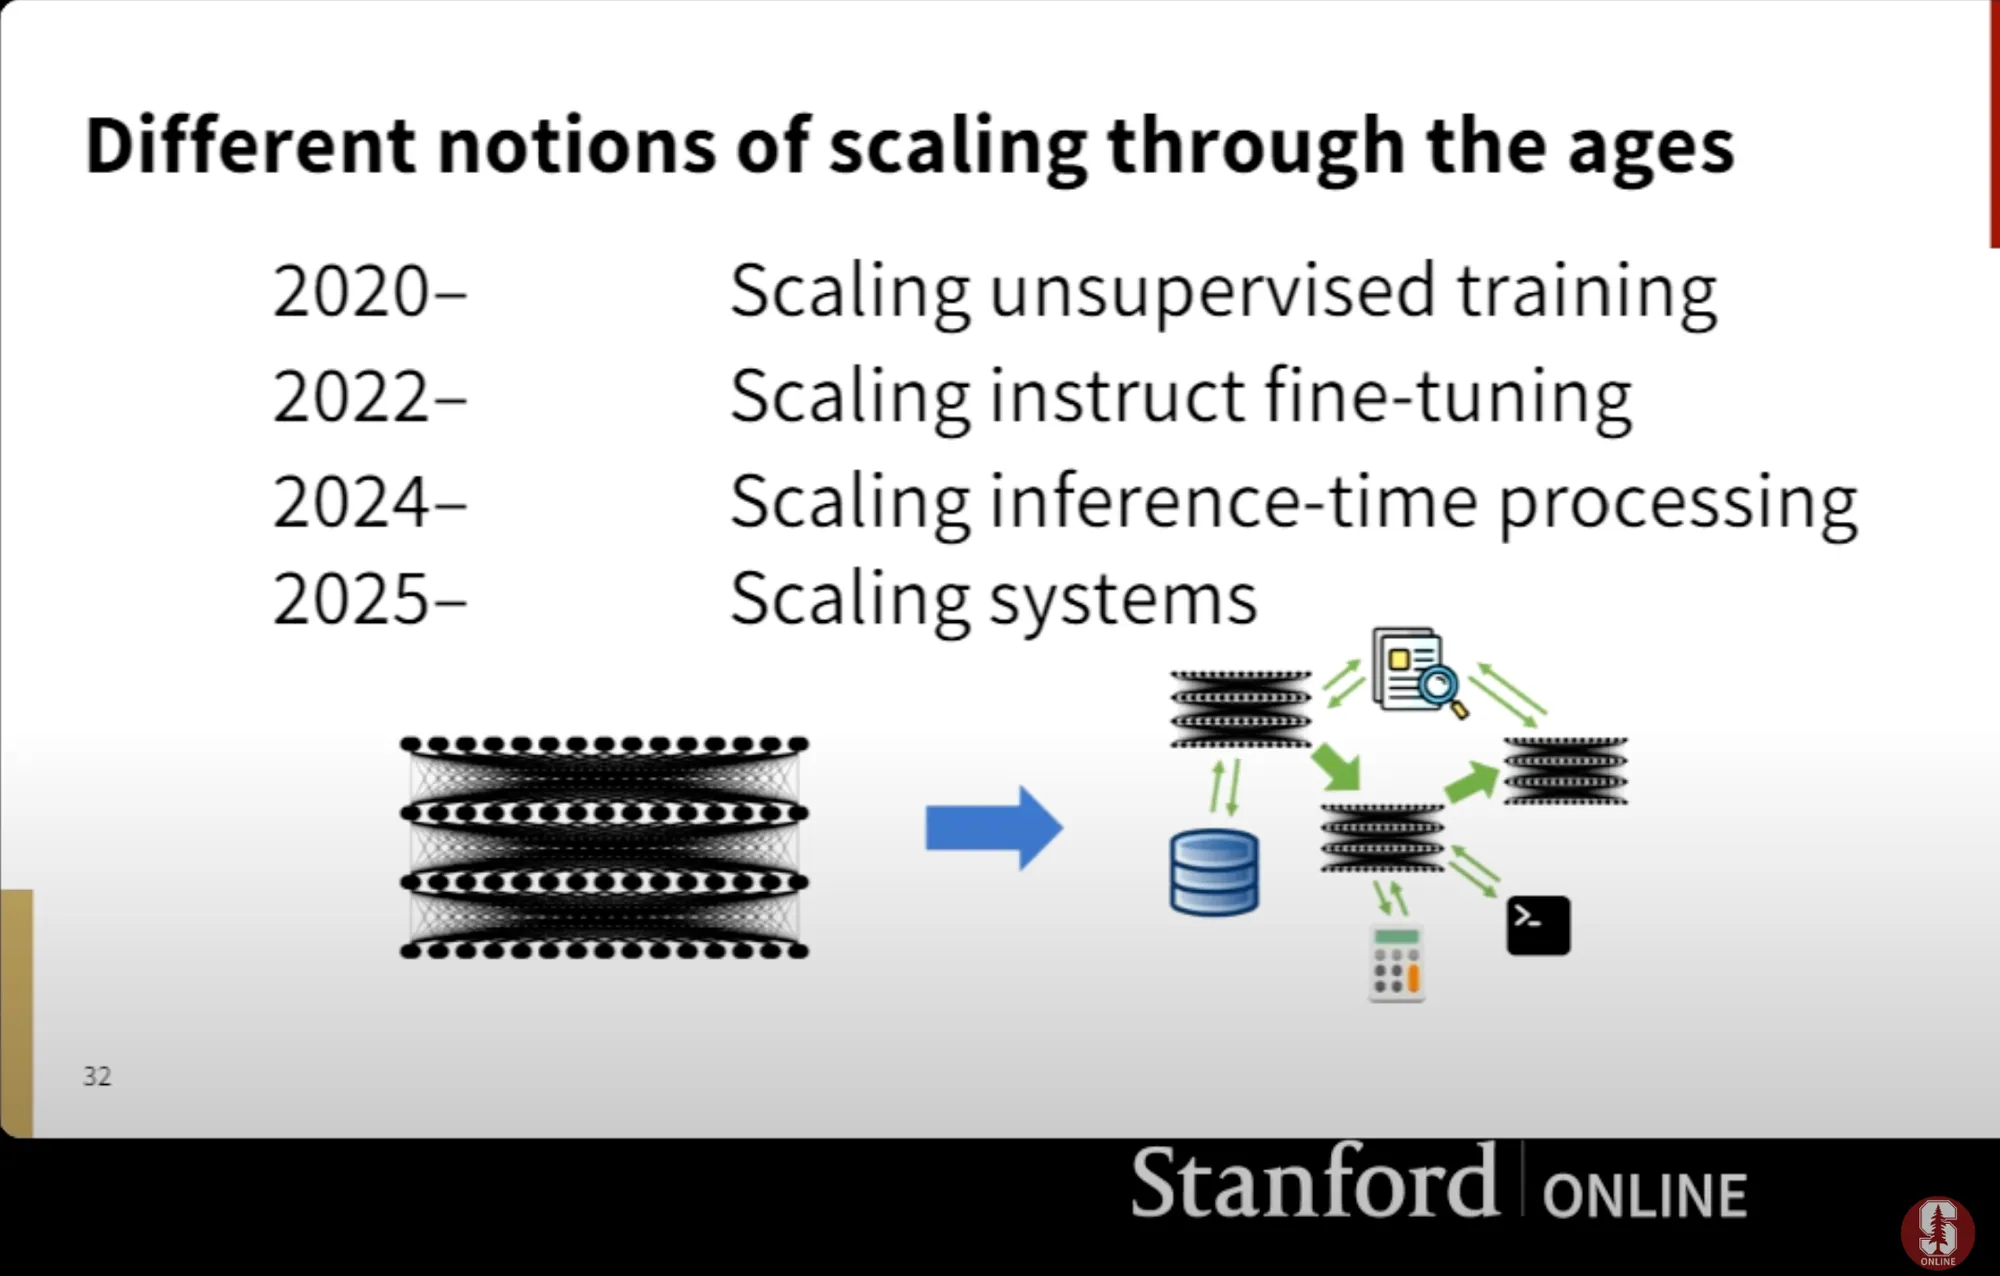
Skalierung des unüberwachten Trainings (ab 2020) – Dies begann mit der Veröffentlichung von GPT-3, das die Leistungsfähigkeit des unüberwachten Trainings im großen Maßstab demonstrierte. Beim unüberwachten Training werden Modelle mit riesigen Mengen unstrukturierter Daten konfrontiert, wie etwa Texten aus dem Internet, damit sie Muster ohne spezifische Aufgabenbeschriftungen verallgemeinern können.
Skalierung des instruktionsbasierten Fine-Tunings (ab 2022) – Diese Ära war geprägt von der Einführung von Anwendungen wie ChatGPT, die Instruction Tuning und Fine-Tuning-Techniken nutzten. Beim instruktionsbasierten Fine-Tuning werden Input-Output-Paare (z. B. Frage-Antwort-Datensätze) bereitgestellt, um vortrainierte Modelle für spezifische Fähigkeiten anzupassen.
Skalierung der Inferenz-Verarbeitung (ab 2024) - Dies bezieht sich auf Innovationen zur Optimierung des Echtzeiteinsatzes von KI-Modellen während der Inferenz. Der Fokus liegt auf der Steigerung von Effizienz, Antwortzeiten und Anpassungsfähigkeit durch mehrstufiges Schlussfolgern, „Chain-of-Thought“-Prompting, Speicheroptimierung usw.
Skalierung von Systemen (ab 2025) - Der Übergang von großen Sprachmodellen (LLMs) hin zu komplexen Systemen; die Entwicklung von eigenständigen Modellen zu integrierten Systemen, die Modelle, Tools, APIs und Infrastruktur kombinieren.
Infrastrukturelle Herausforderungen
Komplexe KI-Systeme erfordern die nahtlose Fähigkeit, je nach den spezifischen Anforderungen der einzelnen Komponenten zwischen GPUs, CPUs und anderer spezialisierter Hardware zu wechseln. Ein Vision-Modell erfordert beispielsweise GPU-Beschleunigung, während eine Datenbankabfrage von der CPU-Effizienz profitieren kann. Die Bestimmung der optimalen Ressourcenkonfiguration für jeden Workload und die dynamische Anpassung der Infrastruktur an sich ändernde Anforderungen sind entscheidend. Durch regelmäßige Überwachung und Feinabstimmung der Infrastruktur wird sichergestellt, dass das System effizient und kostengünstig arbeitet, selbst wenn sich Workloads oder Modellanforderungen ändern.
Um eine effiziente Skalierung komplexer KI-Systeme zu gewährleisten, müssen Auto-Scaling-Mechanismen implementiert werden, die Ressourcen dynamisch an den Workload-Bedarf anpassen. Dies umfasst die Überwachung der Systemauslastung – wie CPU, GPU, Arbeitsspeicher und Netzwerkbandbreite –, um Veränderungen in Echtzeit vorherzusehen und darauf zu reagieren.
Hohe Kosten
Der gleichzeitige Betrieb mehrerer KI-Modelle, insbesondere in Echtzeit, führt zu hohen Rechen-, Speicher- und Cloud-Kosten. Es ist essenziell, eine Infrastruktur aufzubauen, die das Erkennen von Ressourcenineffizienzen ermöglicht und den nahtlosen Wechsel zwischen Konfigurationen unterstützt. Strategien wie Spot-Instanzen, fraktionierte GPUs und Auto-Scaling sorgen für Kosteneffizienz bei gleichzeitig optimaler Leistung.
Integration in bestehende Infrastrukturen
Moderne Infrastrukturen bestehen häufig aus hochgradig verteilten Architekturen, Multi-Cloud-Umgebungen und spezialisierten Tools für spezifische Workflows. Obwohl diese Setups fortschrittlich sind, bringen sie Komplexität mit sich, wenn neue KI-Komponenten hinzugefügt werden, die harmonisch in einem bereits komplizierten Ökosystem funktionieren müssen.
Schnellere Experimente
Schnellere Experimente sind ein entscheidender Faktor für den Erfolg komplexer KI-Systeme, da sie es Teams ermöglichen, zügig zu iterieren, neue Ideen zu testen und die Leistung zu optimieren.
Eine modulare Architektur ermöglicht es Teams, Modelle auszutauschen, Pipelines anzupassen oder neue Algorithmen mit minimaler Unterbrechung zu integrieren. Automatisierung spielt ebenfalls eine wichtige Rolle, wobei Tools wie CI/CD-Pipelines eine nahtlose Bereitstellung und Prüfung aktualisierter Komponenten gewährleisten.
Lesen Sie unseren ausführlichen Blog zur Integration von TrueFoundry mit MongoDB.
Beschleunigen Sie die Markteinführung mit MongoDB Atlas
Die native Vektorsuche von MongoDB vereinfacht die Implementierung komplexer RAG-Workflows (Retrieval-Augmented Generation), indem die Vektorsuche direkt in eine operative Datenbank integriert wird. Dies macht separate Vektordatenbankenüberflüssig, reduziert die Komplexität der Infrastruktur und ermöglicht eine schnellere Bereitstellung.
Schnelle Iteration durch Flexibilität
Das dokumentenbasierte Datenmodell von MongoDB ist von Natur aus flexibel und eignet sich daher ideal für die Speicherung multimodaler Datentypen wie Text, Bilder und Vektoreinbettungen. Entwickler können neue Datentypen ohne Ausfallzeiten oder Schema-Anpassungen integrieren, was eine schnellere Abstimmung, Optimierung und Iteration für KI-gestützte Anwendungen ermöglicht.
Skalierbarkeit und Sicherheit auf Unternehmensniveau
MongoDB Atlas bietet Fehlertoleranz, horizontale Skalierung und standardmäßig sichere Funktionen wie abfragbare Verschlüsselung auf Enterprise-Niveau. Die vollständig verwaltete, serverlose Architektur unterstützt elastische Skalierung und verbrauchsbasierte Abrechnung, wodurch ein kosteneffizienter Betrieb selbst bei anspruchsvollsten Workloads gewährleistet wird.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















