



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Da Large Language Models (LLMs) zu einem zentralen Bestandteil moderner AI-Anwendungen werden, ist die Gewährleistung ihrer Zuverlässigkeit, Leistung und Sicherheit in der Produktion wichtiger denn je. LLM Observability bezieht sich auf die Fähigkeit, das Verhalten von LLMs zu überwachen, zu tracen und zu debuggen, indem Prompts, Latenz, Token-Nutzung, Benutzersitzungen und Fehlermuster nachverfolgt werden. Ohne robuste Observability riskieren Teams Halluzinationen, Kostenüberschreitungen und unbemerkte Ausfälle (Silent Failures). In diesem Artikel erfahren Sie, wie LLM Observability funktioniert, welche die besten LLM-Observability-Tools sind und vieles mehr.
LLM Observability bezieht sich auf die Praxis des Überwachsens, Analysierens und Verstehens des Verhaltens und der Leistung von Large Language Models (LLMs) in realen Anwendungen. Da LLMs zunehmend in Produktionssysteme wie Chatbots, AI-Agenten und Suchmaschinen integriert werden, ist Observability entscheidend, um Zuverlässigkeit, Sicherheit und Vertrauen zu gewährleisten.
Sie geht weit über einfaches Logging oder Metriken hinaus. LLM Observability konzentriert sich auf die Nachverfolgung von Eingaben, Ausgaben, Prompt-Chains, Latenz, Token-Nutzung, Modellversionierung und Fehlerfällen. Sie ermöglicht Entwicklern und ML-Teams, Halluzinationen, Bias, toxische Antworten, Prompt-Injection-Angriffe oder unerwartetes Verhalten zu erkennen. Zudem hilft sie zu identifizieren, wenn Modellausgaben von den erwarteten Normen abweichen, was für die Aufrechterhaltung von Konsistenz und Compliance besonders in regulierten Branchen kritisch ist.
Mit Observability können Teams Echtzeit-Debugging durchführen, die Ursache von Fehlern zurückverfolgen, Benutzerinteraktionen überwachen und Prompts oder feingetunte Modelle kontinuierlich verbessern. Tools wie TrueFoundry, LangSmith, Arize, WhyLabs und PromptLayer entstehen, um Monitoring im DevOps-Stil in LLM-Systeme zu bringen.
LLM Observability fungiert als „Augen und Ohren“ Ihres GenAI-Stacks. Sie ermöglicht eine sichere Skalierung von AI-Anwendungen, indem sie Transparenz und Rechenschaftspflicht bietet und dabei hilft, die Lücke zwischen Experimentieren und verlässlichem Produktionseinsatz zu schließen.
Für einen tiefen Einblick in die Grundlagen der LLM Observability lesen Sie unseren ausführlichen Leitfaden: What is LLM Observability?
LLM Observability funktioniert durch das Erfassen detaillierter Telemetriedaten über jede Phase des LLM-Lebenszyklus hinweg. Von der Prompt-Übermittlung bis zur finalen Ausgabe bietet sie Einblick in das Verhalten des Systems unter realen Bedingungen. Dies umfasst in der Regel drei Hauptkomponenten: Prompt Tracing, Metrik-Erfassung und Verhaltensüberwachung.
Prompt-Level Tracing: Jede Interaktion mit dem LLM wird mit reichhaltigen Metadaten protokolliert, einschließlich des Roh-Prompts, des Benutzerkontexts, der Modellversion, des Zeitstempels und der Systemantwort. Fortschrittliche Tools tracen mehrstufige Workflows oder Agenten-Ketten und verknüpfen Upstream- und Downstream-Operationen mithilfe von Korrelations-IDs. Dies ermöglicht es Teams, Probleme wie Halluzinationen, Kontextverlust oder Leistungsengpässe zu debuggen, indem sie den gesamten Inferenz-Ablauf nachverfolgen.
Performance- & Token-Metriken: Observability-Plattformen erfassen Latenz, Token-Nutzung (Input/Output), Durchsatz und Fehlerraten in Echtzeit. Diese Metriken helfen dabei, Verlangsamungen, übermäßige Token-Nutzung oder abnormales Verhalten zu identifizieren. Die Nachverfolgung auf Token-Ebene ist entscheidend für das Kostenmanagement bei APIs wie OpenAI, bei denen die Preisgestaltung an den Token-Verbrauch gekoppelt ist.
Qualität, Guardrails und Anomalieerkennung: Viele Tools überwachen Ausgaben mithilfe statistischer Modelle oder Regeln auf Qualitätsrisiken wie Bias, Toxizität oder Halluzinationen. Sie erkennen außerdem Verstöße gegen Moderationsrichtlinien oder Sicherheitsgrenzwerte und generieren Warnmeldungen. Einige Plattformen integrieren Embedding-Drift-Analysen, um Verschiebungen im semantischen Verhalten im Laufe der Zeit zu überwachen.
Diese Observability-Signale werden typischerweise in Dashboards visualisiert und können Alerts auslösen, in Logging-Systeme integriert oder in CI/CD-Pipelines zurückgeführt werden. Durch die Bereitstellung von Transparenz, Debugging-Unterstützung und Kosteneinblicken gewährleisten LLM-Observability-Tools einen sicheren, effizienten und skalierbaren GenAI-Betrieb.
Hier ist eine kurze Übersicht über die verschiedenen LLM-Observability-Plattformen:
Die Wahl des richtigen Observability-Tools ist essenziell, um LLM-Anwendungen vertrauensvoll zu skalieren. Vom Prompt Tracing bis zur Latenzüberwachung bieten heutige Plattformen tiefe Einblicke in jede Phase der Modellinferenz. In diesem Abschnitt stellen wir die besten Tools vor, die sich durch Zuverlässigkeit, Governance und Developer Experience auszeichnen. Egal, ob Sie in der Cloud oder On-Premise arbeiten – diese Lösungen helfen dabei, LLMs produktionsreif zu machen.

End-to-End-Prompt- und Output-Tracing: TrueFoundry erfasst jede Phase einer LLM-Interaktion – von der Prompt-Generierung über die Modellinferenz bis zur Nachbearbeitung – und erstellt einen vollständigen Trace mit Korrelations-IDs und OpenTelemetry-Spans. Diese feingranulare Nachverfolgung ermöglicht es Entwicklern, genau zu lokalisieren, wo Latenzspitzen oder Fehler auftreten, sei es bei der Prompt-Verarbeitung, der Modellantwort oder in nachgelagerten Prozessen. Traces werden in der Benutzeroberfläche für einfaches Debugging visualisiert und für Compliance-Audits gespeichert, was Ihnen Transparenz an jedem Entscheidungspunkt in mehrstufigen Workflows bietet.

Echtzeit-Analytik: Integrierte Dashboards liefern Live-Einblicke in Modelllatenz, Token-Durchsatz, Fehlerraten, Rate-Limit-Treffer und Fallback-Ereignisse. Aggregierte Analysen wie Latenz-Heatmaps und Nutzungsaufschlüsselungen werden in Echtzeit aktualisiert, sodass Teams Probleme schnell erkennen können, bevor sie sich auf die Benutzer auswirken. TrueFoundry unterstützt Alerting bei Schwellenwerten wie Latenzspitzen oder ungewöhnlichem Modell-Drift, was eine proaktive Reaktion gewährleistet und Ausfallzeiten minimiert.

Feingranulare Metadaten und Kostenzuweisung: Jeder Aufruf wird mit Metadaten wie Modell, Benutzer, Team, Umgebung oder benutzerdefinierten Tags angereichert und enthält Details zu Token-Nutzung und Kosten. Dies ermöglicht eine präzise Nachverfolgung von Ausgaben und Nutzungstrends über Abteilungen oder Funktionen hinweg. Teams können Dashboards filtern und Berichte für Abrechnungstransparenz und ROI-Analysen exportieren. So erhalten Engineering-, Finanz- und Produktteams vollständige Transparenz darüber, wer was wann und zu welchen Kosten nutzt.

Langfuse ist eine Open-Source-Observability-Plattform, die speziell für LLM-Anwendungen entwickelt wurde. Sie bietet vollständiges Prompt-Response-Tracing, einschließlich Eingabe-Metadaten, Modellausgaben, Latenz und Token-Nutzung. Langfuse lässt sich nahtlos in LangChain, OpenAI-kompatible APIs und andere LLM-Stacks integrieren, was es ideal für Entwickler macht, die mehrstufige oder agentische Workflows bauen. Es unterstützt Tracing über Ketten hinweg und ermöglicht die Visualisierung von verschachtelten Aufrufen, Tool-Nutzung und Argumentationspfaden in Echtzeit.
Die Plattform protokolliert detaillierte Telemetriedaten für jede Benutzersitzung, die nach Projekt, Benutzer oder Modell gefiltert werden können. Langfuse bietet außerdem Unterstützung für die Versionierung von Prompts und das Nachverfolgen von Änderungen im Laufe der Zeit, was das Debuggen von Regressionen oder das Iterieren beim Prompt Engineering erleichtert. Teams können Langfuse selbst hosten oder die verwaltete Cloud-Version nutzen, und Observability-Daten können für externe Analysen oder Compliance-Berichte exportiert werden. Die intuitive Benutzeroberfläche und die feingranulare Kontrolle über Logs machen Langfuse zu einer entwicklerfreundlichen Wahl für Teams, die Wert auf Transparenz und Debugging in LLM-Workflows legen.
Teams, die die Tiefe der Observability und Funktionen auf Gateway-Ebene evaluieren, vergleichen häufig Optionen wie langfuse vs portkey, um die Unterschiede beim Tracing, Routing und der Kostenzuweisung zu verstehen, bevor sie sich für eine produktionsreife Lösung entscheiden.
Confident AI ist eine AI-Observability-Plattform für Teams, die LLM-Anwendungen in der Produktion überwachen, evaluieren und verbessern. Sie bietet vollständiges Tracing über LLM-Aufrufe, Tool-Nutzung, Agentenschritte und Multi-Agenten-Workflows hinweg, was das Debuggen von Fehlern und das Verständnis der Leistung von AI-Systemen bei realem Datenverkehr erleichtert.
Ihr wichtigstes Alleinstellungsmerkmal ist die Eval-getriebene Observability. Über Latenz, Kosten und Fehler hinaus führt Confident AI Online-Evals direkt auf Produktions-Traces aus, um Halluzinationen, Treue zum Kontext (Faithfulness), Antwortrelevanz und andere Fehlermuster zu überwachen. Dabei werden Probleme in Echtzeit erkannt und genau die Prompts, Agenten oder Tools identifiziert, die für die verschlechterte Leistung verantwortlich sind. Confident AI schließt zudem die Lücke zwischen Monitoring und Pre-Release-Tests: Produktions-Traces können in Evaluierungs-Datensätze kuratiert, für menschliche Annotationen eingereiht und für Regressionstests sowie Prompt-Verbesserungen wiederverwendet werden.
Optimal geeignet für Teams, die Observability und Evaluierung in einem einzigen Workflow wünschen. Enterprise-Teams erhalten zudem Governance-Kontrollen, mit denen Plattform-Teams Qualitätsstandards über Produkte hinweg durchsetzen können.
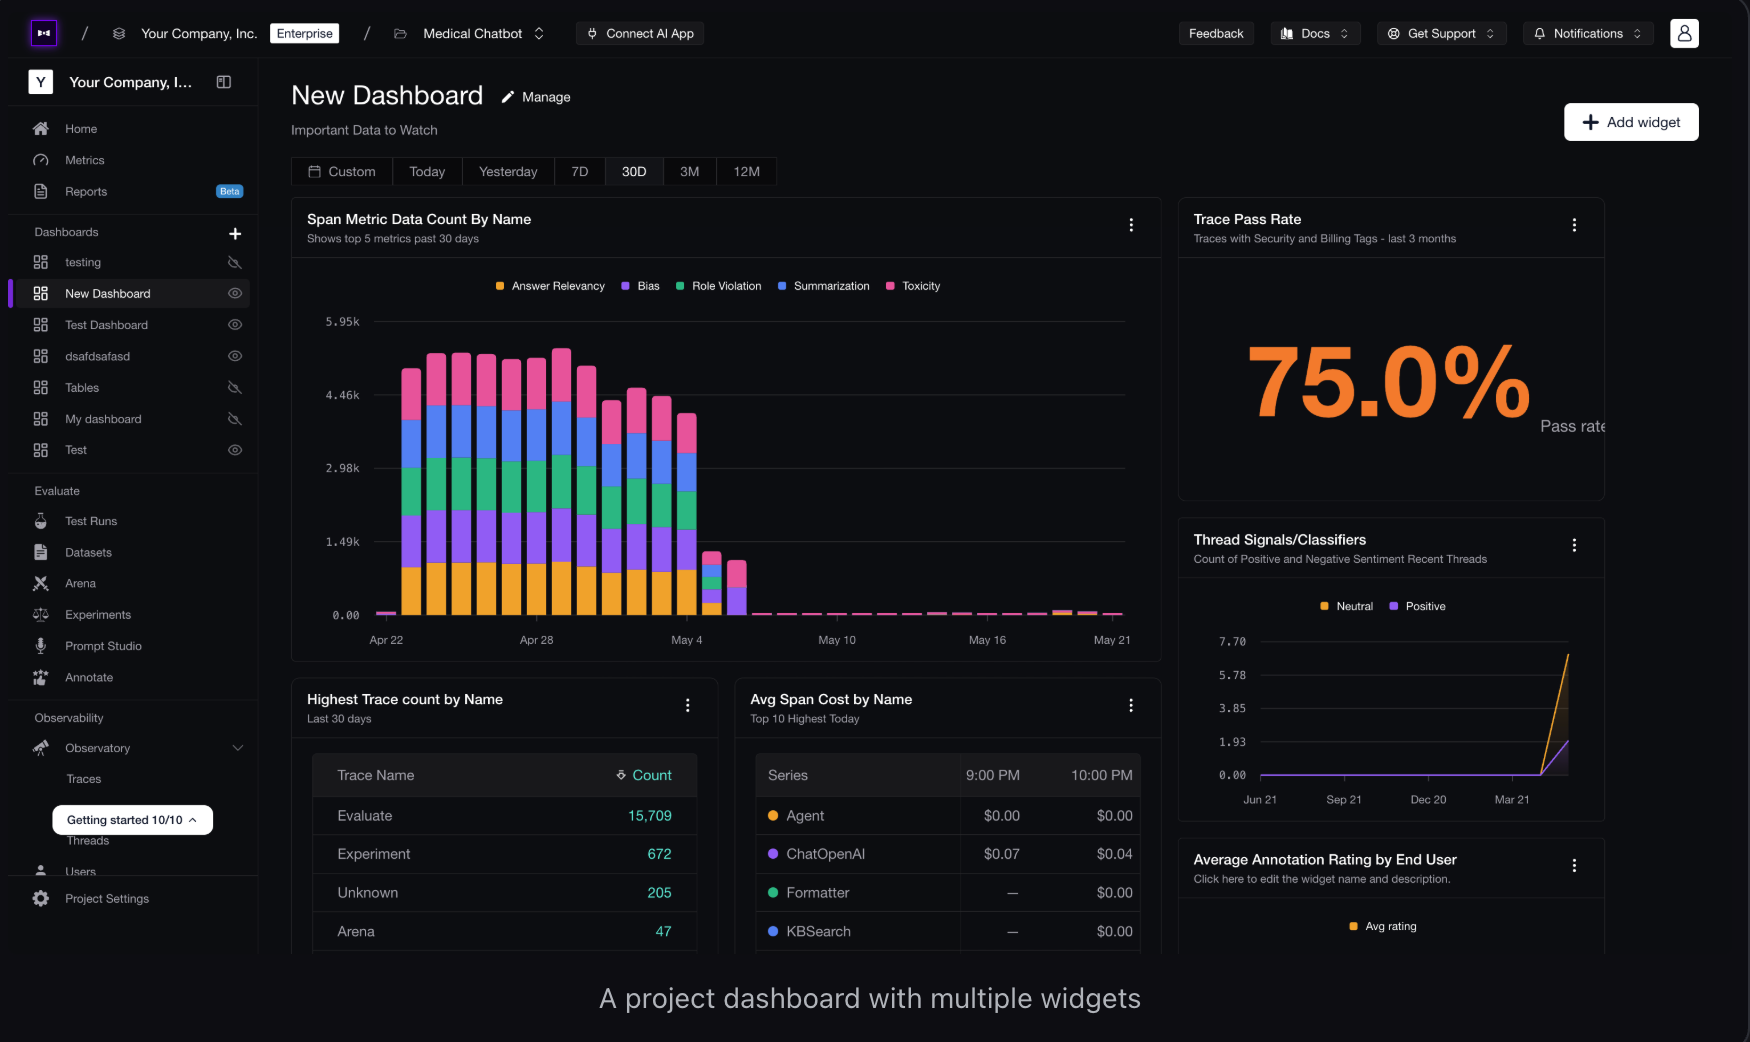

Helicone ist eine leichtgewichtige Observability-Schicht, die speziell für OpenAI-kompatible APIs entwickelt wurde. Sie fungiert als Proxy, der jede LLM-API-Anfrage protokolliert und überwacht und dabei detaillierte Daten wie Prompt-Inhalt, Token-Nutzung, Latenz, Antwortzeit und Fehlercodes erfasst. Helicone ist auf Einfachheit ausgelegt und erfordert minimale Konfiguration; Entwickler können es integrieren, indem sie einfach ihren API-Endpunkt ändern.
Was Helicone attraktiv macht, ist sein Fokus auf Kostentransparenz und Einblicke auf Teamebene. Es verfolgt die Nutzung über Umgebungen hinweg, unterstützt virtuelle API-Schlüssel und ermöglicht es Teams, Kosten pro Benutzer, Modell oder Route aufzuschlüsseln. Das Web-Dashboard bietet Echtzeit-Einblicke in Logs auf Prompt-Ebene, Anfragevolumen und Leistungstrends, was Teams hilft, Probleme frühzeitig zu erkennen und Budgets zu verwalten.
Helicone unterstützt Alerts bei Nutzungsspitzen oder Ausfällen und lässt sich in externe Logging-Tools integrieren. Es ist Open-Source und kann selbst gehostet werden, was es zu einer flexiblen Option für Startups und Entwicklerteams macht, die eine schnelle LLM Observability ohne die Verwaltung schwerer Infrastruktur oder einen Vendor-Lock-in wünschen.
Erkunden Sie auch: Top 5 Helicone Alternatives

PromptLayer ist eine speziell entwickelte Observability- und prompt management-Plattform für LLM-Anwendungen. Sie hilft Entwicklern, jedes Prompt-Antwort-Paar in Echtzeit zu verfolgen, zu versionieren und zu evaluieren, was das Debuggen von Modellausgaben und die Optimierung der Prompt-Qualität erleichtert. Mit nativer Unterstützung für OpenAI und LangChain erfasst PromptLayer Metadaten wie Zeitstempel, Latenz, Token-Nutzung sowie Erfolgs-/Fehlerstatus mit minimalem Integrationsaufwand.
Eines der Kernfeatures ist die Prompt-Versionskontrolle. Entwickler können Änderungen annotieren, Ausgaben vergleichen und überwachen, wie sich Prompt-Anpassungen im Laufe der Zeit auf die Modellleistung auswirken. Dies ist besonders nützlich für Teams, die A/B-Tests durchführen oder rasch an kundenorientierten AI-Funktionen iterieren. PromptLayer unterstützt außerdem das Taggen, Gruppieren und Durchsuchen von Logs über Benutzer, Modelle und Anwendungen hinweg.
Das übersichtliche Dashboard ermöglicht das Filtern nach API-Schlüssel oder Umgebung und bietet Teams eine klare Sicht auf die Produktionsleistung und den Entwicklungsfortschritt. Ob für Debugging, Compliance oder Experimente – PromptLayer bringt Struktur und Transparenz in den Lebenszyklus des Prompt Engineerings.

WhyLabs LangKit ist ein spezialisiertes Observability- und Monitoring-Toolkit, das darauf fokussiert ist, Risiken in LLM-Ausgaben wie Halluzinationen, Bias und toxische Sprache zu erkennen. Entwicklerteams, die generative AI im großen Maßstab einsetzen, können LangKit in Modell-Inferenz-Pipelines integrieren, um Ausgaben mithilfe statistischer und regelbasierter Techniken kontinuierlich auf Anomalien zu scannen.
Im Gegensatz zu traditionellen Tracing-Tools legt LangKit den Schwerpunkt auf Ausgabequalität und Verhaltensanalyse. Es überwacht Verschiebungen in Embeddings, semantischen Drift und Verteilungsanomalien, die auf aufkommende Probleme mit der Modellzuverlässigkeit oder den Dateneingaben hinweisen können. Zudem unterstützt es die Erklärbarkeit, indem es aufzeigt, warum bestimmte Generierungen markiert wurden, was Teams hilft, Prompts, Modellauswahlen oder Guardrails zu verfeinern.
LangKit funktioniert mit selbstgehosteten oder verwalteten Inferenz-Stacks und unterstützt die Integration mit Observability-Backends wie der WhyLabs Platform, OpenTelemetry oder benutzerdefinierten Dashboards. Es ist besonders wertvoll in regulierten Umgebungen oder kundenorientierten Anwendungen, in denen eine schlechte LLM-Ausgabe reale Konsequenzen haben kann. Mit LangKit erhalten Teams eine proaktive Qualitätssicherung und frühe Warnsignale, bevor Fehler eskalieren.

Arize AI bietet fortschrittliche Observability- und Evaluierungsfunktionen, die auf produktionsreife LLM-Bereitstellungen zugeschnitten sind. Ursprünglich für das ML-Modell-Monitoring entwickelt, hat Arize seine Funktionen erweitert, um Large Language Models zu unterstützen. Der Fokus liegt dabei auf Analysen nach dem Deployment, der Erkennung von Daten-Drift und der Integrität von Retrieval-Augmented Generation (RAG).
Eine der Stärken von Arize ist die Überwachung von Embedding-Drift – das Nachverfolgen von Änderungen in Vektordarstellungen im Laufe der Zeit, um semantische Verschiebungen in Benutzeranfragen oder im Modellverhalten zu kennzeichnen. Es unterstützt auch LLM-spezifische Evaluierungen wie Halluzinationserkennung, Relevanz-Scoring und Prompt-Output-Ausrichtung, was Teams hilft, die Modellqualität im großen Maßstab zu vergleichen. RAG-Pipelines profitieren von Transparenz hinsichtlich Retriever-Latenz, Content-Match-Raten und Wissenslücken.
Die Plattform lässt sich in OpenAI, Cohere, Hugging Face und benutzerdefinierte LLMs integrieren und bietet zentralisierte Dashboards und Alerts. Mit der Möglichkeit zur Segmentierung nach Prompt-Typ, Benutzersegmenten und Feedback-Schleifen ermöglicht Arize eine feingranulare Modellanalyse und kontinuierliche Verbesserung. Es ist eine starke Wahl für Unternehmen, die kritische LLM-Anwendungen betreiben, die eine Observability über einfache Logs auf Token-Ebene hinaus erfordern.

Comet ML Observability erweitert seine ML-Experimentier- und Tracking-Suite um umfassende Unterstützung für LLM-Anwendungen. Entwickelt für Forschungs- und Produktionsteams ermöglicht Comet das detaillierte Tracking von Prompts, Antworten, Token-Zahlen, Latenz und Interaktionen auf Benutzerebene in LLM-Workflows. Es unterstützt sowohl vorgefertigte als auch benutzerdefinierte Metriken und lässt sich so für vielfältige Anwendungsfälle wie Prompt-Tuning, Modell-Evaluierung und A/B-Testing anpassen.
Die LLM-Observability-Tools von Comet ermöglichen es Teams, Prompt-Varianten zu vergleichen, die Leistung im Laufe der Zeit zu visualisieren und Prompt-Läufe für das kollaborative Debugging zu annotieren. Durch die enge Integration in Modelltrainings- und Inferenz-Pipelines vereinheitlicht es das Monitoring über alle Phasen des Modelllebenszyklus hinweg – vom Fine-Tuning bis zur Bereitstellung. Teams können Experimente taggen, Guardrail-Verstöße überwachen und Alerts für ungewöhnliches Verhalten einrichten.
Es unterstützt auch die Integration mit OpenAI, Hugging Face, LangChain und benutzerdefinierten Endpunkten, wodurch es sich sowohl für gehostete als auch für selbstverwaltete LLMs eignet. Für Teams, die Comet bereits für die Modellentwicklung nutzen, bringt diese Erweiterung wertvolle Transparenz und Governance in die LLM-Nutzung.
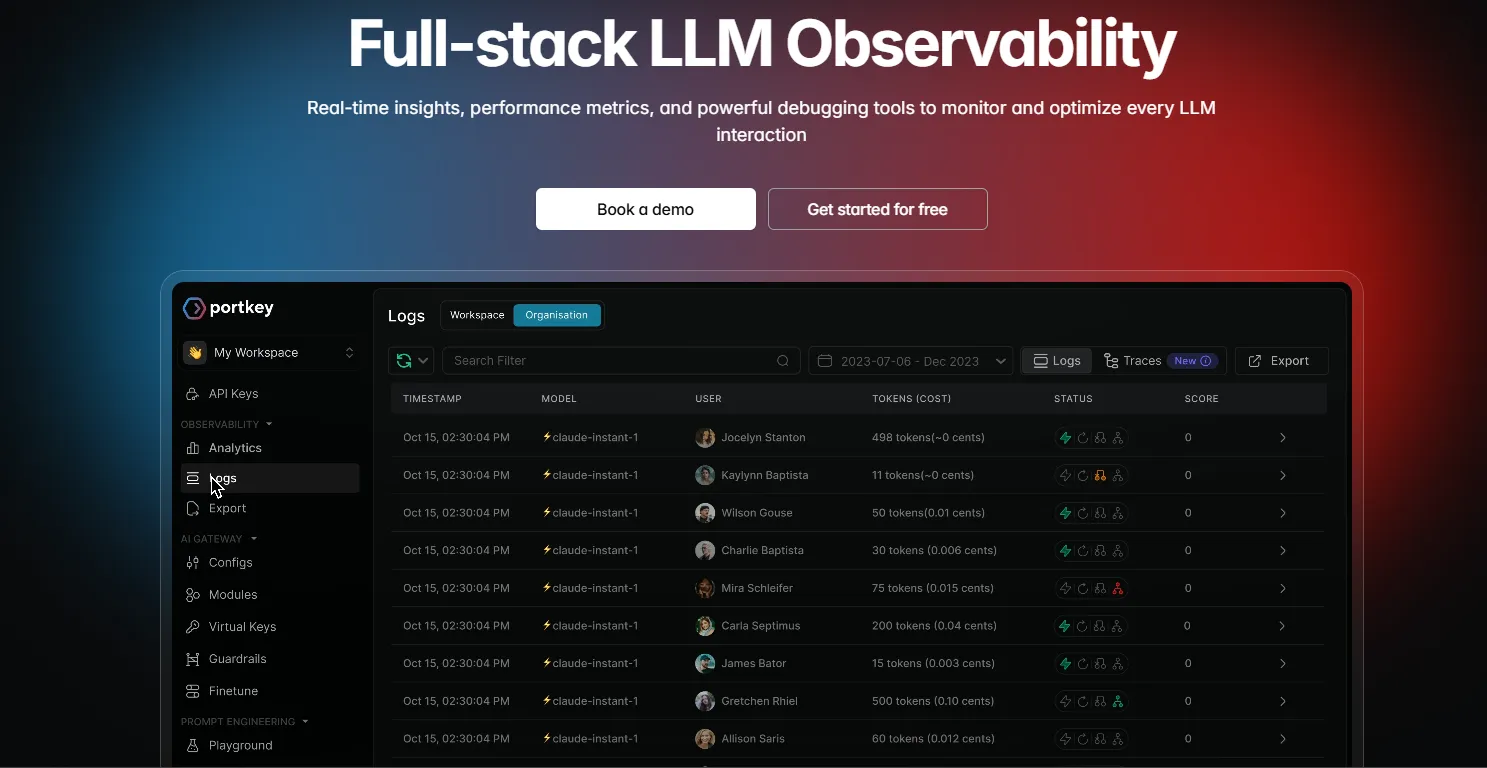
Portkey wurde durch sein Open-Source-LLM-Gateway bekannt, das über eine einzige API einheitlichen Zugriff auf mehr als 100 LLM-Anbieter bietet. Später expandierte es in den Bereich LLM Observability, um Teams bei der Überwachung und Verwaltung von AI-Anwendungen im großen Maßstab zu unterstützen.
Die Plattform fungiert als Proxy-Schicht zwischen Ihrer Anwendung und den LLM-Anbietern. Sie ermöglicht es Teams, Prompt-Bibliotheken, Routing-Regeln, Retries, Temperature-Einstellungen und Modellkonfigurationen zentral zu verwalten. Portkey unterstützt außerdem Response-Caching, Load Balancing und Fallback-Routing, um die Zuverlässigkeit zu verbessern und Infrastrukturkosten zu senken.
Für die Observability erfasst Portkey Anfrage- und Antwort-Logs, Token-Nutzung, Latenz und Modell-Analytik. Der Hauptfokus liegt jedoch auf der Protokollierung von Interaktionen und weniger auf dem vollständigen Workflow-Tracing. Die Kombination aus Gateway-Management und Monitoring macht es zu einer starken Wahl für hochvolumige Multi-Modell-AI-Bereitstellungen.
LangSmith ist eine kommerzielle Tracing- und Observability-Plattform, die von LangChain entwickelt wurde, einem der am schnellsten wachsenden LLM-Orchestrierungs-Frameworks. Seit dem Start im Juli 2023 ist es an der Seite des LangChain-Ökosystems und seiner großen Entwickler-Community rasant gewachsen.
LangSmith ist tief in LangChain integriert, sodass Entwickler automatisch Traces von Prompts, Modellausgaben, Tool-Aufrufen, Latenzen und Ausführungsabläufen erfassen können, ohne dass größere Codeänderungen erforderlich sind. Es unterstützt auch Workflows außerhalb von LangChain, was es für das Debuggen komplexer LLM-Anwendungen und agentenbasierter Systeme nützlich macht.
Die Plattform enthält Evaluierungs-Tools, mit denen Teams Ausgaben manuell überprüfen oder LLM-basierte Evaluatoren für automatisches Scoring und Benchmarking nutzen können. LangSmith bietet auch Analytik und begrenzte Kostenüberwachung, hauptsächlich für die Nutzung von OpenAI. Obwohl es in seinem Standardangebot kein Self-Hosting anbietet, bleibt es eine beliebte Wahl für Teams, die sich auf das Tracing und Debuggen von LLM-Workflows konzentrieren.
Die Auswahl des richtigen LLM-Observability-Tools kann den Unterschied ausmachen zwischen dem zuversichtlichen Skalieren von AI-Systemen und dem Blindflug bei unvorhersehbarem Modellverhalten. Da LLMs immer tiefer in kundenorientierte, hochkritische Anwendungen eingebettet werden, muss Observability über einfache Logs und Metriken hinausgehen. Hier sind die wichtigsten Kriterien, die bei der Auswahl der richtigen Lösung bewertet werden sollten:
Prompt-Level-Tracing und Telemetrie
Das Herzstück der LLM Observability ist die Fähigkeit, jeden Prompt von Anfang bis Ende zu tracen. Ein gutes Tool sollte Prompt-Inhalte, Eingabe-Metadaten, Modellantworten, Token-Nutzung (Input und Output), Latenz und die Auswirkungen auf nachgelagerte Systeme aufzeichnen. Diese Transparenz hilft, Fehler zu diagnostizieren, Kosten zu optimieren und die Qualität zu überwachen.
Unterstützung für mehrere LLM-Anbieter und Modelle
Da moderne Anwendungen verschiedene Modelle verwenden können (OpenAI, Anthropic, Mistral, selbstgehostet über vLLM usw.), sollte sich die Observability-Plattform nahtlos in alle Anbieter integrieren lassen. Sie sollte einheitliche Ansichten bieten und das OpenAI-kompatible API-Format für eine einfache Übernahme unterstützen.
Echtzeit-Monitoring und Alerting
Suchen Sie nach Systemen, die Echtzeit-Dashboards, Latenz-Heatmaps und Metriken zum Token-Verbrauch unterstützen. Noch wichtiger ist, dass sie Benachrichtigungen bei ungewöhnlichem Verhalten ermöglichen, etwa bei einem Anstieg der Fehlerraten, übermäßiger Latenz oder Prompt-Fehlern. Dies erlaubt eine schnellere Reaktion und Behebung bei Produktionsvorfällen.
Guardrail-Verletzungen und Policy-Auditing
Ein Enterprise-Grade-Tool sollte Guardrail-Verletzungen nachverfolgen – also Fälle, in denen Eingaben oder Ausgaben gegen Moderations- oder Sicherheitsrichtlinien verstoßen. Dies ist essenziell, um die Compliance zu wahren und das Modellverhalten an den Unternehmensstandards auszurichten.
Kostenzuweisung und Durchsetzung von Budgets
Fortschrittliche Observability-Plattformen bieten eine feingranulare Kostennachverfolgung bis auf Benutzer-, Modell- oder Prompt-Ebene. Starke Funktionen im Bereich LLM cost tracking solution ermöglichen es Engineering- und Finanzteams, die Nutzung in Echtzeit zu überwachen, Budgets durchzusetzen und unbemerkte Kostenüberschreitungen in der Produktion zu verhindern. Einige Tools erlauben die Integration mit Abrechnungssystemen oder setzen Nutzungsgrenzen über Alerts und automatisierte Kontrollen durch. Dies hilft dabei, Entwicklungs- und Finanzabteilungen aufeinander abzustimmen.
Rollenbasierte Zugriffskontrolle (RBAC) und Ansichten auf Teamebene
Für große Organisationen ist die Möglichkeit, Daten nach Benutzer, Team oder Projekt zu filtern, unerlässlich. Observability-Tools sollten RBAC unterstützen und einen zugriffsbeschränkten Bereich ermöglichen, sodass Teams nur die für sie relevanten Traces und Logs sehen.
Integration mit Dev-Tools und Data Lakes
Wählen Sie Plattformen, die APIs, Exportfunktionen und Unterstützung für Data Sinks wie ClickHouse, BigQuery oder OpenTelemetry bieten. Dies stellt sicher, dass Observability-Daten in Analysen, Compliance-Audits oder Workflows zum Fine-Tuning von Modellen weiterverwendet werden können.
Ein ausgereiftes Observability-Tool hilft Ihnen nicht nur bei der Überwachung der Leistung, sondern verbessert auch die Governance der Modelle, die Debugging-Geschwindigkeit und die Kostenkontrolle. Setzen Sie auf Flexibilität, Sicherheit und Echtzeit-Einblicke, um Ihren LLM-Stack zukunftssicher zu machen.
Um mehr darüber zu erfahren, wie Kostenzuweisung und Budgetierung funktionieren, lesen Sie unseren ausführlichen Leitfaden: AI Cost Observability: Tracking and Controlling LLM Spend in Production
Da LLM-gestützte Anwendungen den Schritt vom Experimentieren in die Produktion vollziehen, wird Observability für Zuverlässigkeit, Sicherheit und Skalierbarkeit unverzichtbar. Im Gegensatz zu traditioneller Software generieren LLMs probabilistische Ausgaben, was bedeutet, dass dieselbe Eingabe je nach Kontext, Prompt-Design oder Modellzustand unterschiedliche Antworten erzeugen kann. Ohne Einblick in das Verhalten dieser Systeme werden Debugging und Optimierung extrem schwierig.
Einer der wichtigsten Gründe für LLM-Observability ist die Erkennung von Halluzinationen. Modelle können mit hoher Sicherheit ungenaue oder irreführende Antworten generieren, insbesondere in kundenorientierten Anwendungen. Observability-Tools helfen Teams dabei, Prompts zurückzuverfolgen, Ausgaben zu prüfen und zu identifizieren, wo Halluzinationen auftreten, um Prompts, Retrieval-Pipelines oder Guardrails zu verbessern.
Kostenmanagement ist ein weiteres zentrales Anliegen. Da viele LLM-APIs auf Basis des Token-Verbrauchs abrechnen, können selbst kleine Ineffizienzen zu massiven Kostenüberschreitungen führen. Observability-Plattformen verfolgen Token-Nutzung, Latenz und Durchsatz in Echtzeit, sodass Teams Prompts optimieren und unbeschränkte API-Ausgaben reduzieren können.
LLM-Observability verbessert auch die Zuverlässigkeit und die User Experience. Durch die Überwachung von Latenzspitzen, fehlgeschlagenen Anfragen oder verschlechterter Ausgabequalität können Teams schneller auf Vorfälle reagieren und die Anwendungsperformance aufrechterhalten. Dies ist besonders wichtig für AI-Agenten, Copilots und RAG-Pipelines, die auf mehreren Modellaufrufen und externen Tools basieren.
Sicherheit und Compliance sind ebenso wichtig. Observability hilft dabei, Prompt-Injection-Angriffe, toxische Ausgaben, Richtlinienverstöße und unbefugte Datenoffenlegungen zu erkennen. Für Unternehmen in regulierten Branchen wie dem Gesundheitswesen oder dem Finanzsektor ist diese Transparenz für Governance und Auditierbarkeit entscheidend.
Letztendlich verwandelt Observability LLM-Systeme von Blackboxes in steuerbare, produktionsbereite Infrastruktur. Sie ermöglicht es Teams, sicherere, effizientere und vertrauenswürdigere AI-Anwendungen im großen Maßstab zu entwickeln.
TrueFoundry sticht als eine der umfassendsten Plattformen für LLM-Observability auf Enterprise-Niveau hervor, da sie tiefes Tracing, Echtzeit-Analysen, Governance und Kostentransparenz in einem einzigen produktionsbereiten Stack vereint.
Einer der größten Vorteile von TrueFoundry ist die End-to-End-Tracing-Architektur. Jede LLM-Interaktion wird über den gesamten Workflow hinweg erfasst, einschließlich Prompts, Antworten, Latenz, Modell-Metadaten, Tool-Aufrufen, Fallback-Ereignissen und nachgelagerten Abhängigkeiten. Dies ermöglicht Teams das Debugging komplexer AI-Systeme mit vollständiger Transparenz über jeden einzelnen Inferenzschritt.
Die Plattform bietet zudem fortschrittliche Echtzeit-Monitoring-Dashboards zur Überwachung von:
Diese Erkenntnisse helfen Teams, Engpässe schnell zu identifizieren, bevor sie sich auf die Nutzer auswirken oder die Infrastrukturkosten in die Höhe treiben.
Eine weitere große Stärke ist die granulare Zuordnung von Kosten. TrueFoundry ermöglicht es Unternehmen, Token-Nutzung und Ausgaben wie folgt zu verfolgen:
Dieses Maß an Transparenz ist extrem wertvoll für Unternehmen, die großflächige GenAI-Workloads über mehrere Abteilungen hinweg ausführen.
Im Gegensatz zu vielen einfachen Observability-Tools ist TrueFoundry für den produktiven AI-Betrieb konzipiert. Es unterstützt:
Dies macht es besonders attraktiv für Organisationen, die sensible oder regulierte Daten verarbeiten.
TrueFoundry fügt sich zudem nahtlos in moderne LLM-Ökosysteme ein, darunter OpenAI-kompatible APIs, LangChain-Workflows, RAG-Pipelines und benutzerdefinierte Inferenz-Stacks. Teams können Observability einführen, ohne ihre Infrastruktur neu aufbauen zu müssen.
Für Unternehmen, die AI verantwortungsvoll skalieren und gleichzeitig Governance, Zuverlässigkeit und Kosteneffizienz wahren möchten, bietet TrueFoundry eine der vollständigsten LLM-Observability-Lösungen des Jahres 2026.
Da LLMs zu einem Grundpfeiler moderner Anwendungen werden, ist Observability nicht mehr optional, sondern essenziell. Die richtigen Tools wie die LLM-Observability von TrueFoundry helfen Teams dabei, Prompt-Verhalten zu verfolgen, Kosten zu verwalten, Fehler zu erkennen und einen verantwortungsvollen AI-Einsatz im großen Maßstab zu gewährleisten. Egal, ob Sie Latenzzeiten optimieren, sich vor Halluzinationen schützen oder die Token-Nutzung analysieren: Diese Tools bieten die nötige Transparenz für einen sicheren Betrieb.
Plattformen wie TrueFoundry, Langfuse und Arize sind führend mit Funktionen auf Produktionsniveau, während andere Anbieter leichtgewichtige Optionen für eine schnelle Integration bereitstellen. Welches Tool das beste ist, hängt letztlich von Ihrem Stack, Ihren Governance-Anforderungen und dem Umfang Ihres Betriebs ab. Die Investition in Observability zahlt sich schon heute in sichereren und intelligenteren LLM-Systemen von morgen aus.
Erlangen Sie volle Transparenz über Ihre Produktions-Traces und optimieren Sie die Kosten mit TrueFoundry, der besten LLM-Observability-Plattform für Enterprise-AI-Workloads. Buchen Sie noch heute eine Demo, um sicherzustellen, dass Ihre Modelle zuverlässig, sicher und effizient sind.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




The best LLM observability platform ensures reliable scaling of your AI applications. TrueFoundry stands out by offering seamless integration and robust performance monitoring for diverse models. It provides granular cost monitoring, making it an ideal choice for optimizing LLM apps while preventing expensive overruns and ensuring high response quality.
The top LLM observability tools for 2026 include TrueFoundry, LangSmith, Arize, WhyLabs, and PromptLayer. These platforms offer key features like prompt-level tracing and production traces. TrueFoundry excels with flexible deployment options, helping teams manage production workloads efficiently while meeting specific governance and data privacy needs.
When evaluating LLM observability tools, prioritize data privacy, low latency, and secure access control. The right observability platform must handle sensitive data safely while offering real-time performance tracking. TrueFoundry meets these criteria with seamless integration and comprehensive telemetry data, ensuring your production data remains secure.
Most modern LLM observability tools add very little latency, usually a few milliseconds per request. Platforms like TrueFoundry optimize telemetry collection using asynchronous logging and lightweight tracing, ensuring observability does not significantly impact production performance or user experience.
For enterprises that require data privacy and infrastructure control, self-hosted observability platforms are often preferred. TrueFoundry and Langfuse are among the strongest self-hosted options because they support secure deployments, flexible integrations, and complete visibility into production LLM workloads and telemetry data.
As a leading LLM observability platform, TrueFoundry captures detailed telemetry data across all production environments. It provides low-latency insights and token cost tracking, helping teams optimize every LLM call. With end-to-end tracing and user feedback loops, it empowers developers to debug complex AI workloads effectively.
While LLM observability tools vary, open source options often allow self-hosting for flexible deployment options. Commercial solutions typically provide managed infrastructure for reliable AI operations. TrueFoundry bridges these needs, offering an enterprise-grade observability solution that protects sensitive information while simplifying data collection and prompt versioning.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















