



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
GPT-6 Astra erschien am 3. September 2026. Der API-String lautet gpt-6-astra – kein datiertes Snapshot, kein separates Alias; auf der Modellseite wird gpt-6-astra sowohl als Snapshot als auch als Alias geführt.
Die Spezifikationen aus der Modell-Dokumentation von OpenAI:
Drei Dinge im Kleingedruckten sind wichtiger als die Hauptschlagzeile.
Erstens: reasoning.effort akzeptiert kein none mehr. GPT-5.6 Sol tat dies noch. Wenn Sie einen günstigen, schnellen Pfad fest auf none eingestellt haben, lässt sich dieser nicht 1:1 übertragen.
Zweitens: temperature, top_p und logprobs wurden entfernt. Im Changelog heißt es, dass Astra „keine benutzerdefinierten temperature- oder top_p-Werte oder Log-Wahrscheinlichkeiten unterstützt.“ Alles in Ihrem Stack, das Sampling-Parameter setzt, muss vor dem Wechsel überprüft werden.
Drittens: Tool Calling erfordert die Responses API. Wenn Sie Tools heute über Chat Completions aufrufen, handelt es sich um eine Migration und nicht um einen einfachen Modelltausch.
[SCREENSHOT: OpenAI Platform – die gpt-6-astra Modellseite mit Kontextfenster, Max Output und Preisen pro Token]
Das Kontextfenster und das Output-Limit haben sich nicht verändert. Der Preis hingegen schon.
Quellen: GPT-6 Astra Modell-Dokumentation, GPT-5.6 Sol Modell-Dokumentation, September 2026. Beachten Sie, dass OpenAI die Tarife von GPT-5.6 Sol als Aktionspreise beschreibt, die mindestens bis zum 21. November 2026 gelten. Das Verhältnis könnte sich nach diesem Datum also ändern.
Jeder Tarif hat sich um exakt denselben Faktor verändert. Das erweist sich für die nachstehende Caching-Frage als entscheidend.
Batch und Flex verbleiben bei 50 % des Standard-Tarifs. Der Fast-Modus, von dem OpenAI angibt, dass er bis zu 2x die Geschwindigkeit der Standard-Verarbeitung liefert, wird mit dem 2-fachen der anwendbaren Tarife berechnet – Fast-Modus Astra kostet somit $20 für Input und $100 für Output.
OpenAI veröffentlicht im Launch-Post eine große Vergleichstabelle. Hier ist der Teil, den zu reproduzieren sich lohnt, gefolgt von dem Teil, den die meisten Berichte überspringen.
Quelle: GPT-6 Astra Launch-Post, September 2026. Die Ergebnisse zeigen den Höchstwert bei beliebigem Reasoning Effort.
Wo Astra eindeutig führt. Bei langwierigen agentischen Aufgaben. Terminal-Bench 4.0 steigt um mehr als zwanzig Punkte gegenüber Sol. Terminal-Bench Science verdreifacht sich nahezu. AutomationBench mehr als verdoppelt sich. Die Retrieval-Leistung bei langem Kontext von 512K-1M steigt von 73,8 % auf 96,3 %. Dies sind die Workloads, für die das Modell entwickelt wurde, und der Abstand ist nicht subtil.
Wo der Abstand zur Nebensache schrumpft. Bei Single-Shot-Wissen und Reasoning. GPQA Diamond verbessert sich von 94,6 % auf 96,0 %. DeepSWE verbessert sich von 72,7 % auf 74,1 %. Wenn Ihr Datenverkehr aus Fragen mit Antworten statt aus Aufgaben mit mehreren Schritten besteht, zahlen Sie den 2,5-fachen Preis für etwa einen Prozentpunkt mehr Leistung.
Wo Astra nicht gewinnt. Bei den beiden zusammengesetzten Drittanbieter-Indizes, die OpenAI in den Vergleich aufgenommen hat, liegt Astra nicht an erster Stelle. Der Artificial Analysis Intelligence Index platziert Claude Fable 5.1 mit 65,7 vor Astra mit 61.2. Der Coding Agent Index sieht Claude Opus 5 mit 68,1 vor Astra mit 67,0. OpenAI hat beide Zahlen veröffentlicht, was für das Unternehmen spricht, und sie bilden das ehrliche Gegengewicht zu den oben genannten agentischen Erfolgen.
Ein Punkt, der die Preisgeschichte verkompliziert. Die Kostenschätzungen von OpenAI pro Aufgabe fallen trotz der 2,5-fachen Tarife manchmal niedriger aus als bei Sol, weil Astra Aufgaben mit weniger Tokens abschließt. Der Launch-Post spricht von schätzungsweise rund 9 % geringeren API-Kosten pro Aufgabe auf Terminal-Bench 4.0 im Vergleich zu Sol, etwa 27 % weniger auf Terminal-Bench Science bei einer kostengünstigeren Einstellung und etwa 43 % weniger auf BenchCAD. Dies sind eigene Schätzungen von OpenAI in spezifischen Konfigurationen, keine unabhängigen Nachprüfungen, und sie lassen sich nicht pauschal auf Ihren Datenverkehr übertragen. Dennoch bedeuten sie, dass „2,5-mal teurer“ die falsche Zusammenfassung für agentische Arbeit ist. Messen Sie Tokens pro erledigter Aufgabe, nicht den Preis pro Token.
TrueFoundry hat die Berechnung zum Cache Break-Even bei GPT-5.6 durchgeführt, als Cache Writes erstmals kostenpflichtig wurden. Dieselbe Frage stellt sich hier, und die Antwort ist interessanter, als es den Anschein hat.
Astras Cache-Multiplikatoren sind identisch mit denen von GPT-5.6. Aus der Modell-Dokumentation geht hervor, dass Cache Writes mit dem 1,25-fachen des ungecasteten Input-Tarifs abgerechnet werden. Der veröffentlichte Cached-Input-Tarif von $1,00 bei einem Input-Tarif von $10,00 entspricht exakt dem 0,10-fachen. Also:
Sei w der Anteil der Anfragen an einen gemeinsamen Präfix, die Cache Writes statt Reads darstellen. Caching erreicht den Break-Even-Punkt, wenn:
1,25w + 0,10(1 - w) = 1
1,15w = 0,90
w = 78,3%
Der Break-Even-Punkt liegt bei 78,3 % und ist damit gegenüber GPT-5.6 unverändert. P kürzt sich heraus, weshalb die 2,5-fache Preiserhöhung hieran nichts ändert. Caching rechnet sich erst dann nicht mehr, wenn mehr als etwa 78 % Ihrer Anfragen an einen bestimmten Präfix Schreibvorgänge sind – das heißt, wenn Ihr gemeinsamer Kontext im Durchschnitt weniger als etwa 1,3 Anfragen übersteht, bevor er geändert wird oder abläuft. Kaum ein realer Agenten-Workload fällt in diesen Bereich.
Was die Preiserhöhung jedoch ändert, ist das Einsparpotenzial. Betrachten wir ein gemeinsames Präfix von 32K Tokens, das über eine Sitzung von 25 Anfragen hinweg wiederverwendet wird – ein Write, vierundzwanzig Reads:
Der Prozentsatz ist identisch. Der absolute Betrag in Dollar ist 2,5-mal so hoch. Caching war schon immer lohnenswert; bei Astra kostet der Verzicht darauf zweieinhalb Mal so viel.
Das Fehlerszenario bleibt ebenfalls unverändert: Kontext, der sich schnell ändert. Wenn Ihr Agent seinen System-Prompt oder sein Tool-Schema alle paar Durchläufe neu aufbaut, zahlen Sie $12,50 pro Million Tokens, um einen Cache zu schreiben, den Sie kaum lesen. Das ist jetzt ein $12,50-Fehler statt eines $5,00-Fehlers.
Das beworbene GPT-6-Kontextfenster beträgt 1.050.000 Tokens. Die Abrechnung skaliert jedoch nicht linear darüber hinaus.
Aus der Modell-Dokumentation: „Prompts mit mehr als 272K Input-Tokens werden mit dem 2-fachen Input- und Cache-Tarif sowie dem 1,5-fachen Output-Tarif für die gesamte Anfrage abgerechnet.“
Lesen Sie das sorgfältig. Es gilt für die gesamte Anfrage, nicht nur für den Überschuss oberhalb von 272K. Das Überschreiten der Grenze kostet Sie nicht das Doppelte für die zusätzlichen Tokens, sondern das Doppelte für alle Tokens der Anfrage.
Eine Erhöhung der Prompt-Größe um 0,7 % führt zu einem Anstieg der Input-Rechnung um 101 %. Cached Reads verdoppeln sich ebenfalls von $1,00 auf $2,00 pro Million, und der Output steigt von $50,00 auf $75,00. GPT-5.6 Sol hat dieselbe Regel, das ist also nicht neu – aber bei den Tarifen von Astra fällt der Sprung 2,5-mal höher aus.
Die praktische Konsequenz: Wenn Ihre Prompts nahe der Marke von 272K liegen, besteht die effektivste Kostenoptimierung darin, sie unter diese Grenze zu bringen. Das Kürzen eines 275K-Prompts um 5K Tokens bringt mehr als jede Routing-Änderung, die Sie vornehmen könnten.
[SCREENSHOT: OpenAI Platform – Dashboard zur Nutzung mit Ausgaben für Input-, Cached-Input- und Output-Tokens nach Modell]
Vier Fehlermodi treten in den ersten Wochen nach dem Start eines neuen Frontier-Modells immer wieder auf – und Astra weist alle vier auf.
Alles wird an das neue Modell geroutet. Das Teuerste, was ein Team nach einem Launch tun kann, ist, den Standard-Pfad darauf umzustellen. Bei $10 Input und $50 Output kostet ein Klassifizierungsaufruf, den ein günstigeres Modell korrekt beantwortet, jetzt das 2,5-fache des Vormonats – ohne Qualitätsgewinn. Die oben gezeigte Benchmark-Verteilung ist ein Argument für eine gemischte Flotte, nicht für eine pauschale Migration.
Die Migration ist kein bloßer String-Wechsel. Kein none-Reasoning-Effort, keine temperature, kein top_p, keine logprobs und ein Tool-Calling, das die Responses API voraussetzt. Code, der mit gpt-5.6-sol funktionierte, kann bei gpt-6-astra auf Weisen fehlschlagen, die erst in der Produktion offensichtlich werden.
Misalignment-Monitoring kann Ihre Anfrage stoppen. OpenAI führt asynchrone Prüfungen bei Agenten-Aufgaben in unterstützten Requests der Responses API durch. Der Launch-Post benennt die Konsequenz explizit: In ChatGPT oder Codex werden Sie möglicherweise gebeten, eine Aktion zu überprüfen, aber „in der API wird die Aufgabe gestoppt.“ OpenAI räumt ein, dass diese Prüfungen „manchmal legitime Arbeit unterbrechen können.“ Das ist eine neue Zuverlässigkeitseigenschaft, für die man planen muss, und keine bloße Fußnote.
Niemand weiß, was es tatsächlich kostet, bis die Rechnung eintrifft. Der Preis pro Token sagt sehr wenig aus, wenn das Modell eine andere Anzahl von Tokens pro Aufgabe verwendet. Ohne Kostenzuordnung pro Anfrage und pro Team lässt sich die Frage „Ist Astra für uns günstiger oder teurer?“ nicht beantworten.
Ein teureres Frontier-Modell schwächt die Notwendigkeit eines Gateways nicht ab. Es stärkt sie, da jede Routing-Entscheidung nun 2,5-mal mehr wert ist.
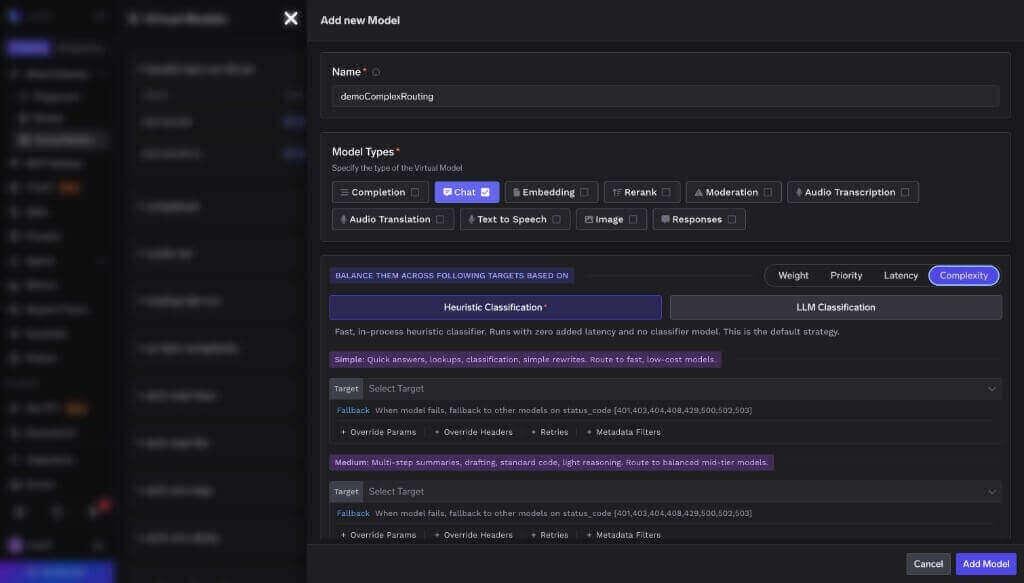
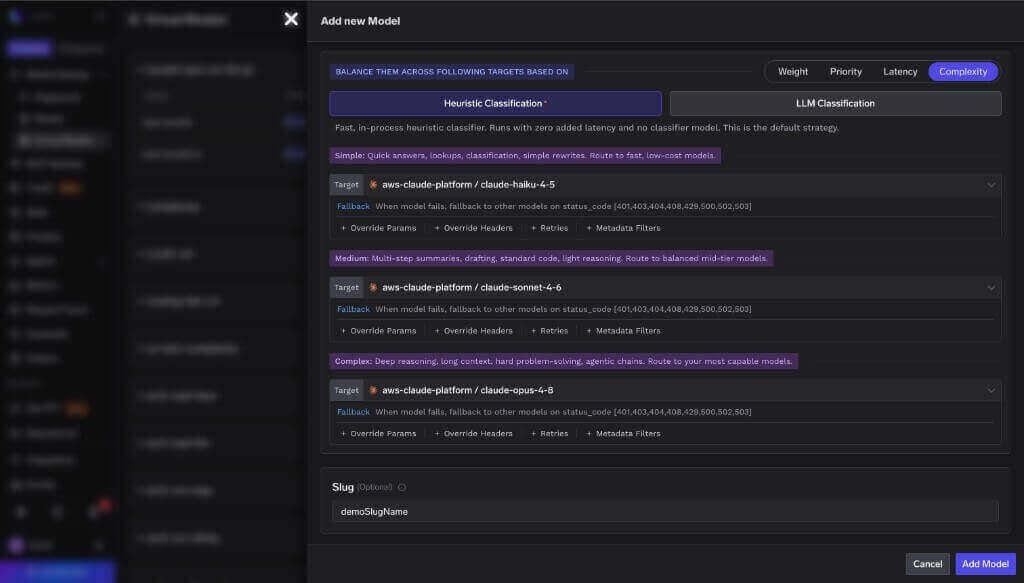
Routen Sie nach Komplexität, nicht nach Gewohnheit. Das AI Gateway klassifiziert eingehende Anfragen und leitet jede an eine passende Stufe weiter, sodass anspruchsvolle agentische Aufgaben bei Astra landen, während Extraktion, Klassifizierung und Zusammenfassung an andere Modelle gehen. Im eigenen Auto-Routing-Benchmark von TrueFoundry über 550 Prompts hinweg senkte dieses Tiering die Kosten um 69 % bei Beibehaltung von 98 % der Baseline-Qualität, wobei die mittlere Latenz von 7,6s auf 4,0s sank. Bei produktionsnahem Datenverkehr erreichte die Einsparung bis zu 80 %. Diese Prozentwerte sind bei Tarifen von $10/$50 erheblich mehr wert als bei $4/$20.
Standardisieren Sie Caching über Anbieter hinweg. Die Cache-Semantik von Astra ist die von OpenAI. Die von Anthropic unterscheidet sich, und die von Bedrock weicht erneut ab. Anbieterunabhängiges Prompt Caching am Gateway bedeutet, dass Sie das Präfix einmal schreiben und die 78,3-%-Regel oben gültig bleibt, unabhängig davon, welches Modell der Router auswählt.
Messen Sie Kosten pro Aufgabe, nicht Kosten pro Token. Die gesamte Preisdiskussion um Astra dreht sich um Token-Effizienz, und das lässt sich nicht anhand einer Preisliste klären. Kosten pro Anfrage, Token-Zahlen und Latenzen, aufgeschlüsselt nach Team und Modell, sind der Weg, um herauszufinden, ob das Versprechen von Astra – weniger Tokens pro Aufgabe – bei Ihrem Workload zutrifft.

Nutzen Sie einen einheitlichen Guardrail-Pfad über alle Modelle hinweg. Guardrails auf Gateway-Ebene werden im Anfrage- und Antwortpfad ausgeführt, unabhängig davon, welches Modell antwortet. So ändert eine Routing-Anpassung nicht stillschweigend Ihre Sicherheitsanforderungen.

Die Kurzfassung, Stand September 2026:

GPT-6 Astra ist ein echter Fortschritt bei den Aufgaben, für die es entwickelt wurde. Terminal-Bench 4.0 um zwanzig Punkte verbessert, Long-Context-Retrieval um zweiundzwanzig Punkte zugelegt, AutomationBench mehr als verdoppelt – das sind keine marginalen Schritte. Bei den von OpenAI selbst veröffentlichten Drittanbieter-Indizes liegt das Modell jedoch nicht an der Spitze, und bei Single-Shot-Wissensfragen ist der Unterschied zu GPT-5.6 Sol kaum mehr als ein Rundungsfehler.
Die Preisgestaltung spiegelt dieses geteilte Bild wider. Jeder Tarif stieg um das 2,5-fache, was nach einer einfachen Preiserhöhung klingt – bis man feststellt, dass die eigenen Schätzungen von OpenAI pro Aufgabe bei mehreren agentischen Benchmarks niedriger ausfallen als bei Sol, weil Astra weniger Tokens benötigt. Beide Aussagen können zutreffen. Welche davon auf Sie zutrifft, ist eine empirische Frage bezüglich Ihres Datenverkehrs. Die einzige Möglichkeit, sie zu beantworten, besteht darin, beide Modelle laufen zu lassen und die Kosten pro erledigter Aufgabe zu messen.
Zwei Dinge erfordern keine Messung. Caching lohnt sich weiterhin ab genau demselben Break-Even-Punkt von 78,3 % wie bei GPT-5.6. Wenn Sie heute cachen, behalten Sie das bei. Und die Abrechnungsklippe bei 272K ist eine Stufenfunktion, die die Input-Rechnung für einen Prompt, der nur um wenige tausend Tokens gewachsen ist, stillschweigend verdoppelt.
Es läuft also darauf hinaus, wie Sie Ihre Infrastruktur aufbauen möchten. Wenn Sie ein einzelnes Modell und eine einfache Rechnung bevorzugen, leiten Sie alles an Astra und akzeptieren Sie, dass Sie für die einfache Hälfte Ihres Datenverkehrs zu viel bezahlen. Wenn Sie schwierige Aufgaben lieber an das Frontier-Modell und alles andere an günstigere Alternativen senden möchten, benötigen Sie eine Routing-Schicht – und bei $10 Input sowie $50 Output ist das Argument für den Aufbau einer solchen Schicht gerade zweieinhalb Mal überzeugender geworden.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.




GPT-6 Astra ist das Frontier-Modell von OpenAI, veröffentlicht am 3. September 2026 und in der API als gpt-6-astra aufrufbar. Es ist über die OpenAI API, Microsoft Azure und AWS Bedrock verfügbar sowie für Nutzer von ChatGPT Plus, Pro, Business und Enterprise.
Stand September 2026, pro 1 Mio. Tokens: 10,00 $ Input, 1,00 $ gecachter Input, 12,50 $ Cache-Schreibvorgänge, 50,00 $ Output. Batch und Flex kosten 50 % dieser Preise; der Fast-Modus das Doppelte. Anfragen mit mehr als 272K Input-Tokens werden für die gesamte Anfrage zum 2-fachen Input- und Cache-Preis und zum 1,5-fachen Output-Preis abgerechnet.
1.050.000 Tokens, bei einer maximalen Ausgabe von 128.000 Tokens. Beides ist identisch mit GPT-5.6 Sol. Die praktische Grenze ist eher kommerziell als technisch: Ab 272K Input-Tokens wird die gesamte Anfrage zum doppelten Input-Preis abgerechnet.
Das hängt ganz von der Art der Aufgabe ab. Bei agentischer Arbeit mit langem Horizont sind die Zugewinne groß – Terminal-Bench 4.0 steigt von 37,3 % auf 57,9 %. Bei einzelnen Wissensfragen sind sie marginal, und Sie zahlen dafür das 2,5-Fache pro Token. Routen Sie entsprechend, statt pauschal umzustellen.
Ja, und zwar im selben Maß. Cache-Schreibvorgänge kosten das 1,25-Fache des Input-Preises und Lesevorgänge das 0,10-Fache, genau wie bei GPT-5.6, sodass der Break-even in beiden Fällen bei einem Schreibanteil von 78,3 % liegt. Höhere Listenpreise erhöhen die absoluten Einsparungen, nicht die Schwelle.
Das AI Gateway von TrueFoundry fügt etwa 3–4 ms hinzu und bewältigt mehr als 350 RPS auf 1 vCPU – unerheblich im Vergleich zu Generierungszeiten von mehreren Sekunden.



Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















