November 5, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Entwickeln eines Agents umfasst mehr als nur das Verbinden eines LLMs mit ein paar Tools. Sie müssen auch entscheiden, wie der Agent den Zustand verwaltet, mit Kontext umgeht, Tools aufruft, Aufgaben ausführt und bestimmt, was als Nächstes zu tun ist.
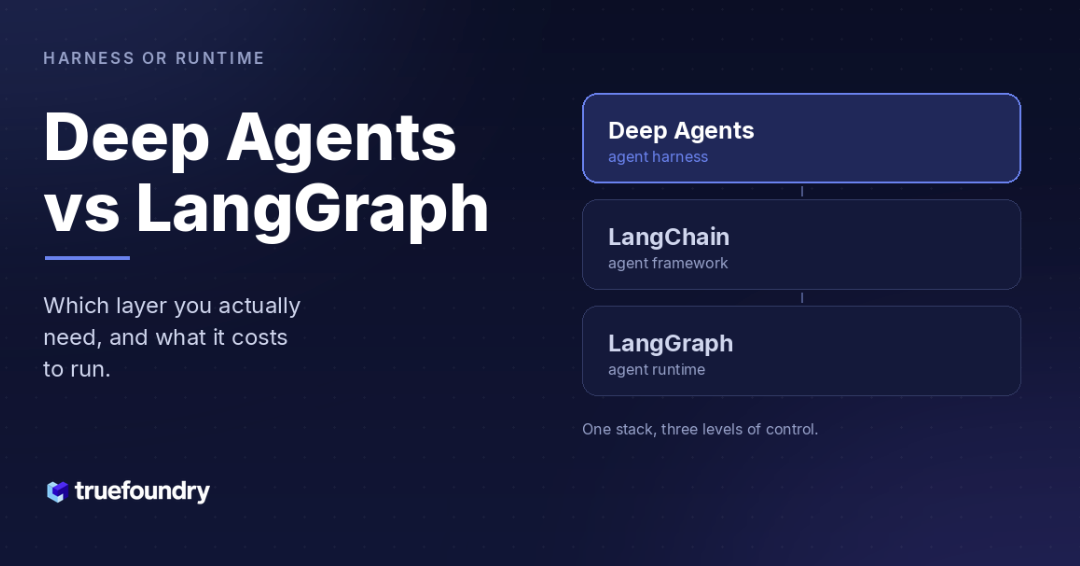
LangGraph und Deep Agents lösen diese Probleme auf unterschiedlichen Abstraktionsebenen. LangGraph bietet Entwicklern die Primitiven zur Definition und Steuerung des Ausführungspfads eines Agents, während Deep Agents einen höherwertigen, vorgefertigten Agent Harness auf LangGraph bereitstellt.
Beide lösen dasselbe zugrunde liegende Problem. Ein Modell denkt nach, kann aber nicht handeln. Es wird keine Datei öffnen, keine API aufrufen, keinen eben geschriebenen Code ausführen oder sich daran erinnern, was es vor vier Schritten entschieden hat. Etwas muss sich um das Modell legen und diese Lücke schließen – und zwar so lange, wie die Aufgabe dauert. LangGraph liefert Ihnen die Bausteine, um diese Komponente zu bauen. Deep Agents übergibt sie Ihnen bezugsfertig montiert.
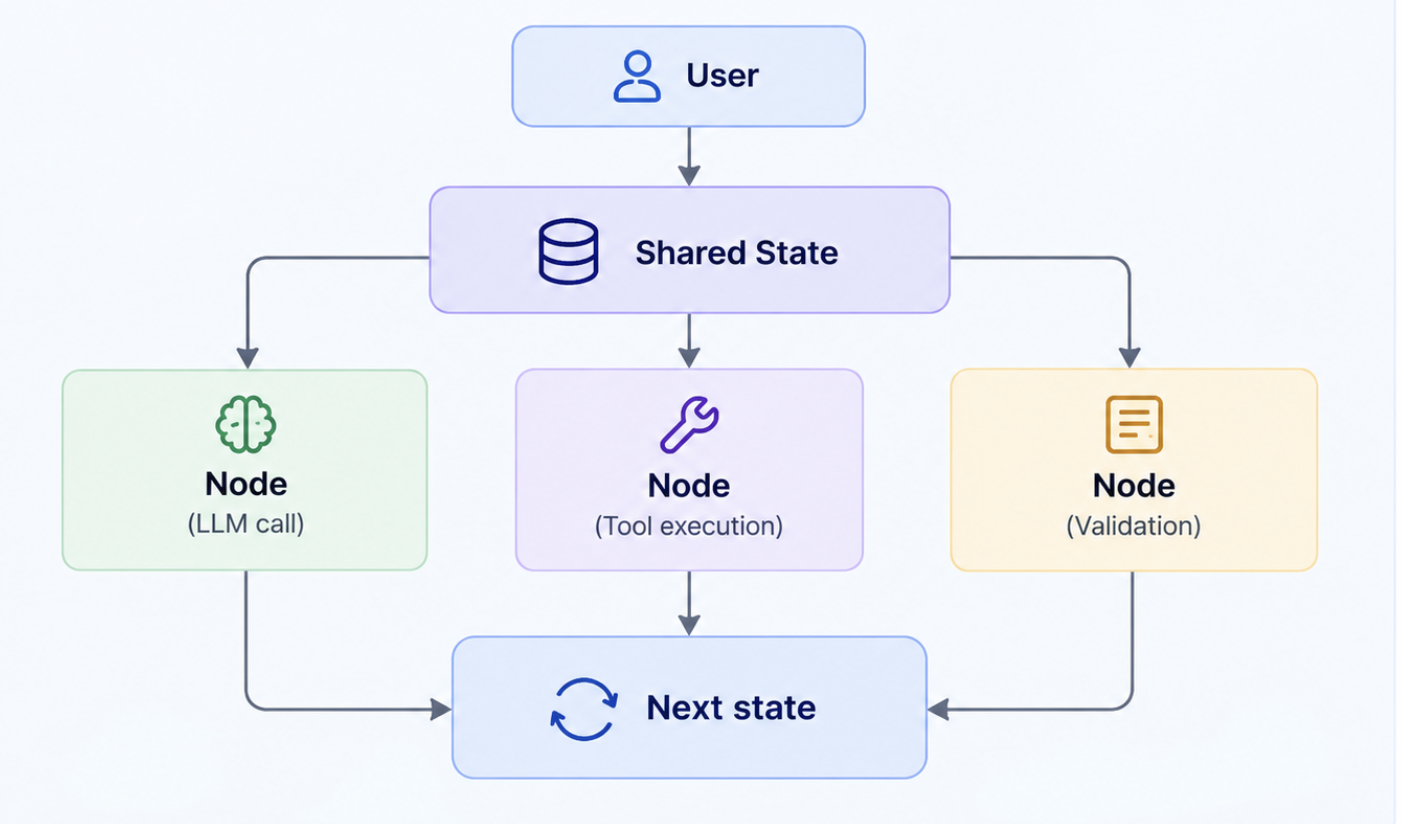
LangGraph ist eine Agent-Runtime. Sie modellieren den Workflow als gerichteten Graphen: Knoten sind diskrete Operationen, Kanten definieren, was als Nächstes ausgeführt wird, und ein typisiertes Zustands-Schema zieht sich durch jeden Schritt. Die Ausführung durchläuft Ihre Struktur, bis ein Knoten END zurückgibt.
Eine LangGraph-Implementierung sieht typischerweise so aus:
Die Checkpointer und Interrupts sind hier die echten Alleinstellungsmerkmale – und sie sind der Grund, warum LangGraph unter fast allem im LangChain-Stack liegt. Sowohl create_agent von LangChain als auch Deep Agents laufen darauf.
Das eigene Beispiel von LangChain ist eine Pipeline für Mietanträge: Einkommen und Kredithistorie aus Dokumenten extrahieren, gegen die Kriterien des Vermieters prüfen und dann Grenzfälle automatisch genehmigen, ablehnen oder eskalieren. Nur der erste Schritt nutzt ein LLM. Der Rest ist fester Code – und sollte es auch bleiben.
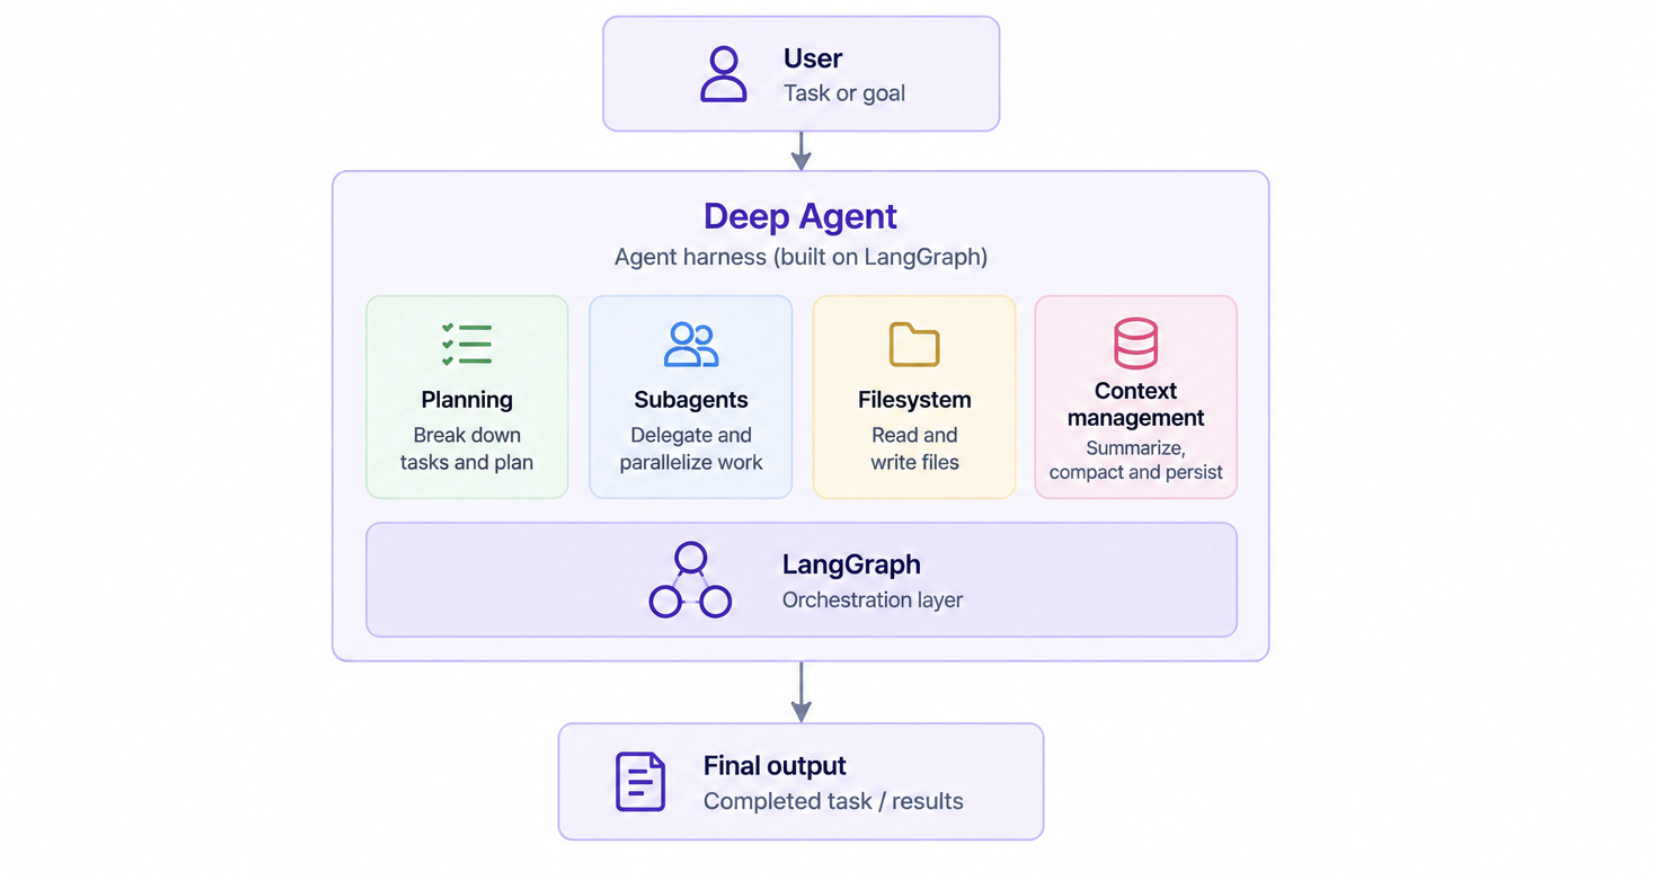
Deep Agents ist ein Agent Harness. Es nutzt dieselbe Kernschleife wie create_agent von LangChain, ist jedoch meinungsstark (opinionated) konzipiert und bringt standardmäßig bewährte Context-Engineering-Praktiken mit. LangChain beschreibt es als den Kern-Agenten zusammen mit einer Reihe von Middleware; darunter bleibt es weiterhin ein LangGraph-Graph.
Was direkt mitgeliefert wird:
Sie erhalten einen Agenten von create_deep_agent mit einem Modell, einer Reihe von Tools und einem System-Prompt. Sie müssen keinen Graphen erstellen.
Der Unterschied zu LangGraph liegt darin, wer die Schleife schreibt. Bei LangGraph deklarieren Sie die Knoten und Bedingungen; die Ablaufsteuerung gehört Ihnen. Bei Deep Agents liefern Sie Tools sowie Anweisungen und drücken auf Start – das Modell entscheidet, was als Nächstes innerhalb einer Schleife passiert, die jemand anderes geschrieben hat. Wenn Sie die ausführlichere Variante dieser Differenzierung lesen möchten, haben wir dies separat unter Agent Harness vs. Agent Framework aufbereitet.
Beide zielen auf dasselbe Ergebnis ab, sitzen aber an unterschiedlichen Stellen im selben Stack. Deshalb lässt sich die Frage „Was ist besser?“ nicht pauschal beantworten. Der eine Ansatz verlangt von Ihnen, das Verhalten des Agents zu entwerfen. Der andere nimmt Ihnen den Großteil ab – und berechnet Ihnen Tokens für die Teile, die großzügig ausgelegt wurden.
LangChain Deep Agents nimmt Ihnen einen Großteil der schwierigen Arbeit innerhalb eines einzelnen Agenten ab – darunter Planung, Subagents, Dateisystem-Tools, Skills, Memory und langlaufende Ausführungen. Sobald Sie jedoch Agenten über mehrere Teams hinweg betreiben, verlagert sich die Herausforderung vom Bauen des einzelnen Agenten hin zum Betrieb der gesamten Flotte.
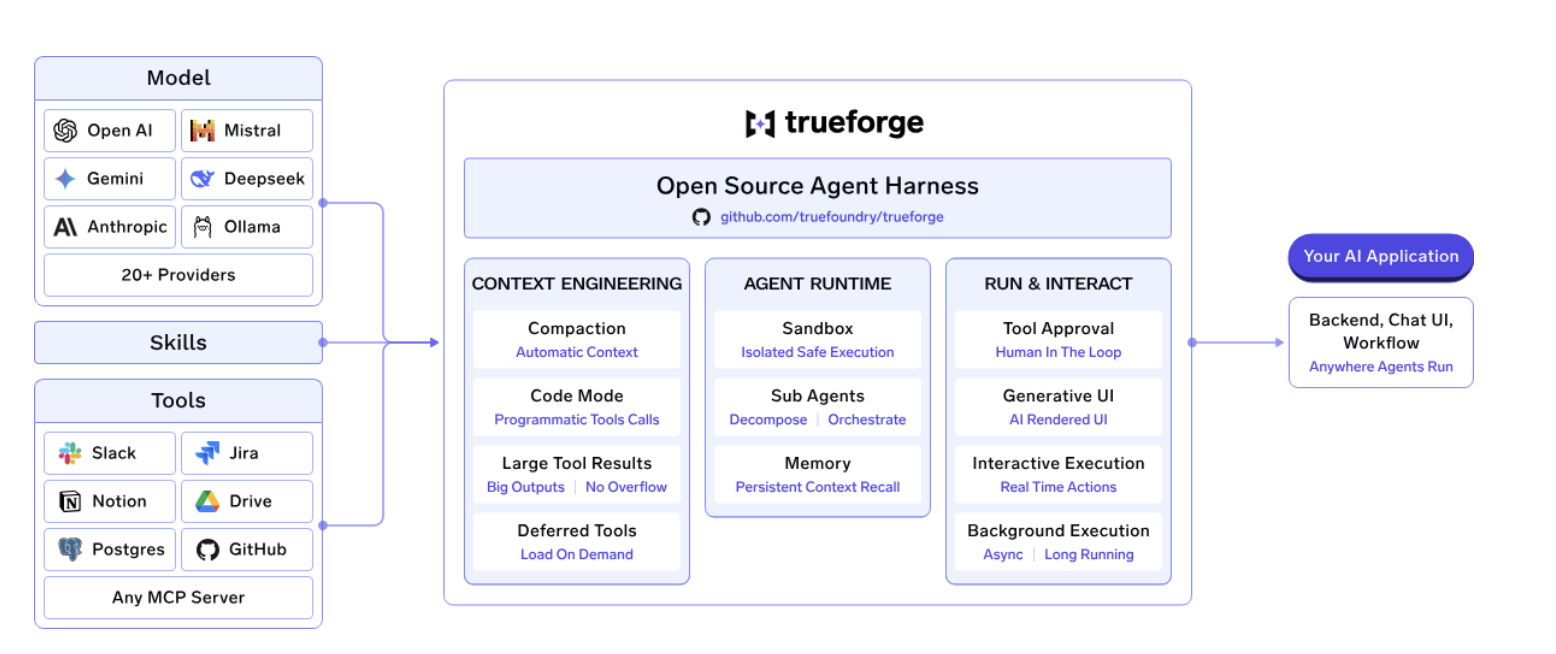
TrueForge ist der herstellerneutrale Open-Source-Agent-Harness von TrueFoundry für genau diese Runtime-Schicht. TrueForge führt die Agent-Schleife um das Modell herum aus – inklusive Planung, Tool-Aufrufen, Kontextmanagement, Freigaben und Sitzungszustand –, während Sie Ihre eigenen Modelle, MCP-Server und Sandbox-Anbieter einbinden können.
Sie können es lokal mit npx @truefoundry/trueforge ausführen oder denselben Harness für ein Team mittels Docker Compose oder Helm bereitstellen. Siehe die TrueForge-Dokumentation.
TrueForge bietet zudem mehrere Mechanismen zur Steuerung der Menge an Kontext- und Tool-Daten, die an das Modell übermittelt werden.
Deferred Tool Loading bedeutet, dass MCP-Tool-Schemata bei Bedarf geladen werden, anstatt das Context Window vorab zu füllen. Im Code Mode kann der Agent mehrere Tool-Aufrufe innerhalb eines Sandbox-Skripts verketten, sodass nur die ausgegebene Zusammenfassung in den Kontext gelangt und nicht jedes Zwischenergebnis. Zu große Tool-Antworten werden ausgelagert in eine Sandbox-Datei und durch einen Pfad sowie eine Vorschau ersetzt. Die Kompaktierung (Compaction) wird bei 80 % der Kontextlänge des Modells ausgelöst und tauscht alte Historie gegen eine strukturierte Zusammenfassung aus – die direkte Antwort auf das Replay-Problem. Subagents laufen mit ihrem eigenen, sauberen Kontext und liefern nur das Endergebnis zurück.
Das Sandbox-Modell ist der zweite Hebel. Die meisten Harness-Lösungen hüllen die gesamte Sitzung in einen Container. TrueForge behandelt die Sandbox als Tool und startet erst dann eine Instanz, wenn der Agent tatsächlich Code ausführen muss. So kann ein Server viele Agenten gleichzeitig ausführen, und Schritte, die keinen Code berühren, bleiben kostengünstig.
TrueForge ist als Runtime strukturiert und nicht nur als reine Bibliotheks-Schnittstelle.
Der Core Server führt die Agent-Schleife aus und bietet Streaming, Freigabe-Schranken (Approval Gates), Subagent-Delegierung, Kompaktierung und persistente Sitzungen. Eine HTTP-API und ein TypeScript-SDK (@truefoundry/trueforge-sdk) stellen dieselben Funktionen programmatisch bereit. Eine separate Chat-UI und ein UI-SDK (@truefoundry/trueforge-ui) können direkt genutzt, angepasst oder in ein anderes Produkt eingebettet werden.
Dies bietet Teams eine Bereitstellungsfläche über die reine Python-Agenten-Definition hinaus: Dieselbe Runtime kann eine Anwendung, eine API oder eine eingebettete Agent-Experience antreiben.
Modelle, MCP-Server und Sandbox-Anbieter basieren vollständig auf dem Prinzip Bring-Your-Own. Wenn ein günstigeres Modell erscheint, verweisen Sie einfach darauf, anstatt den Agenten umzuschreiben. So konnte derselbe Benchmark-Durchlauf auf GLM-5.2 dieselben ~11 von 14 Aufgaben für 2,90 $ pro Durchlauf lösen.
Der Unterschied zwischen einem Agent Framework und einer Agent Runtime wird deutlicher, wenn man sie auf denselben Workloads vergleicht. TrueFoundry hat TrueForge und Deep Agents auf dem Enterprise-Bench von DevRev getestet, der aus 14 systemübergreifenden Unternehmensaufgaben besteht. Jede Aufgabe erfordert vom Agenten das Planen, den Aufruf von MCP-Tools über ein CRM, einen Projekt-Tracker und einen Dokumentenspeicher hinweg, das Zusammenführen der Ergebnisse und das Liefern einer Antwort, die das Evaluierungsschema erfüllt. Beide Harness-Systeme führten dieselben Aufgaben mit denselben MCP-Servern aus; die Antworten wurden verdeckt von einem LLM-Richter bewertet.
Bei konstantem Einsatz von Opus 4.8 erzielten beide Harness-Systeme eine ähnliche Genauigkeit bei den Aufgaben, ihre Ausführungskosten unterschieden sich jedoch erheblich:
Der Benchmark zeigt einen vergleichsweise geringen Unterschied bei der Aufgabengenauigkeit, aber einen gravierenden Unterschied bei den Ausführungskosten. TrueForge verbrauchte weniger als ein Viertel der Tokens im Vergleich zu Deep Agents und war bei demselben Modell rund 2,5-mal günstiger pro Durchlauf.
Der Unterschied resultiert weitgehend daraus, wie die beiden Runtimes Orchestrierung und Kontext handhaben. Deep Agents bietet Funktionen wie Planung, ein virtuelles Dateisystem und Subagents; diese können jedoch bei jedem Schritt zusätzliche Orchestrierung und Kontext erzeugen. TrueForge verfolgt einen schlankeren Ansatz mit gezielten Tool-Aufrufen und Kontext-Kompaktierung, um zu verhindern, dass große Historien und Tool-Antworten wiederholt an das Modell gesendet werden. Dies ist entscheidend, da die Kosten eines Agents nicht allein durch den Modellpreis bestimmt werden. Zwei Agenten-Systeme, die dasselbe Modell nutzen, können je nach Implementierung von Planung, Tool-Nutzung, Kontextmanagement und Subagents einen völlig unterschiedlichen Token-Verbrauch aufweisen.
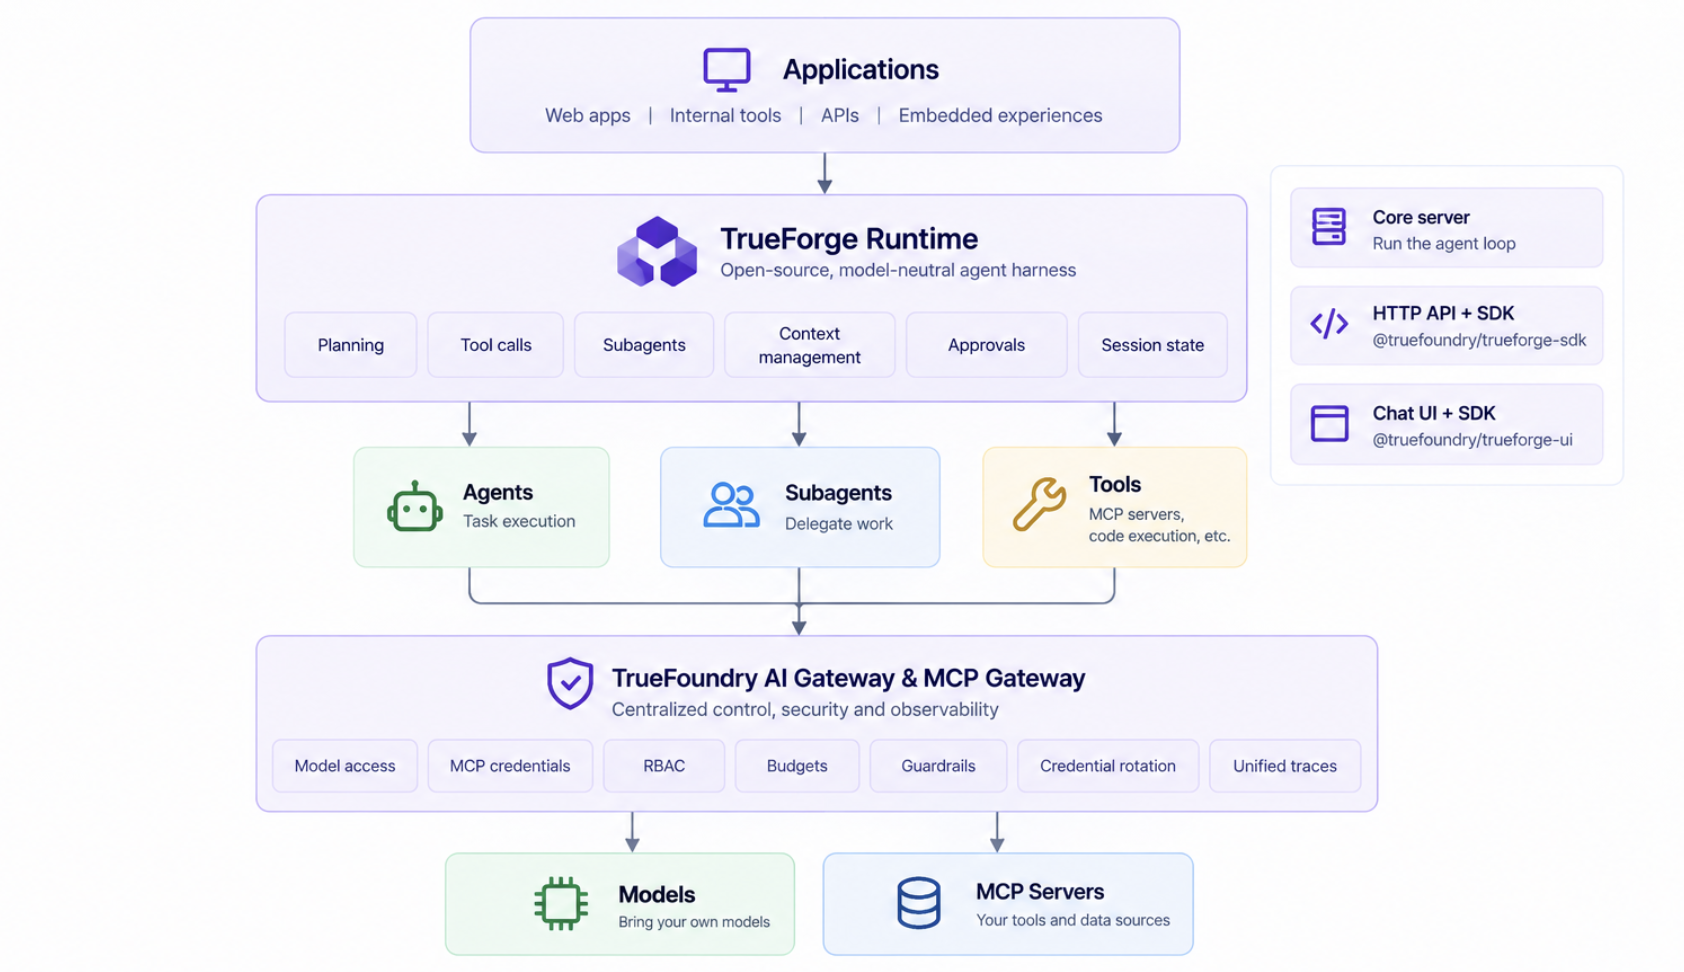
TrueForge lässt sich auch mit dem AI Gateway und MCP Gateway von TrueFoundry verbinden, um Kontrollmechanismen bereitzustellen, die wichtig werden, sobald Agenten keine isolierten Projekte mehr sind. Dazu gehören zentralisierter Modellzugriff, MCP-Anmeldedaten, RBAC, Budgets, Guardrails, Credential-Rotation und einheitliche Traces. Dadurch werden diese Aspekte aus den einzelnen Agenten-Definitionen herausgelöst und in eine gemeinsame Plattformschicht verlagert.
Für Teams, die Deep Agents für den Produktionseinsatz evaluieren, ist der Benchmark eine nützliche Erinnerung daran, dass das Framework nur ein Teil des Stacks ist. Die Runtime-Architektur um den Agenten herum kann erhebliche Auswirkungen auf Token-Verbrauch, Latenz und Kosten haben. TrueForge ist darauf ausgelegt, genau diese Runtime-Schicht bereitzustellen und gleichzeitig die Wahl von Modell und Infrastruktur offenzuhalten.
Greifen Sie zu LangGraph, wenn die Struktur des Graphen der eigentliche Wert ist. Wenn Sie Compliance-Schranken an spezifischen Knoten, bedingte Schleifen zurück zu früheren Phasen oder eine Pipeline benötigen, in der nur ein einziger Schritt jemals ein Modell berühren darf. Wenn Sie bereits LangGraph nutzen und Ihr Ablauf eine echte Graphenstruktur hat, bleiben Sie dabei.
Greifen Sie zu einem Harness, wenn Sie merken, dass Sie manuell eine Schleife bauen, die andernorts bereits existiert. Dann stellt sich nur die Frage, welcher Harness zu wählen ist – und das ist eine Frage des Kontextmanagements. Lesen Sie daher die Dokumentation zu Kompaktierung, Auslagerung und Deferred Loading, bevor Sie sich festlegen. Wenn dort nichts davon erwähnt wird, haben Sie es mit einem Framework zu tun, das sich lediglich als Harness bezeichnet.
Greifen Sie speziell zu deepagents, wenn Sie das Ökosystem und die Abstraktionen von LangChain nutzen möchten und das Token-Profil für Ihre Workloads akzeptabel ist. Bei kurzen Durchläufen macht sich der Unterschied kaum bemerkbar.
Greifen Sie zu TrueForge, wenn langlaufende Prozesse der Normalfall sind, wenn Sie eine HTTP-API oder eine eingebettete Benutzeroberfläche statt einer Bibliothek benötigen, wenn Sie eine MIT-Lizenz ohne Bindung an ein bestimmtes Ökosystem bevorzugen oder wenn die Kosten pro Durchlauf einer Prüfung durch die Finanzabteilung standhalten müssen. Unsere Übersicht zu LangGraph-Alternativen deckt die Optionen auf Framework-Ebene ab, falls sich herausstellt, dass Sie eigentlich diese Schicht benötigen.
Oft lautet die Antwort auch: beides. Ein Framework übernimmt die Orchestrierung zwischen Agenten oder den deterministischen Workflow, in dem ein Harness-gesteuerter Agent sitzt. Ein Harness führt die Agenten selbst aus. Die beiden typischen Fehlentscheidungen, die Sie vermeiden sollten, sind: die Nutzung eines Frameworks zum Nachbauen einer Schleife, die Sie hätten erben können, und das Erzwingen einer starren Compliance-Sequenz in einem Harness, indem Sie diese in einen Prompt schreiben und auf das Beste hoffen.
F: Was ist der Unterschied zwischen Deep Agents und LangGraph?
A: LangGraph ist eine Agent-Runtime und Deep Agents ein darauf aufgebauter Agent Harness. Bei LangGraph deklarieren Sie Knoten, Kanten sowie Zustand und schreiben die Ablaufsteuerung selbst. Bei Deep Agents ist die Schleife bereits vorgefertigt – zusammen mit einem Dateisystem, Subagents, Skills und Memory –, sodass Sie stattdessen Tools und Anweisungen bereitstellen. Deep Agents kompiliert im Hintergrund zu einem LangGraph-Graphen.
F: Ersetzt Deep Agents LangGraph?
A: Nein, das ist technisch nicht möglich, da es auf LangGraph basiert. Ein Harness bietet eine feste Schleife, die von einem Modell gesteuert wird. Wenn Ihr Workflow eine beliebige Topologie, Validierungs-Schranken an benannten Knoten oder bedingte Schleifen zurück zu früheren Phasen erfordert, kann kein Harness dies abbilden – LangGraph bleibt in diesem Fall das richtige Werkzeug. Viele Produktivsysteme nutzen beides auf unterschiedlichen Ebenen.
F: Was ist im Betrieb günstiger: deepagents oder ein anderer Harness?
A: In unserem Enterprise-Bench-Durchlauf verbrauchte deepagents auf Opus 4.8 16,5 Mio. Tokens und kostete 21 $ pro Durchlauf. TrueForge benötigte beim selben Modell und denselben 14 Aufgaben 3,8 Mio. Tokens und kostete 8,50 $, bei einer Abweichung in der Genauigkeit von nur einer Aufgabe. Der Unterschied liegt im erneuten Abspielen des aufgelaufenen Kontextes anstelle einer Kompaktierung sowie im Scaffolding, das bei jedem Schritt mitgeführt wird.
F: Kann ich beide Lösungen in meiner eigenen VPC oder On-Premises ausführen?
A: Ja. Beide sind als Open Source selbst hostbar. TrueForge startet lokal über einen einzigen npx-Befehl oder mittels Docker Compose und Helm für Team-Deployments mit Postgres, Redis, Replikaten und OIDC-Login. Die verwaltete Plattform von TrueFoundry läuft ebenfalls Self-Hosted, On-Premises, Air-Gapped oder hybrid, sodass keine Daten Ihre Domain verlassen.
F: Wie verwalte ich Modelle und MCP-Server über viele Agenten hinweg?
A: Über eine Gateway-Schicht, sobald selbstverwaltete Schlüssel nicht mehr skalieren. Das AI Gateway von TrueFoundry stellt über 1.000 LLMs hinter einer einzigen OpenAI-kompatiblen API bereit – bei etwa 3 bis 4 ms zusätzlicher Latenz und über 350 RPS auf einer einzelnen vCPU, inklusive RBAC, Budgets, Guardrails und Credential-Rotation sowie OpenTelemetry-Traces für Grafana, Datadog oder Prometheus. Agenten, die auf LangGraph, deepagents oder anderen Systemen aufbauen, werden auf dieselbe Weise verwaltet.
Die Entscheidung Deep Agents vs. LangGraph hängt davon ab, auf welcher Ebene Ihr Problem angesiedelt ist. Das lässt sich mit einer Frage klären: Hat der Pfad des Agents eine feste Struktur, die Sie definieren möchten, oder ergibt er sich erst im Laufe des Prozesses?
Wenn er eine Struktur hat: LangGraph. Wenn nicht, benötigen Sie einen Harness – und dann entscheidet sich das System daran, was dieser Harness bei Schritt vierzig mit Ihrem Context Window macht. Das zu messen lohnt sich, bevor Sie darauf aufbauen.
npx @truefoundry/trueforge bringt Ihnen in etwa einer Minute einen laufenden Agenten, oder sehen Sie sich an, wie TrueForge Kontext bei langlaufenden Prozessen handhabt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet