



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
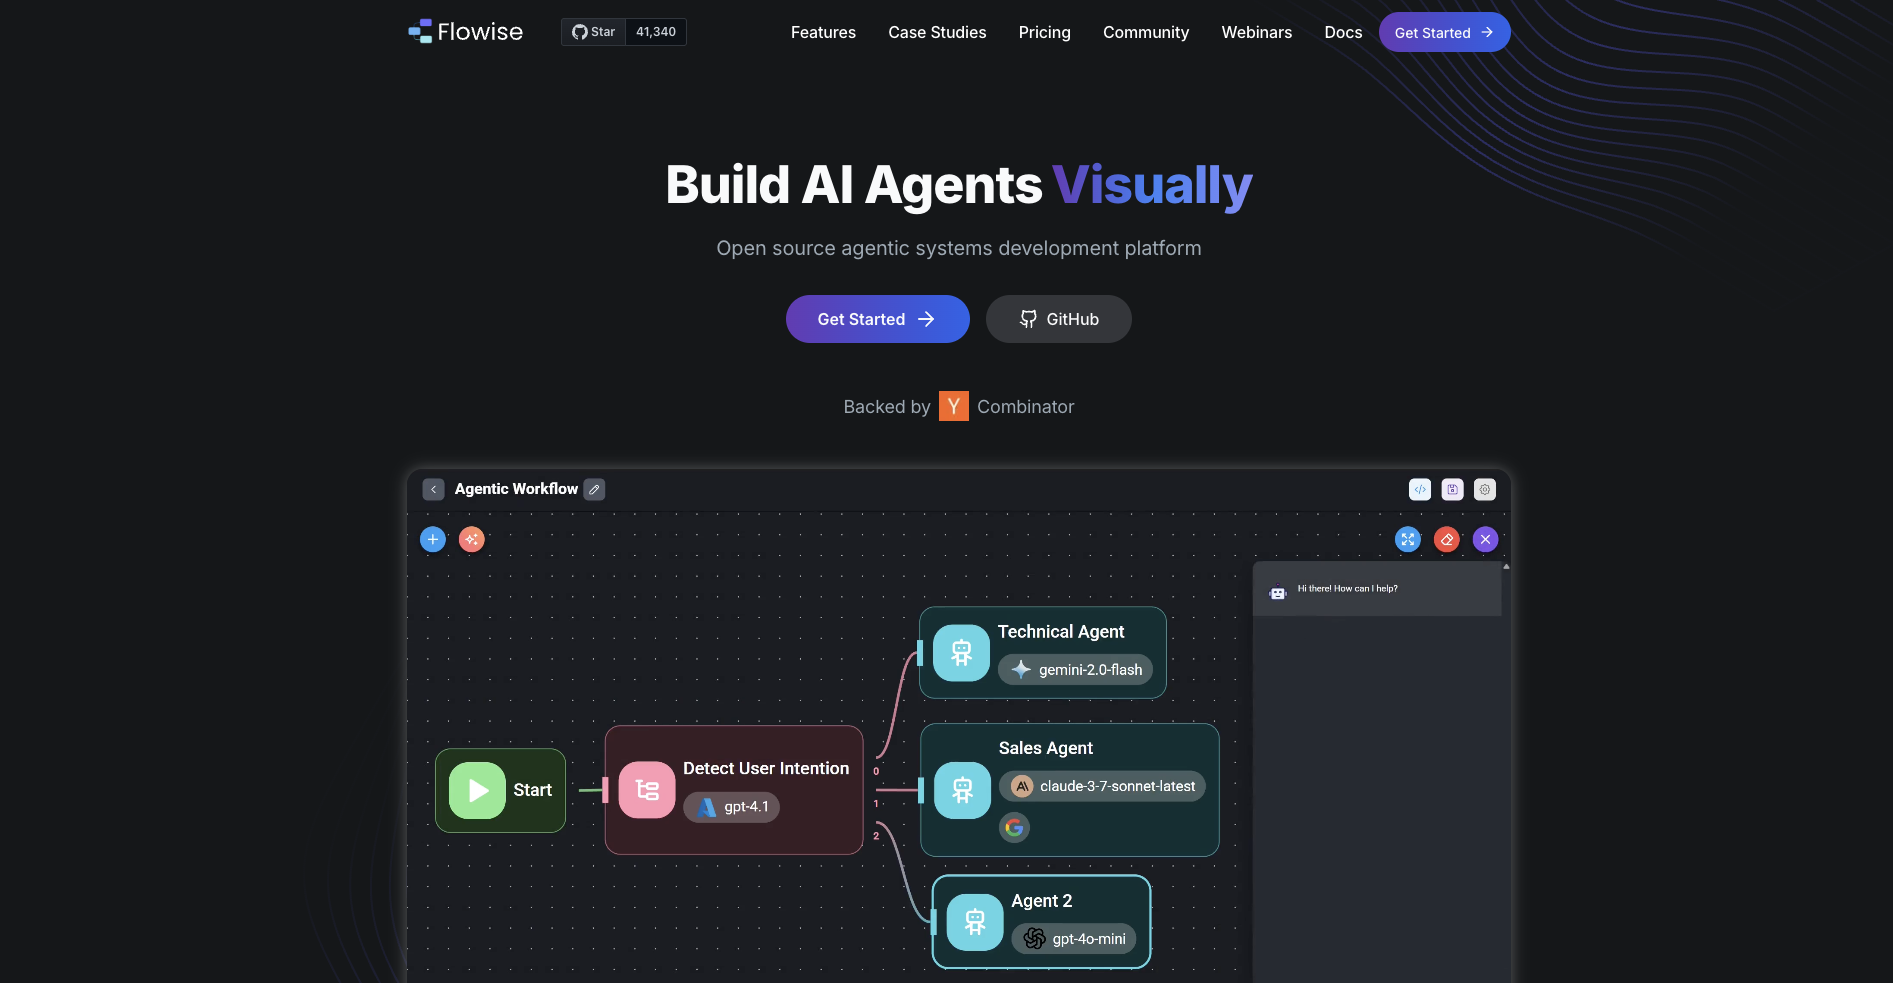
Low‑Code-Builder wie Flowise haben stark an Beliebtheit gewonnen, weil sie schnell sind. Der Drag-and-Drop-Canvas ermöglicht es Data Scientists und Produktmanagern, Prompts, Tools, Vektorsuche und mehrstufige Agenten miteinander zu verknüpfen – ganz ohne Python. Proof-of-Concepts sind in Stunden statt Wochen einsatzbereit. Doch wenn diese Prototypen echten Mehrwert liefern, zeigt sich die versteckte Kehrseite: Jeder Node ruft einen anderen Modell-Endpunkt auf, jeweils mit eigenem API-Key, eigenen Nutzungs-Logs und einer eigenen Zeile auf der Firmenkreditkarte. Multipliziert man das über Teams und Experimente hinweg, kann niemand mehr die grundlegenden Fragen beantworten: Wer hat was aufgerufen? Wie viel hat es gekostet? War es sicher?
Genau dieses Problem löst das TrueFoundry AI Gateway. Es verarbeitet täglich über eine Million LLM-Aufrufe für Unternehmen und wendet dabei Authentifizierung auf Projektebene, Kostenkontrollen pro Anfrage, Latenz-SLOs und vollständige Audit-Trails an – unabhängig davon, ob Sie GPT-5, Claude 4, Mistral oder ein internes, feinabgestimmtes Modell nutzen. Teams haben uns gebeten, dieselben Guardrails auch für Flowise-Agenten bereitzustellen. Hier ist der ausführliche Blogbeitrag zum Thema: Warum Low-Code-Agenten hinter das Gateway gehören
Das ist dieselbe Governance, die wir bereits auf geschäftskritischen Traffic (>1M Aufrufe/Tag) anwenden. Die Integration von Flowise weitet diese einfach auf Ihre Low-Code-Experimente aus. Einen kurzen Überblick über das AI Gateway von TrueFoundry finden Sie hier: Link
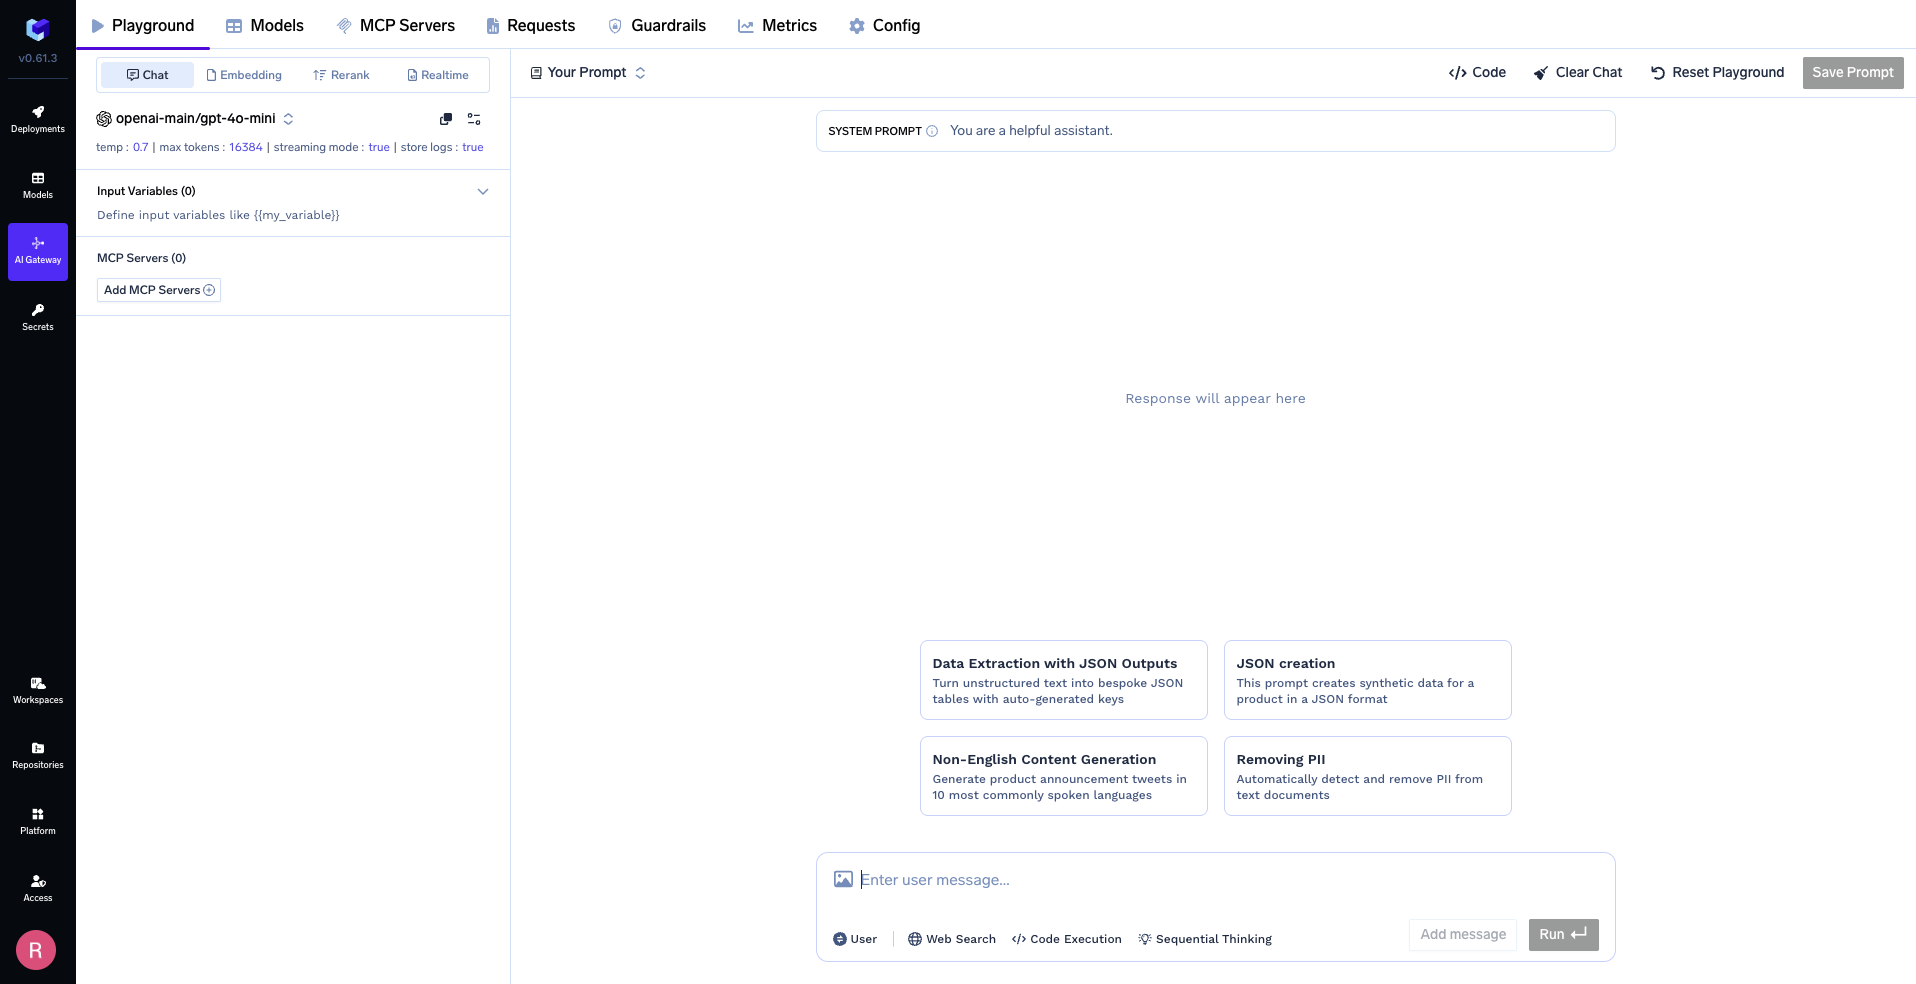
Voraussetzungen
Einrichtung in zwei kurzen Schritten
Eine detaillierte Anleitung mit Screenshots finden Sie in unserer Dokumentation
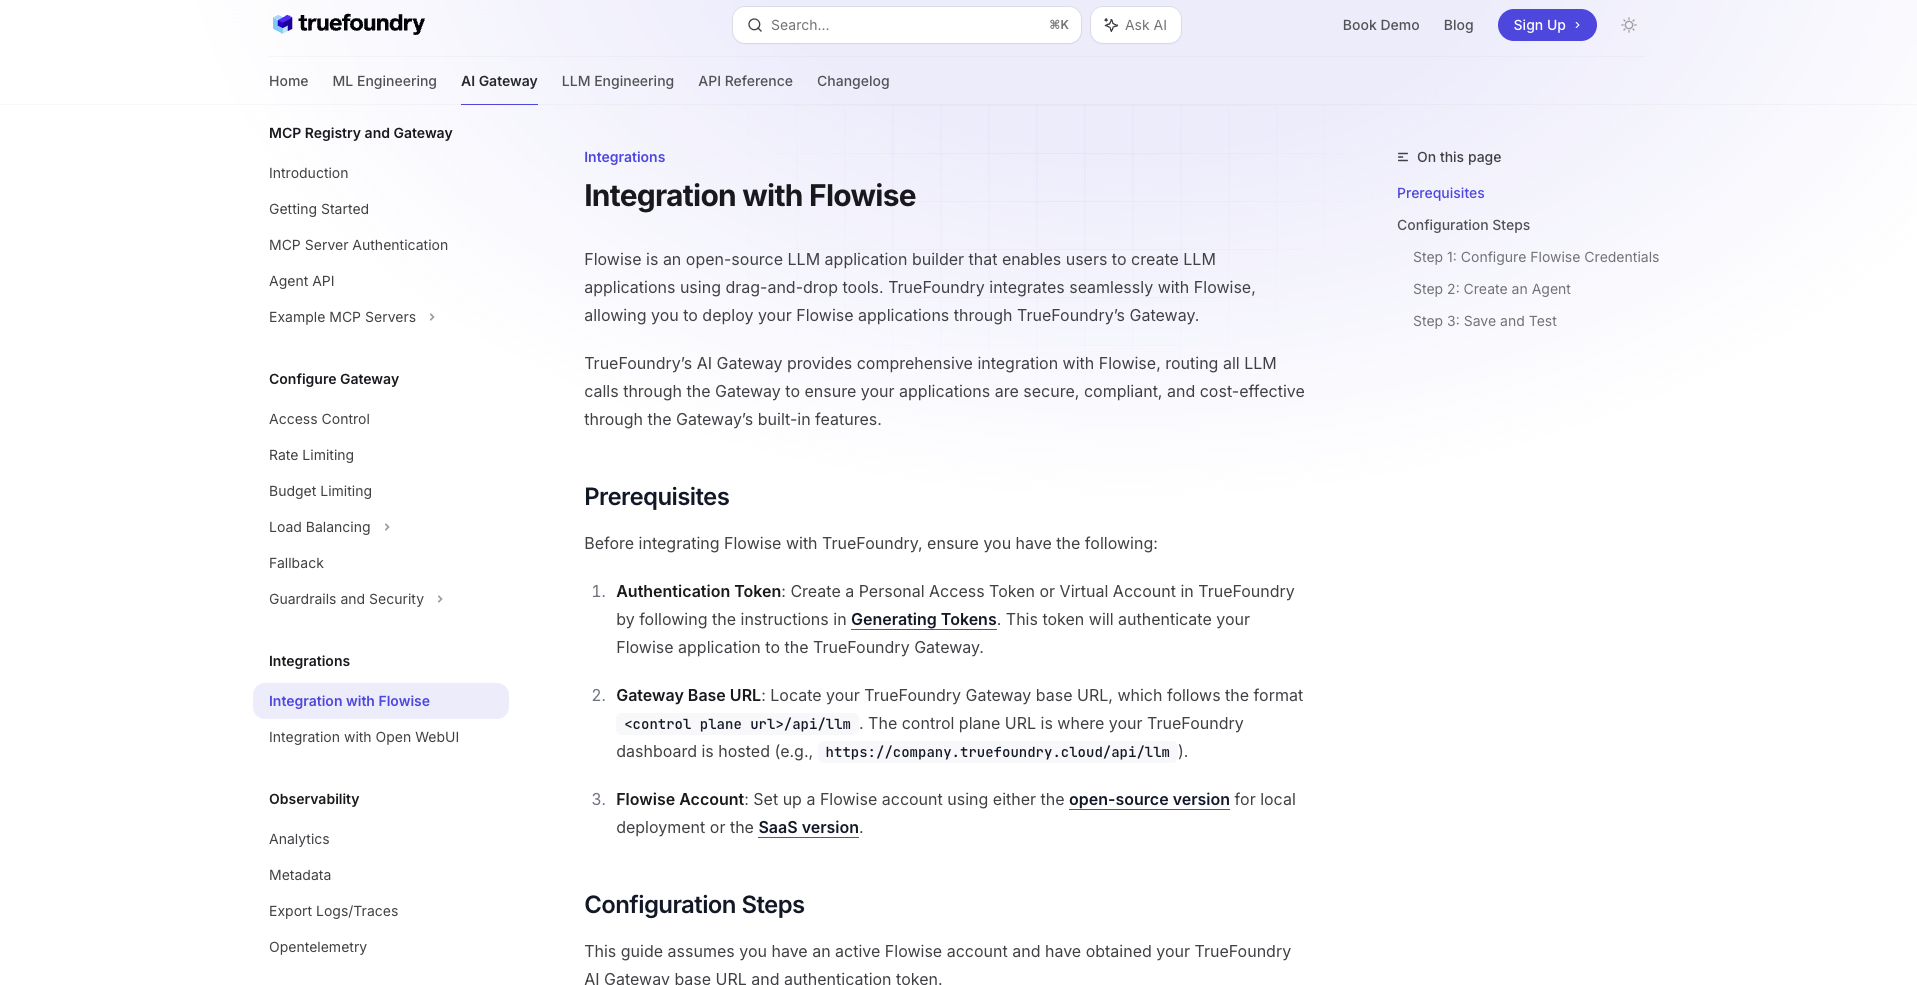
Sobald diese zwei Felder ausgefüllt sind, erbt Flowise alles, was das Gateway bereits für Produktions-Workloads leistet:
Möchten Sie loslegen? Registrieren Sie sich hier für ein Konto: TrueFoundry (keine Kreditkarte erforderlich :)), folgen Sie den Schritten in unserer Quick-Start-Anleitung und Sie haben in etwa 15 Minuten einen produktionsreifen AI-Stack laufen. Keine komplexen Migrationen, keine Code-Umschreibungen – einfach bessere Leistung, Sicherheit und Kontrolle für Ihre AI-Anwendungen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















