November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Braintrust hat sich zu einer ernstzunehmenden Observability-Plattform für KI-Evaluierung und Production Tracing entwickelt. Die Stärken liegen auf der Hand: Teams können Produktionsverhalten nachverfolgen, Evals durchführen, Prompts und Modelle vergleichen, Datensätze verwalten und reale Fehler in Regressionstests umwandeln. Für Engineering-Teams, die Wert auf rigorose Evaluierungs-Workflows legen, bleibt Braintrust eine starke Option.
Dennoch suchen Teams nach Braintrust-Alternativen, wenn ihre Anforderungen über die reine Evaluierung hinausgehen. Manche benötigen bei hohem Trace-Volumen günstigere Preise. Andere bevorzugen Open-Source-Self-Hosting. Wieder andere benötigen eine Runtime-Governance, die Modellzugriffe, Kostenkontrollen, Agenten-Richtlinien, MCP-Berechtigungen und Audit-Nachweise durchsetzt, bevor Produktionsdaten die Anbieter erreichen.
Dieser Leitfaden vergleicht sieben Braintrust-Konkurrenten im Jahr 2026, erläutert die jeweiligen Stärken und zeigt auf, wo die Grenzen der Tools liegen. Ziel ist es nicht, Braintrust pauschal zu ersetzen. Das Ziel ist präziser: LLM-Teams dabei zu helfen, die richtige Ebene für ihr spezifisches Problem zu wählen.
Definieren Sie Ihre Auswahlkriterien, bevor Sie Tools vergleichen. Braintrust-Alternativen sind nicht austauschbar, da jedes Tool eine andere Ebene im LLM-Lebenszyklus abdeckt. Eine gute Braintrust-Alternative sollte genau die Lücke in Ihrem aktuellen Betriebsmodell schließen.
Auch die Abdeckung von Sprachen und Integrationen spielt eine wichtige Rolle. Teams sollten prüfen, ob Workflows in Python, TypeScript, Ruby und Java unterstützt werden, insbesondere wenn der Anwendungscode mehrere Dienste umfasst. Eine einzelne Plattform mag zunächst attraktiv erscheinen, doch sobald Instrumentierung, SDK-Abdeckung und Team-Workflows ins Spiel kommen, können Reibungsverluste entstehen.
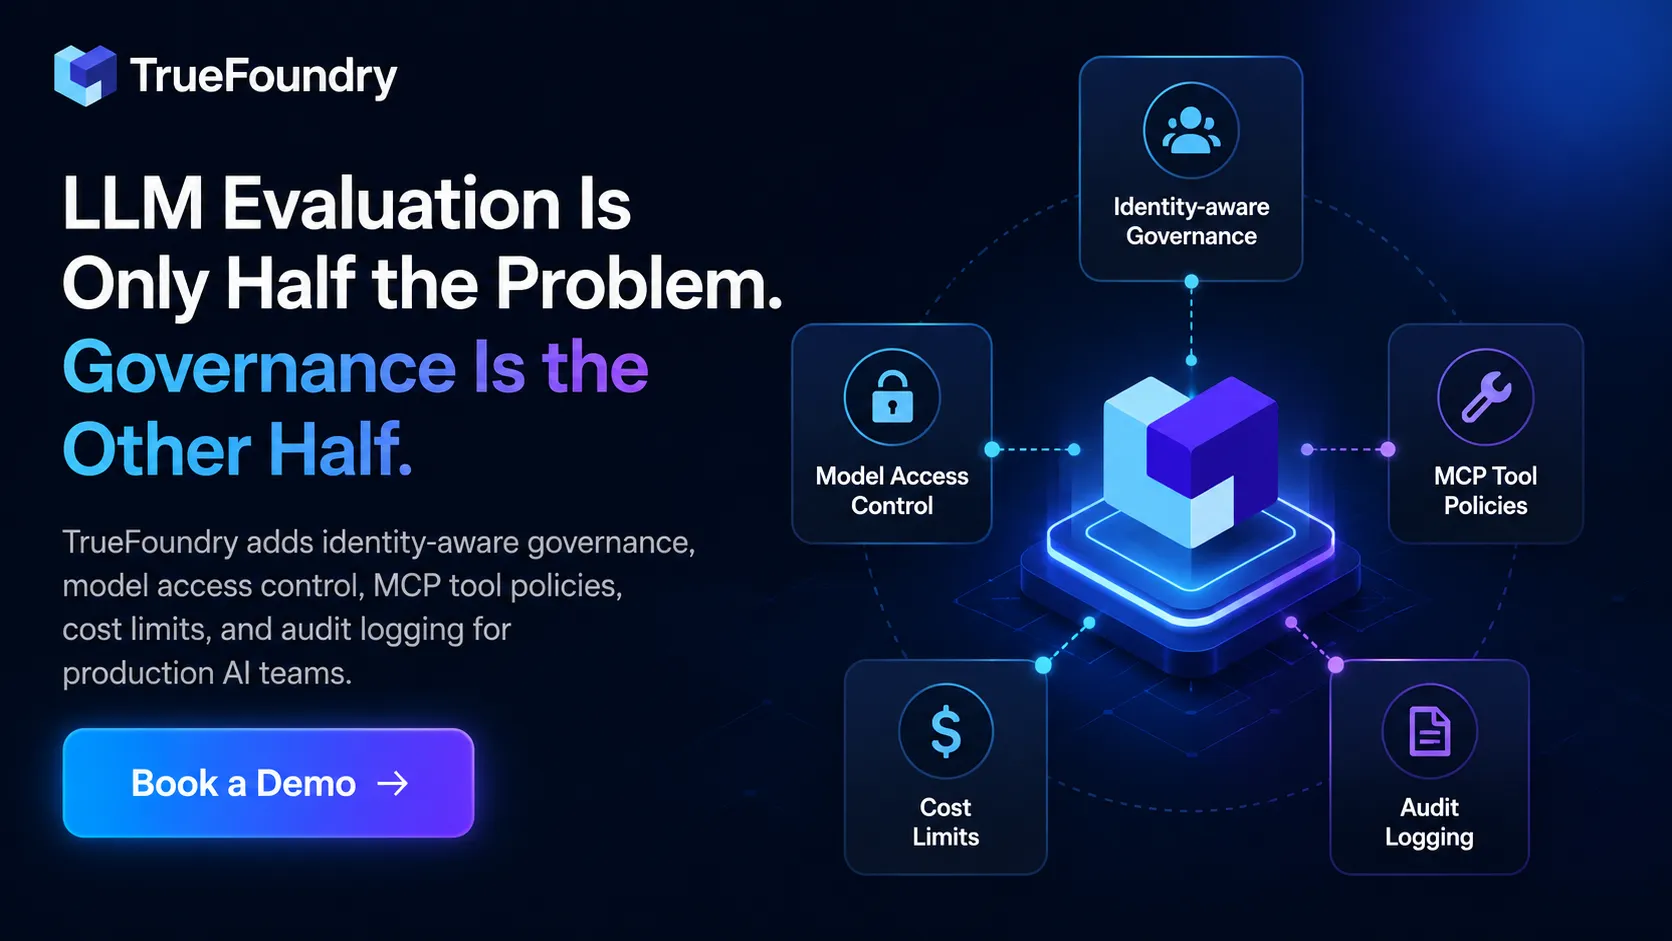
Die führenden Braintrust-Alternativen im Jahr 2026 lassen sich in drei Hauptgruppen unterteilen. Einige konzentrieren sich auf die Evaluierung und die Qualität von Prompts. Andere legen den Schwerpunkt auf Tracing und Observability. Wieder andere bieten eine Laufzeit-Governance für Produktionsdatenverkehr, Agenten, Tools und Kostenkontrollen.
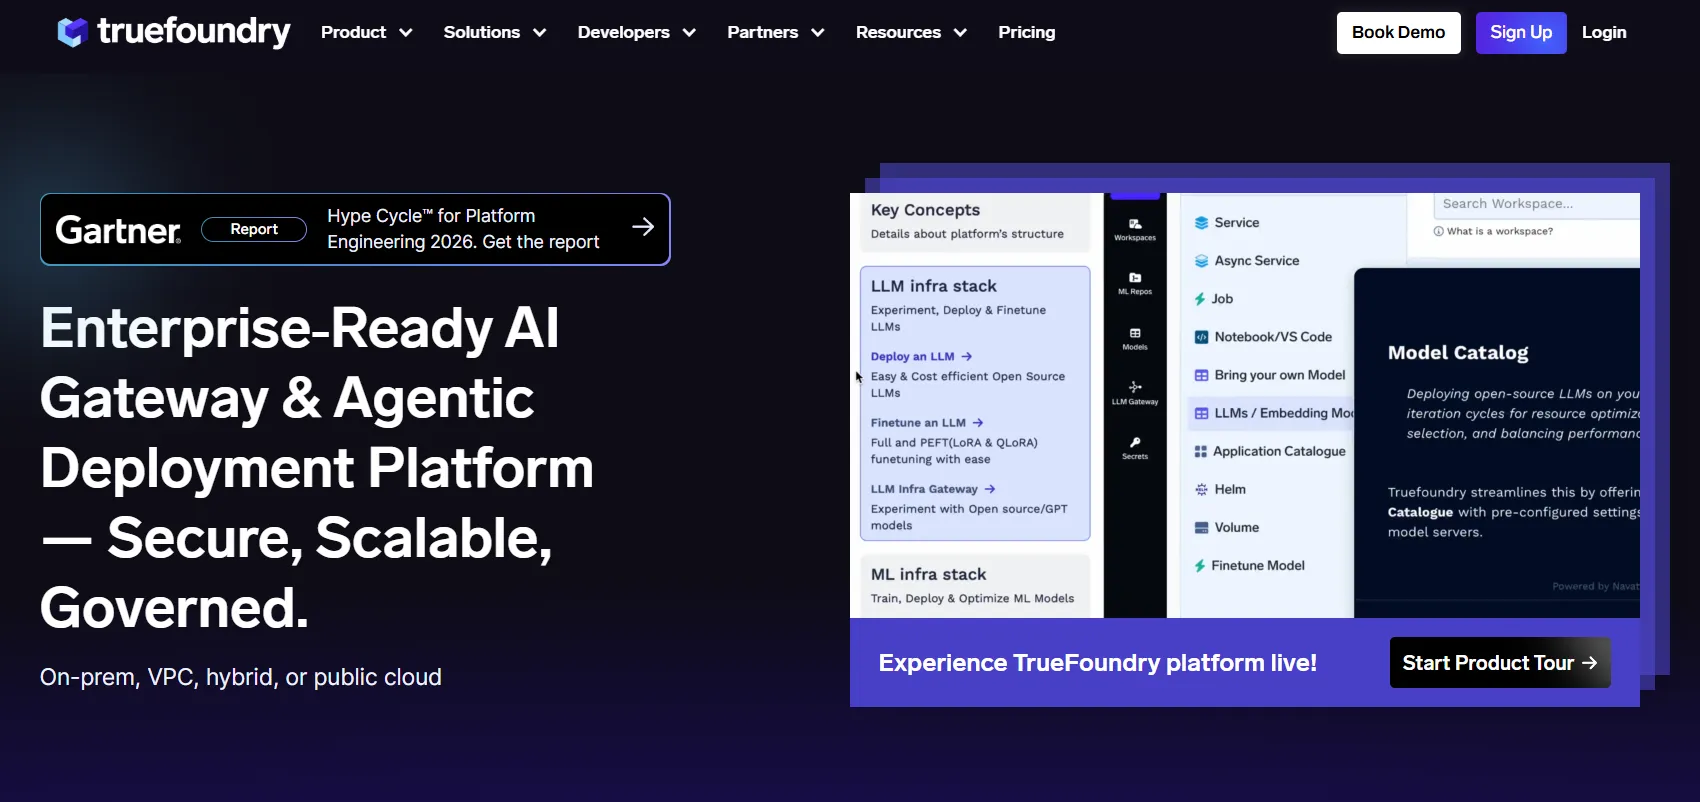
TrueFoundry ist die beste Braintrust-Alternative, wenn die größte Lücke nicht bei der Offline-Evaluierung, sondern bei der Produktions-Governance liegt. Der Ansatz erfolgt über die Infrastrukturebene des LLM-Stacks: Modellzugriff, Routing, Observability, Agenten-Richtlinien, MCP-Tool-Steuerung und Kostenkontrolle greifen hier, bevor der Produktionsverkehr die Anbieter erreicht.
Im Gegensatz zu reinen Evaluierungstools unterstützt TrueFoundry Teams dabei, den Betrieb in der Produktion zu steuern. Sein AI Gateway zentralisiert Zugriff, Richtlinienprüfungen, Monitoring, Routing, Failover, Ratenbegrenzungen und Audit-Nachweise. Dies ist besonders relevant, wenn zwar Evaluierungen vorhanden sind, die Laufzeit-Governance jedoch fragmentiert bleibt.
Die Preisgestaltung von TrueFoundry umfasst einen Developer-Plan für 0 $ für Entwickler in der Frühphase, einen Pro-Plan für 499 $ pro Monat, einen Pro-Plus-Plan für 2.999 $ pro Monat sowie individuelle Enterprise-Preise. Die Enterprise-Variante ist auf strengere Governance, Sicherheit, Flexibilität bei der Bereitstellung und geschäftskritische Zuverlässigkeit ausgelegt.
TrueFoundry ist ideal für Enterprise-KI-Plattformteams und regulierte Organisationen mit LLM-Programmen, an denen mehrere Teams beteiligt sind. Es ist besonders relevant, wenn bereits Evaluierungen durchgeführt werden, aber die Kontrolle über Produktionszugriffe, Identitäten, Kosten und Audits noch fragmentiert ist.
Confident AI ist eine starke Braintrust-Alternative für Teams, die produktionsreife Evaluierungs-Workflows für echte LLM-Anwendungen benötigen. Es basiert auf DeepEval, dem Open-Source-Framework für LLM-Evaluierung, und ergänzt dieses um Funktionen für Zusammenarbeit, Tracing, Monitoring, Dashboards und Team-Workflows.
Confident AI ist ideal für Teams, die eine tiefgehende Evaluierung benötigen und eine breitere Beteiligung von QA- oder Produktteams wünschen. Es eignet sich für Gruppen, die Tests vor der Veröffentlichung mit einer produktionsnahen Überwachung verknüpfen möchten.
Confident AI ist in erster Linie eine Plattform für Evaluierung und Qualitätssicherung. Teams sollten sie nicht als vollständige Governance-Lösung für die Laufzeit oder als Kontrollinstanz für die KI-Infrastruktur betrachten, ohne die Anforderungen an Bereitstellung, Zugriffskontrolle und Richtlinien direkt zu validieren.
Langfuse ist eine der stärksten Open-Source-Alternativen zu Braintrust für Teams, die LLM-Observability, Tracing, Prompt-Management, Datasets und Evaluierungs-Workflows mit der Kontrolle durch Self-Hosting suchen. Es ist zudem attraktiv für Teams, die die Anzahl der GitHub-Sterne als Indikator für die Akzeptanz in der Community nutzen.
Langfuse ist ideal für Plattform-Teams, die Open-Source-Kontrolle, Self-Hosting und eine umfassende Abdeckung der Observability wünschen. Es passt zu Teams, die ihren Observability-Stack lieber selbst verwalten.
Self-Hosting bringt einen echten operativen Kompromiss mit sich. Teams müssen sich selbst um Skalierung, Upgrades, Speicher, Sicherheitsvorkehrungen, Incident-Response und die langfristige Zuverlässigkeit des Observability-Stacks kümmern.


LangSmith ist ein praktischer Konkurrent zu Braintrust für Teams, die bereits mit LangChain oder LangGraph arbeiten. Es reduziert den Aufwand für die Instrumentierung und bietet Entwicklern Tracing, Debugging, Datensätze, Evaluierungen und Monitoring innerhalb des LangChain-Ökosystems.
LangSmith ist ideal für Teams, die intensiv mit LangChain oder LangGraph arbeiten. Es ist die richtige Wahl für Entwickler, die minimale Integrationshürden und leistungsstarke Debugging-Workflows suchen.
LangSmith ist weniger attraktiv für Teams, die Wert auf herstellerneutrale Observability, Open-Source-Self-Hosting oder eine Governance auf Infrastrukturebene für Systeme außerhalb des LangChain-Ökosystems legen.
Arize Phoenix ist eine Open-Source-Plattform für KI-Observability und Evaluierung. Sie ist besonders relevant für Teams, die auf OpenTelemetry-basierte Instrumentierung, RAG-Evaluierung, Retrieval-Debugging, Experimente und Troubleshooting-Workflows setzen.
Teams mit Kapazitäten im Bereich Platform Engineering, die Open-Source-Tools für LLM-Observability und -Evaluierung mit leistungsstarken Workflows für Tracing und Experimente suchen.
Phoenix ist leistungsstark, doch für den produktiven Unternehmenseinsatz können je nach Skalierung, Sicherheitsanforderungen und Supportbedarf zusätzliche Plattformanpassungen oder eine kommerzielle Arize-Bereitstellung erforderlich sein.
W&B Weave ist eine logische Alternative zu Braintrust für Teams, die Weights & Biases bereits für das Tracking von ML-Experimenten nutzen. Es erweitert das W&B-Ökosystem um Funktionen für LLM-Observability, Evaluierung, Tracing und Agent-Workflows in produktiven KI-Systemen.
W&B Weave eignet sich am besten für ML-Teams, die bereits auf W&B standardisiert sind. Es ist zudem ideal für Teams, die NVIDIA-gestützte Modell-Workflows und LLM-Anwendungen in einem einheitlichen Betriebsmodell verwalten möchten.
Weave spielt seine Stärken vor allem dann aus, wenn das ML-Betriebsmodell des Teams bereits auf W&B basiert. Für reine LLM-Evaluierungen oder selbst gehostete Observability-Lösungen könnten Langfuse, Phoenix oder Braintrust einfacher zu implementieren sein.

Helicone ist ein leichtgewichtiges KI-Gateway und eine Plattform für LLM-Observability. Es ist eine hervorragende Wahl für Entwicklerteams, die eine schnelle Einrichtung, OpenAI-kompatibles Routing, Request-Logging, Kostenverfolgung, Caching und Ratenbegrenzungen wünschen, ohne eine komplexe Instrumentierung von Grund auf neu entwickeln zu müssen.
Helicone ist ideal für Startups und Engineering-Teams, die eine schnelle LLM-Observability und Kostenverfolgung benötigen. Es ist die richtige Wahl für Teams, die aufwendige Implementierungsarbeiten auf großen Plattformen vermeiden möchten.
Helicone ist in erster Linie keine umfassende Workbench für Offline-Evaluierungen oder eine Enterprise-Plattform für KI-Governance. Teams in regulierten Branchen sollten ihre Anforderungen an Identitätsmanagement, Audits, Datenkontrolle und Richtliniendurchsetzung prüfen, bevor sie es als einzige Lösung einsetzen.
Die größte Falle in diesem Bereich ist die Annahme, dass Evaluierung, Observability und Governance dasselbe sind. Sie hängen zwar zusammen, sind aber nicht identisch. Diese Unterscheidung ist entscheidend, wenn Teams Braintrust-Alternativen für KI-Produktionssysteme bewerten.
Die praktische Frage lautet daher nicht „Welches Tool ist das beste?“, sondern „Welche Ebene fehlt in unserem aktuellen LLM-Betriebsmodell?“. Wenn die Lücke beim einheitlichen Modellzugriff und der Request-Governance liegt, ist ein LLM-Gateway wird relevanter als eine weitere Evaluierungs-Workbench.

Braintrust ist keineswegs schwach. Es ist eine leistungsstarke Plattform für KI-Observability und -Evaluierung, deren Gateway zudem einheitlichen Modellzugriff, Caching, Observability und Multi-Provider-Unterstützung bietet. Ein glaubwürdiger Vergleich sollte die Stärken von Braintrust anerkennen, bevor Alternativen diskutiert werden.
Die richtige Alternative hängt davon ab, welche Ebene fehlt. Wenn es um Self-Hosting geht, sind Langfuse und Phoenix einen Blick wert. Wenn es um tiefgreifende Evaluierung und funktionsübergreifende Qualitäts-Workflows geht, ist Confident AI eine ernstzunehmende Option. Wenn das Team bereits mit LangChain arbeitet, ist LangSmith der Weg des geringsten Widerstands.
Wenn das Team bereits W&B nutzt, ist Weave die natürliche Wahl. Wenn eine schlanke Gateway-Observability benötigt wird, ist Helicone attraktiv. Jede dieser Optionen ist ein valider Braintrust-Konkurrent, sofern das jeweilige Betriebsmodell zum tatsächlichen Problem passt.
Für Enterprise-Teams, denen es an Governance in der Produktion mangelt, ist TrueFoundry die beste Wahl in dieser Liste. Es richtet sich an Teams, die Modellzugriffe, Agenten-Aktionen, MCP-Tools, Kostenlimits, Observability und Audit-Nachweise über eine Infrastruktur-Kontrollschicht steuern müssen.
Das bedeutet nicht, dass TrueFoundry jeden Evaluierungs-Workflow ersetzt. Es bedeutet vielmehr, dass TrueFoundry einen bestehenden Evaluierungs-Stack ergänzen kann, wenn Produktionszugriff, Kosten, Identitätsmanagement und Audit-Kontrollen strenger durchgesetzt werden müssen. Das ist der Unterschied zwischen der Überwachung von KI-Qualität und der Steuerung von KI-Risiken.
Demo buchen um zu sehen, wie TrueFoundry KI-Workloads steuert, bevor sie ein Produktionsrisiko darstellen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet