


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
إن سؤال "أي نموذج هو الأفضل؟" هو السؤال الخاطئ، وهو يكلف فرق العمل أموالاً دون أن تشعر. والجواب الصريح هو أن النموذج الرائد (Frontier Model) ما هو إلا أداة ذات سعر محدد، والأداة المناسبة تعتمد على ما تطلبه منها. إن إرسال مهمة تصنيف تقييمات المنتجات إلى نموذج تفكير عالي المستوى يشبه استئجار رافعة لتعليق إطار صورة. إنه أمر يعمل بنجاح، ولكنه يكلف أيضًا 40 ضعفًا عما ينبغي، فضلاً عن أنه أبطأ.
بحلول أواخر عام 2026، اتسعت ساحة النماذج الرائدة لتتحول إلى فئات (Tiers). حيث يقدم كل مورد رئيسي ثلاثة نماذج على الأقل: نموذج رائد (Flagship) مخصص للتفكير المعقد، ونومذج متوسط رائد (Workhorse) متوازن من حيث السعر وسرعة المعالجة (Throughput)، ونموذج صغير سريع وشبه مجاني. ولم تعد القرارات المثيرة للاهتمام هي "OpenAI أم Anthropic"، بل أصبحت "أي فئة، وأي طلب، وأي تكلفة، وأي خطة بديلة (Fallback)". هذه مشكلة توجيه (Routing)، ومشكلات التوجيه تُحل بالسياسات، وليس بالولاء لعلامة تجارية معينة.
يقدم هذا المقال أمرين: أولاً، جولة على الموردين منظمة حول ما يتفوق فيه كل نموذج بالفعل. ثانياً، إطار عمل لاتخاذ القرار يربط أنواع مهامك بفئة النموذج وموقف التكلفة، ويوضح كيف تتيح لك بوابة AI Gateway تطبيق هذا الإطار دون إعادة كتابة تطبيقك في كل مرة يصدر فيها المزود إصدارًا جديدًا.
هل ترغب في توجيه كل طلب إلى النموذج المناسب حسب المهمة والتكلفة؟ احجز عرضًا توضيحيًا.
تقيس اختبارات التقييم (Benchmarks) النموذج بناءً على اختبار ثابت. لكن حركة المرور في بيئة الإنتاج لديك ليست اختبارًا ثابتًا، بل هي مزيج: تدفق هائل من الاستدعاءات الرخيصة والمكررة (استخراج رقم الفاتورة، تصنيف التذكرة، تحديد التوجيه الذي سيتم تشغيله لاحقًا)، وتدفق محدود من الطلبات المعقدة حقًا (معالجة مشكلة تسابق Race Condition عبر خمسة ملفات، والتفكير في عقد مكون من 200 صفحة). إن الاعتماد على نموذج رائد واحد "أفضل" يعني تسعيره وتحديد حجمه ليلائم التدفق المعقد، مما يجعلك تدفع مبالغ إضافية لا داعي لها على التدفق الهائل للمهام البسيطة.
هناك ثلاث قوى تجعل التفكير في نموذج واحد أمرًا مكلفًا:
والحل يكمن في التعامل مع اختيار النموذج كتهيئة (Configuration). حدد السياسة مرة واحدة ("تذهب عمليات الاستخراج إلى الفئة الرخيصة، وتذهب البرمجة إلى الفئة المتوسطة، والتفكير المعقد يتم تصعيده إلى نموذج رائد، ويتم التبديل إلى مزود ثانٍ عند حدوث خطأ")، ثم قم بصياغتها عند البوابة، وغير فيها دون الحاجة لنشر كود جديد. لمعرفة تفاصيل هذه الآلية، راجع ما هو موجه LLM router و اختيار النماذج بناءً على التكلفة والجودة.
الأرقام الوحيدة المؤكدة من المصدر الأول أدناه هي الخاصة بـ Claude. أما بقية البيانات فتم تجميعها من تقارير جهات خارجية اعتبارًا من نوفمبر 2026، ويجب التحقق منها من صفحات الأسعار والنماذج الخاصة بالمزود نفسه قبل الاعتماد عليها، حيث تتغير مواصفات النماذج باستمرار.
تعتمد تشكيلة Claude لأواخر عام 2026 على نافذة سياق (Context Window) بسعة 1 مليون رمز مع إخراج (Output) يبلغ 128 ألف رمز، وتاريخ انتهاء تدريب في يونيو 2026. الفئات واضحة تمامًا:
النمط المفيد هنا هو التقسيم الثلاثي: نموذج صغير شبه مجاني، ونموذج متوازن للمهام اليومية، ونموذج متميز للوكلاء الذكيين (Agentic). يمكنك بناء أي سياسة توجيه تقريبًا استنادًا إلى هذه الأدوار الثلاثة.
أفادت التقارير بأن جيل GPT-6 من OpenAI يتبع نفس هيكل الفئات. يُذكر أن GPT-6 Astra يأتي بسعر 10 دولارات / 50 دولارًا ومخصص للتفكير عالي المستوى. أما GPT-6.1 Sol فيكلف 2 دولار / 10 دولارات وتصفه التقارير بأنه أقوى نموذج للبرمجة والبحث في العائلة، بمؤشر برمجة (Coding Index) يبلغ حوالي 54. نموذج GPT-6.1 Terra، المعلن عنه بسعر 1 دولار / 5 دولارات والذي صدر حول 26 أكتوبر 2026، يأتي بسياق يبلغ حوالي 1.05M ومؤشر برمجة يقارب 48، مما يضعه بسعر يعادل نصف سعر Sol تقريبًا مع تقديم نسبة كبيرة من قدرات Sol البرمجية. أما GPT-6 Luna، فتكلفته 0.10 دولار / 0.50 دولار، وهو مخصص لعمليات التصنيف والتوجيه عالية الحجم، بمؤشر برمجة يقارب 31.
يرجى التعامل مع أرقام مؤشر البرمجة هذه كأرقام توجيهية وليست دقيقة، كونها ناتجة عن تجميع بيانات من أطراف خارجية وهي عرضة للتغيير.
تشكيلة Google هي الأقوى صعوبة في التحديد بسبب تضارب التقارير. يُذكر أن Gemini 3.1 Pro بسعر 2 دولار / 12 دولارًا وموجه لأصعب مهام التفكير. نموذج Gemini 3.6 Flash يُذكر بسعر 1.50 دولار / 7.50 دولار، وصدر حول يوليو 2026، بنافذة سياق 1M، ومؤشر ذكاء يقارب 50، ومعدل SWE-Bench Pro يقارب 58.7%، وسرعة معالجة تبلغ نحو 280 رمزًا في الثانية، مما يجعله نموذجًا قويًا ورخيصًا لعمليات البرمجة. أما Gemini 3.1 Flash-Lite فيُذكر بسعر 0.25 دولار / 1.50 دولار للفئة الأدنى. وإذا لم تتمكن من تأكيد وجود 3.6 Flash في حسابك، فإن البديل الآمن هو Gemini 3.5 Flash المتاح بشكل عام.
تسميات إصدارات Grok غير مستقرة بعد. يُعد Grok 4.3 بسعر 1.25 دولار / 2.50 دولار تقريبًا التكوين الأكثر ذكرًا، وسعره المنخفض للإخراج يلفت الانتباه. أُشير إلى إصدارات أحدث مثل Grok 4.6 وGrok 5 لكنها لم تستقر بعد. تعامل مع الإصدار على أنه غير مستقر وتحقق مباشرة مع xAI قبل توجيه حركة المرور في بيئة الإنتاج إليه.
للفرق التي ترغب في الاستضافة الذاتية (Self-host) أو تقليل التكلفة لأدنى حد: يُذكر نموذج Meta Llama 4 Maverick بسعر 0.20 دولار / 0.60 دولار ونموذج Scout بسعر 0.11 دولار / 0.34 دولار، وكلاهما مفتوح الوزن وقابل للاستضافة الذاتية. يُذكر نموذج DeepSeek V4 في نطاق من 0.22 إلى 0.66 دولار تقريبًا ومخصص للتفكير والبرمجة بكفاءة عالية في التكلفة. أُشير إلى Mistral Large 3 بسعر 0.50 دولار / 1.50 دولار. وتكمن أهمية هذه النماذج عندما تكون إقامة البيانات (Data Residency) أو الاقتصاديات المباشرة للوحدة هي العوامل الحاكمة للقرار.
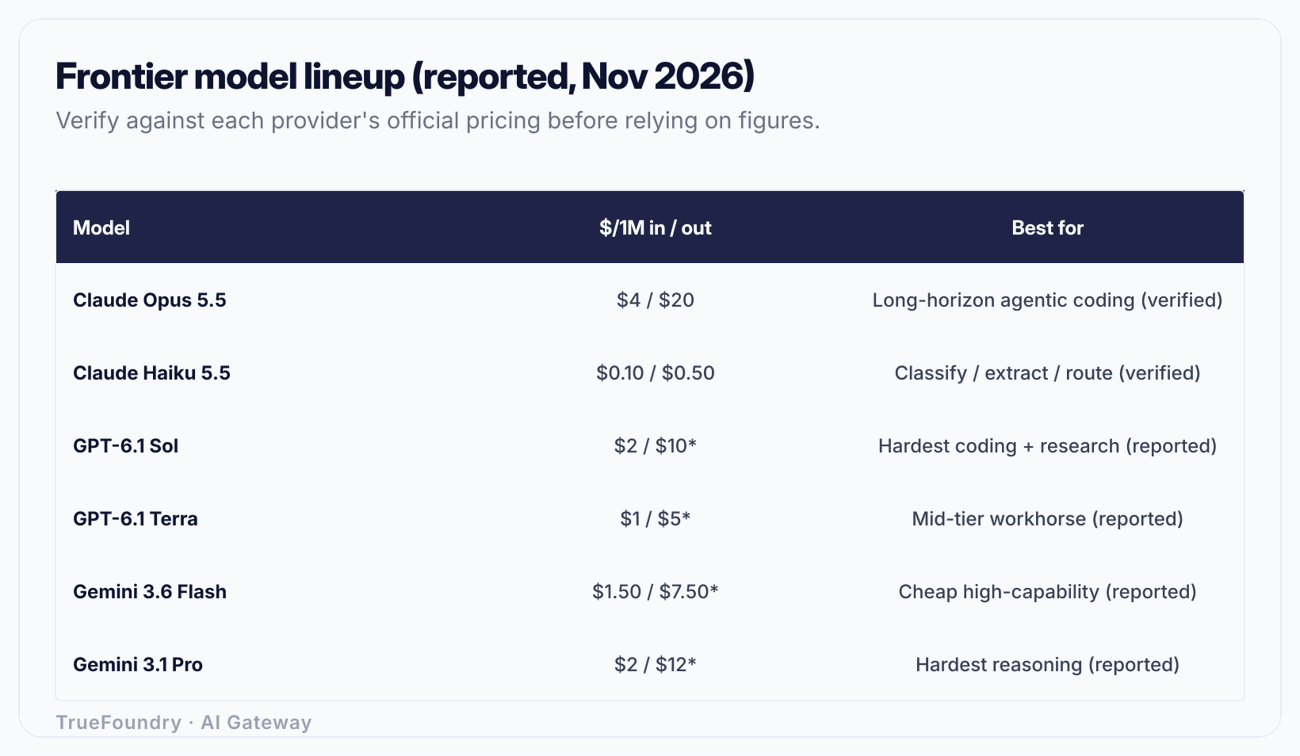
الأسعار ومقاييس الأداء حسب التقارير الصادرة في نوفمبر 2026؛ يرجى التحقق منها من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — مواصفات النماذج تتغير باستمرار.
توقف عن اختيار نموذج واحد. ابدأ بتصنيف حركة المرور لديك، ثم اربط كل فئة بنوع النموذج وموقف التكلفة. أربع فئات تغطي كل شيء تقريبًا.
هذه المهام تتميز بحجمها العالي ووضوحها التام: تصنيف تذكرة، استخراج تاريخ من مستند، تحديد مسار التوجيه المراد تشغيله. وهي لا تتطلب نموذجًا رائدًا. فالنماذج الصغيرة مثل (Haiku 5.5، GPT-6 Luna، Gemini 3.1 Flash-Lite) بتكلفة تتراوح بين 0.10 و0.25 دولار تقريبًا لكل مليون رمز إدخال يمكنها التعامل معها، ونظرًا لأن الإخراج قصير، فإن تكلفة الطلب الواحد تكون ضئيلة جدًا. موقف التكلفة: تقليل التكلفة لأدنى حد. هذا هو المجال الذي يحقق فيه التوجيه إلى الفئة الرخيصة عائداً ممتازاً.
تحتاج المحادثات الموجهة للمستخدمين إلى جودة جيدة وزمن استجابة (Latency) منخفض، ولكنها نادراً ما تتطلب أعمق مستويات التفكير. وتُعد النماذج المتوسطة مثل (Sonnet 5.5، GPT-6.1 Terra، Gemini 3.6 Flash) الخيار الخيار الأمثل. موقف التكلفة: التوازن. انتبه لسعر الإخراج تحديدًا لأن المحادثة تنشئ عددًا كبيرًا من الرموز.
تظهر الفجوات في الإمكانيات عند البرمجة متعددة الخطوات، حيث يقوم النموذج بالتخطيط، واستدعاء الأدوات، وقراءة الملفات، والحفاظ على الهدف عبر عدة جولات. لأصعب أعمال الوكلاء، يُعد Opus 5.5 الخيار الافتراضي القوي والمؤكد؛ بينما يُذكر GPT-6.1 Sol كبديل منافس قوي. أما للبرمجة اليومية التي لا تتطلب مدى طويل، فإن النموذج المتوسط (Terra، Gemini 3.6 Flash، Sonnet 5.5) يعطي غالبًا 90% من الجودة بكسر بسيط من التكلفة. موقف التكلفة: التقسيم حسب الصعوبة. وجه التعديلات الروتينية إلى الفئة المتوسطة، وصعّد المهام البرمجية المعقدة إلى الفئة العليا.
التحليل القانوني، وتجميع البحوث، والتفكير عبر المستندات الضخمة. هذا هو المجال الوحيد الذي تستحق فيه الاستثمار في نموذج رائد مثل (Astra، Gemini 3.1 Pro، Opus 5.5 أو Fable 5.1 للمهام الأثقل). موقف التكلفة: الدفع مقابل الجودة مع ضبط الوصول. يجب أن يصل جزء يسير فقط من حركة المرور إلى هذه الفئة؛ وقاعدة التوجيه هي الصمام لهذا الوصول.
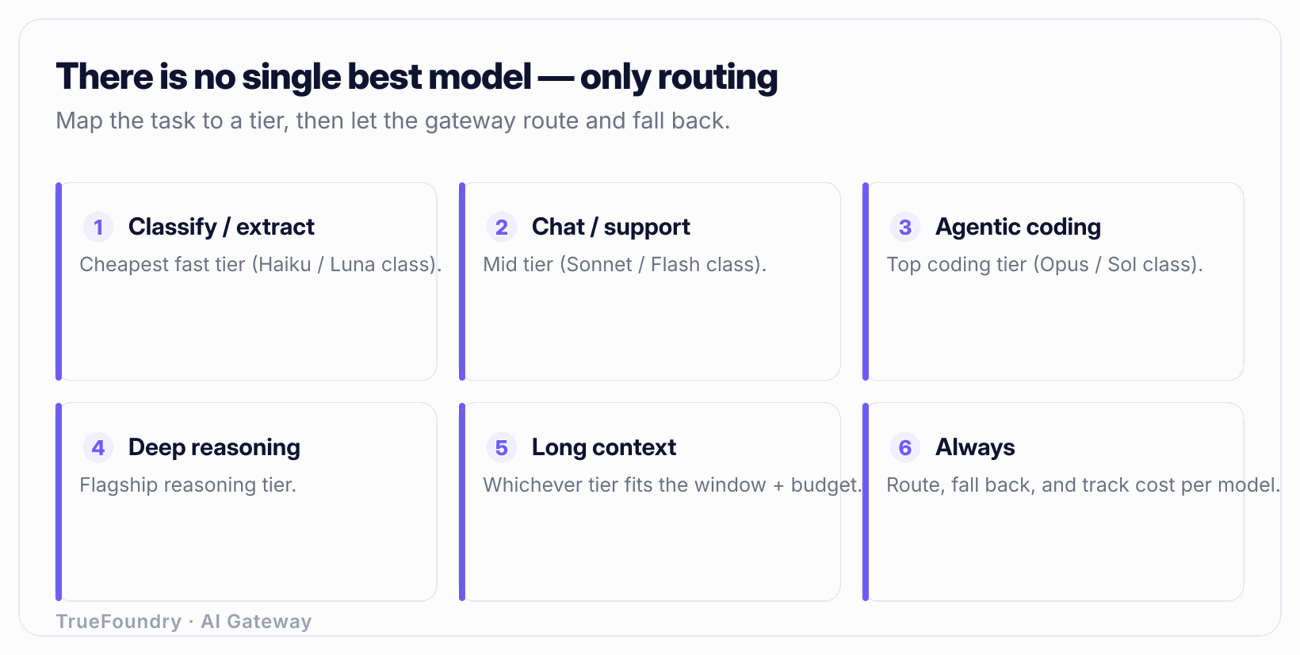
الأسعار ومقاييس الأداء حسب التقارير الصادرة في نوفمبر 2026؛ يرجى التحقق منها من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — مواصفات النماذج تتغير باستمرار.
تعرف على كيفية قيام TrueFoundry بالتوجيه، والتبديل التلقائي، وتتبع التكلفة عبر كل نموذج. احجز عرضًا توضيحيًا.
نفترض أن هناك منتجًا يرسل 10 ملايين طلب نموذج شهريًا. بفرض تقسيم بنسبة 80/15/5: 80% بسيط (تصنيف، استخراج، توجيه)، 15% محادثة وبرمجة يومية، 5% تفكير معقد وبرمجة وكلاء. بافتراض متوسط 500 رمز إدخال و200 رمز إخراج لكل طلب للفئات البسيطة والمحادثة، وأكثر من ذلك للفئة المعقدة.
إذا قمت بتوجيه كل شيء إلى نموذج رائد واحد بسعر 4 دولارات / 20 دولارًا، فستدفع سعر النموذج الرائد على جميع الـ 10 ملايين طلب، بما في ذلك 8 ملايين طلب كان يمكن لنموذج بسعر 0.10 دولار معالجتها بآداء مماثل. بدلاً من ذلك، قم بالتوجيه حسب المهمة:
الفئة البسيطة، التي تشكل غالبية الحجم، أصبحت تكلفتها الآن حوالي 1/40 من تكلفة الرمز للإدخال مقارنة بالنموذج الرائد. في معظم عبء العمل الحقيقي، يقلل هذا الفاتورة الإجمالية بأكثر من النصف مع ترك الطلبات المعقدة للنموذج الذي تحتاجه بالضبط. الرقم الدقيق يعتمد على مزيج الرموز لديك، وتلك هي النقطة الأساسية: أنت تقيس التكلفة لكل فئة، وهو ما يتطلب رؤية واضحة لتكلفة كل نموذج. راجع تحديد تكاليف LLM وميزانيات الفرق لمعرفة كيفية إلزام الفرق بذلك.
إطار العمل أعلاه لا يكون مفيدًا إلا إذا كان بإمكانك تنفيذه دون الحاجة للنشر في كل مرة. وهذا هو الغرض من بوابة الذكاء الاصطناعي (AI Gateway). تعرض البوابة API واحدًا موحدًا ومتوافقًا مع OpenAI لتطبيقك. وخلف نقطة النهاية الموحدة هذه، تقوم بتهيئة النموذج الحقيقي الذي يذهب إليه كل طلب. يرسل التطبيق نفس شكل الطلب في كل مرة؛ بينما تحدد البوابة الوجهة.
يوفر هذا الفصل أربع مزايا ترتبط مباشرة بإطار العمل:
نقطة الـ API الموحد أكثر أهمية مما تبدو عليه. فعندما يظهر نموذج جديد (ظهر Terra في أواخر أكتوبر؛ وسوف يظهر شيء آخر في ديسمبر)، تفتحه كهدف وتوجه حركة المرور إليه بتغيير بسيط في التهيئة. والتطبيق لا يشعر بالتغيير مطلقًا. لمعرفة الهندسة المعمارية الأساسية، راجع ما هو وكيل LLM proxy و كيفية اختيار AI gateway.
النماذج الرائدة في أواخر عام 2026 ليست قمة واحدة برابح واضح، بل هي مجموعة من الفئات، والفرق التي تدير ميزانياتها بذكاء هي التي تطابق كل جزء من حركة المرور بالفئة المناسبة بدلاً من دفع أسعار النماذج الرائدة لمهام التصنيف البسيطة. أسماء الموردين ستستمر في التغير، والأسعار ستستمر في التحرك، ولوحات الترتيب سيعاد ترتيبها دائماً. لكن إطار العمل يبقى ثابتاً أمام كل ذلك: صنّف حركة المرور لديك، واربط كل فئة بموقف التكلفة، وضيّق الوصول إلى الفئة المكلفة بحيث لا يصل إليها إلا الطلبات المعقدة حقًا.
اجعل إطار العمل هذا سياسة توجيه عند البوابة، ولسوف يتوقف سؤال "أي نموذج نختار" عن كون دائم، وليتحول إلى سطر تهيئة تغيره في دقائق. أنت توجه حسب المهمة والتكلفة، وتبدل تلقائياً عند تعثر المزود، وتخزن الإجابات المكررة مؤقتاً، وتعرف بالضبط ما يكلفه كل نموذج لكل طلب. بهذه الطريقة تظل في مقدمة التطور دون أن تكون حبيسًا لأي نقطة واحدة فيه.
توقف عن التقيد بنموذج واحد — وجه الطلبات بينها بمرونة. احجز عرضًا توضيحيًا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




