Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.
9,9
Resolvendo Gargalos de Dados de SEO com Agentes Autônomos e TrueFoundry
Updated: novembro 20, 2026
Published: maio 20, 2026
Built for Speed: ~10ms Latency, Even Under Load
Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed
É segunda-feira de manhã. Seu líder de SEO está olhando para três abas diferentes do navegador: Google Search Console (GSC), Looker Studio e uma planilha que trava se você rolar muito rápido. Eles estão exportando manualmente milhares de linhas de dados de consulta, tentando usar VLOOKUP em relação ao desempenho da semana passada e aplicando filtros subjetivos para decidir sobre o que a equipe de engenharia deve criar conteúdo em seguida.
Este é o problema da "Última Milha" na análise de dados. Temos ferramentas de coleta sofisticadas, mas a síntese real — a camada de tomada de decisão — depende de uma frágil "cola" humana.
Na TrueFoundry, percebemos que nosso fluxo de trabalho de engenharia de crescimento estava bloqueado por essa agregação manual. Não éramos limitados pelos dados; éramos limitados pela capacidade de processamento da análise humana. Para resolver isso, não compramos outra ferramenta de dashboard. Construímos o Agente de Automação de Palavras-chave, um sistema que trata as métricas de SEO como um fluxo de engenharia, e não como um relatório estático, impulsionado pelo TrueFoundry AI Gateway e pelo Model Context Protocol (MCP).
A Mudança Técnica: Da Análise Estática para Pipelines Adaptativos
A abordagem padrão para operações de SEO é Baseada em Polling e Manual: humanos buscam dados periodicamente, aplicam regras codificadas (por exemplo, "volume > 100") e adivinham a relevância.
Mudamos para um Orientado a Eventos e Probabilístico modelo:
Pontuação Determinística: A matemática lida com as métricas óbvias (deltas de CTR, distância de classificação).
Filtragem Probabilística: LLMs injetam contexto de negócios (por exemplo, sabendo que "AI Gateway" é relevante para nós, mas "Gateway Computer Drivers" não é).
Abstração de Ferramentas (MCP): Fontes de dados externas (Ahrefs, Google Trends) são acessadas via protocolos padronizados, e não por wrappers de API frágeis.
Análise Aprofundada da Arquitetura
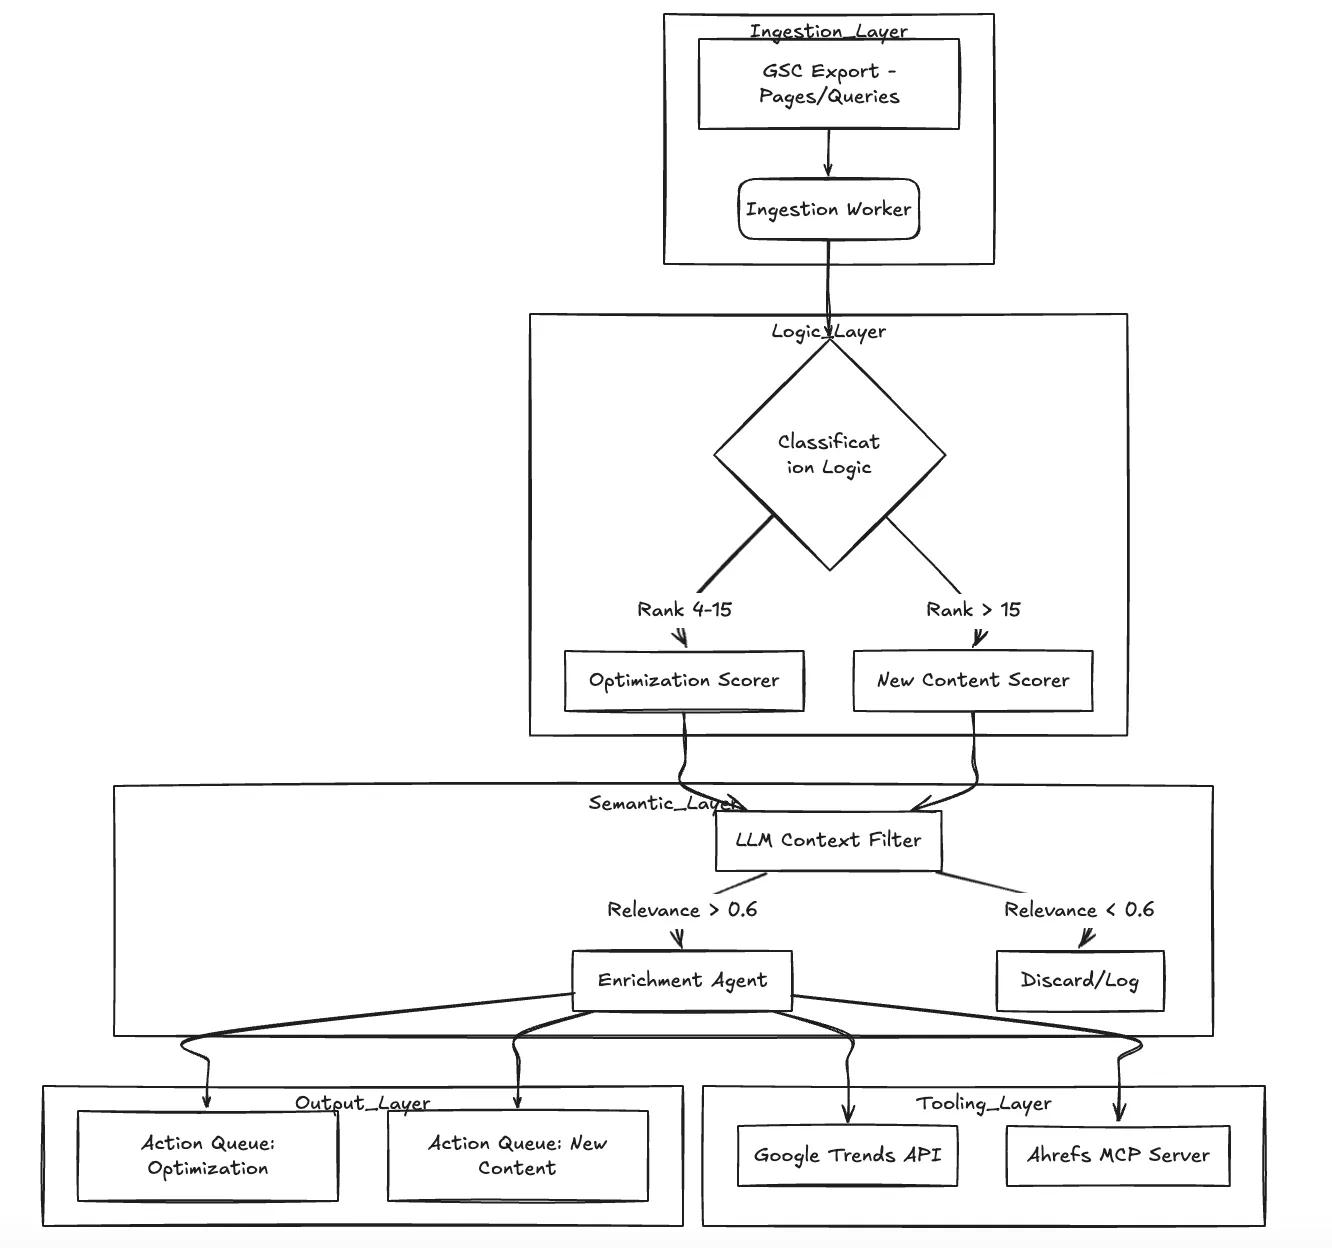
O sistema opera como um grafo acíclico direcionado (DAG) de etapas de processamento. Ele não se limita a "resumir" dados; ele os filtra e enriquece ativamente.
Componentes Principais:
Trabalhador de Ingestão: Analisa exportações CSV brutas do GSC (Páginas e Consultas).
Controlador de Pontuação: Aplica a lógica matemática. Para otimização, utilizamos uma função de decaimento baseada em distância: $Score = \log(1 + impressions) \times (1 - CTR) \times (\max(0, 20 - position))$.
Agente de Relevância (LLM): Atua como o guardião semântico. Ele avalia palavras-chave em relação ao contexto de domínio da TrueFoundry (Kubernetes, Operações de LLM, Plataformas de Desenvolvedor) para filtrar o ruído.
Trabalhador de Enriquecimento: Busca dados de tendência e (na V2) métricas de dificuldade externas via MCP.
Infraestrutura e TrueFoundry: Gateway e MCP
A implementação desta arquitetura introduz dois grandes desafios de sistemas distribuídos: Limitação de Taxa e Integração de Ferramentas.
Se você simplesmente percorrer 5.000 palavras-chave e acionar uma API de LLM para pontuação de relevância, você atingirá os limites de taxa imediatamente. Se você codificar chamadas de API da Ahrefs diretamente no seu agente, você cria um acoplamento forte que se rompe sempre que uma versão da API muda.
Utilizamos o Plataforma TrueFoundry para resolver ambos:
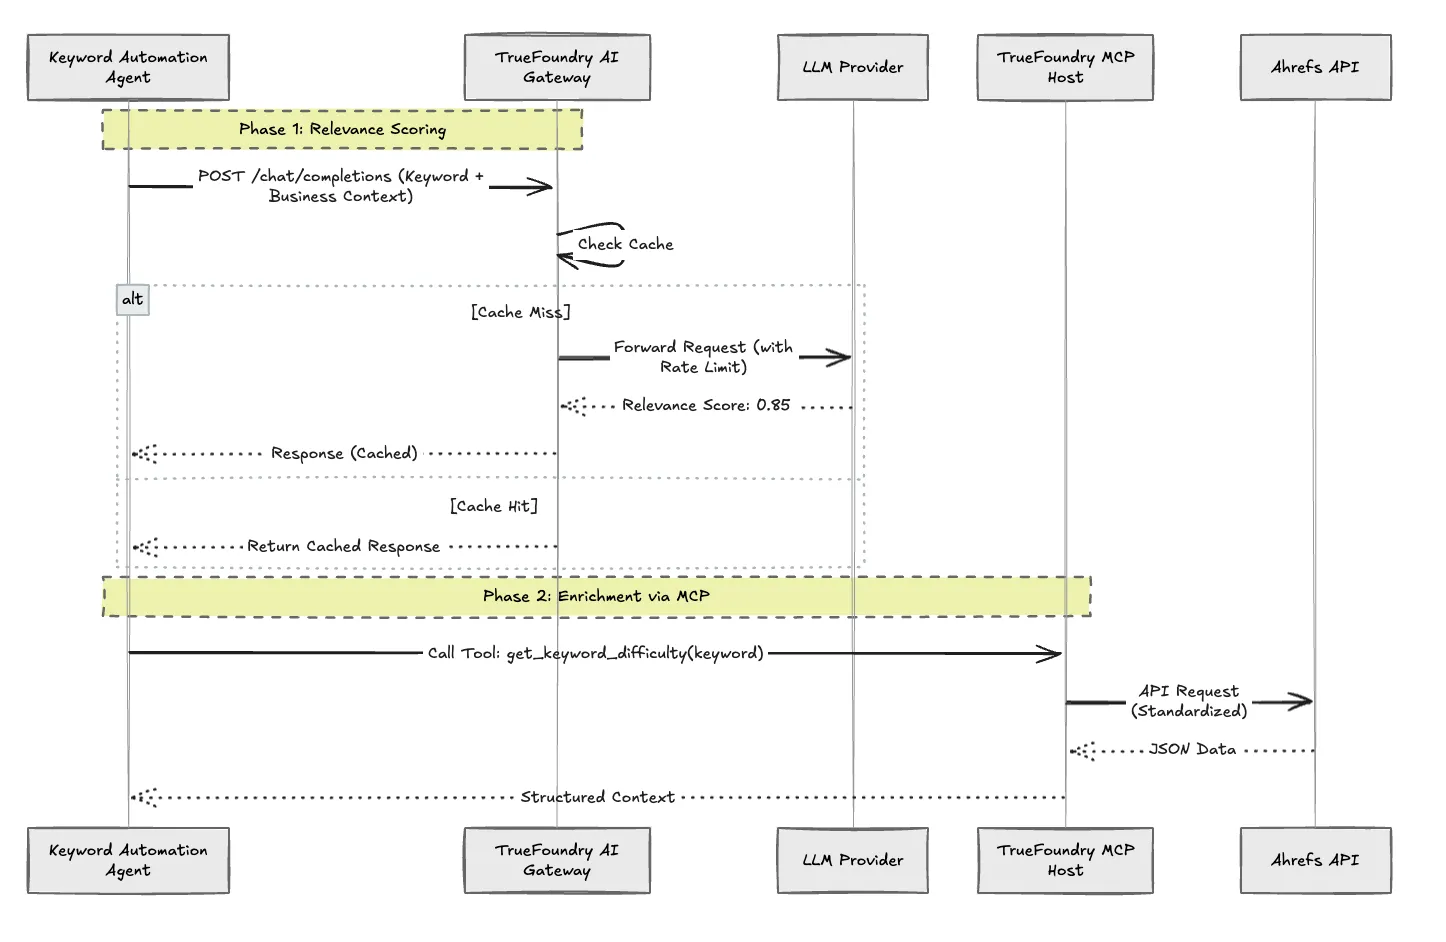
TrueFoundry AI Gateway: Encaminhamos todas as chamadas LLM (para pontuação de relevância e geração de resumos) através do Gateway. Isso oferece:
Limitação de Taxa Centralizada: Definimos um orçamento de requisições por minuto no nível do gateway, protegendo nossos provedores a jusante.
Cache: Se já tivermos pontuado a palavra-chave "LLM Observability" na semana passada, o Gateway entrega o veredito em cache, reduzindo a latência e o custo a zero.
Roteamento de Modelos: Podemos trocar o modelo subjacente (por exemplo, de GPT-4 para um modelo mais barato e rápido como o Gemini Flash) para a tarefa de classificação sem alterar uma linha do código da aplicação.
Protocolo de Contexto de Modelo (MCP): Em vez de escrever funções personalizadas para Ahrefs, implementamos um Servidor MCP Ahrefs no TrueFoundry. O Agente simplesmente consulta o servidor MCP para métricas de explorador de site ou dificuldade de palavra-chave. O servidor MCP lida com a autenticação e as especificidades da API. Isso padroniza como nossos agentes se comunicam com ferramentas externas.
Trecho de código
Comparação: Scripting Padrão vs. TrueFoundry Accelerator
A tabela a seguir destaca por que nos afastamos de scripts Python locais para uma arquitetura gerenciada.
Dimension
Standard Python Script Approach
TrueFoundry Accelerator Approach
Resilience
Fragile. If the GSC API times out or the script hits an LLM rate limit, the entire process crashes. Requires manual restarts.
High. TrueFoundry Gateway handles retries and exponential backoff. Process isolation ensures one failed batch doesn't kill the pipeline.
Security
Low. API keys for OpenAI and Ahrefs are often stored in local .env files or hardcoded.
Enterprise. Keys are managed in TrueFoundry Secrets. Agents access tools via authenticated MCP endpoints, never touching raw credentials.
Scalability
Vertical. Limited by the local machine's memory when processing large CSVs combined with trend data.
Horizontal. Workers run as microservices on Kubernetes. We can parallelize the scoring of 10,000 keywords across multiple pods.
Maintenance
High. Every time Ahrefs changes an API endpoint, the main application code must be refactored.
Low. Tool logic is isolated in the MCP Server. The core agent logic remains untouched during external API updates.
Lidando com Casos Limite e Confiabilidade
Em um ambiente de produção, os dados raramente são limpos. Implementamos salvaguardas específicas para garantir a confiabilidade:
O Portão da "Alucinação": LLMs podem ser excessivamente confiantes. Implementamos uma porta lógica onde, se a relevância = falso E a confiança < 0,6, a palavra-chave é descartada como ruído. No entanto, se a relevância = verdadeiro, mas a confiança < 0,5, ela é sinalizada para revisão humana em vez de processamento automático.
Divergência de Tendência: Um modo de falha comum em SEO é otimizar para uma palavra-chave em declínio. Nosso Enrichment Worker verifica o Google Trends. Se Impression_Trend estiver estável, mas Market_Trend estiver em ascensão, ele sinaliza uma "Oportunidade Perdida". Se Impression_Trend estiver em ascensão, mas Market_Trend for zero, ele sinaliza uma provável anomalia de bot ou pico sazonal, evitando esforços desperdiçados.
Conclusão
Ao mover o fluxo de trabalho de SEO de planilhas manuais para um fluxo de trabalho baseado em agentes no TrueFoundry, reduzimos o tempo de obtenção de insights de dias para minutos. Mais importante, separamos a lógica da infraestrutura. O TrueFoundry AI Gateway gerencia o "custo de cognição" (chamadas de LLM), enquanto o MCP gerencia a "complexidade de integração" (ferramentas externas).
Esta arquitetura prova que as ferramentas internas não precisam ser scripts improvisados. Elas podem ser sistemas resilientes e escaláveis que geram valor de negócio real.
Implante este Acelerador da Biblioteca TrueFoundry hoje para padronizar seus próprios fluxos de trabalho de enriquecimento de dados.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.