outubro 5, 2023
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
A gestão de configuração é um aspecto importante da engenharia de software. Este artigo destacará o porquê e o quê desse problema e analisará as diferentes soluções existentes.

A abordagem para gerenciar configurações muda à medida que a aplicação ganha escala — tanto em termos de tráfego quanto em tamanho da equipe de desenvolvedores. Para ilustrar essa jornada, vamos começar com uma aplicação simples.
Este é um servidor simples que se conecta ao MongoDB e retorna a lista de usuários. O código é apenas um pseudocódigo e não pretende se ater a nenhuma linguagem específica.

Hardcode de configuração na aplicação: um NÃO gigante!

Inserir a URI do MongoDB diretamente no código da aplicação tornará muito difícil executá-la em qualquer outro ambiente — como nos notebooks dos colegas de equipe ou em produção. Devemos seguir a metodologia do 12 factor app aqui para separar a configuração do código.
“ SEPARE A CONFIGURAÇÃO DO CÓDIGO “
Agora a pergunta é: o que compõe a configuração de uma aplicação? Citando de https://12factor.net/config
A configuração de uma aplicação é tudo o que pode variar entre deploys (staging, produção, ambientes de desenvolvimento, etc). Isso inclui:
1. Identificadores de recursos para o banco de dados, Memcached e outros backing services
2. Credenciais para serviços externos como Amazon S3 ou Twitter
3. Valores por deploy, como o nome de host canônico para a implantação
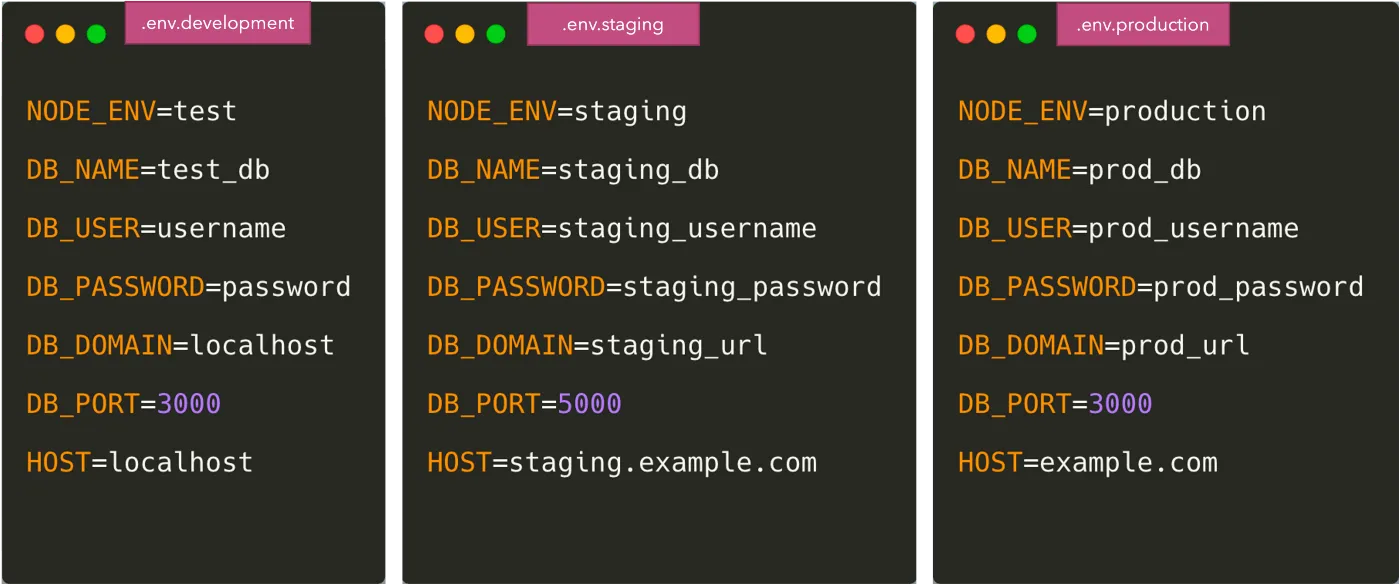
A maneira mais fácil e comum de separar a configuração do código é colocar as variáveis em um arquivo .env.

Feito isso, precisamos carregar as variáveis no código a partir do arquivo .env. Existem vários pacotes para fazer isso, como dotenv e dotenv-expand. O arquivo .env não é enviado para o Git neste caso e cada desenvolvedor sobrescreve a variável de acordo com seu próprio ambiente. Para dar a todos os desenvolvedores uma ideia de quais variáveis de ambiente precisam ser adicionadas, geralmente enviamos um arquivo como .env.example para o Git.

Também precisaremos fornecer os valores dessas variáveis nos ambientes de staging e produção. Quase todos os sistemas de deployment fornecem uma maneira de armazenar e fornecer variáveis de ambiente, como ConfigMap e Secrets no Kubernetes, ou S3 para o Elastic Container Service.
Precisaremos copiar essas variáveis para esses ambientes e mantê-las sincronizadas sempre que os desenvolvedores adicionarem ou removerem variáveis de ambiente. Uma abordagem possível é ter um arquivo .env separado para os ambientes de staging, produção, etc.

Alguém pode sugerir armazenar esses arquivos no Git, mas há um grande problema de segurança nesse caso — especialmente para algumas das credenciais sensíveis nos arquivos env.
As pessoas usam abordagens diferentes aqui — no entanto, alguns dos métodos mais conhecidos são:

Ao usar qualquer um desses sistemas externos, agora dividimos a configuração entre os arquivos .env e os secretmanagers. Alguns dos parâmetros não sensíveis virão dos arquivos .env e alguns virão do armazenamento remoto de credenciais. Podemos argumentar que podemos armazenar todos os parâmetros no armazenamento remoto — mas isso pode ser um exagero às vezes. Então, agora o que temos é:

Nossa aplicação agora precisa ter código para ler de ambas as fontes de configuração. A leitura dos arquivos .env pode ser feita usando o pacote dotenv, no entanto, obter as variáveis de ambiente dos secretmanagers exige o uso de suas APIs correspondentes para obter os valores.

Isso resolve a questão de manter nossa configuração segura e também segue a metodologia 12-factor.
No entanto, escrever código de aplicação para buscar segredos acaba sendo uma prática repetitiva, em que cada aplicação agora precisa adicionar código específico de secretmanager para obter os valores da API. Isso também significa que, se algum dia mudarmos nosso provedor de secretsmanager, o código em todas as aplicações precisará mudar. Para resolver esse problema, pode haver algumas abordagens:
A gestão de configuração é complexa e deve ser feita corretamente desde o início para garantir que a velocidade de desenvolvimento permaneça alta sem sacrificar os aspectos de segurança. O Kubernetes, que é o mais amplamente utilizado hoje para implantar aplicações, vem com seu próprio gerenciamento de configuração e segredos, o qual abordarei em outro artigo. Além disso, se você estiver usando alguma outra forma de gestão de configuração, mencione nos comentários — adoraria saber mais e aprender com você!
A TrueFoundry é um AI gateway de nível empresarial que abrange gateways de LLM, MCP e agentes, permitindo que empresas conectem, observem e governem com segurança o acesso a modelos, ferramentas, guardrails e agentes a partir de um único plano de controle. O AI Gateway viabiliza fluxos de trabalho baseados em agentes que são:
a) Seguros — resolvendo gestão de chaves, autenticação e autorização
b) Eficientes — otimizando custos, latência e failovers entre múltiplas regiões
c) À prova de futuro — permitindo conexões unificadas e composíveis entre LLMs, MCPs e guardrails de qualquer provedor
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada