outubro 5, 2023
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O rastreamento de experimentos é um aspecto crítico do desenvolvimento de machine learning, permitindo que os profissionais gerenciem e acompanhem o progresso de seus experimentos de maneira eficiente. O rastreamento de experimentos envolve registrar e monitorar vários fatores, como desempenho do modelo, hiperparâmetros e dados de treinamento, para obter insights sobre o desempenho do modelo de machine learning.
Gerenciar experimentos e rastrear resultados pode ser uma tarefa desafiadora para praticantes de machine learning devido à complexidade dos modelos, às grandes quantidades de dados envolvidas e à variedade de ferramentas e frameworks usados no desenvolvimento de machine learning. Aqui estão alguns dos principais desafios enfrentados por profissionais ao gerenciar experimentos e rastrear resultados:
Weights & Biases (W&B) é uma plataforma projetada para ajudar praticantes de machine learning a gerenciar e rastrear seus experimentos de forma eficaz. Ela fornece um conjunto de ferramentas para rastreamento de experimentos, visualização e colaboração, facilitando para os profissionais o desenvolvimento de modelos de machine learning robustos e escaláveis.
Os principais recursos e benefícios da plataforma W&B são:
A configuração do W&B para rastreamento de experimentos envolve várias etapas:
wandb.init(). Esta função inicializa a biblioteca do W&B e configura uma nova execução (run).wandb.log(). Esta função recebe um dicionário de métricas como entrada e as registra no painel do W&B.wandb.config. Esta função recebe um dicionário de hiperparâmetros como entrada e os registra no painel do W&B.wandb.log() com os dados de visualização adequados. O W&B fornece uma ampla gama de ferramentas de visualização, incluindo visualizações em 3D, matrizes de confusão e gráficos de dispersão, entre outras.Aqui está um exemplo de como registrar métricas, modelos, hiperparâmetros e visualizações usando o W&B:
import wandb
import numpy as np
import matplotlib.pyplot as plt
import tensorflow as tf

# Step 1: Initialize W&B
wandb.init(project="my-project")

# Step 2: Log hyperparameters
config = {
    "learning_rate": 0.001,
    "batch_size": 32,
    "epochs": 10
}
wandb.config.update(config)

# Step 3: Train model and log metrics
model = tf.keras.models.Sequential([
    tf.keras.layers.Dense(10, activation='relu', input_shape=(10,)),
    tf.keras.layers.Dense(1)
])
model.compile(optimizer=tf.keras.optimizers.Adam(config['learning_rate']),
              loss=tf.keras.losses.MeanSquaredError(),
              metrics=[tf.keras.metrics.MeanAbsoluteError()])
for epoch in range(config['epochs']):
    # ... train model ...
    history = model.fit(x_train, y_train, batch_size=config['batch_size'])
    loss = history.history['loss'][-1]
    mae = history.history['mean_absolute_error'][-1]
    wandb.log({"epoch": epoch, "loss": loss, "mae": mae})

# Step 4: Log visualizations and model
x = np.linspace(0, 10, 100)
y = np.sin(x)
fig, ax = plt.subplots()
ax.plot(x, y)
wandb.log({"my_plot": wandb.Image(fig)})
wandb.save('my_model.h5')

# Step 5: Finish run
wandb.finish()
c
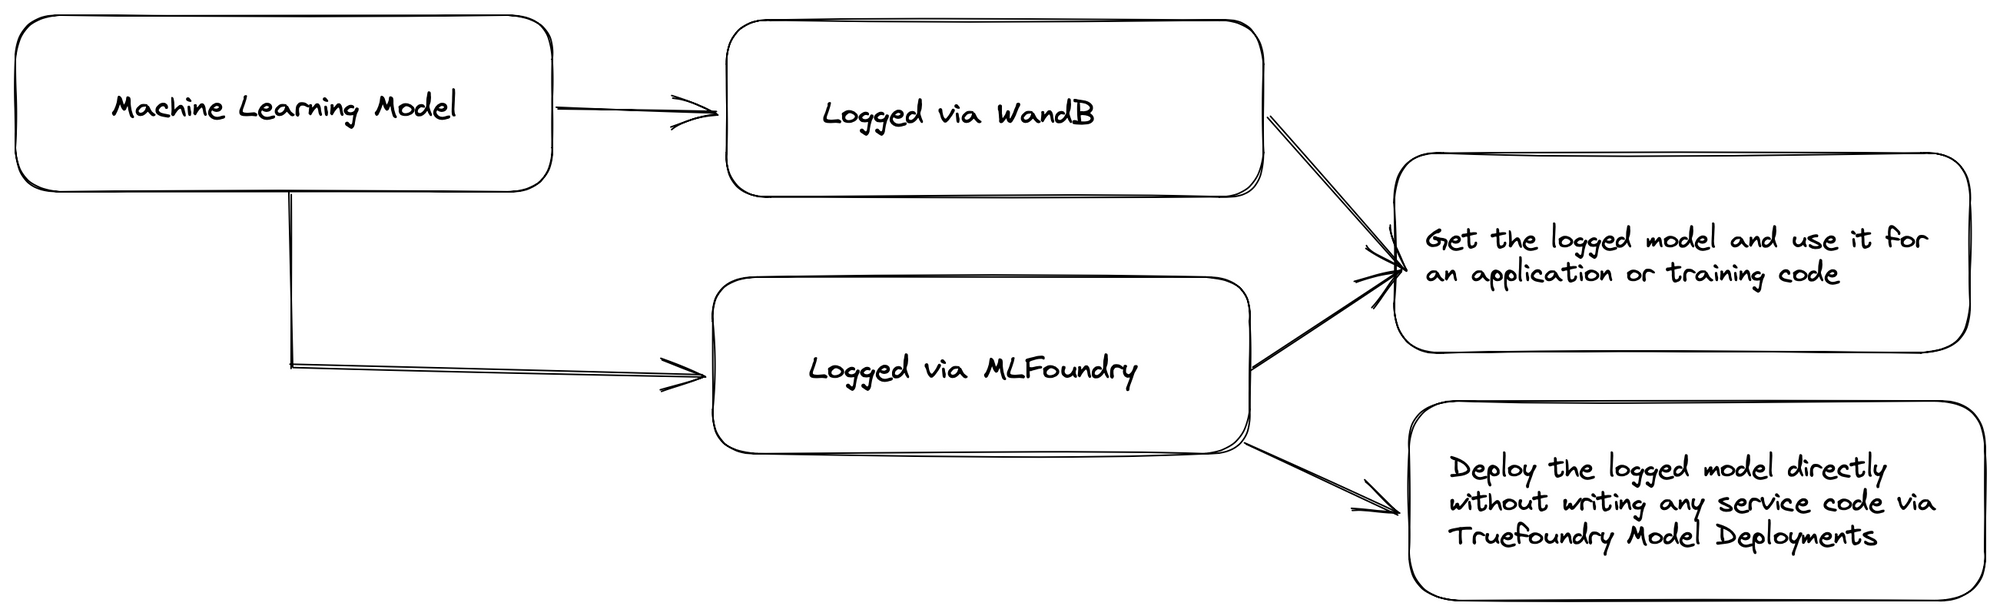
A TrueFoundry integra-se perfeitamente com o Model Registry do Weights & Biases para permitir que você faça o deploy de modelos registrados no Weights & Biases em seu Cluster Kubernetes usando a TrueFoundry.
📌
Além de usar o Weights & Biases para gestão de modelos e rastreamento de experimentos, você também pode usar o MLFoundry, a solução de Rastreamento de Experimentos da TrueFoundry.
📌
Você também pode acompanhar o código abaixo por meio do seguinte colab notebook:
Colab Notebook
Passo 1 - Instalar e configurar:
pip install wandb -qU
import wandb
wandb.login()
pip install -U "servicefoundry"
sfy login
Passo 2 - Treinar e registrar o modelo:
Primeiro usaremos wandb.init() para inicializar o projeto
Em seguida, treinaremos nosso modelo de ML e o salvaremos como um arquivo joblib
Depois, salvaremos nosso arquivo joblib no wandb por meio do wandb.save()
import wandb
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report
import joblib

# Initialize W&B
wandb.init(project="iris-logistic-regression")

# Load and preprocess the data
X, y = load_iris(as_frame=True, return_X_y=True)
X = X.rename(columns={
        "sepal length (cm)": "sepal_length",
        "sepal width (cm)": "sepal_width",
        "petal length (cm)": "petal_length",
        "petal width (cm)": "petal_width",
})

X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# Initialize the model
clf = LogisticRegression(solver="liblinear")

# Fit the model
clf.fit(X_train, y_train)

# Evaluate the model
preds = clf.predict(X_test)

# Log the model and the evaluation metrics to W&B
joblib.dump(clf, "model.joblib")
wandb.save("model.joblib")

# Finish the run
wandb.finish()
Passo 3 - Criar uma aplicação de inferência e um arquivo de dependências:
Teremos que criar dois arquivos para implantar na TrueFoundry: um arquivo app.py contendo o código da nossa aplicação e um arquivo requirements.txt contendo nossas dependências.
.
├── app.py
├── deploy.py
└── requirements.txt
c
wandb.restore() : <name_of_saved_file> e "username/project/run_id"wandb.restore("model.joblib", "adityajha-tfy/iris-logistic-regression/00r5xvyv")import os
import wandb
import joblib
import pandas as pd
from fastapi import FastAPI
wandb.login(key=os.environ["WANDB_API_KEY"])
# Retrieve the model from W&B
model_joblib = wandb.restore(
'model.joblib',
run_path="adityajha-tfy/iris-logistic-regression/00r5xvyy",
)
model = joblib.load(model_joblib.name)
# Load the model
app = FastAPI(root_path=os.getenv("TFY_SERVICE_ROOT_PATH"))
@app.post("/predict")
def predict(
sepal_length: float, sepal_width: float, petal_length: float, petal_width: float
):
data = dict(
sepal_length=sepal_length,
sepal_width=sepal_width,
petal_length=petal_length,
petal_width=petal_width,
)
prediction = int(model.predict(pd.DataFrame([data]))[0])
return {"prediction": prediction}
fastapi
joblib
numpy
pandas
scikit-learn
uvicorn
wandb
Passo 4 - Usar o SDK Python da TrueFoundry e configurar a implantação
import argparse
import logging
from servicefoundry import Build, PythonBuild, Service, Resources, Port

# Setup the logger
logging.basicConfig(level=logging.INFO)

# Setup the argument parser
parser = argparse.ArgumentParser()
parser.add_argument("--workspace_fqn", required=True, type=str)
parser.add_argument("--wandb_api_key", required=True, type=str)
args = parser.parse_args()

service = Service(
    name="fastapi",
    image=Build(
        build_spec=PythonBuild(
            command="uvicorn app:app --port 8000 --host 0.0.0.0",
            requirements_path="requirements.txt",
        )
    ),
    ports=[
        Port(
            port=8000,
            host="ml-deploy-aditya-ws-8000.demo.truefoundry.com",
        )
    ],
    resources=Resources(
        cpu_request=0.25,
        cpu_limit=0.5,
        memory_request=200,
        memory_limit=400,
        ephemeral_storage_request=200,
        ephemeral_storage_limit=400,
    ),
    env={
        "WANDB_API_KEY": args.wandb_api_key
    }
)
service.deploy(workspace_fqn=args.workspace_fqn)
Passo 5 - Implantar seu Serviço via TrueFoundry
Execute o seguinte comando e passe o seu
python deploy.py --workspace_fqn "<Your Workspace FQN>" --wandb_api_key "<Your Wandb API Key>"
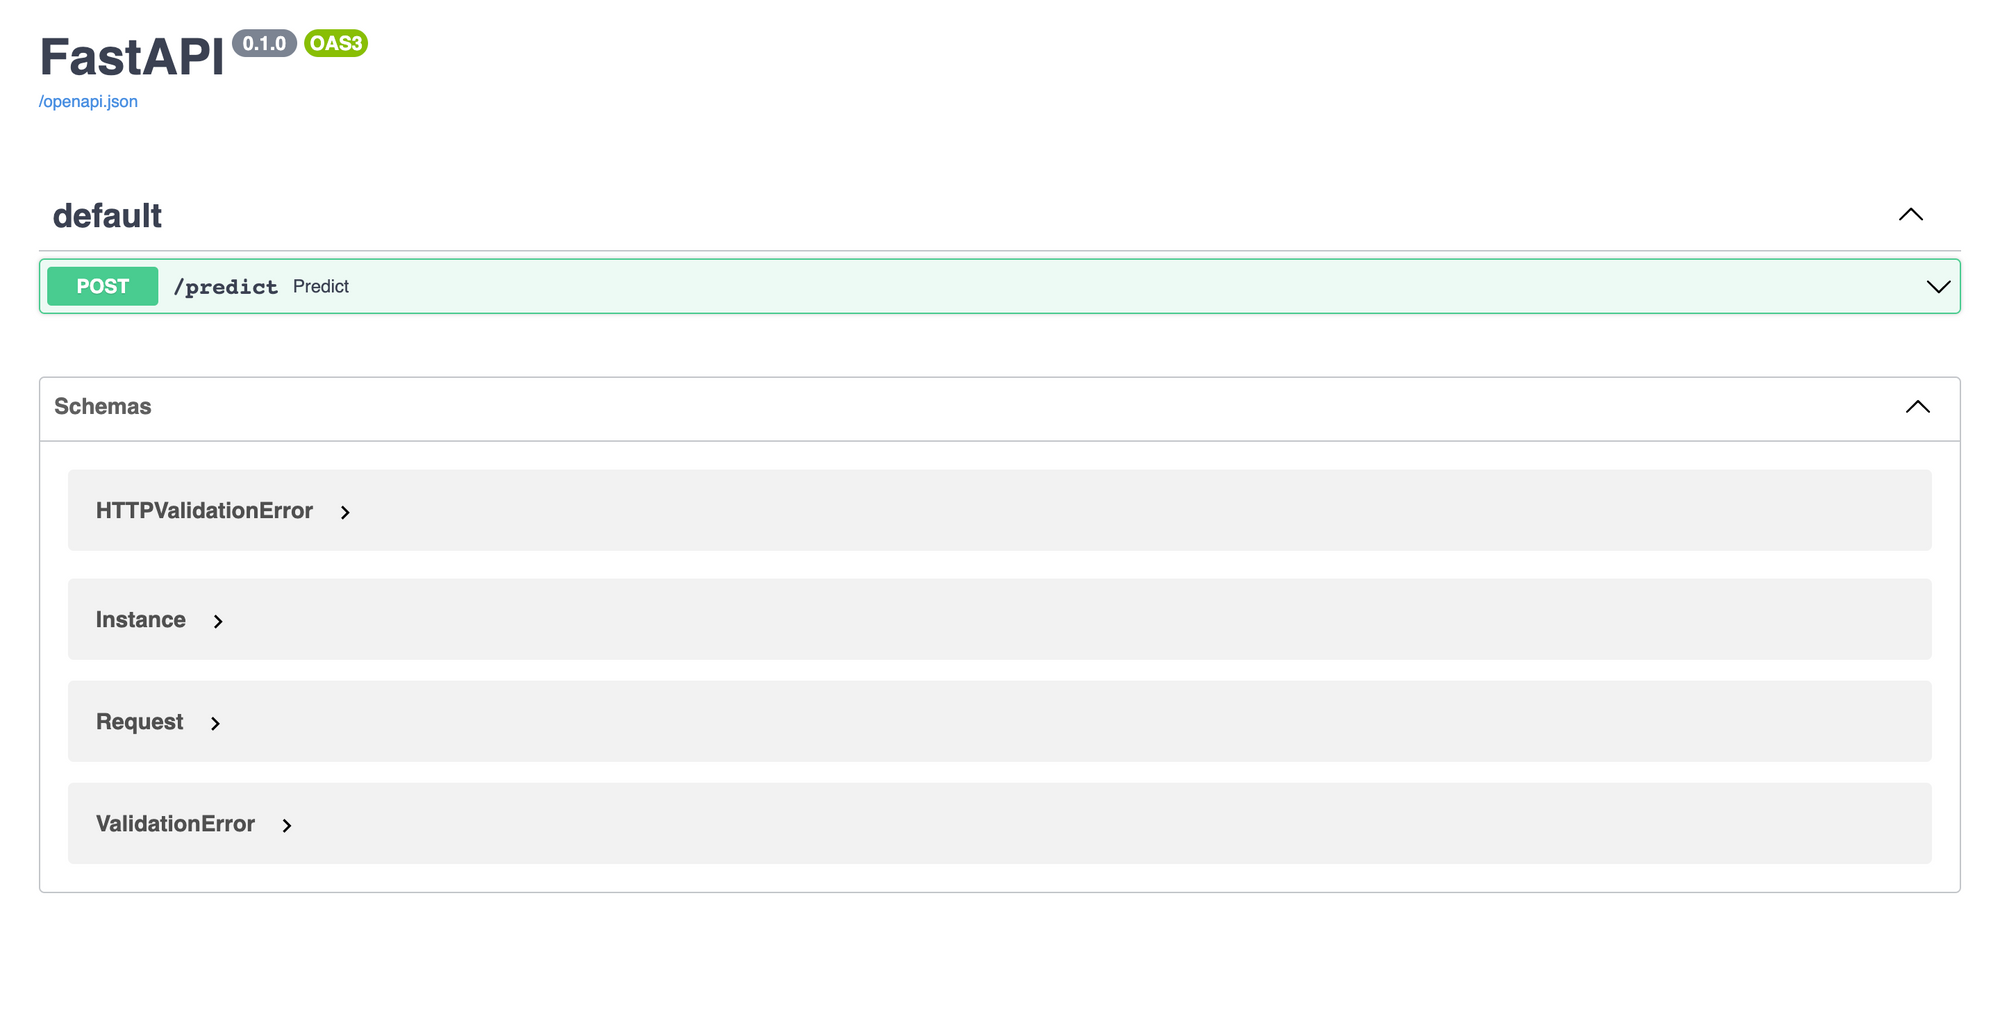
E pronto!!! Nos logs você pode encontrar o painel do seu serviço implantado. E no canto superior direito você encontrará o endpoint da sua aplicação implantada.
TrueFoundry é uma PaaS de Implantação de ML sobre Kubernetes para acelerar os fluxos de trabalho dos desenvolvedores, permitindo flexibilidade total no teste e na implantação de modelos, enquanto garante total segurança e controle para a equipe de Infraestrutura. Através de nossa plataforma, capacitamos equipes de Machine Learning a implantar e monitorar modelos em 15 minutos com 100% de confiabilidade, escalabilidade e a capacidade de realizar rollback em segundos - permitindo economizar custos e lançar Modelos em produção mais rápido, viabilizando o real valor de negócio.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada