Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.
9,9
GenAI como Serviço para Empresas
Updated: novembro 20, 2026
Published: maio 20, 2026
Built for Speed: ~10ms Latency, Even Under Load
Blazingly fast way to build, track and deploy your models!
Handles 350+ RPS on just 1 vCPU — no tuning needed
Para engenheiros de plataforma, GenAI como Serviço significa construir um sistema que permite que diferentes equipes — cientistas de dados, desenvolvedores de aplicativos e usuários de negócios — acessem, implementem e experimentem modelos de IA de forma contínua, sem se preocupar com gargalos de infraestrutura e operacionais.
Embora a ideia de GenAI pareça empolgante, a realidade é que as equipes de plataforma estão sob imensa pressão para entregar uma infraestrutura de IA escalável, econômica e segura. Elas enfrentam prazos apertados, necessidades empresariais em constante evolução e modelos de IA que mudam rapidamente, tornando a implantação de GenAI um alvo em constante movimento.
O Desafio Central: Proliferação de Modelos e Complexidade da Infraestrutura
Uma das maiores dores de cabeça para as equipes de plataforma é que os modelos estão se tornando uma commodity. A cada poucas semanas, novos e aprimorados LLMs, modelos de embedding e rerankers, etc., são lançados. As equipes de negócios querem integrá-los imediatamente, mas isso cria um pesadelo para o planejamento da infraestrutura.
Como você troca LLMs sem interromper os aplicativos existentes?
Como você garante que diferentes equipes tenham acesso ao modelo certo sem duplicar esforços?
Como você mantém os modelos funcionando de forma econômica quando os recursos de GPU são limitados?
As empresas precisam de um sistema centralizado que abstraia essas complexidades, permitindo que as equipes consumam serviços de IA sem comprometer a infraestrutura.
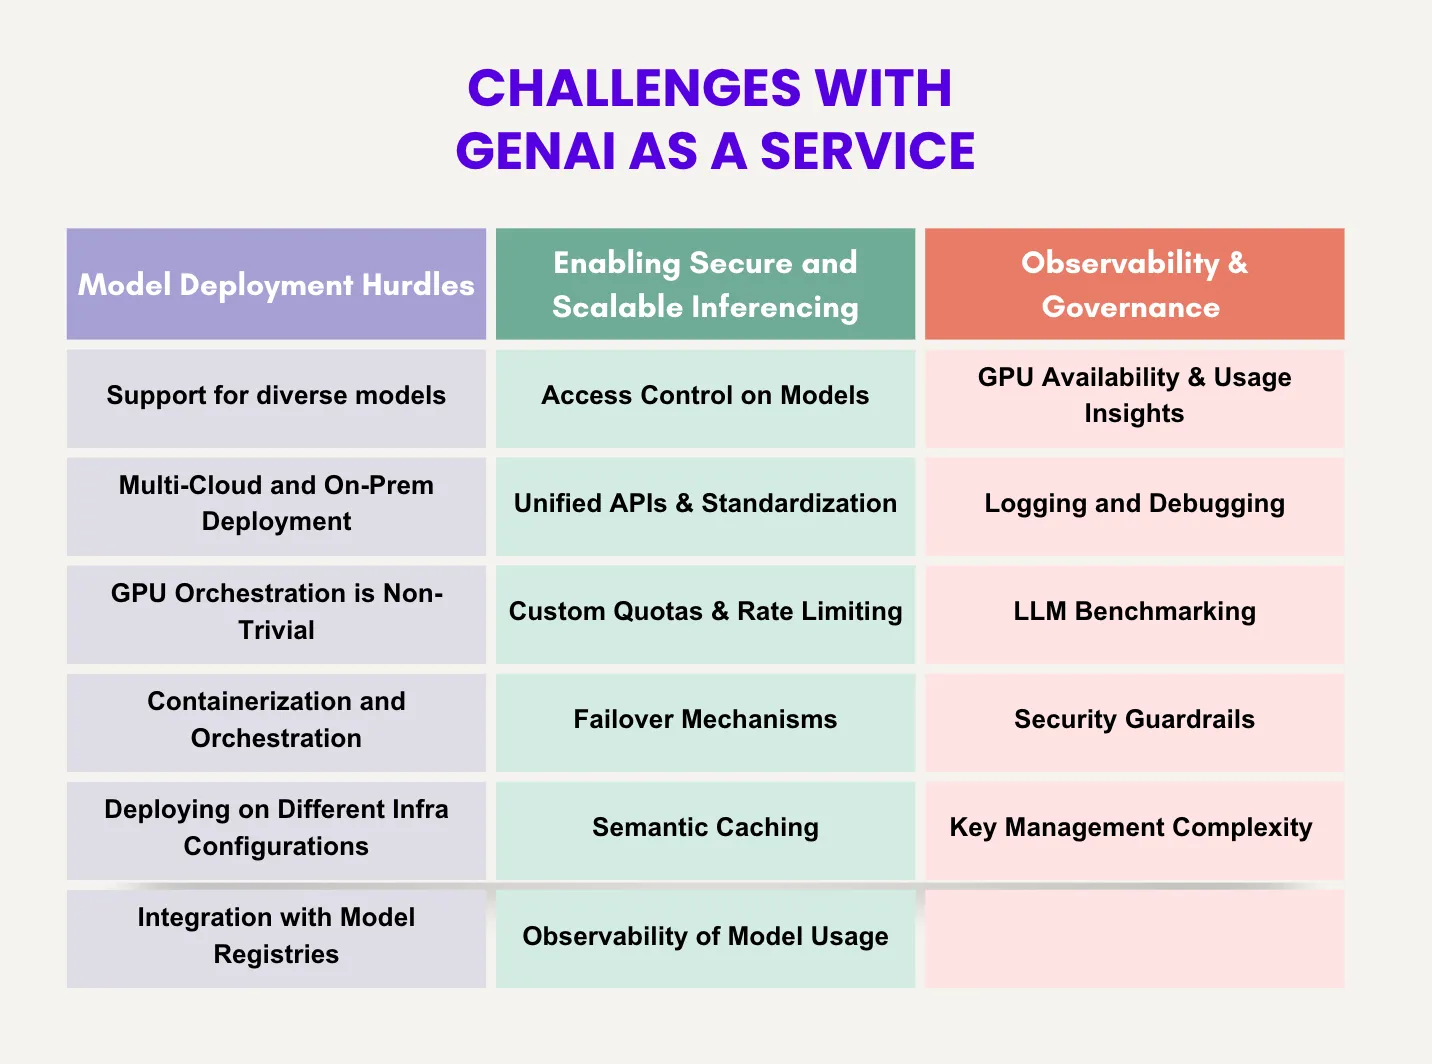
Desafios na Operacionalização da GenAI como Serviço
Ready to Build With GenAI? Start With TrueFoundry.
TrueFoundry gives you everything you need to build, deploy, and scale generative AI applications across open and closed-source models. From a unified API layer and prompt management to full observability and self-hosted deployment, it’s the enterprise-grade GenAIaaS platform built for developers.
Implantar modelos de GenAI internamente é muito mais complexo do que executar um aplicativo de software padrão -
Suporte para modelos diversos
Suporte para múltiplos modelos de código aberto (por exemplo, Llama,) e modelos de APIs proprietárias (por exemplo, OpenAI, Anthropic) .
As empresas precisam suportar vários modelos, como modelos de embedding, rerankers, etc., para diferentes tarefas.
Implantação Multi-nuvem e On-Premise: As empresas precisam de flexibilidade para implantar modelos em provedores de nuvem (AWS, GCP, Azure) ou on-premise, com base no custo, conformidade e disponibilidade de GPU
A Orquestração de GPUs Não é Trivial: Kubernetes, Ray e Slurm são frequentemente necessários para alocar GPUs dinamicamente. Além disso, alternar entre provedores (por exemplo, de AWS A100 para GCP TPU) exige trabalho personalizado.
Contentorização e Orquestração: Sem a contentorização de modelos, as equipas debatem-se com incompatibilidades de dependência, conflitos de software e problemas de versionamento. Também oferece benefícios adicionais como autoescalonamento, agendamento de GPU, tolerância a falhas, etc., que são bastante importantes em ambiente de produção.
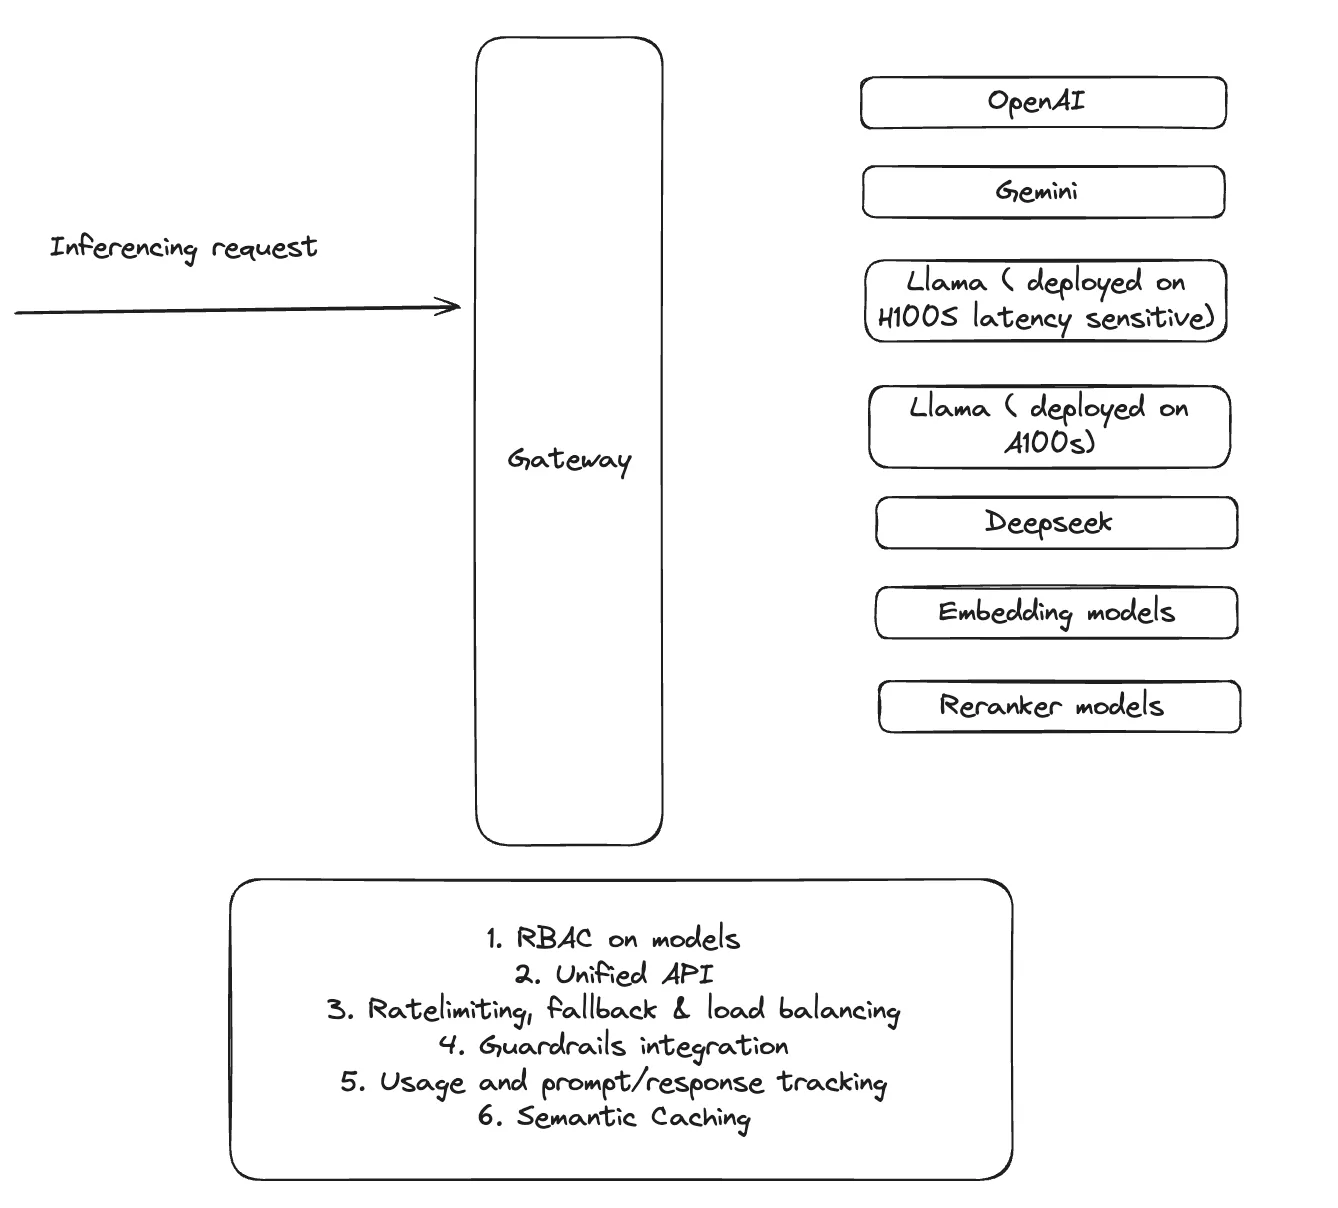
Implementação em Diferentes Configurações de Infraestrutura: Algumas cargas de trabalho exigem latência ultrabaixa para produção, enquanto o desenvolvimento e a experimentação podem tolerar latências mais altas. Exemplo: Uma empresa pode precisar de duas instâncias diferentes de Llama — uma a funcionar eficientemente em GPUs T4 ou A10G para otimização de custos, enquanto outra funciona em GPUs H100 para aplicações de alta prioridade e sensíveis à latência.
Integração com Registros de Modelos: As organizações frequentemente mantêm múltiplos registros de modelos (por exemplo, MLflow, SageMaker, Hugging Face), exigindo integração perfeita para controlo de versão e auditoria.
Gestão de Modelos Ajustados: Cientistas de dados frequentemente ajustam modelos, e as equipas de plataforma devem garantir que esses modelos sejam implementados de forma eficiente e segura.
2. Ativar Inferência Segura e Escalável
Uma vez implementados, o desafio passa a ser disponibilizar esses modelos para inferência em diversas aplicações empresariais.
Controlo de Acesso em Modelos: Definição de RBAC (Controle de Acesso Baseado em Função) para gerenciar o acesso ao modelo com base em equipes ou usuários
APIs e Padronização: Permitir que as equipes criem facilmente endpoints de inferência e troquem múltiplos LLMs através de um portal de autoatendimento.
Cotas Personalizadas e Limitação de Taxa: Definição de cotas de uso do modelo a nível de usuário, equipe ou organizacional para garantir uma alocação justa de recursos.
Mecanismos de Failover: Implementação de soluções de fallback para prevenir interrupções na produção, como a troca automática para outro provedor de modelo (por exemplo, OpenAI para um modelo alternativo).
Cache Semântico: Aproveitamento de estratégias de cache para garantir que consultas semelhantes não exijam computação redundante, melhorando a eficiência.
Observabilidade do Uso do Modelo: Captura de todas as solicitações de usuários, respostas de modelos e chamadas de API para governança, depuração e faturamento.
3. Observabilidade e Governança
Os modelos GenAI não são estáticos; eles precisam de avaliação e melhoria contínuas. As equipes de plataforma enfrentam desafios com:
Disponibilidade de GPU e Insights de Uso: Oferecer transparência na utilização da GPU para otimizar a alocação de recursos.
Registro e Depuração: Captura de todas as métricas de uso, incluindo prompts de usuário e saídas de modelo, para melhor rastreamento e análise.
Benchmarking de LLM: Fornecer dados empíricos sobre o desempenho de LLMs para garantir que os modelos escolhidos atendam aos padrões de qualidade e confiabilidade desejados pela empresa.
Barreiras de Segurança: Integração com barreiras de segurança predefinidas ou personalizadas para evitar a exposição de dados PII e outras informações sensíveis
Complexidade no Gerenciamento de Chaves: Gerenciar chaves de API, segredos e autenticação em diferentes ambientes de nuvem adiciona riscos de segurança e sobrecarga operacional.
Como a TrueFoundry Habilita GenAI como Serviço
A TrueFoundry oferece uma plataforma de infraestrutura de IA ponta a ponta que simplifica a implantação de modelos, inferência e governança — permitindo que as equipes de plataforma se concentrem em escalabilidade, eficiência e segurança, em vez de gargalos de infraestrutura.
A Plataforma Completa para Implantações Unificadas
A TrueFoundry oferece uma plataforma de IA nativa de Kubernetes que automatiza a implantação de modelos e o gerenciamento de infraestrutura, eliminando a necessidade de configuração manual.
Suporte multi-nuvem/on-premise - Com suporte multi-nuvem e on-premise, as empresas podem implantar modelos na AWS, GCP, Azure ou em data centers privados sem sobrecarga operacional adicional.
Suporta a implantação de modelos em diversas Estruturas, Tipos e Servidores de Modelo. Também suporta a implantação de modelos de embedding e reranker.
A plataforma seleciona automaticamente a melhor configuração de implantação Kubernetes com base na arquitetura do modelo, disponibilidade de GPU e requisitos de throughput.
A TrueFoundry também otimiza a infraestrutura fornecendo recursos de autoescalonamento que reduzem o tempo de escalonamento do modelo em 3 a 5 vezes, diminuindo significativamente os atrasos de cold-start.
Também suporta recursos avançados como streaming de imagem, roteamento persistente (sticky routing) para LLMs e recomendações inteligentes de GPU
Além disso, a TrueFoundry permite a implantação de modelos self-service, permitindo que cientistas de dados implantem modelos sem experiência em Kubernetes, reduzindo dependências de engenheiros de plataforma e acelerando a adoção de IA entre as equipes.
Suporte GitOps completo para facilitar a vida das equipes de plataforma
Inferência de Modelo Unificada e Escalável
A TrueFoundry simplifica a inferência de modelos fornecendo um Gateway de IA centralizado, garantindo acesso contínuo aos modelos em diferentes ambientes de nuvem.
Com uma única API, as equipes de plataforma podem gerenciar modelos de código aberto (Llama), soluções comerciais (OpenAI, Bedrock, Mistral) e modelos empresariais ajustados (fine-tuned). Essa unificação garante experiências de inferência consistentes em todos os fluxos de trabalho.
Também suporta limitação de taxa para garantir cotas entre usuários/equipes/modelos, balanceamento de carga e failover automatizado para evitar interrupções. Em caso de interrupções de serviço ou degradação de desempenho, os modelos podem alternar de forma transparente para provedores alternativos sem intervenção manual.
Além disso, o cache semântico reduz computações redundantes, otimizando o tempo de resposta e reduzindo os custos operacionais.
A TrueFoundry também integra nativamente modelos de reranker e embedding, facilitando a construção de geração aumentada por recuperação (RAGs), um caso de uso comum.
Observabilidade, Segurança e Governança
As equipes de plataforma podem rastrear o uso do modelo em tempo real, monitorar quem está invocando quais modelos e com que frequência, e analisar o desempenho do sistema para otimizar a alocação de recursos.
A plataforma oferece ferramentas detalhadas de log e depuração, permitindo que os engenheiros rastreiem problemas de forma eficiente, reduzindo o tempo de inatividade e melhorando a confiabilidade.
A segurança é um foco central, com gerenciamento centralizado de chaves de API, prevenindo acesso não autorizado e garantindo que os processos de autenticação permaneçam seguros em todos os ambientes de nuvem. A TrueFoundry também garante privacidade de dados de nível empresarial ao implantar todas as cargas de trabalho de IA dentro da infraestrutura VPC da organização, eliminando riscos de exposição externa de dados.
Além disso, a plataforma se integra perfeitamente com guardrails como Nemo guardrails, Arize etc., para detecção de PII, etc.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.