



October 10, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Published: October 10, 2026
Blazingly fast way to build, track and deploy your models!
Dois números dominam a maioria das conversas sobre Claude Sonnet 4.5 vs GPT-5. A Anthropic precifica o Claude Sonnet 4.5 em US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída. A OpenAI precifica o GPT-5 em US$ 1,25 e US$ 10, respectivamente. O GPT-5 leva vantagem na tabela de preços publicada.
Tabelas de preços dizem pouco sobre a produção. Um agente de codificação que executa novamente uma tarefa falha duas vezes já consumiu a economia feita com os tokens. Um pipeline de resumo com um prefixo estável de 40.000 tokens se comporta de maneira diferente de um agente que reescreve o contexto a cada interação.
Ambos os fornecedores também já avançaram além desses lançamentos. A OpenAI descreve o GPT-5 como seu modelo de raciocínio anterior e direciona os desenvolvedores para o GPT-5.6. A Anthropic agora posiciona modelos Claude mais novos acima do Claude Sonnet 4.5 para muitas necessidades de desenvolvimento. Equipes que codificam nomes de modelos de forma rígida criam dívida técnica de migração precocemente.
Ambos os modelos visam cargas de trabalho avançadas de IA generativa, embora seus focos de design sejam diferentes. Ler a abordagem de cada fornecedor diz mais aos compradores do que um único ranking. A decisão prática entre Claude Sonnet 4.5 e GPT-5 começa pelo caso de uso principal.
A Anthropic posicionou o Claude Sonnet 4.5 para trabalhos de codificação exigentes, agentes de longa duração e uso de computador. A nota de lançamento o descreve como um grande lançamento para agentes do mundo real, mantendo os preços de US$ 3 e US$ 15 do Claude Sonnet 4. O ID do modelo da API é `claude-sonnet-4-5-20250929`, um snapshot fixo em vez de um ponteiro móvel.
O GPT-5 é o modelo de raciocínio da OpenAI para codificação e tarefas agenticas em diversos domínios, exposto tanto pelo Chat Completions quanto pela Responses API. Seu snapshot é `gpt-5-2025-08-07`. O modelo aceita entrada de texto e imagem e retorna texto, com suporte a tokens de raciocínio e um parâmetro `reasoning.effort` que aceita `minimal`, `low`, `medium` e `high`.
Uma diferença prática aparece imediatamente. O GPT-5 não oferece suporte a ajuste fino (fine-tuning) ou saídas previstas, de acordo com a documentação do modelo da OpenAI. O Claude Sonnet 4.5 expõe controles agenticos, incluindo raciocínio intercalado por meio de um cabeçalho beta para raciocínio conectado a ferramentas.
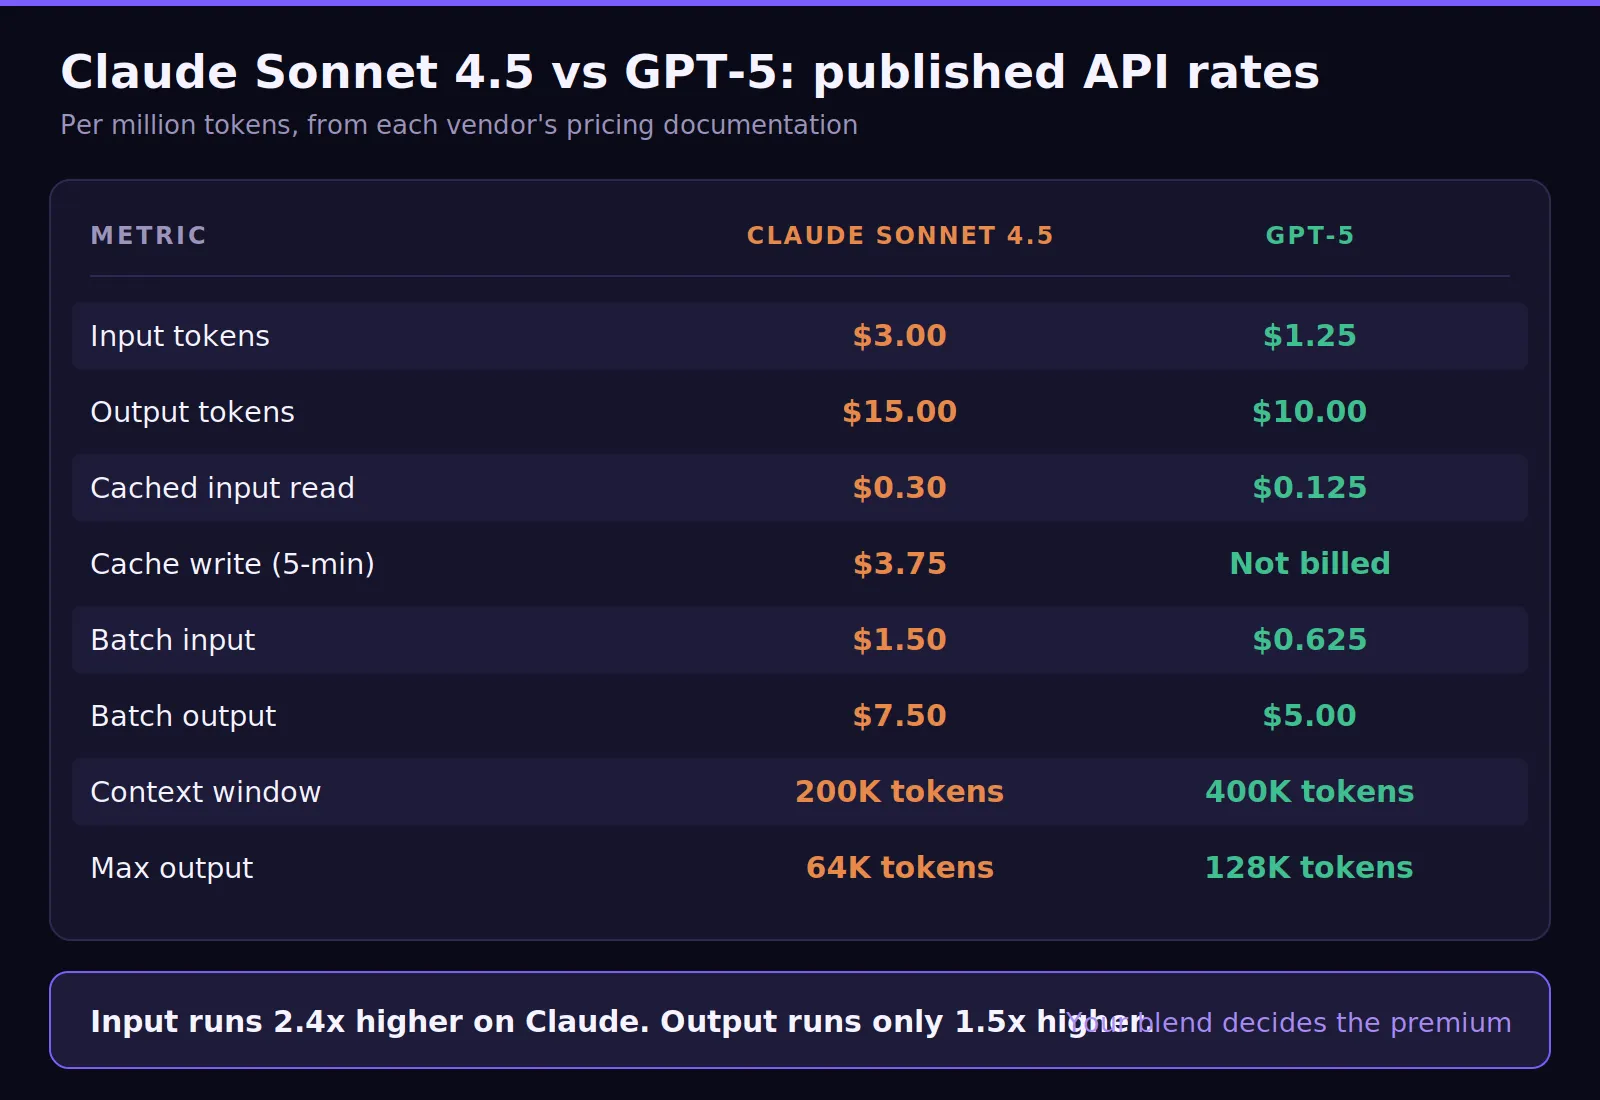
O preço é onde os dois modelos se separam mais claramente. Todos os valores abaixo vêm da documentação de preços publicada pelos fornecedores. Os compradores ainda devem modelar os custos por carga de trabalho, pois os custos de entrada, o tamanho da saída, o comportamento do cache e as tentativas de repetição afetam a fatura final.
Dois índices importam mais do que os valores absolutos. A entrada custa 2,4 vezes mais no Claude Sonnet 4.5. A saída custa 1,5 vezes mais. Como essas diferenças variam, o custo total depende da quantidade de tokens que sua carga de trabalho consome e gera.
Considere 1.000 solicitações com 30.000 tokens de entrada e 2.000 tokens de saída cada, sem cache. O Claude Sonnet 4.5 custa US$ 90,00 pela entrada e US$ 30,00 pela saída. O GPT-5 custa US$ 37,50 pela entrada e US$ 20,00 pela saída.
Isso cria uma comparação de US$ 120,00 contra US$ 57,50. O Claude custa 2,09 vezes mais nesse exemplo. A vantagem de custo do GPT-5 é clara na economia de tokens brutos, especialmente para fluxos de trabalho de alto volume de suporte, classificação e gerenciamento de conteúdo.
Agora, processe 90% dessa entrada a partir do cache. O Claude Sonnet 4.5 cai para US$ 8,10 para leituras em cache, US$ 9,00 para entrada nova e US$ 30,00 para saída. O GPT-5 chega a US$ 27,13. O prêmio cai porque o cache reduz o lado da entrada.
A contabilização do cache é a armadilha que vale a pena mencionar. A Anthropic cobra pelas gravações em cache de cinco minutos a 1,25 vezes a entrada base. A tabela de preços publicada do GPT-5 da OpenAI não lista uma cobrança separada para gravação em cache. Portanto, os preços dos tokens de resposta e a rotatividade do cache podem alterar qual é a melhor escolha.
O custo responde a uma pergunta. Se um modelo de IA consegue manter a tarefa na memória por tempo suficiente para concluí-la responde a uma pergunta mais difícil. Na comparação entre Claude Sonnet 4.5 e GPT-5, a janela de contexto, os limites de saída e os controles de raciocínio merecem uma leitura atenta.
A lacuna de contexto é fácil de subestimar. O GPT-5 aceita o dobro da entrada e emite o dobro da saída máxima. Isso é importante para grandes refatorações, páginas de texto, fluxos de trabalho complexos e longos rastreamentos de agentes que chegam como uma única tarefa grande.
O Sonnet 4.5 responde com um recurso que falta ao GPT-5. O comportamento de percepção de contexto da Anthropic injeta o orçamento restante do modelo diretamente na solicitação, como `<budget:token_budget>200000</budget:token_budget>` no prompt do sistema e um `<system_warning>` contínuo após cada chamada de ferramenta. Os planos do modelo baseiam-se na capacidade real restante em vez de estimá-la.
O Claude Sonnet 4.5 também oferece suporte a raciocínio intercalado com ferramentas por meio de um cabeçalho beta. Isso ajuda em tarefas de raciocínio complexo, raciocínio mais profundo, raciocínio científico, análise financeira, raciocínio matemático e operações de negócios com agentes, onde os resultados das ferramentas afetam a próxima etapa.
O GPT-5 oferece suporte a níveis de esforço de raciocínio por meio do modo padrão e configurações de raciocínio mais elevadas. Isso dá às equipes outra maneira de ajustar a latência, a qualidade analítica e a eficiência de custos. O modelo certo ainda depende da qualidade medida dentro da carga de trabalho alvo.
Benchmarks podem orientar a triagem inicial, embora não devam substituir os testes internos. A Artificial Analysis publica um Índice de Inteligência e comparações de modelos, enquanto outras fontes cobrem o desempenho de ART, inteligência de análise e pontuações de raciocínio especializado. Trate-os como sinais iniciais, não como evidências para aquisição.
O posicionamento da Anthropic foca em engenharia de software, uso de ferramentas e trabalho com agentes de longa duração. Isso torna o Claude Sonnet 4.5 relevante para programação com agentes, geração de código, revisão de código e operação autônoma. O modelo é especialmente interessante quando a qualidade reduz os ciclos de revisão.
De qualquer forma, trate a qualidade do modelo como algo específico da carga de trabalho. Os benchmarks de programação medem tarefas públicas, enquanto seus engenheiros trabalham em repositórios privados. Convenções de repositório, grafos de dependência, cultura de revisão e estrutura de testes determinam se o Claude Sonnet produz um desempenho superior.
Execute ambos os modelos nos mesmos 20 tickets internos e, em seguida, avalie-os com uma rubrica fixa. Conte tentativas falhas, prompts de acompanhamento, erros de ferramentas e pull requests aceitos. Um modelo que custa mais por chamada ainda pode vencer com menos revisões.
A comparação mais próxima raramente é um resultado de ranking universal. Uma equipe pode encontrar uma vantagem clara para o Claude em um repositório e para o GPT-5 em outro. É por isso que a resposta sobre Claude Sonnet 4.5 vs GPT-5 deve vir de testes reais de carga de trabalho.
O preço por token publicado do GPT-5 é inferior ao do Claude Sonnet 4.5 em entrada, saída, leituras em cache e uso em lote. Isso altera a aritmética para cargas de trabalho de produção de alto volume. Automação de suporte, classificação, verificações de qualidade de linguagem natural e ferramentas internas geralmente tendem ao GPT-5.
A janela de contexto maior de 400.000 tokens ajuda em outra classe de carga de trabalho. Pipelines de processamento de documentos podem caber em uma única chamada em vez de fragmentar e unir respostas. Menos fragmentos podem significar menos junções, menos falhas e menos cola operacional.
O custo por si só não deve definir a decisão. A qualidade da saída, o comportamento de repetição, a taxa de acerto de cache e a revisão humana afetam o gasto total. O corte de conhecimento do GPT-5 também está atrás do Claude Sonnet 4.5, o que pode ser importante para frameworks, APIs e fluxos de trabalho corporativos mais recentes.
O GPT-5 também pode ser adequado para públicos gerais e casos de uso amplos de plataformas de IA. Ele pode oferecer suporte a conteúdos semelhantes em suporte, resumos, análises e fluxos de trabalho de CMS. Para fundamentação na Pesquisa Google, o Gemini 3 Pro, o Cosmic AI ou outro modelo especializado podem se tornar uma comparação separada.
A maioria das equipes enquadra a decisão como uma escolha fixa. Geralmente, essa é a estrutura errada. A versão melhor divide por carga de trabalho e, em seguida, pergunta se um modelo deve dominar tudo. Isso torna o GPT-5 vs Claude Sonnet 4.5 operacionalmente mais útil.
Escolha o Claude Sonnet 4.5 quando:
Escolha o GPT-5 quando:
Escolha uma camada de modelo governada quando:
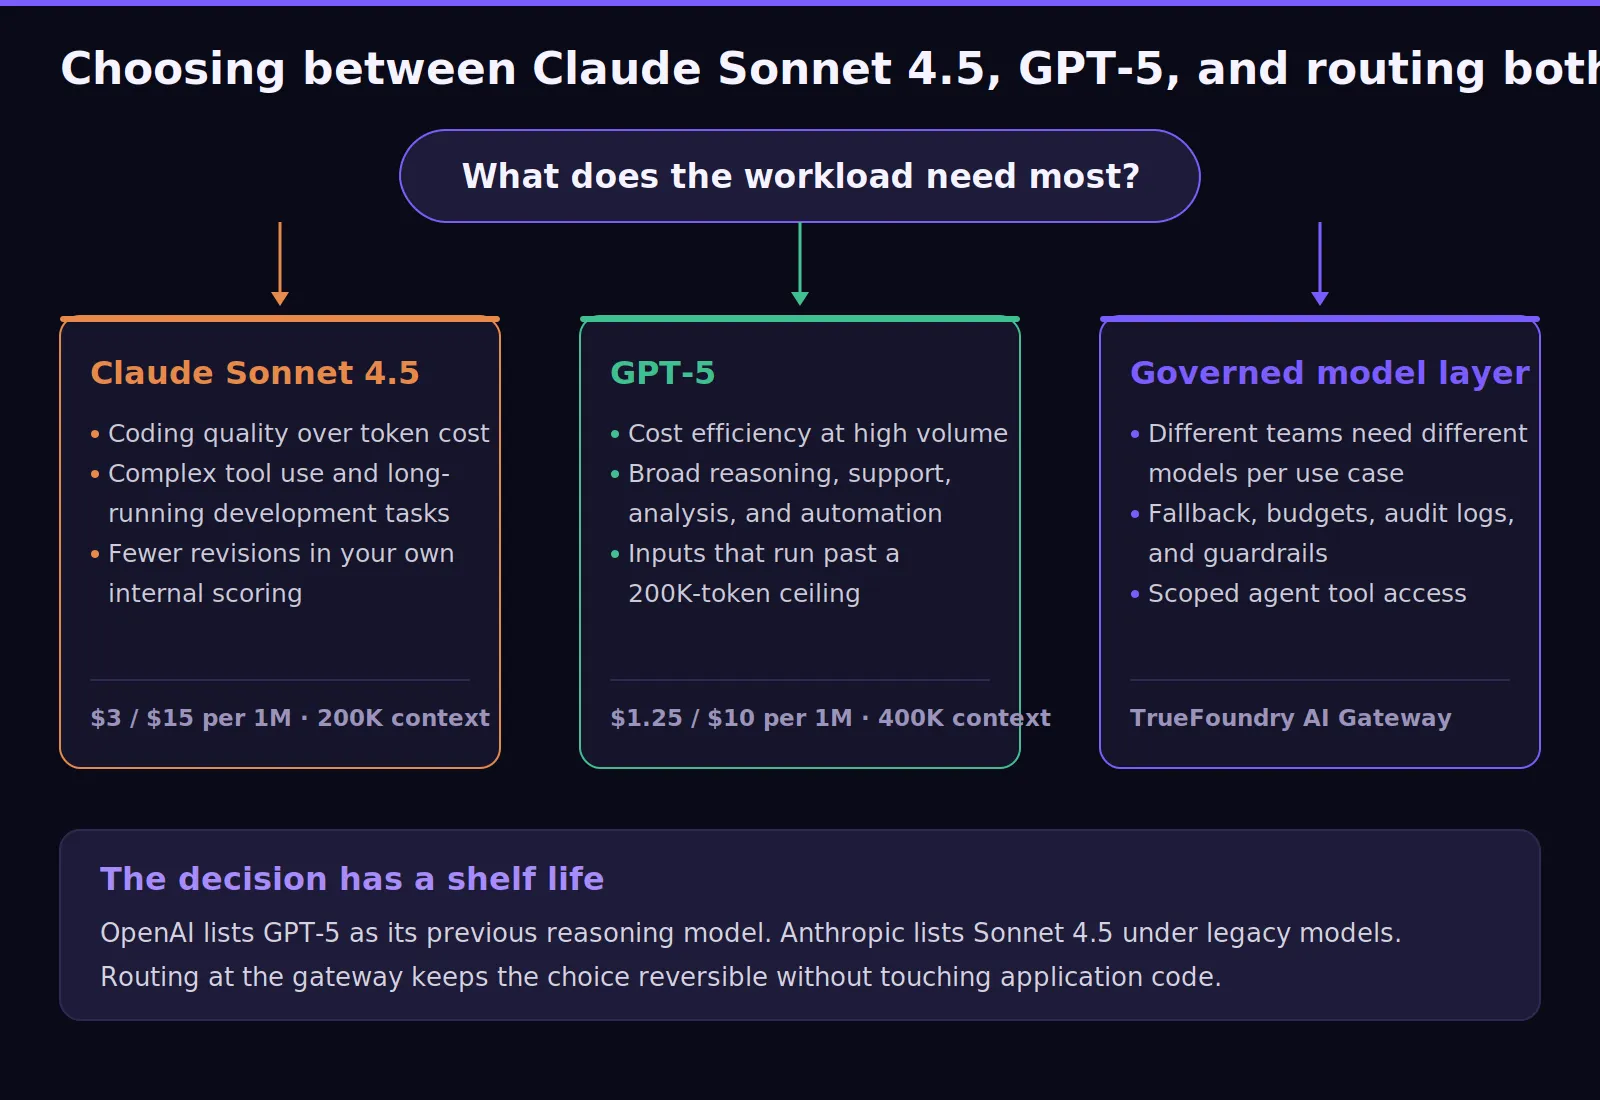
A comparação acima tem prazo de validade. O GPT-5 já carrega o rótulo de um modelo anterior. A Anthropic possui modelos mais novos além do Claude Sonnet 4.5. O cenário de IA muda rapidamente, e a TrueFoundry mantém a rotatividade de modelos fora do código da aplicação.
As equipes podem avaliar o Claude Sonnet 4.5 e o GPT-5 com base em qualidade, custo, latência e profundidade de raciocínio. A camada de governança permanece independente de ambos os provedores. Diferentes grupos podem, então, executar modelos diferentes para codificação, automação de suporte, análise e copilotos internos.
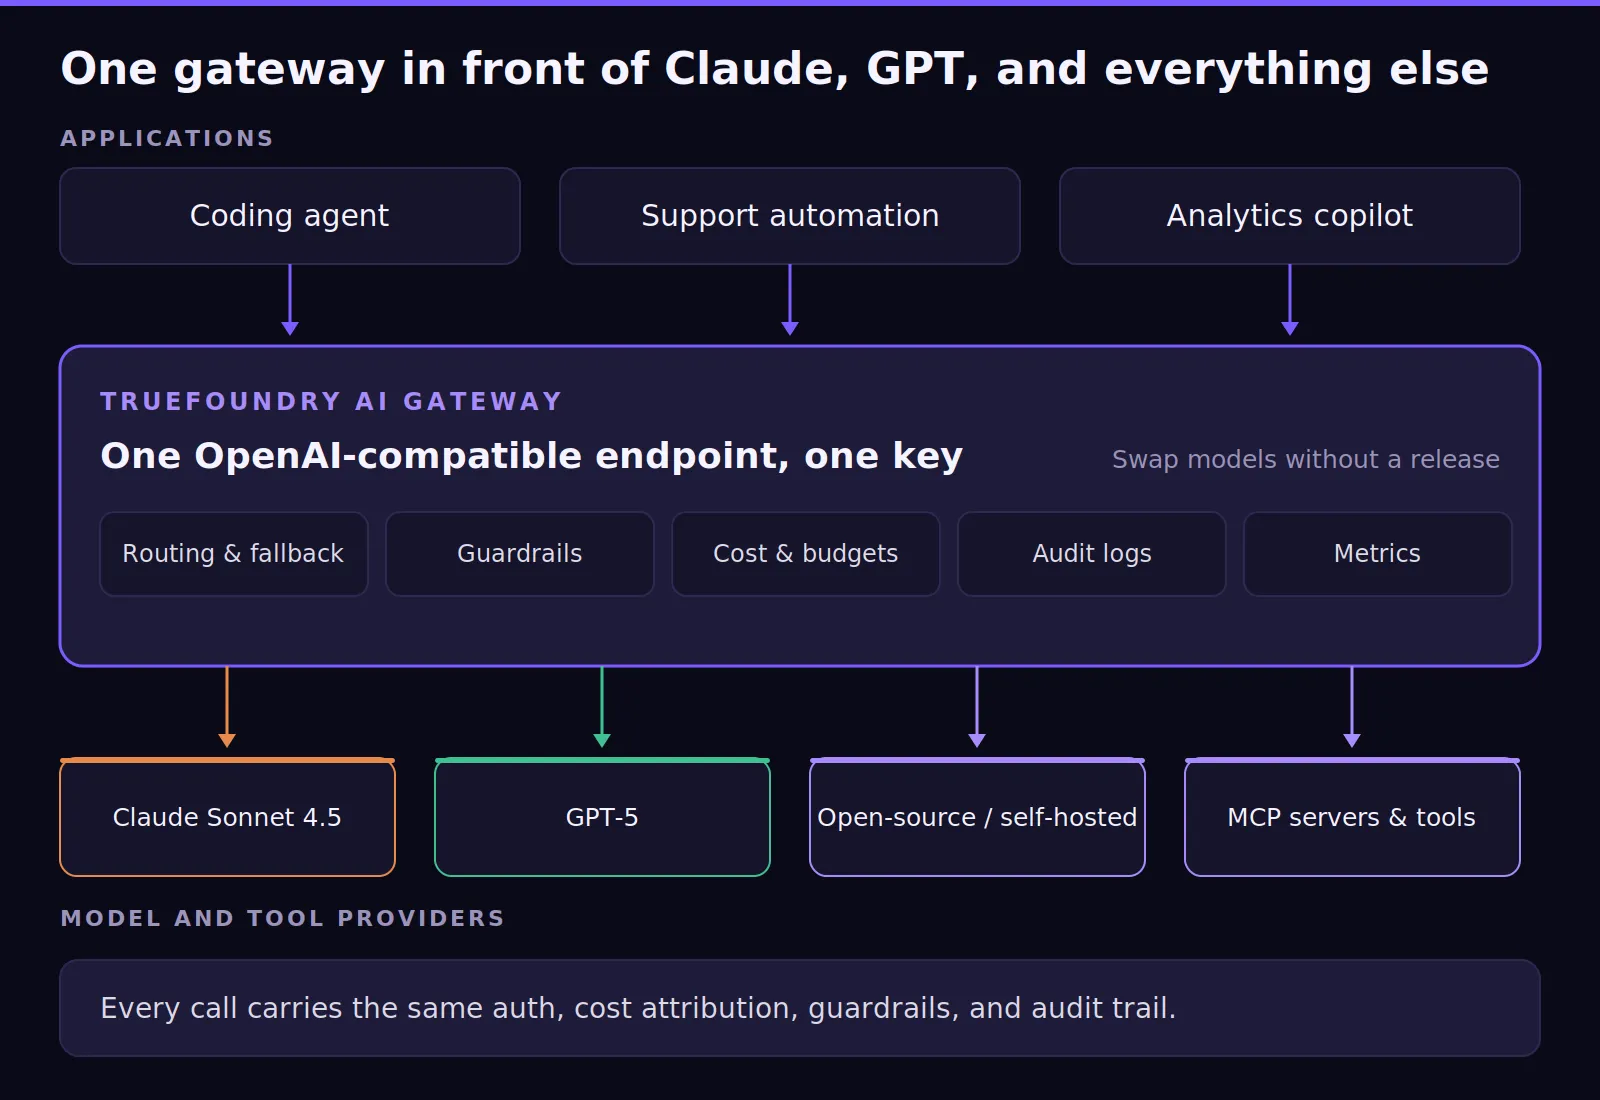
OGateway de IA atua entre aplicações e provedores de modelos. Ele expõe um endpoint compatível com OpenAI enquanto aplica autenticação, registro de logs, guardrails e controles de custo. A mesma camada pode gerenciar modelos Claude, GPT, de código aberto e auto-hospedados.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
Gateway de LLM para roteamento de múltiplos modelos.OGateway de LLM roteia solicitações entre provedores através de uma interface única, para que o GPT-5 possa lidar com resumos de alto volume enquanto o Sonnet 4.5 cuida dos caminhos de codificação e agentes. Um modelo virtual oferece a ambos um nome estável e torna a troca de destinos uma alteração de configuração, em vez de um novo lançamento.
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
As regras são avaliadas em ordem, e a primeira correspondência vence. A `retry_config` por destino lida com falhas temporárias para o mesmo modelo, enquanto os `fallback_status_codes` encaminham a solicitação quando é improvável que novas tentativas ajudem. O TrueFoundry também detecta um destino instável a partir de suas solicitações, tokens e falhas por minuto, colocando-o em espera para um período de resfriamento.
Gateway MCP para acesso seguro a ferramentas.OMCP Gateway gerencia como aplicações e agentes acessam ferramentas, APIs, bancos de dados e sistemas de negócios. O acesso com escopo definido é essencial quando um agente baseado em Claude ou GPT pode recuperar registros, chamar serviços ou acionar fluxos de trabalho.
Gateway de Agentes para governança em nível de fluxo de trabalho.OGateway de Agentes adiciona governança em nível de fluxo de trabalho em tarefas autônomas. Ele ajuda a controlar comportamentos de várias etapas, limites de execução, mensagens entre agentes e rastreamento sensível à sessão. Loops descontrolados e ações inseguras tornam-se telemetria, não surpresas no final do mês.
Guardrails, controles de custo e trilhas de auditoria. Eles transformam o GPT-5 e o Claude Sonnet 4.5 em uma decisão de produção governada. O Painel de Métricas pode relatar latência, tempo para o primeiro token, custo de inferência, tokens de entrada, tokens de saída, métricas de cache e bloqueios por limite de orçamento.
Essa capacidade transforma a comparação em uma resposta operacional, em vez de uma opinião pontual. Direcionar 10% do tráfego para outro modelo e analisar o custo por tarefa resolvida é melhor do que reler uma tabela de preços. Isso também ajuda as equipes a tomarem uma decisão informada.
Mantenha a escolha do modelo flexível enquanto a governança de produção permanece consistente. Agende uma demonstração para ver como o TrueFoundry roteia modelos Claude, GPT, de código aberto e personalizados através de um AI Gateway governado.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada




















