November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Kies een willekeurig LLM-product dat in de afgelopen drie jaar is uitgebracht en inspecteer de API. De kans is groot dat het een request accepteert met een model-veld, een messages-array van {role, content}-objecten, en temperature, en een choices-array retourneert met een usage-blok dat tokens telt. Die vorm is niet afkomstig van een standaardiseringsinstantie. Het kwam voort uit OpenAI's Chat Completions API, en het heeft gewonnen.
Voor een platformteam is "OpenAI-compatibel" een dragende term. Het is de reden waarom u op vrijdag een nieuw open-weight model kunt evalueren en het op maandag al verkeer kunt laten afhandelen zonder uw applicatie te herschrijven. Het is ook een term die stilzwijgend te veel belooft: twee endpoints kunnen beide "OpenAI-compatibel" zijn en het toch oneens zijn over hoe tool calls worden geretourneerd, hoe tokens worden geteld, en of de parameter die u instelt daadwerkelijk iets doet.
In dit artikel leggen we uit wat de standaard werkelijk inhoudt, wat "compatibel" garandeert en wat niet, en hoe een gateway veel gedeeltelijk compatibele providers omzet in één endpoint waar u met vertrouwen op kunt bouwen.
Wilt u één OpenAI-compatibel endpoint voor elke provider, inclusief failover en kostenbewaking? Boek een demo.
Standaarden winnen meestal om een van twee redenen: ze worden verplicht gesteld, of ze zijn er als eerste en worden overgenomen voordat iemand een alternatief ontwerpt. Het Chat Completions-schema behoort overduidelijk tot de tweede categorie.
OpenAI publiceerde het /v1/chat/completions-endpoint en bracht, cruciaal genoeg, officiële Python- en JavaScript SDK's uit die hier omheen waren gebouwd. Die SDK's raakten geïntegreerd in tutorials, starter templates, framework-integraties en productiecodebases in de hele industrie. Tegen de tijd dat concurrerende providers modellen hadden die het waard waren om aan te bieden, was het integratieoppervlak in de praktijk al gestandaardiseerd: miljoenen regels code wisten al hoe ze client.chat.completions.create(...) moesten aanroepen.
Een nieuwe provider stond vervolgens voor een keuze. Ontwerp uw eigen elegante API en vraag het hele ecosysteem om deze te leren, of implementeer het schema van OpenAI en krijg elke SDK, elk framework en elke tool er gratis bij. Vrijwel iedereen koos het tweede pad. Open-weight serving stacks namen het over, zodat alles wat erop draaide direct bereikbaar was vanuit bestaande code. Het resultaat is een de-facto standaard zonder officieel standaarddocument: het schema is "alles wat de OpenAI SDK verstuurt en terugverwacht."
Dit is waarom de term belangrijker is dan hij lijkt. Compatibiliteit is geen functie die een leverancier toevoegt voor de afwerking. Het is het toegangsbewijs tot een ecosysteem, en het vormt de manier waarop u uw architectuur rondom modelkeuze kunt inrichten.
Teruggebracht tot de essentie is compatibiliteit een contract over vier dingen: het endpoint, de aanvraagvorm (request shape), de responsvorm (response shape) en streaming.
Het endpoint. Een compatibele service accepteert POST /v1/chat/completions met een Authorization: Bearer <key>-header. Velen implementeren ook /v1/models, /v1/embeddings en /v1/completions. De base URL verschilt per provider; het pad blijft hetzelfde.
De request shape. Minimaal: een model-string en een messages-array van objecten met een role (system, user, assistant, tool) en content. Optionele parameters die de client kan sturen zijn onder meer temperature, top_p, max_tokens (nieuwere OpenAI-modellen gebruiken max_completion_tokens), stream, stop, tools, tool_choice en response_format.
De response shape. Een JSON-object met een choices-array; elke keuze heeft een index, een message met role en content (en tool_calls wanneer het model een functie aanroept), en een finish_reason (stop, length, tool_calls, content_filter). Een usage-object rapporteert prompt_tokens, completion_tokens en total_tokens.
Streaming. Met stream: true is de respons een text/event-stream van server-sent events. Elke data:-regel bevat een chunk waarvan de choices[].delta de incrementele token(s) bevat. De stream wordt afgesloten met een letterlijke data: [DONE].
Hier is het concrete voordeel. Deze request body is gericht op OpenAI:
POST https://api.openai.com/v1/chat/completions
Authorization: Bearer sk-...

{
  "model": "gpt-4.1",
  "messages": [
    {"role": "system", "content": "You are a terse assistant."},
    {"role": "user", "content": "Summarize MCP in one sentence."}
  ],
  "temperature": 0.2,
  "stream": false
}
Om dezelfde prompt uit te voeren tegen een andere provider via een compatibel endpoint, veranderde u twee dingen: de base URL en de model-waarde. De velden messages, temperature en stream blijven ongewijzigd. Uw verwerkingscode, die choices[0].message.content en usage.total_tokens leest, verandert helemaal niet. Dat is de gehele waardepropositie in één diff: modelkeuze wordt een string in plaats van een herschrijving.
De respons, ongeacht welke backend deze heeft verwerkt, komt terug als:
{
  "id": "chatcmpl-...",
  "choices": [
    {"index": 0,
     "message": {"role": "assistant", "content": "MCP is an open protocol..."},
     "finish_reason": "stop"}
  ],
  "usage": {"prompt_tokens": 24, "completion_tokens": 18, "total_tokens": 42}
}
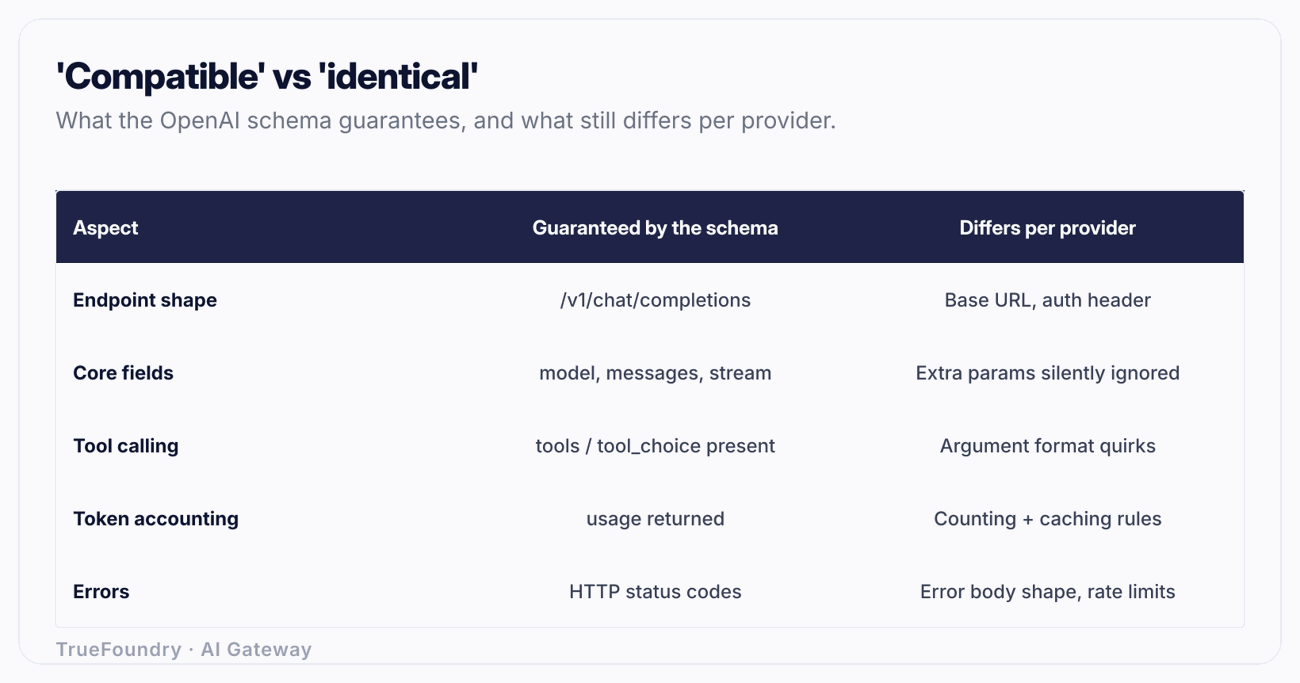
Dit is waar teams de fout in gaan. "OpenAI-compatibel" is een claim over het schema, geen garantie voor identiek gedrag. De buitenkant komt overeen; de inhoud kan verschillen op manieren die pas naar boven komen onder zware belasting of bij randgevallen.
Tool-calling dialecten. De grootste afwijking. OpenAI retourneert functie-aanroepen in message.tool_calls, elk met een id, een type en een function-object waarvan de arguments een als string geformatteerde JSON-blob is die u moet parseren. Sommige compatibele backends retourneren argumenten als een reeds geparset object, gebruiken het oudere enkele function_call-veld, streamen tool-call deltas op een andere manier, of gaan inconsistent om met parallelle tool-calls. Code die blindelings de argumenten JSON.parset, zal een foutmelding geven op een backend die ze al heeft geparset.
Tokenberekening.usage-aantallen worden berekend door de eigen tokenizer van elke provider. Dezelfde prompt die naar twee verschillende modellen wordt gestuurd, levert een verschillende prompt_tokens op omdat de tokenizers verschillen. Erger nog, sommige backends laten usage bij gestreamde responsen volledig weg, tenzij u een specifieke vlag instelt, waardoor kostenregistratie die hierop vertrouwt stilzwijgend op nul blijft staan.
Parameters die stilzwijgend niets doen (no-op). U kunt seed, logit_bias, frequency_penalty, presence_penalty of response_format: {type: "json_schema"} naar een compatibel endpoint sturen en een 200 OK terugkrijgen, waarbij de parameter volledig wordt genegeerd. Het endpoint heeft het veld geaccepteerd omdat het schema het toestaat; de backend heeft het simpelweg niet geïmplementeerd. Dit is de meest vervelende categorie bugs omdat er geen foutmelding ontstaat. Uw "deterministische" pipeline die vertrouwt op seed is ongemerkt niet-deterministisch.
Systeemprompt- en rolverwerking. Sommige backends voegen het system-bericht samen met de eerste gebruikersinteractie, ondersteunen slechts één systeembericht, of behandelen een lege content anders. Het gedrag bij gesprekken met meerdere interacties kan hierdoor afwijken.
Semantiek van finish-reason. Wanneer een model stopt omdat het een tool wil aanroepen, rapporteert OpenAI finish_reason: "tool_calls". Niet elke backend gebruikt dezelfde string, wat agent-loops die hierop vertakken kan verstoren.
De onderstaande tabel scheidt wat de standaard u betrouwbaar biedt van wat u per provider moet verifiëren.
De conclusie is niet dat "compatibiliteit nep is." Het is dat "compatibiliteit u 90% gratis oplevert en u de laatste 10% per provider moet testen." Die laatste 10% is precies het werk dat een gateway kan opvangen, zodat uw applicatie hier nooit mee te maken krijgt.
Bekijk hoe TrueFoundry u in staat stelt van model te wisselen op naam zonder de applicatiecode aan te raken. Boek een demo.
Als elke provider grotendeels compatibel is, maar subtiel verschilt, is de schoonste architectuur om uw applicatie niet langer rechtstreeks met elke provider te laten praten. Plaats één OpenAI-compatibel endpoint voor al deze providers en laat die laag de vertaling en normalisatie afhandelen.
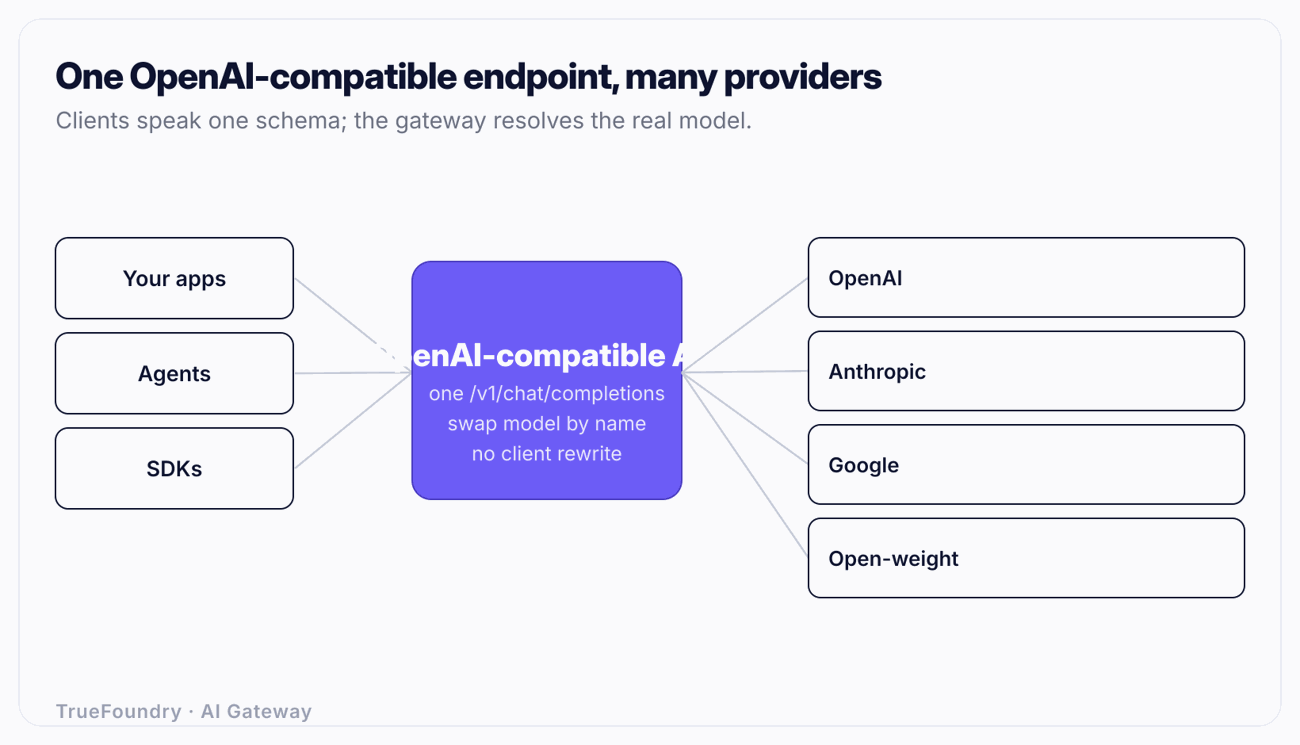
Dit is wat een AI gateway doet, en het is qua structuur hetzelfde idee als een LLM proxy: één logische voordeur met vele backends erachter. TrueFoundry biedt een geünificeerde OpenAI-compatibele API voor elke provider. Uw applicatie blijft de vertrouwde Chat Completions-vorm versturen. Om van model te wisselen, veranderde u de model-waarde in een logische naam die de gateway converteert; al het andere — request body, SDK, parsing — blijft gelijk.
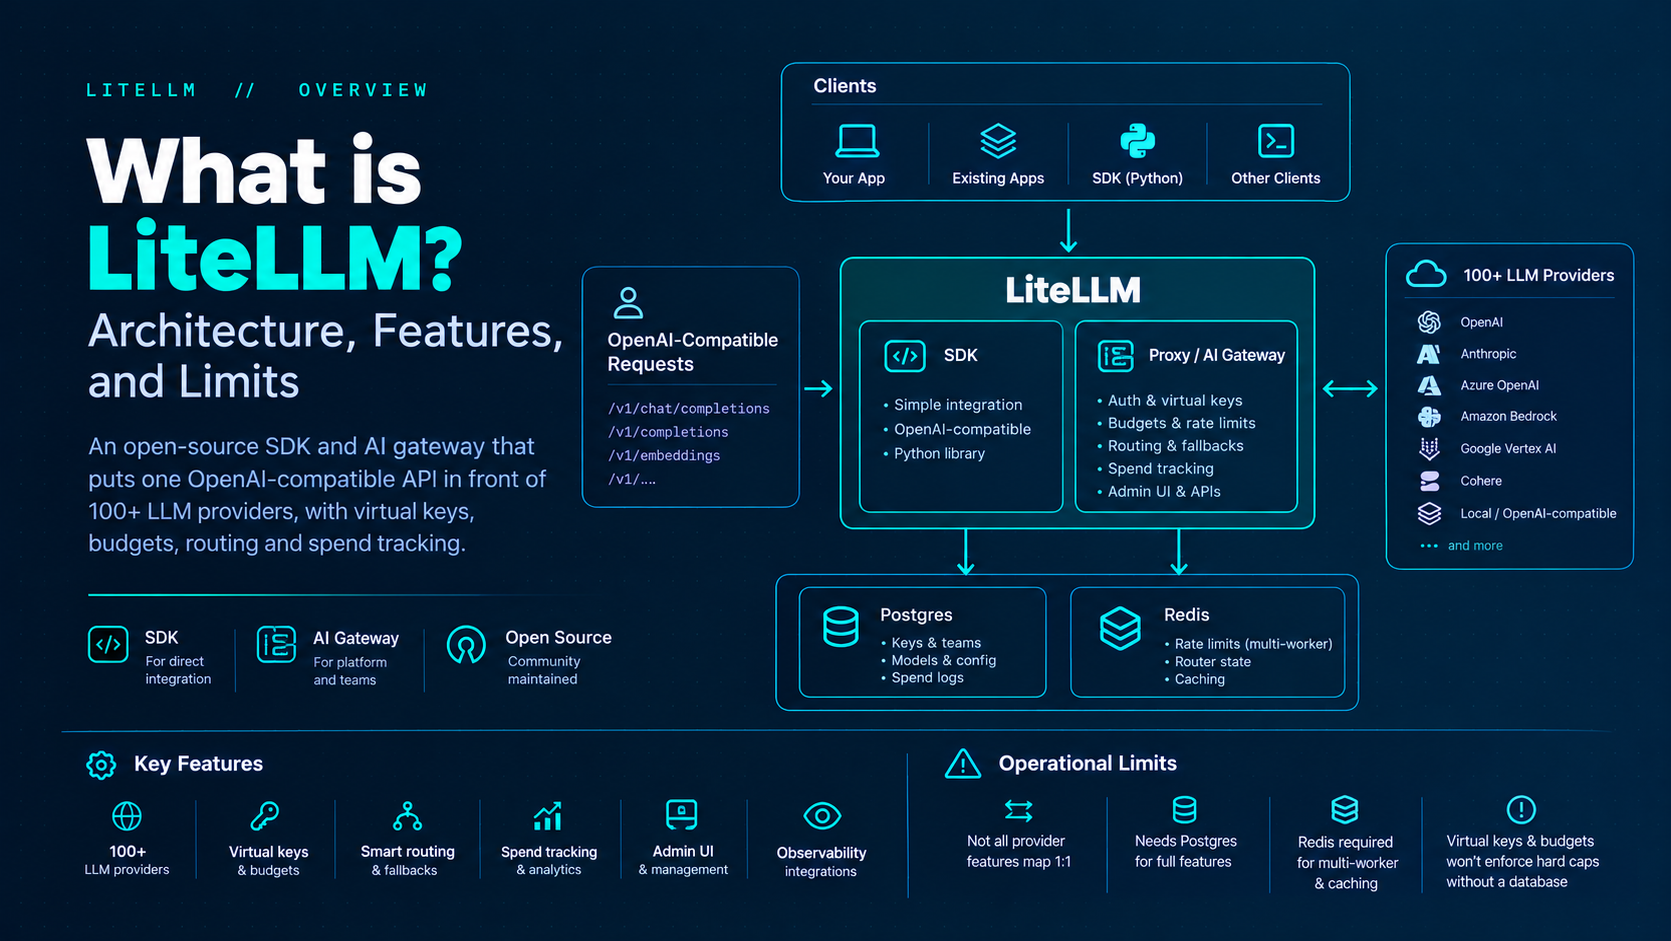
Omdat de gateway de hierboven beschreven verschillen normaliseert, hoeft uw code er niet meer op te letten of een specifieke backend argumenten van tool-calls omzet in strings of usage rapporteert bij streams. De gateway biedt één consistent dialect. Open-source libraries zoals LiteLLM hebben deze vertaallaag in code populair gemaakt; onze uitleg over wat LiteLLM is behandelt die aanpak en laat zien waar een beheerde gateway nog verder gaat.
Maar de reden om dit patroon over te nemen is niet alleen een overzichtelijke interface. Zodra elke aanvraag via één endpoint loopt, ontgrendelt u functionaliteiten die onmogelijk toe te voegen zijn aan versnipperde integraties per provider:
Routing. Een logische modelnaam kan worden ondersteund door meerdere echte targets, waarbij de gateway kiest op basis van latency, gewicht of prioriteit. Bekijk wat een LLM-router is voor kosten- en kwaliteitsbewuste modelselectie.
Fallback. Als een provider een 500-fout retourneert of een timeout heeft, probeert de gateway het binnen de aanvraag opnieuw via een fallback-target. Zo leidt een storing bij een enkele provider niet direct tot een foutmelding voor uw gebruiker. Dat is het onderwerp van LLM fallback.
Caching. Exacte en semantische caching bij de gateway verminderen zowel de latency als de kosten voor herhaalde of vrijwel identieke prompts, transparant, achter hetzelfde endpoint.
Observability en kostentoewijzing. Omdat elke aanvraag via één plek loopt, krijgt u kosten-, token- en latency-metrieken per request, gelabeld per gebruiker, team en model. Dit voedt LLM observability en kostentoewijzing aan teambudgetten. Een directe integratie per provider biedt u dit niet zonder maatwerk-instrumentatie op elke afzonderlijke integratie.
Geen van deze zaken vereiste dat u een nieuwe API invoerde. Ze kwamen voort uit het standaardiseren op de ene interface die u toch al gebruikt. Als u de opties afweegt, zet hoe kiest u een AI gateway de criteria voor u op een rij.
De beslissing is niet principieel; het gaat erom met hoeveel providers u werkt en hoeveel waarde u hecht aan veerkracht en kosteninzicht.
Directe integratie is te verdedigen wanneer u precies één provider aanroept en dat nooit zal veranderen. Op het moment dat u een tweede model wilt, bescherming zoekt tegen storingen, of één centrale bron van waarheid voor kosten wilt, betaalt de gateway zichzelf terug.
Aannemen dat compatibel identiek betekent. Het schema komt overeen; het gedrag niet altijd. Teams zetten een prompt over naar een goedkopere backend, zien dat het "werkt" en nemen het in gebruik, om er weken later achter te komen dat seed werd genegeerd en dat de uitvoer nooit reproduceerbaar was. Test de parameters waar u daadwerkelijk afhankelijk van bent bij elke backend.
Vertrouwen opusagevoor kosten zonder streaming te controleren. Verschillende backends laten het usage-blok bij gestreamde responsen weg, tenzij er expliciet om wordt gevraagd. Kostendashboards die hierop bouwen tonen nul en lijken geweldig, totdat de echte factuur binnenkomt. Controleer of het gebruik aanwezig is op het exacte type request dat u in productie gebruikt.
De base URL en SDK per provider hardcoden. Dit veroorzaakt opnieuw de wildgroei die de standaard juist had moeten wegnemen. Elk nieuw model wordt een integratieproject en elke storing bij een provider wordt uw storing. Standaardiseer op één endpoint en maak van modelkeuze een configuratie, geen code.
Tool-call argumenten parseren zonder het format te controleren. Sommige backends retourneren arguments als een string, andere als een object. Blindelings JSON.parse toepassen leidt tot foutmeldingen bij de laatste variant. Normaliseer de structuur voordat u verwerkt, of laat een gateway dit voor u normaliseren.
De gateway zien als puur technische infrastructuur. Het endpoint is het eenvoudige gedeelte. De waarde zit in wat één centraal punt mogelijk maakt: routing, fallback, caching, budgetten en kostentoewijzing, zaken die u niet eenvoudig achteraf kunt toevoegen aan N directe integraties.
Het OpenAI Chat Completions-schema werd de standaard niet door een decreet, maar doordat het er als eerste was en overal werd overgenomen. "OpenAI-compatibel" is het toegangsbewijs tot dat ecosysteem: verstuur de bekende request shape, verwerk de bekende respons. Het levert u enorm veel voordeel op — modelkeuze als een configuratiestring — zolang u er rekening mee houdt dat compatibel niet identiek is, en u het gedrag test waar u afhankelijk van bent.
De schoonste manier om dit voordeel te benutten zonder de valkuilen, is door te standaardiseren op één OpenAI-compatibel endpoint voor elke provider. Uw applicatie behoudt de interface die deze al kent, en de gateway vangt de specifieke eigenaardigheden per provider op, terwijl functies zoals routing, fallback, caching, budgetten en kostentoewijzing worden toegevoegd die u nooit achteraf aan versnipperde integraties zou kunnen toevoegen. Één interface aan de voorkant; elk model erachter.
Verenig elke LLM-provider achter één OpenAI-compatibele API. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Het betekent dat een dienst de Chat Completions-interface van OpenAI implementeert: het endpoint POST /v1/chat/completions, de verzoekstructuur met messages, de responsestructuur met choices/usage, en SSE-streaming. Bestaande OpenAI SDK-code werkt hiertegen door alleen de base URL en modelnaam te wijzigen.
Nee. Het schema komt overeen, maar het gedrag kan verschillen: formattering van tool-aanroepen, tokenberekening, en of parameters zoals seed of logit_bias daadwerkelijk effect hebben. Compatibel brengt u het grootste deel van de weg; u moet het specifieke gedrag waarop uw applicatie vertrouwt zelf verifieren.
De meeste wel, rechtstreeks of via een compatibiliteitslaag, samen met open-weight serving-stacks en vrijwel elke AI Gateway. Het schema is het standaard integratieoppervlak van de sector, dus nieuwe toetreders implementeren het vrijwel altijd.
Via één enkele OpenAI-compatibele gateway wel, u wijzigt de waarde van model en de gateway lost deze op naar een echte backend. Als u rechtstreeks met providers spreekt, kunt u provider-specifieke eigenaardigheden tegenkomen (format van tool-aanroepen, genegeerde parameters) die codewijzigingen vereisen, tenzij een gateway ze normaliseert.
Een gateway geeft u één endpoint, genormaliseerd gedrag, en mogelijkheden die u niet eenvoudig per provider kunt bouwen: routering tussen doelen, fallback bij storingen, exact en semantisch cachen, centrale budgetten en rate limits, en kostentoewijzing per verzoek, gelabeld op gebruiker, team en model.



Het laatste nieuws, artikelen en bronnen in je inbox