



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
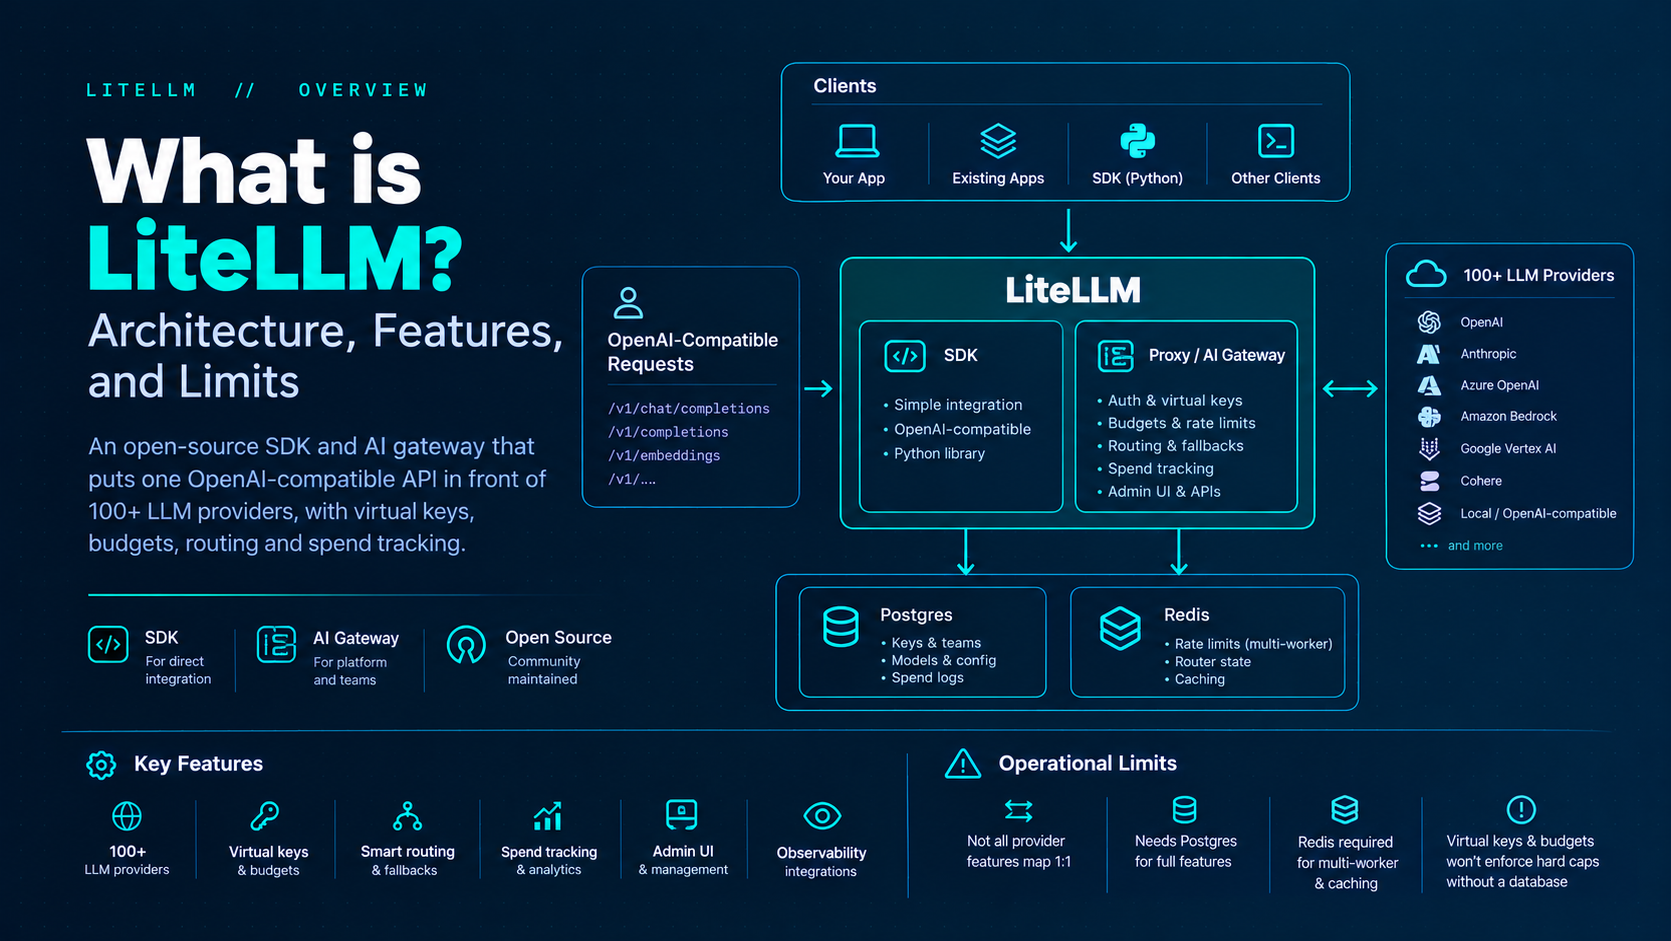
LiteLLM is een open-source bibliotheek en AI-gateway die toepassingen een enkele, OpenAI-compatibele interface biedt om 100+ LLM-providers aan te roepen—OpenAI, Anthropic, Azure OpenAI, Amazon Bedrock, Google Vertex AI, Cohere, lokale OpenAI-compatibele servers en vele anderen. U kunt het op twee manieren gebruiken: als een Python SDK binnen één toepassing, of als een gecentraliseerde proxy (AI Gateway) waar uw hele platform naar verwijst.
Dat onderscheid is belangrijk. De SDK is een ontwikkeldependency. De proxy is infrastructuur: authenticatie, virtuele sleutels, budgetten, ratelimieten, routing, uitgavenlogs, een Admin UI en integraties voor observeerbaarheid. Officiële documentatie en de BerriAI/litellm GitHub README kaderen het product op deze manier—SDK voor directe bibliotheekintegratie; AI Gateway voor GenAI-facilitering en ML-platformteams.
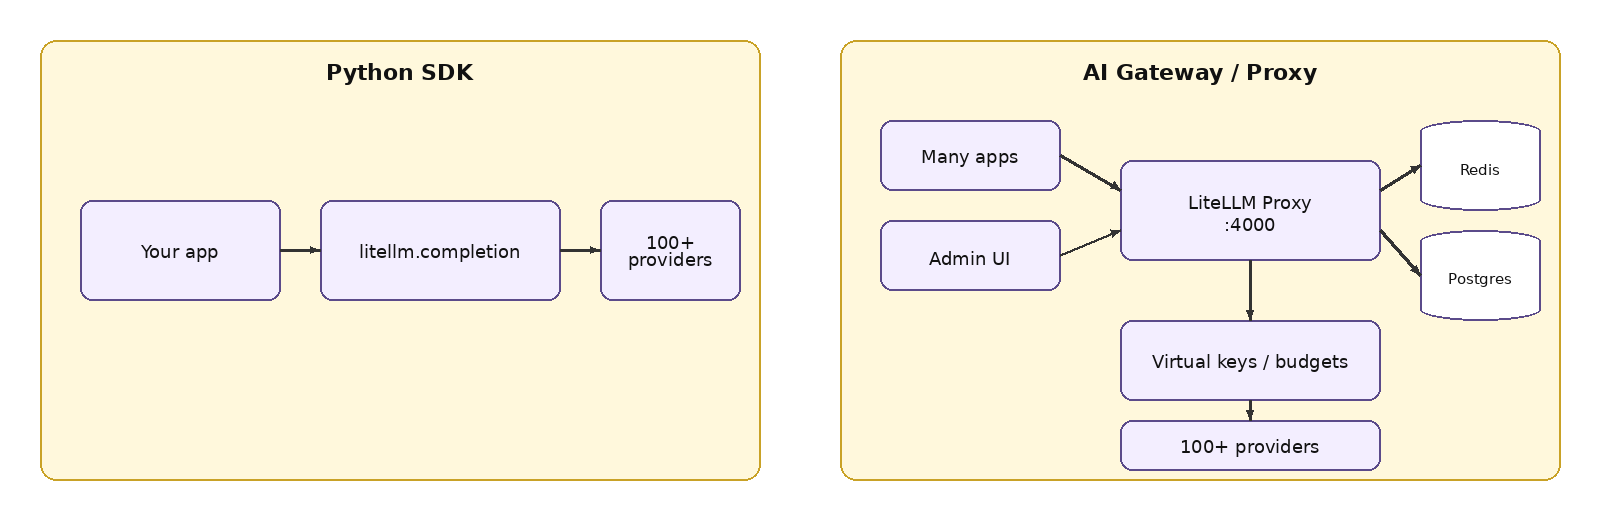
De proxy accepteert verzoeken in OpenAI API-vormen (bijvoorbeeld /v1/chat/completions en gerelateerde endpoints) en vertaalt deze naar de onderliggende provider. Clients stellen de OpenAI SDK base_url doorgaans in op de proxy (meestal http://localhost:4000 of uw ingress) en geven een LiteLLM-mastersleutel of virtuele sleutel door als de API key. Het antwoord komt terug in OpenAI-stijl JSON, zodat toepassingscode niet vertakt per vendor SDK.
Dit is de belangrijkste belofte van het product: één clientintegratie, vele backends. Het is geen claim dat elke providerfunctie 1:1 wordt overgenomen. Providerspecifieke optionele parameters, edge cases bij streaming en tool-schema's vereisen nog steeds zorgvuldige testen voor uw kritieke paden.
Bij een minimale productie-topologie voert u LiteLLM uit achter een load balancer, met Postgres voor duurzame status en Redis zodra u meer dan één worker of replica hebt. Clients en beheerders benaderen dezelfde gateway-host; LLM-verkeer gaat door auth, budget en routing; beheeroperaties en de Admin UI zijn afhankelijk van de database.
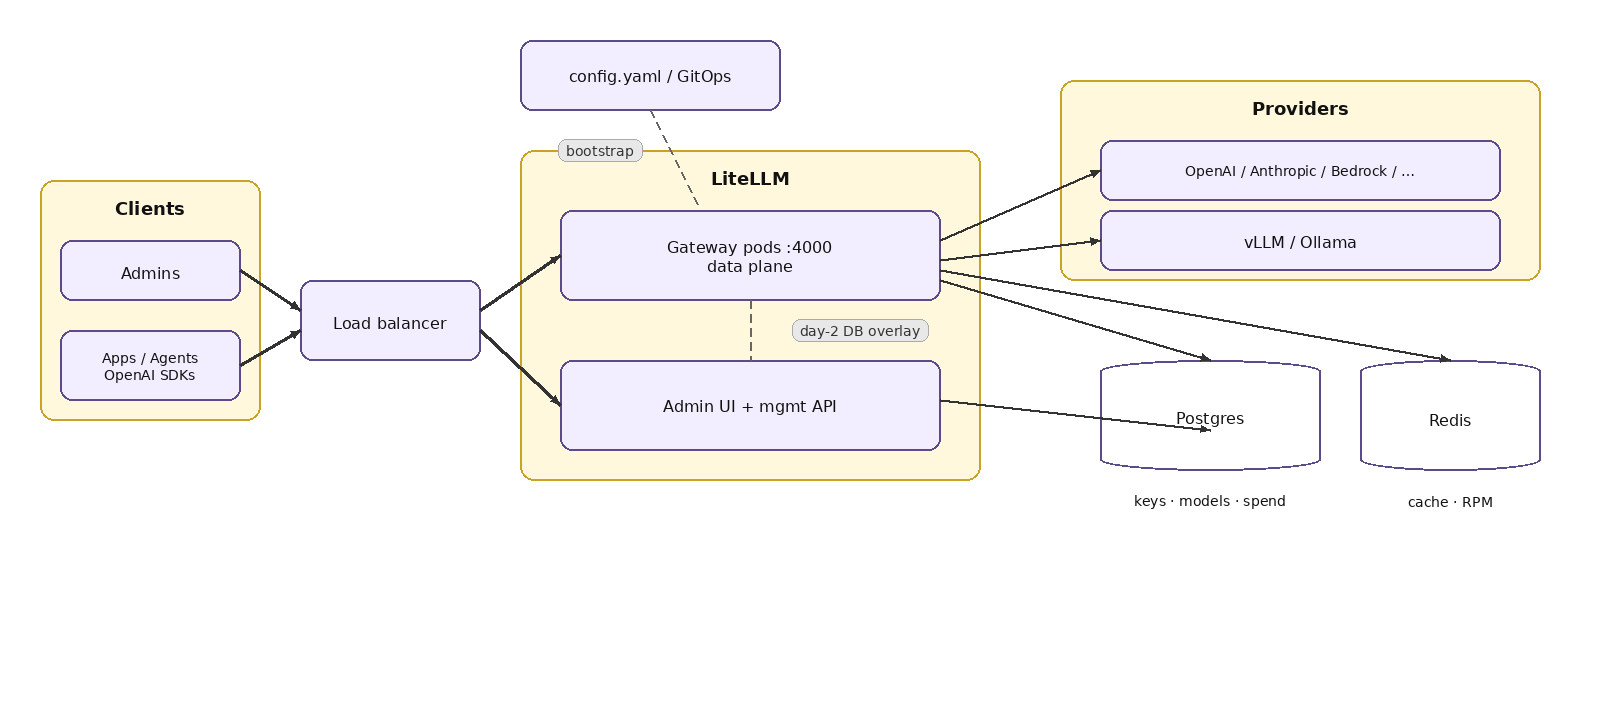
Het is nuttig om in twee vlakken te denken. Het data plane is het kritieke pad: authenticeer de virtuele sleutel, handhaaf ACL en budgetten, kies een implementatie, vertaal het verzoek, roep de provider aan, retourneer het antwoord en zet de uitgavenregistratie in de wachtrij. Het control plane is de Admin UI en beheer-API's: sleutels, teams, modellen, budgetten en dag-2 configuratie-overlays opgeslagen in Postgres.
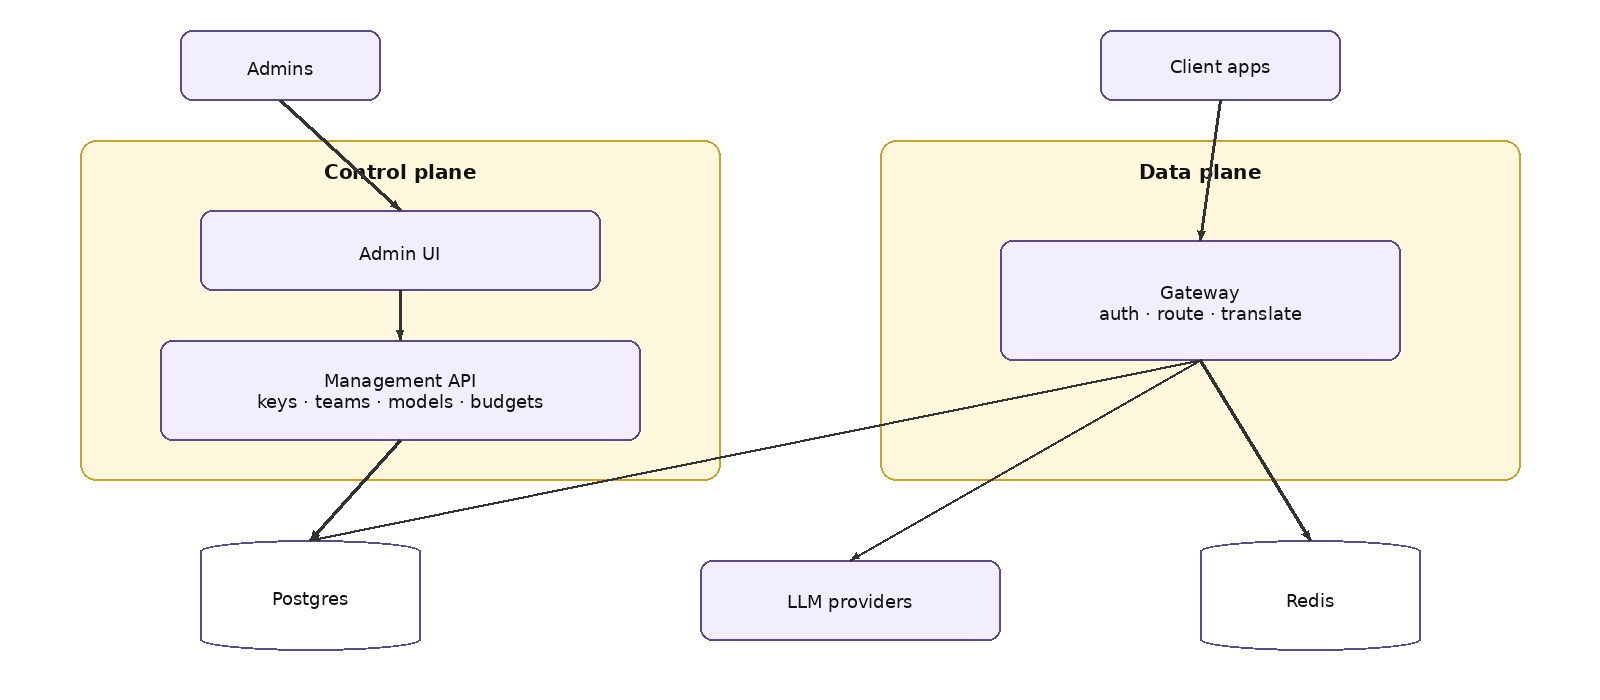
LiteLLM kan worden uitgevoerd als een monolithische image (één proces bedient LLM-verkeer, beheer-API's en UI)—wat de litellm-helm chart doorgaans uitvoert—of als microservices: een gateway voor LLM-verkeer (poort 4000), een backend voor beheer-API's en UI-backend (poort 4001), en een UI (poort 3000). Officiële productiedocumentatie beschrijft beide. De gecomponenteerde chart en gepubliceerde Terraform-modules rollen de microservice-vorm uit, zodat u vele gateway-replica's kunt schalen tegenover een kleinere backend. Component-images (litellm-gateway, -backend, -ui, -migrations) zijn gedocumenteerd als gepubliceerd vanaf v1.89.0 en hoger—zet image-tags vast in productie; ga er niet van uit dat :latest geschikt is voor productie.
Ondersteunende componenten die in die documentatie worden genoemd: PostgreSQL voor sleutels, teams, gebruikers, uitgavenlogs en configuratie; Redis voor rate limiting, router-status en caching over instanties heen; en een migratiejob die schemawijzigingen toepast terwijl proxy-pods DISABLE_SCHEMA_UPDATE=true kunnen instellen.
Postgres is vereist voor Admin UI-modelbeheer, virtuele sleutels en het bijhouden van uitgaven. Zonder database kunt u nog steeds een OpenAI-compatibele API uitvoeren vanuit config.yaml, maar budgetten worden niet gehandhaafd zoals teams verwachten: officiële quickstart-documentatie waarschuwt dat litellm_settings.max_budget niet fungeert als een harde uitgavenlimiet zonder een DB-client, en virtuele sleutels zelf vereisen een verbonden database.
Redis (7.0+ wordt aanbevolen in best practices voor productie) is aan te raden zodra u meer dan één proxy-instantie of meer dan één Uvicorn-worker uitvoert. Officiële "What Needs Redis"-richtlijn: zonder gedeelde Redis houdt elke worker zijn eigen tellers en cache bij, waardoor een limiet van 100 RPM over vier workers effectief ~400 wordt, ingetrokken sleutels op andere workers kunnen blijven hangen tot een herlaadbeurt, en antwoordcache-hits lokaal blijven. Semantische caching-backends die afhankelijk zijn van Redis/Valkey/Qdrant hebben die infrastructuur rechtstreeks nodig.
Virtuele sleutels zijn door LiteLLM uitgegeven inloggegevens die u aan toepassingen geeft in plaats van ruwe provider-sleutels. Elke sleutel kan budgetten, ratelimieten en toegestane modellijsten bevatten; uitgaven worden bijgehouden in Postgres. Teams en gebruikers staan boven sleutels voor governance in multi-tenant-omgevingen. Sleutelgeneratie en -bewerking zijn beschikbaar via de Admin UI en beheer-API's. Geautomatiseerde rotatie van virtuele sleutels met een gratieperiode is gedocumenteerd als een Enterprise-functie; master-sleutel-rotatieflows bestaan op de open-source build en zijn gericht op API's.
Productiedocumentatie raadt ook aan om uitgaven-schrijfacties te batchen (bijvoorbeeld proxy_batch_write_at: 60), zodat een hoge QPS de database niet overbelast. Bij zeer hoog verkeer (~1000+ RPS of 10+ instanties) kan een Redis-transactiebuffer uitgaven-updates in de wachtrij plaatsen voordat een enkele flusher naar Postgres schrijft.
Met de door een database ondersteunde quickstart bevindt de Admin UI zich meestal op /ui. Standaardinlog gebruikt gebruikersnaam admin en de LITELLM_MASTER_KEY als wachtwoord (de master-sleutel is ook het root-inloggegeven voor beheer-API's). Behandel die sleutel als een root-wachtwoord. Enterprise voegt SSO toe (Okta, Azure AD, Google Workspace, OIDC/SAML) voor UI-inlog; SSO is gedocumenteerd als gratis tot vijf gebruikers, met een licentie daarboven.
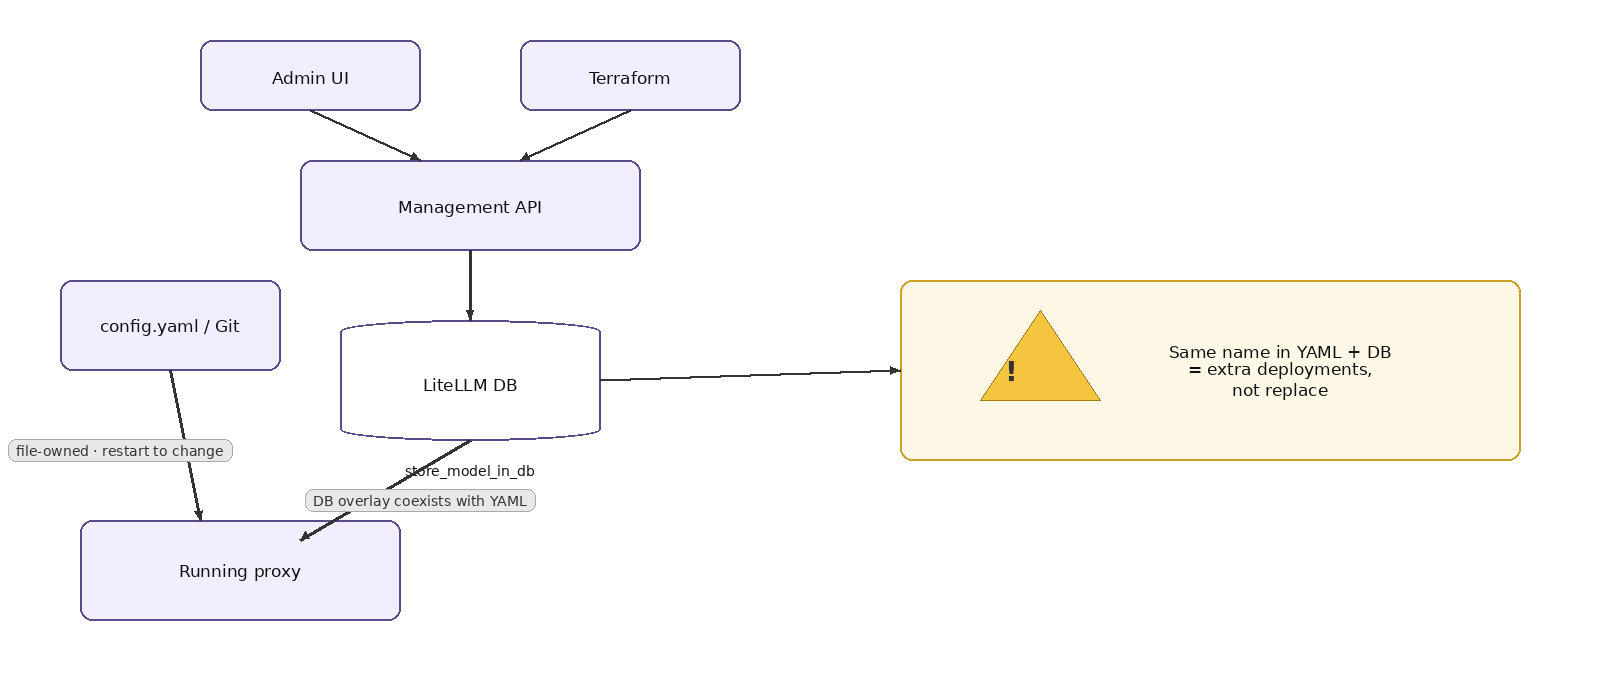
Modellen en instellingen kunnen in config.yaml staan (GitOps-vriendelijk, herstarten om bestandsgebonden modellen te wijzigen) en/of in de database wanneer store_model_in_db is ingeschakeld (UI en API dag-2 wijzigingen). Pods pollen de DB om runtime-overlays op te halen; het standaard herlaadinterval is in de orde van grootte van 30 seconden en is aanpasbaar. Dezelfde modelnaam in YAML en DB vervangt niet stilzwijgend—u kunt eindigen met extra uitrols. Bepaal één enkele bron van waarheid voor uw productiemodel-inventaris en documenteer welke knoppen bestandsgebonden zijn versus DB-gebonden.
Stel deze vroegtijdig in en bewaar ze in een secret manager:
LITELLM_MASTER_KEY authenticeert beheer-API's en dient standaard ook als Admin UI-wachtwoord. Productiedocumentatie geeft aan dat het moet beginnen met sk-. LITELLM_SALT_KEY versleutelt provider-inloggegevens die in de database zijn opgeslagen. Als u de salt-sleutel wijzigt nadat modellen zijn opgeslagen, worden die inloggegevens onleesbaar totdat ze opnieuw worden ingevoerd. Als er geen salt-sleutel is ingesteld, valt de master-sleutel terug als versleutelingssleutel—waardoor rotatie van de master-sleutel een migratie-event wordt. Stel vroegtijdig een permanente salt-sleutel in; bewaar beide sleutels in een secret manager; voeg ze nooit toe aan versiebeheer.
OSS bevat al de OpenAI-compatibele gateway, virtuele sleutels, het bijhouden van uitgaven, budgetten, fallbacks en het loggen van verzoeken/antwoorden. Enterprise voegt plichten en controles toe voor grotere organisaties: SSO + SCIM, OIDC/JWT-authenticatie voor verzoeken, organisatie-/team-beheerdersrollen, integraties met secret managers, geautomatiseerde rotatie van virtuele sleutels, IP-allowlists, uitgebreidere audit-/beheerslogs, log-routing per team, multi-regio onder één licentie, en beheerder/worker split-patronen. Sommige ingebouwde moderatie-callback-integraties zijn licentie-gebonden; aangepaste guardrails en Presidio PII-maskering worden genoemd als beschikbaar in het OSS guardrail-framework. Controleer altijd de actuele Enterprise-vergelijkingstabel voordat u aankoopbeslissingen neemt.
Officiële Enterprise-documentatie vermeldt dat LiteLLM ongeveer elke week een nieuwe minor-lijn uitbrengt en de vier meest recente stabiele minor-lijnen ondersteunt met doorlopende patches. Oudere lijnen bereiken het einde van hun levenscyclus en ontvangen geen updates meer. Dit ondersteuningsbeleid is gedocumenteerd als ingaand op maandag 29 juni 2026. Per midden juni 2026 waren de vermelde ondersteunde lijnen 1.86–1.89, die doorschuiven naarmate er nieuwe stabiele versies verschijnen. Zet image-tags vast in productie; plan upgrades voordat uw minor-lijn buiten het venster van vier lijnen valt.
LiteLLM is geschikt voor platformteams die één OpenAI-compatibele ingang nodig hebben voor meerdere providers, met uitgaven- en toegangsniveaus op sleutelniveau, zonder een aangepaste gateway te moeten schrijven. Het is minder geschikt als u slechts één provider aanroept vanuit één toepassing (de SDK of de provider-SDK alleen kan voldoende zijn), of als u een beheerd GPU-inferentieproduct verwachtte. Voor platformcontexten zoals TrueFoundry kunt u het evalueren als een control plane voor LLM-uitgaand verkeer—eerlijk over de kosten van Postgres/Redis/beheer—en niet als een modelhost. Als u opties afweegt tegen die beheerkosten, vergelijkt ons overzicht van LiteLLM-alternatieven hoe andere gateways met dezelfde afwegingen omgaan.
LiteLLM is een krachtige open-source manier om elk team één OpenAI-compatibele ingang te bieden tot meerdere LLM-providers, met virtuele sleutels, budgetten en het bijhouden van uitgaven. De afweging is eigenaarschap: Postgres, Redis, master- en salt-sleutels, wekelijkse upgrades en configuratiedrift dient u zelf te beheren. Evalueer het als een control plane voor LLM-uitgaand verkeer, waarbij die kosten vooraf worden gebudgetteerd.
Als u dezelfde geïntegreerde API wilt met ingebouwde governance en observeerbaarheid, uitgerold in uw eigen VPC, ontdek hoe de AI Gateway van TrueFoundry dit aanpakt →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



LiteLLM is an open-source Python SDK and AI gateway (proxy) that exposes a single OpenAI-compatible API in front of 100+ LLM providers, including OpenAI, Anthropic, Azure OpenAI, Amazon Bedrock, and Google Vertex AI. Applications send OpenAI-shaped requests, and LiteLLM translates them for each provider. Deployed as a proxy, it also adds virtual keys, budgets, rate limits, routing, and spend tracking, backed by Postgres and Redis.
The SDK is a Python library you import into one application to call many providers through one interface. The proxy is a shared service that every team points at via base_url, and it centralizes authentication, virtual keys, budgets, routing, logging, and the Admin UI. Use the SDK for a single app; use the proxy when a platform team needs one governed front door for LLM traffic.
Not in the durable sense: keys, teams, models, budgets, and spend logs live in Postgres, so gateway pods can be scaled and replaced horizontally. They do keep in-memory state, though—per-worker rate-limit counters, local caches, and DB config overlays polled on an interval. That is why Redis becomes required once you run more than one worker or replica; without it, limits and cache hits fragment per pod.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.



Het laatste nieuws, artikelen en bronnen in je inbox



















