



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Deel 1 benoemde het probleem: tokenmaxxing, de nieuwe 'regels code'-metriek, waarbij engineers optimaliseren voor het volume van AI-gebruik omdat dat het getal is dat wordt gemeten. Deel 2 schreef het architectonische middel voor: identiteit, beleid, veiligheid en observabiliteit gekoppeld aan elk verzoek bij de gateway. Dit laatste deel zet die architectuur om in iets dat een organisatie daadwerkelijk week na week kan operationeel beheren.
De meest ingrijpende ontwerpbeslissing in deze laag is ook degene die het gemakkelijkst over het hoofd wordt gezien. Het dashboard dat u bouwt, zal gedrag sturen. Een klassement creëert sociale druk om tokens te verbranden. Een control room helpt platform-, security-, finance- en engineering-leaders om moeilijkere vragen te beantwoorden en naar die antwoorden te handelen.
De vragen die er echt toe doen: Welke workflows creëren waarde per dollar? Welke agents zitten in een loop? Welke teams gebruiken AI te weinig waar het echt zou helpen? Welk gebruik van premium-modellen is gerechtvaardigd, en welk gebruik is decoratief? Welke guardrail-gebeurtenissen zijn ruis en welke duiden op een echt risico?
Richt de panelen juist in en dit worden routinematige operationele vragen die in de maandagse stand-up worden beantwoord. Richt ze verkeerd in en uw meest nauwkeurige dashboard stimuleert ongemerkt hetzelfde beïnvloedbare gedrag dat u juist wilde voorkomen.
Voordat we naar de panelen kijken, eerst de ontwerpregels. Elk principe is het directe antwoord op een valkuil die klassementen introduceren.
Het adoptiepaneel beantwoordt een bedrieglijk eenvoudige vraag: hoeveel engineers gebruiken op een willekeurige dag daadwerkelijk AI-tools?
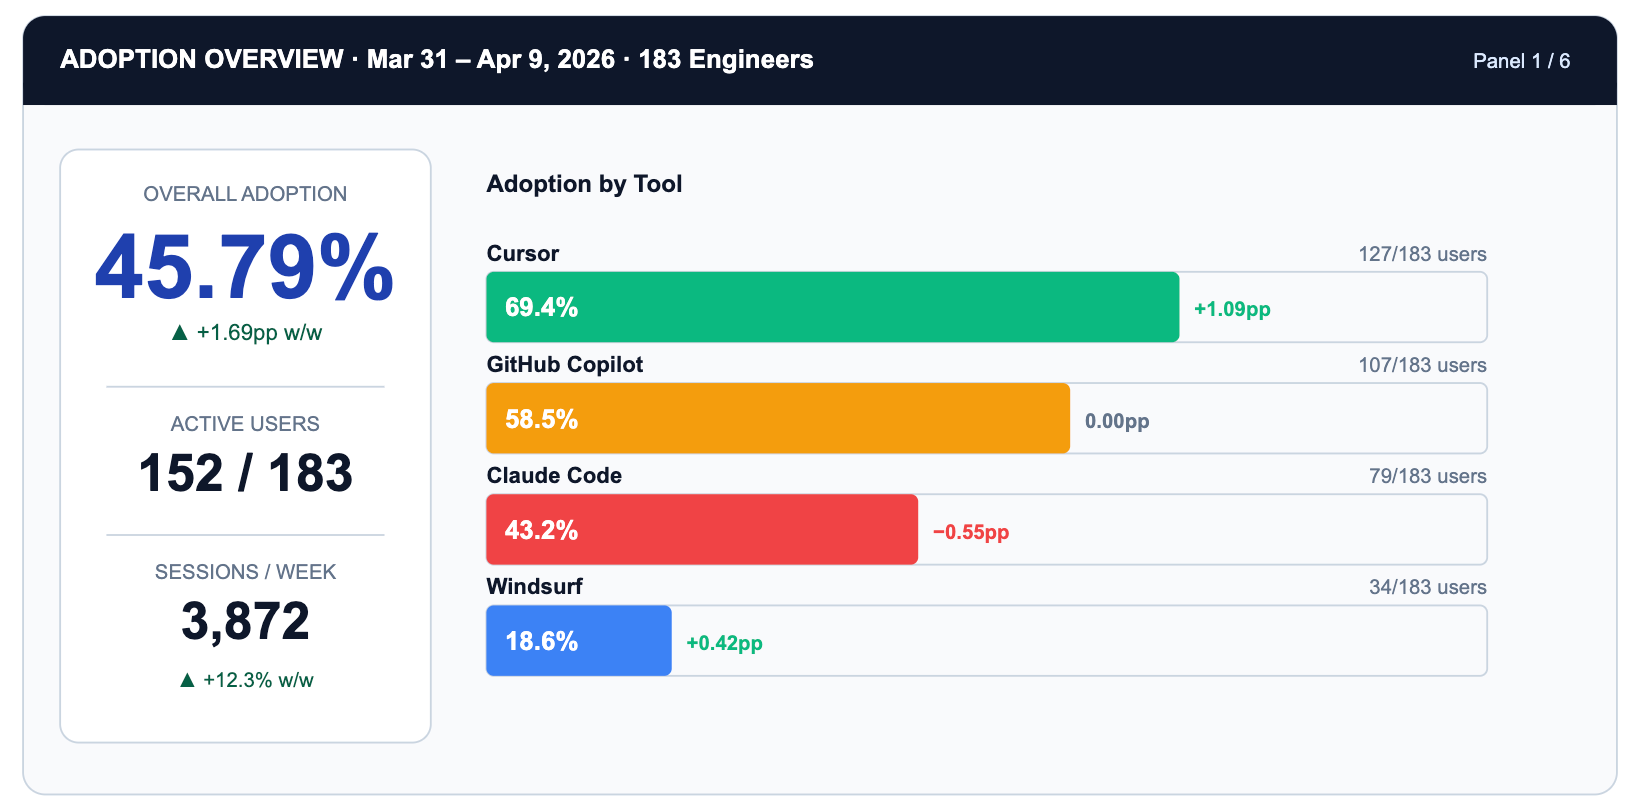
Let op wat het paneel niet laat zien: individuele ranglijsten. De eenheid is leverancier x team x dag. De actie die het oplevert is niet 'feliciteer Alex', maar 'Claude Code-adoptie ligt 26 procentpunten achter op Cursor. Is dit een probleem met toolfrictie of met de geschiktheid voor de use-case?' Dat is een vraag die een sprint waard is.
TrueFoundry maakt dit mogelijk via de X-TFY-METADATA-header die aan elk gateway-verzoek is gekoppeld. De header bevat een stringified JSON-object waarvan de velden onder meer gebruikersidentiteit, teamlidmaatschap, toolnaam, projecttag en sessie-ID omvatten.
→ TrueFoundry Request and Response Headers Reference
→ Analytics Dashboard Overview
Adoptie vertelt u wie AI gebruikt. Burn rate vertelt u waar het geld naartoe gaat. Dit zijn verschillende vragen en ze horen thuis in verschillende panelen.
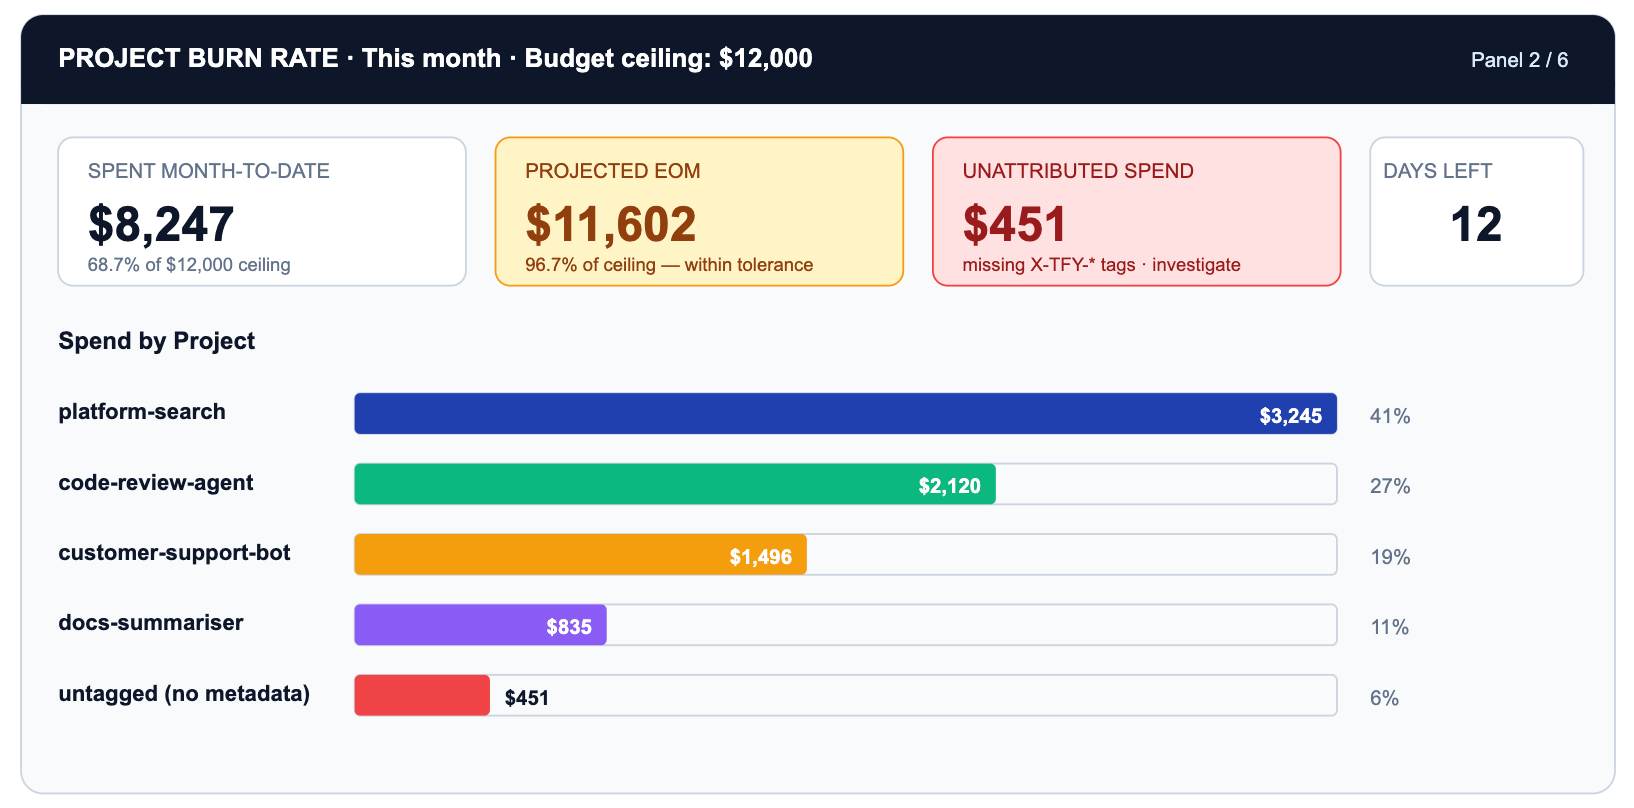
De cruciale regel is UNTAGGED. $451 aan uitgaven heeft geen project-metadata. Dat is een gat in de gateway-configuratie, geen uitgavenprobleem. Elk verzoek zonder tag kan niet worden toegeschreven aan een bedrijfsresultaat, worden beheerd door een budgetbeleid, of verschijnen in een nuttige burn rate-grafiek.
Met TrueFoundry Budget Limiting kunt u harde plafonds instellen per project, per team, per modelfamilie of per tijdsvenster. Wanneer platform-search 100% van het maandelijkse plafond van $ 4.000 bereikt, beginnen verzoeken 429-fouten te retourneren of vallen ze terug op een goedkoper model op basis van uw geconfigureerde beleid.
→ Budget Limiting — vensters, plafonds en waarschuwingen
→ Rate Limiting — per gebruiker, per model, per metadata-tag
De duurste nieuwe faalmodus in een agentische wereld is de loop: een agent die oneindig opnieuw probeert omdat er nooit aan de exit-conditie wordt voldaan, of omdat de tool die hij aanroept fouten blijft retourneren. Eén enkele agent in een loop kan in een uur evenveel tokens verbruiken als een team van engineers in een dag.
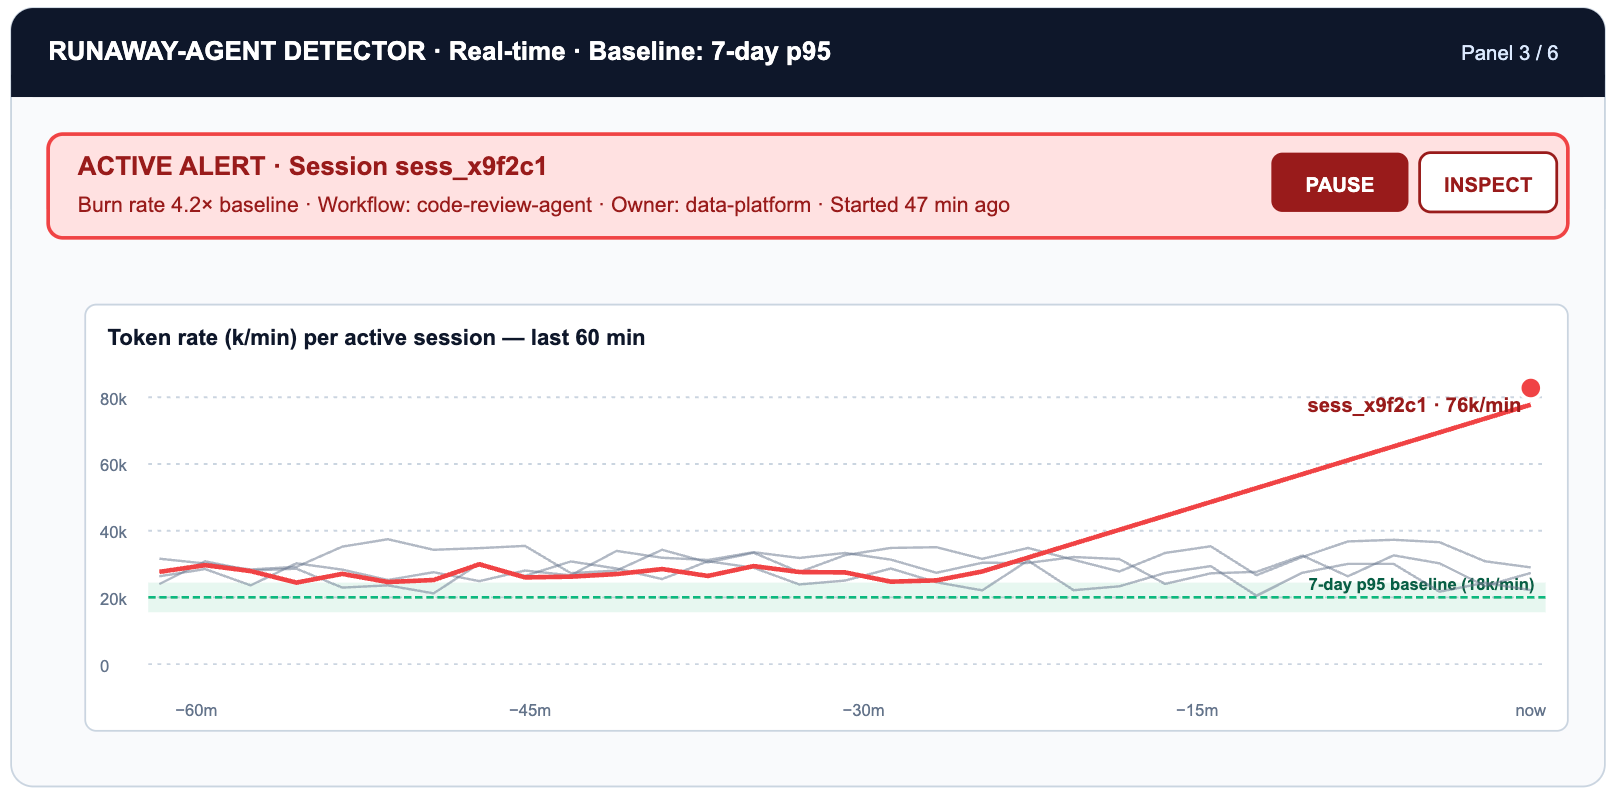
Dit paneel vereist het OTEL-signaal dat TrueFoundry exporteert: token-snelheid per sessie over de tijd, niet alleen aantallen per verzoek, wat AIOps-praktijken ondersteunt zoals anomaliedetectie en proactieve probleemidentificatie. De p95-baseline wordt berekend op basis van de afgelopen zeven dagen aan sessies voor elke workflowtag. Alles wat 3x die baseline overschrijdt, activeert een pager-gebeurtenis en optioneel het beëindigen van de sessie via het rate-limit-handhavingspad.
→ OpenTelemetry-gegevens exporteren — traces, spans, token-tellers
→ Rate Limiting — plafonds per sessie afdwingen
Niet elke taak die een frontier-model bereikt, verdient een frontier-model. Het routeren van een classify-this-email-taak naar Claude Opus 4.7 tegen $5/$25 per miljoen tokens wanneer Haiku 4.5 tegen $1/$5 dit zou afhandelen binnen 2pp van dezelfde nauwkeurigheid, is 5x betalen voor functionaliteit die u niet gebruikt. Die keuze is onzichtbaar totdat deze wordt samengevoegd over duizenden dagelijkse verzoeken — en dat is precies wat dit paneel doet.
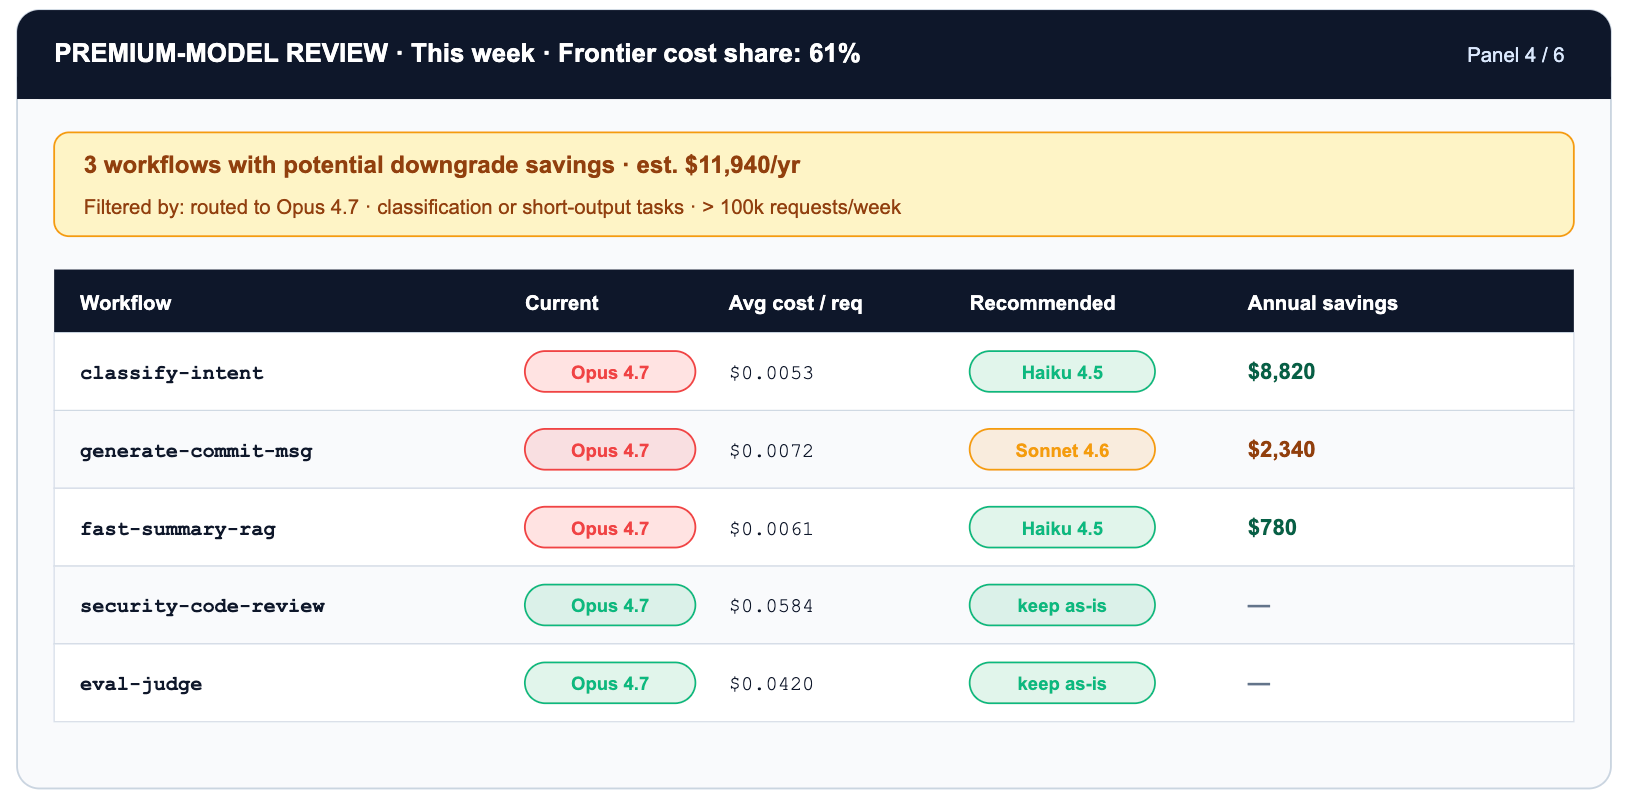
Twee gelaagde optimalisaties stapelen zich op in dit paneel. Het omrouteren van classify-intent van Opus 4.7 naar Haiku 4.5 levert een 5x reductie in tokenkosten op. Bovendien verlaagt het inschakelen van prompt caching op de systeem-prompt de gecachte input-tokens met nog eens 90% — een gestapelde korting die een workflow van $ 3.200/mnd verandert in ongeveer $ 50/mnd zonder verandering in nauwkeurigheid.
Er is ook een verborgen versie van dit paneel: tokenizer-drift. Toen Anthropic Opus 4.7 uitbracht, genereerde de nieuwe tokenizer tot 35% meer tokens voor dezelfde invoer vergeleken met Opus 4.6. De officiële tarieven veranderden niet. De effectieve kosten per verzoek wel. De enige manier om dit te zien is via token-telemetrie per modelversie op de gateway. De enige manier om te reageren is door het virtuele model-alias terug te draaien — wat op TrueFoundry een YAML-diff is, geen sprint.
TrueFoundry's virtuele model-routing maakt het handelen naar aanleiding van dit paneel moeiteloos. U configureert een logische modelnaam zoals 'code-review-fast' die routeert naar verschillende fysieke eindpunten op basis van workflowtag, tijdstip van de dag of belasting — zonder de applicatiecode aan te raken. Het A/B-testen van een goedkoper model is een YAML-diff, geen sprint.
→ Routing Overview — gewicht, prioriteit, fallback, prompt caching
De taak van het veiligheidspaneel is triage. De meeste guardrail-gebeurtenissen zijn ruis: testverkeer, experimenten van ontwikkelaars, verwachte randgevallen in productie. Een klein aantal vormt een echt risico: PII die lekt via een prompt, een geheim dat verschijnt in door agenten gegenereerde code, of een prompt injection-poging in door gebruikers aangeleverde invoer.
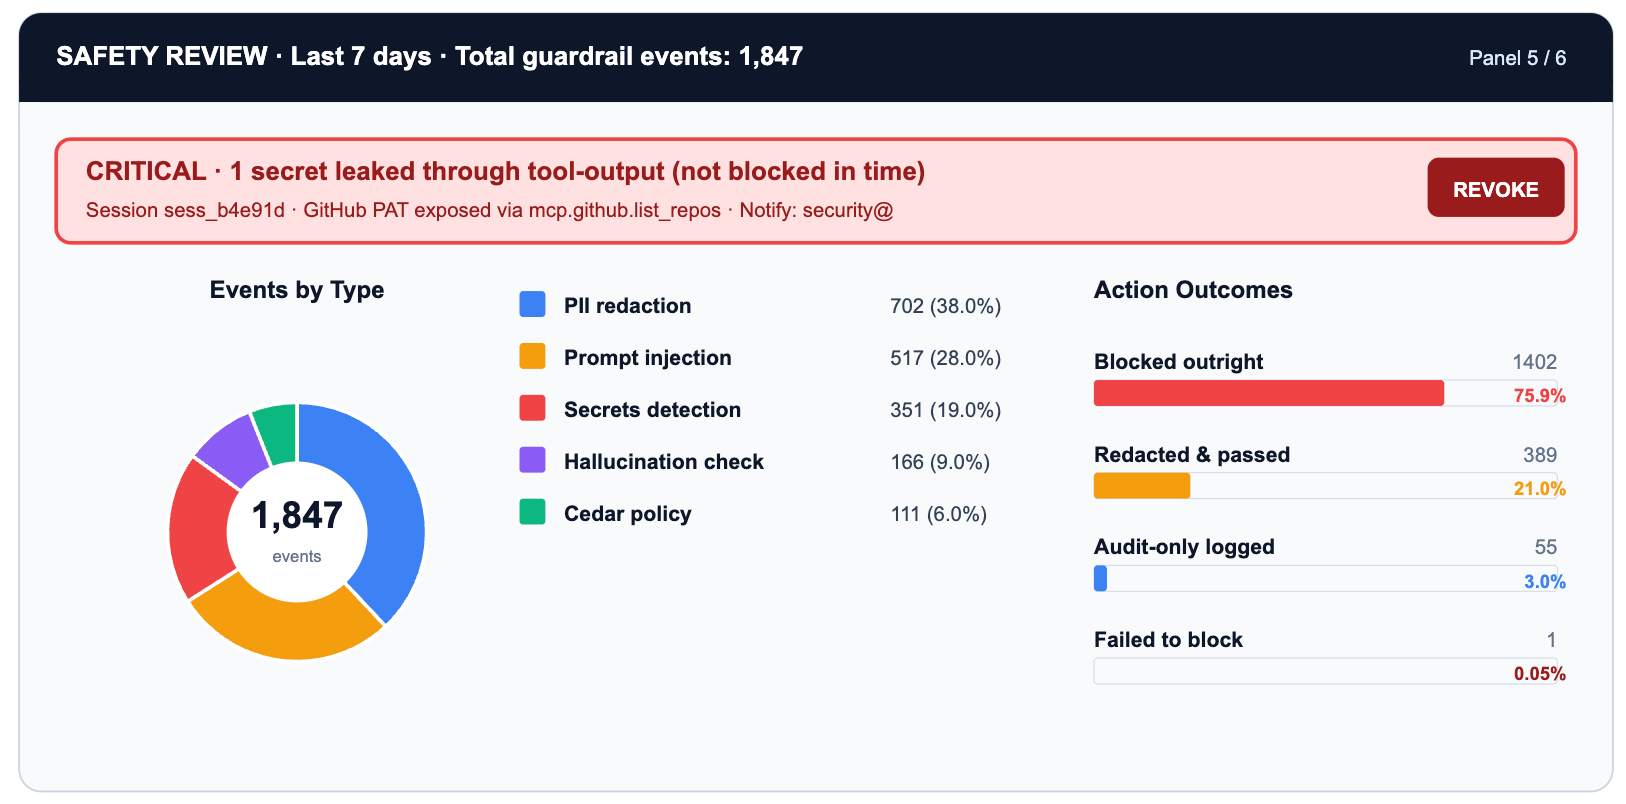
Het ene gelekte geheim op de regel secrets-scan is de cel die onmiddellijke actie vereist. Al het andere is informatief: nuttig voor het afstemmen van de gevoeligheid van guardrails, het scheiden van hoofdzaken van bijzaken en het aantonen van compliance aan auditors.
TrueFoundry's guardrail-model met vier hooks (request-input, request-output, tool-input, tool-output) betekent dat elke gebeurtenisregel overeenkomt met een specifiek interceptiepunt in de levenscyclus van het verzoek. PII-detectie bij request-input onderschept gebruikersgegevens voordat deze het model bereiken. Secrets detection bij tool-output onderschept authenticatiegegevens voordat ze downstream systemen bereiken.
→ Guardrails Overview — vier hooks, ontleding van het dreigingsoppervlak
→ PII/PHI Detection — anonimiseringsmodi en hook-plaatsing
→ Secrets Detection — valideren vs mutatiewijze
Dit is het moeilijkste paneel om te bouwen en het belangrijkste om te hebben. Alle vijf voorafgaande panelen beschrijven AI-gebruik. Dit paneel beantwoordt de vraag of dat gebruik iets heeft opgeleverd.
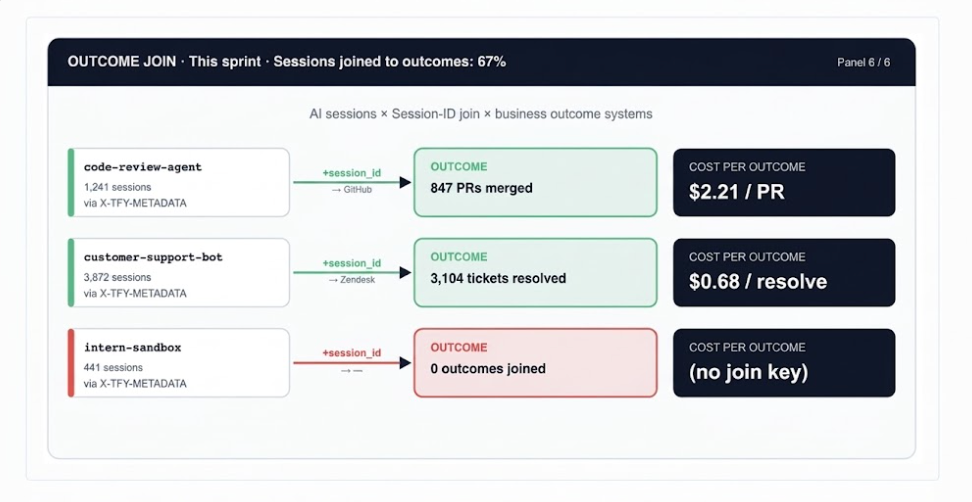
De koppelingssleutel is het veld session_id in X-TFY-METADATA, dat door TrueFoundry wordt doorgegeven bij elk verzoek in een agent-sessie met meerdere interacties. Wanneer hetzelfde sessie-ID verschijnt in uw GitHub-webhook payload of Zendesk-metadata, kunt u de cirkel rondmaken: deze sessie kostte $ 2,21 en leverde een gemergde code-review PR op.
→ Analytics — kosten- en gebruiksweergaven op sessieniveau
De zes panelen putten uit drie verschillende metrieklagen. De meest voorkomende fout bij dashboards is het mengen van deze lagen: een managementweergave hoort geen retry-aantallen te tonen, en een piketdienstweergave hoort geen eval-slagingspercentages te tonen.
Zodra de drie lagen zijn ingericht, is de verleiding groot om ze samen te voegen tot een score per engineer en een ranglijst te publiceren. Weersta die verleiding. De onderstaande functie is expliciet diagnostisch: een hulpmiddel om workflowpatronen te vinden die investering, herontwerp of nieuwe guardrails verdienen. Aggregeer op workflow_tag, niet op user_id.
Dashboards sturen geen organisaties aan. Rituelen wel. De minimale levensvatbare operationele cadans voor beheerd AI-gebruik:
Elke waarschuwing moet gekoppeld zijn aan een runbook-stap, niet alleen aan een pager-gebeurtenis. De onderstaande YAML definieert de minimale set waarschuwingsregels voor de control room, draaiend op de OTEL-export van TrueFoundry:
Controleer het veld workflow_tag in de X-TFY-METADATA van het verzoek voor het verantwoordelijke team
Controleer het veld workflow_tag in de X-TFY-METADATA van het verzoek voor het verantwoordelijke team
→ tfy apply — GitOps-style alert en policy deployment
→ Export OpenTelemetry Data — OTEL metric endpoints
Voordat u uw AI control room operationeel verklaart, controleert u deze acht voorwaarden. Elk punt komt overeen met een specifieke TrueFoundry-functionaliteit:
De Tokenmaxxing Trilogy heeft een argument opgebouwd uit drie lagen. Elke laag is noodzakelijk; geen enkele laag is op zichzelf voldoende.
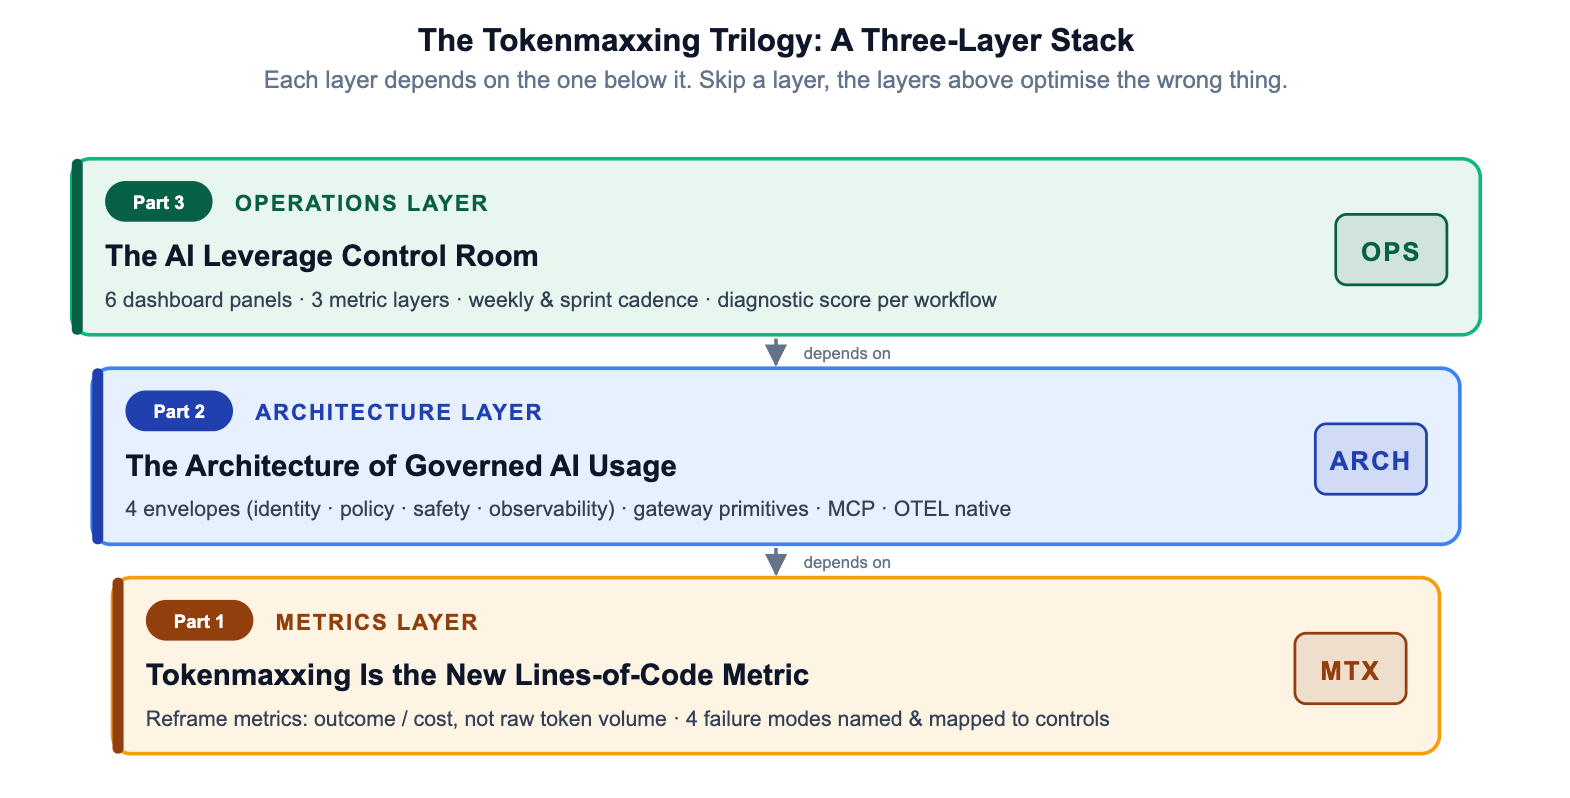
Organisaties die stoppen bij Laag 1 hebben wel een verhaal, maar geen handhaving. Organisaties die stoppen bij Laag 2 hebben wel handhaving, maar geen feedbackloop. De control room sluit de cirkel — waardoor beheerd AI-gebruik geen compliance-houding wordt, maar een operationele discipline die zich na verloop van tijd uitbetaalt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















