November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
"Wat is de beste LLM voor programmeren?" is de verkeerde vraag, omdat er geen vast antwoord op bestaat. Het model dat de strakste functie van 40 regels schrijft, is niet het model dat u tokens wilt laten verbruiken bij een refactoring van 30 bestanden, en het model dat een ingewikkelde concurrency-bug oplost, is overkill voor de autocomplete van een getter. Benchmarks verschuiven om de paar weken. Een team dat in januari één model hardcodeert in zijn tooling, herziet die beslissing in april alweer.
De betere vraag is: naar welk model routeer ik voor dít type codeertaak, binnen dít budget — en hoe houd ik de uitgaven en beveiliging onder controle als honderd ontwikkelaars die vraag elk anders beantwoorden? Dat is de vraag die dit artikel beantwoordt. We lopen de uitdagers langs op basis van waar ze echt goed in zijn, bieden een beslissingskader van taak tot model dat langer meegaat dan elke afzonderlijke benchmark, en behandelen vervolgens het onderdeel dat de meeste teams overslaan: de routing- en governance-laag die van de modelkeuze een configuratiewaarde maakt in plaats van een herschrijving van de code.
Vooraf een opmerking over de nauwkeurigheid. De onderstaande prijzen van Anthropic's Claude zijn geverifieerd per november 2026. De benchmarkcijfers van concurrenten zijn gerapporteerde of samengestelde cijfers; we vermelden de bron en datum, en u dient deze te controleren bij de betreffende leverancier voordat u er geld aan uitgeeft.
Wilt u kostentracking per ontwikkelaar en guardrails voor elk coderingsmodel? Boek een demo.
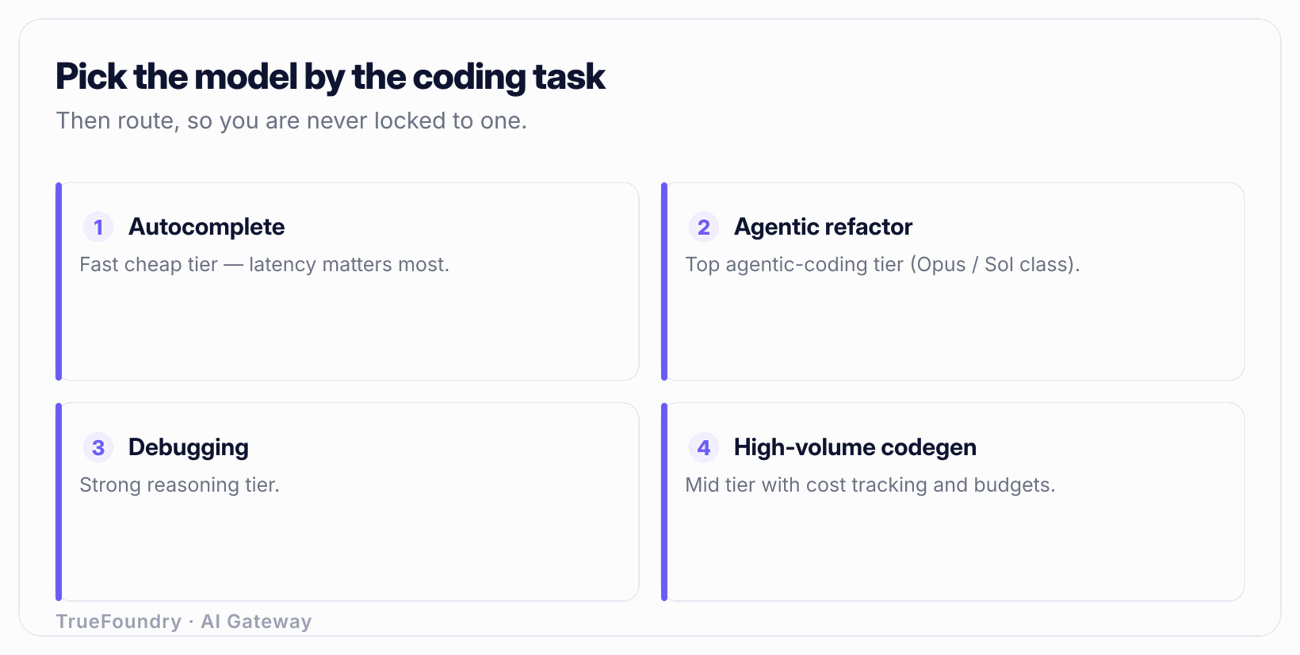
Voordat u een model kunt kiezen, moet u de taak benoemen. De meeste vergelijkingen van de "beste coderings-LLM" mislukken omdat ze een gemiddelde nemen van taken met tegenovergestelde vereisten. Verdeel programmeren in vier categorieën en de keuze wordt een stuk duidelijker.
Autocomplete / inline aanvulling. Het model voorspelt de volgende paar regels terwijl u typt. Latentie is alles — alles boven ongeveer 300-500 ms verstoort de workflow. De context is klein (het huidige bestand plus een paar aangrenzende bestanden). U voert duizenden van deze calls per ontwikkelaar per dag uit, dus de kostprijs per eenheid overheerst. U wilt een snel, goedkoop model, niet het slimste.
Agentische refactoring van meerdere bestanden. Het model plant, leest veel bestanden, bewerkt er meerdere, voert tests uit en itereert — een loop die minutenlang kan duren en honderdduizenden tokens in één enkele taak kan verbruiken. Dit is waar redeneerdiepte, coherentie bij een lange context en het vermogen om over vele stappen op koers te blijven hun vruchten afwerpen. Het is ook waar een zwak model het duurst is, omdat het tokens verspilt door aan te modderen en u vervolgens een kapotte diff oplevert.
Diepgaande debugging. Één moeilijk probleem: een race condition, een geheugenlek, een heisenbug die alleen onder belasting optreedt. Het volume is laag, maar de waarde van een juiste oplossing is hoog. U wilt maximale redeneerkwaliteit en bent bereid daar per incident voor te betalen.
Codegen in hoge volumes. Scaffolding, boilerplate, test-stubs, migratiescripts, docstrings — grote hoeveelheden eenvoudige code. De kwaliteitseisen zijn gematigd; doorvoer en kosten per generatie overheersen. Een model uit het middensegment wint het meestal op basis van de totale eigendomskosten (TCO).
Deze vier vormen komen zelden overeen met één model. Dezelfde ontwikkelaar wil binnen hetzelfde uur een snel en goedkoop model voor aanvullingen, een diepgaand redeneermodel voor de bug waar hij vastzit, en een krachtig agentisch model voor de refactoring die hij op de achtergrond is gestart. Dat is de structurele reden waarom standaardisatie op één enkel model mislukt.
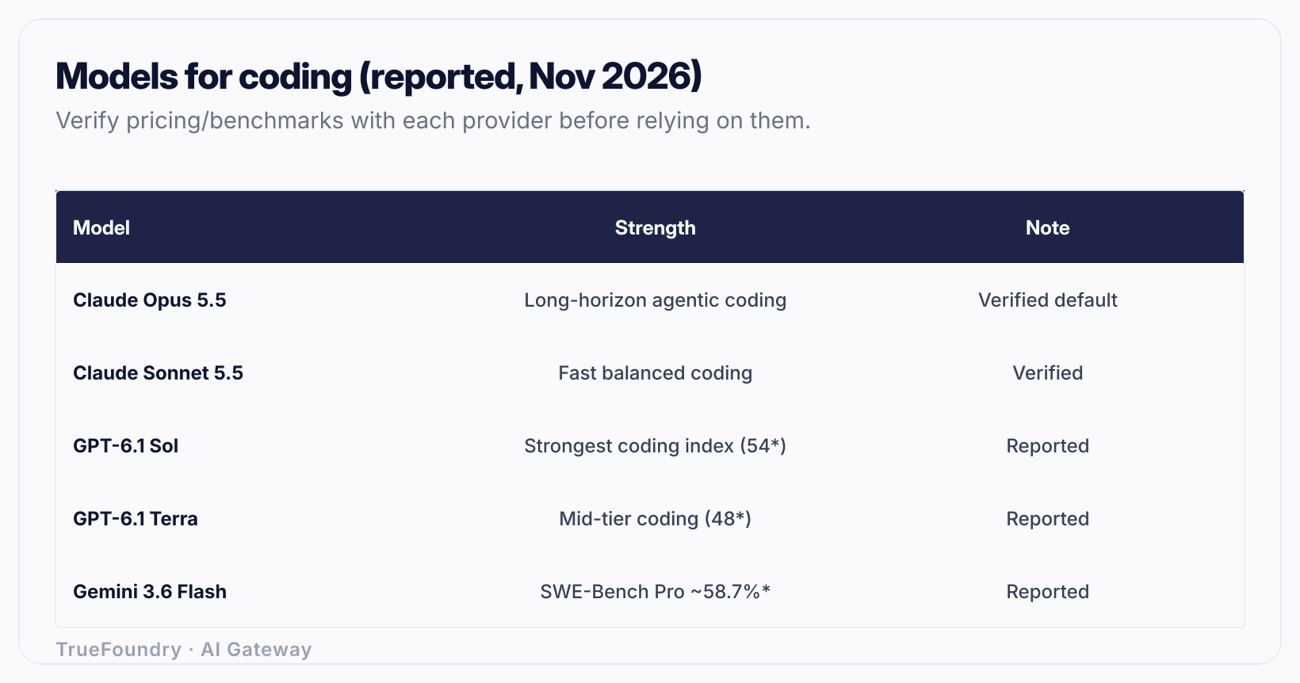
Hier is de eerlijke stand van zaken per november 2026. De prijzen voor Claude zijn geverifieerd; de rest is gerapporteerd en moet opnieuw worden gecontroleerd.
De 5.5-generatie van Claude is duidelijk onderverdeeld in de bovenstaande taakvormen:
Het praktische patroon is een gelaagde strategie binnen Claude alleen — Haiku voor completions en bulk, Sonnet voor het meeste agentwerk, Opus voor de zware refactorings en de ingewikkelde debuggingsessies.
Per november 2026 staat GPT-6.1 Sol volgens rapporten bovenaan qua algemene codeervaardigheid, met een verzamelde "Coding Index" van rond de 54, en GPT-6.1 Terra een stap erachter op ongeveer 48. Sol is gepositioneerd als een geavanceerd topmodel voor codering; Terra als een snellere, goedkopere klasse. Beschouw de indexcijfers als indicatief — ze zijn afkomstig van aggregatie door derden, niet van één gestandaardiseerde testomgeving, en de eigen prijzen en categorienamen van OpenAI moeten op hun site worden bevestigd voordat u budget toezegt.
Gemini 3.6 Flash scoort naar verluidt rond de 58,7% op SWE-Bench Pro, een benchmark die echte fixes in de stijl van pull-requests vergelijkt met daadwerkelijke repositories. Als dat cijfer klopt, is Flash concurrerend op het gebied van praktische software-engineeringtaken binnen een categorie die is gepositioneerd voor snelheid en kosten. Nogmaals: gerapporteerd per november 2026, verifieer dit bij Google.
SWE-Bench en coderingsindices meten het vermogen van een model om een correcte patch te produceren op gecureerde problemen. Ze meten niet hoe een model zich gedraagt binnen uw agent, op uw codebase, met uw tools en contextlimieten. Een model dat twee punten hoger scoort op een openbare benchmark kan in de praktijk zwaar verliezen als het trager is, een kleiner effectief contextvenster heeft of slechter omgaat met uw specifieke taal en framework. Gebruik benchmarks om een shortlist te maken en voer vervolgens uw eigen evaluatie uit op taken die lijken op uw daadwerkelijke werk.
Hier is het gerapporteerde landschap in één tabel. Lees de onderstaande voorbehoudregel voordat u een van deze cijfers citeert.
Voorbehoud: Claude-prijzen zijn geverifieerd per november 2026. Alle cijfers van concurrenten zijn gerapporteerde of verzamelde cijfers van derden per november 2026 en zijn niet rechtstreeks vergelijkbaar over verschillende testomgevingen — controleer specificaties, beschikbaarheid en prijzen opnieuw bij elke leverancier voordat u erop vertrouwt.
In plaats van "het beste model" te kiezen, kiest u een standaard per taakvorm en een escalatiepad. Dit is het gedeelte dat geldig blijft wanneer het klassement van volgende maand weer verandert.
De logica: start elke taak op het goedkoopste niveau dat betrouwbaar slaagt, en escaleer alleen bij een concreet signaal — tests mislukken, de diff is te groot, de agent blijft hangen in een loop. Een refactoring die een model uit het middensegment in tien dure iteraties zou verprutsen, is goedkoper op een topmodel dat het in twee keer goed doet. Een aanvulling die een topmodel perfect zou uitvoeren, is nog steeds de verkeerde plek om geld aan uit te geven, omdat u die call tienduizend keer per dag maakt.
Let op wat dit kader operationeel vereist: de mogelijkheid om verschillende verzoeken naar verschillende modellen te sturen op basis van taaktype en signalen, zonder de applicatie te herschrijven. Dat is routing, en dat is waar een gateway om de hoek komt kijken. Zie kosten- en kwaliteitsbewuste modelselectie voor de wijze waarop deze logica wordt gecodeerd, en wat een LLM-router is voor de werking ervan.
Bekijk hoe TrueFoundry coderingsverkeer meeroutet en de uitgaven per ontwikkelaar maximeert. Boek een demo.
Stel u een organisatie voor met 200 ontwikkelaars. Sommigen werken in Cursor, sommigen in Claude Code, een paar zweren bij Copilot in VS Code en het datateam roept modellen rechtstreeks aan vanuit notebooks. Elk hulpprogramma gebruikt standaard andere modellen en elke ontwikkelaar heeft zijn eigen voorkeuren. Zelfs als u vandaag één model verplicht zou stellen, verschijnt er over zes weken een beter model en omzeilen uw beste engineers het mandaat.
Dit is geen gebrek aan discipline. Het is de juiste eindtoestand. Verschillende taken vragen om verschillende modellen, verschillende tools maken verschillende modellen toegankelijk en de stand van de techniek verandert maandelijks. Het bestrijden van die fragmentatie is een verloren strijd. De winnende zet is om niet langer te proberen het model te standaardiseren, maar in plaats daarvan het controlepunt vóór de modellen te standaardiseren.
Concreet betekent dit dat elke coding agent in de organisatie — Claude Code, Cursor, Copilot, zelfgebouwde scripts — naar één OpenAI-compatibel eindpunt wijst in plaats van rechtstreeks naar de API van elke leverancier. Achter dat eindpunt bepaalt u de routing, ziet u elk verzoek en handhaaft u het beleid. Het model wordt een configuratiewaarde. Het vervangen van Sonnet door een nieuwer model, of het toevoegen van GPT-6.1 Sol als escalatie voor debugging, is een configuratiewijziging in plaats van een codemigratie voor de hele organisatie.
Een AI gateway bevindt zich tussen uw coding agents en de modelproviders en biedt een universele OpenAI-compatibele API. Specifiek voor programmeren zijn vier functionaliteiten van belang.
Kostentoerekening per ontwikkelaar, team en model. Coding agents verbruiken tokens op manieren die de financiële afdeling kunnen verrassen. Een agentische refactoring kan meer dan 300.000 tokens in één taak verbruiken. Zonder toerekening krijgt u één ongedifferentieerde factuur van de provider en heeft u geen idee of de uitgaven afkomstig zijn van de refactorings van het platformteam of van de oneindige loop van één ontwikkelaar. De gateway voorziet elk verzoek van een tag met de gebruiker, het team en het model, zodat u tot op het niveau van het verzoek kunt beantwoorden "wie wat heeft uitgegeven aan welk model". Dit vormt de basis van kostentoerekening en teambudgetten en van FinOps voor AI in het algemeen.
Budgetten en rate limits per ontwikkelaar of team. Stel een maandelijks budget in dollars in per team en een limiet voor het aantal verzoeken per ontwikkelaar. Wanneer een limiet wordt overschreden, retourneert de gateway HTTP 429 in plaats van stilzwijgend de rekening te laten oplopen. Dit voorkomt dat een verkeerd geconfigureerde agent in een loop verandert in een onverwachte kostenpost van vijf cijfers. De werking hiervan wordt behandeld in token rate limiting en budgetten.
Guardrails tegen het lekken van geheimen. Coding agents lezen uw broncode. Broncode bevat gehardcodeerde referenties, interne hostnamen, klantgegevens in fixtures en PII in testbestanden. Elk van die elementen kan in een prompt naar een modelprovider worden gestuurd. Een gateway kan uitgaande verzoeken scannen op geheimen en PII en deze blokkeren of anonimiseren voordat ze uw netwerk verlaten. Voor een gereguleerde organisatie is dit vaak het verschil tussen "goedgekeurd" en "geblokkeerd." Zie AI guardrails voor de verschillende detectietypen.
Audit en observability. Één overzicht van elk verzoek — wie, welk model, hoeveel tokens, latentie, kosten, geslaagd/mislukt op guardrails. Wanneer security vraagt "is er het afgelopen kwartaal code gelekt naar een extern model", hebt u een antwoord klaar in plaats van een vragende blik. Koppel het gateway-logboek aan uw LLM observability-tooling voor het opvolgen van de latentie en kwaliteit in de loop van de tijd.
De AI gateway van TrueFoundry biedt precies dit controle-element — een universele OpenAI-compatibele API met routing op basis van latentie/gewicht/prioriteit, automatische fallback en in-request retries, exacte en semantische caching, budgetten en rate limits per gebruiker/team/model, volledige observability per verzoek en guardrails voor PII/geheimen/prompt-injectie. Het kan worden ingezet als SaaS, in uw VPC, on-premise of air-gapped, zodat het datavlak dat uw broncode transporteert binnen uw netwerk blijft.
Maak het concreet. Drie ontwikkelaars, één week, verschillend werk:
Drie ontwikkelaars, drie taakvormen, drie categorieën en een gezamenlijke wekelijkse uitgave van bijna $ 40 — waarbij de diepgaande refactoring van Dev C ongeveer 14 keer zoveel kost als de completions van Dev A. Stel u nu 200 ontwikkelaars voor zonder kostentoerekening: u ziet één globale rekening en kunt het nuttige gebruik niet onderscheiden van verspilling. Met de gateway ziet u dat de refactoring van Dev C duur en de moeite waard was, de completions van Dev A efficiënt zijn, en als de agent van een vierde ontwikkelaar om 2 uur 's nachts in een loop raakt, stopt het budgetplafond dit op HTTP 429 voordat het een probleem wordt.
De bovenstaande cijfers maken gebruik van geverifieerde Claude-prijzen en afgeronde getallen ter illustratie; uw werkelijke aantallen tokens zullen afwijken. Het gaat om de structuur: de taakvorm bepaalt de categorie, de categorie bepaalt de kosten en toerekening is wat een schrikbarend totaalbedrag verandert in een beheersbare post.
De leaderboard achtervolgen. Teams kiezen telkens een nieuw "één en alomvattend codeermodel" wanneer een benchmark wordt bijgewerkt, en passen hun tooling elke keer opnieuw aan. Het verschil in de benchmark is meestal kleiner dan de kosten van de verandering. Kies standaarden per taakvorm, routeer het verkeer en laat de gateway modelwijzigingen opvangen als configuratie.
Alles naar het hoogste model routen. Het gebruik van Opus 5.5 of GPT-6.1 Sol voor autocomplete voelt veilig, maar is heimelijk ruïneus — u betaalt de hoofdprijs voor de calls met het hoogste volume en de laagste waarde. Stem de categorie af op de taak. Het goedkoopste model dat betrouwbaar presteert, is het juiste model.
Geen kostentoerekening totdat de rekening binnenkomt. Veel teams ontdekken de uitgaven aan coding agents pas wanneer de financiële afdeling aan de bel trekt. Tegen die tijd kunnen ze niet meer achterhalen welk team of welk gedrag de kosten heeft veroorzaakt. Toerekening moet geregeld zijn voordat u het aantal licenties uitbreidt, niet erna.
Geen rekening houden met het lekken van geheimen en PII uit code. Het grootste risico van coding agents is niet verkeerde code, maar het lekken van de juiste code. Bronbestanden bevatten referenties en klantgegevens, en agents sturen deze naar externe modellen. Als u geen uitgaande guardrail hebt, lekt u geheimen uit en komt u er pas achter bij een incidentevaluatie.
Modelkeuze behandelen als een applicatie-aangelegenheid. Het hardcoderen van modelnamen en API-sleutels in elke tool en service betekent dat elke modelwijziging een nieuwe deployment vereist. Plaats de keuze achter een gateway-eindpunt en modelselectie wordt een beleidsbeslissing, die één keer wordt genomen en overal wordt toegepast.
De "beste LLM voor programmeren" is een bewegend doel, en het proberen bij te houden is een gebed zonder einde. De duurzame strategie is om te stoppen met het kiezen van één model en te beginnen met het beheren van een portfolio: een goedkope, snelle klasse voor completions en bulk, een gebalanceerde klasse voor dagelijks agentwerk en een topklasse voor zware refactorings en diepgaande debugging — met een duidelijk escalatiesignaal daartussen. De verdeling Opus/Sonnet/Haiku van Claude sluit vandaag de dag vrijwel één-op-één aan op dat kader, en de gerapporteerde cijfers van GPT-6.1 en Gemini bieden opties voor escalatie en vergelijking die u als configuratie kunt invoegen.
Wat dat portfolio beheersbaar maakt, is de laag die er voor staat. Routeer elke coding agent via één AI gateway en de modelkeuze wordt een configuratiewaarde, kosten worden toewijsbaar per ontwikkelaar en team, budgetten stoppen buitensporige uitgaven met een HTTP 429-melding en guardrails voorkomen dat de geheimen uit uw broncode lekken naar een provider. Dat is hoe u voorop blijft lopen zonder de controle over de rekening of de impact uit het oog te verliezen.
Beheer het modelgebruik van uw coding agents vanuit één gateway. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Er is geen enkel beste model - het hangt af van de taak. Voor agentic coding op lange termijn is Claude Opus 5.5 de geverifieerde sterke keuze; Sonnet 5.5 verzorgt het meeste alledaagse werk en Haiku 5.5 is het beste voor hoogvolume autocomplete. Gerapporteerde cijfers plaatsen GPT-6.1 Sol bovenaan de algemene codeerindices en Gemini 3.6 Flash sterk op SWE-Bench Pro, per november 2026 - verifieer dit bij elke leverancier.
Ze blinken eind 2026 op verschillende manieren uit. Claude Opus 5.5 is de geverifieerde keuze voor agentic coding met meerdere bestanden over een lange termijn, terwijl GPT-6.1 Sol naar verluidt bovenaan de algemene codeerindices staat. Het eerlijke antwoord voor een onderneming is om naar beide te routeren en per taak te kiezen, in plaats van op één model te standaardiseren.
Dit varieert met de taakmix. Een ontwikkelaar die vooral autocomplete gebruikt op een goedkoop niveau kost mogelijk enkele dollars per week; iemand die zware refactors op Opus-niveau uitvoert, kan $20+ per week kosten. Zonder kostentoewijzing per ontwikkelaar kunt u efficiente uitgaven niet onderscheiden van uit de hand gelopen uitgaven.
Ja, en dat zou u vrijwel zeker moeten doen. Verschillende tools en taken vragen om verschillende modellen. Route ze allemaal via één enkele AI Gateway, zodat u één endpoint, consistente budgetten en guardrails, en uniforme kostentoewijzing krijgt over elk model en elke agent heen.
Plaats een gateway met guardrails tussen de agents en de providers. Deze scant uitgaande verzoeken op geheimen en persoonsgegevens en blokkeert of redigeert ze voordat ze uw netwerk verlaten. Door de gateway in uw VPC of on-prem te implementeren, blijft het dataverkeer met uw broncode binnen uw eigen omgeving.



Het laatste nieuws, artikelen en bronnen in je inbox