



November 16, 2026
|
5 min read


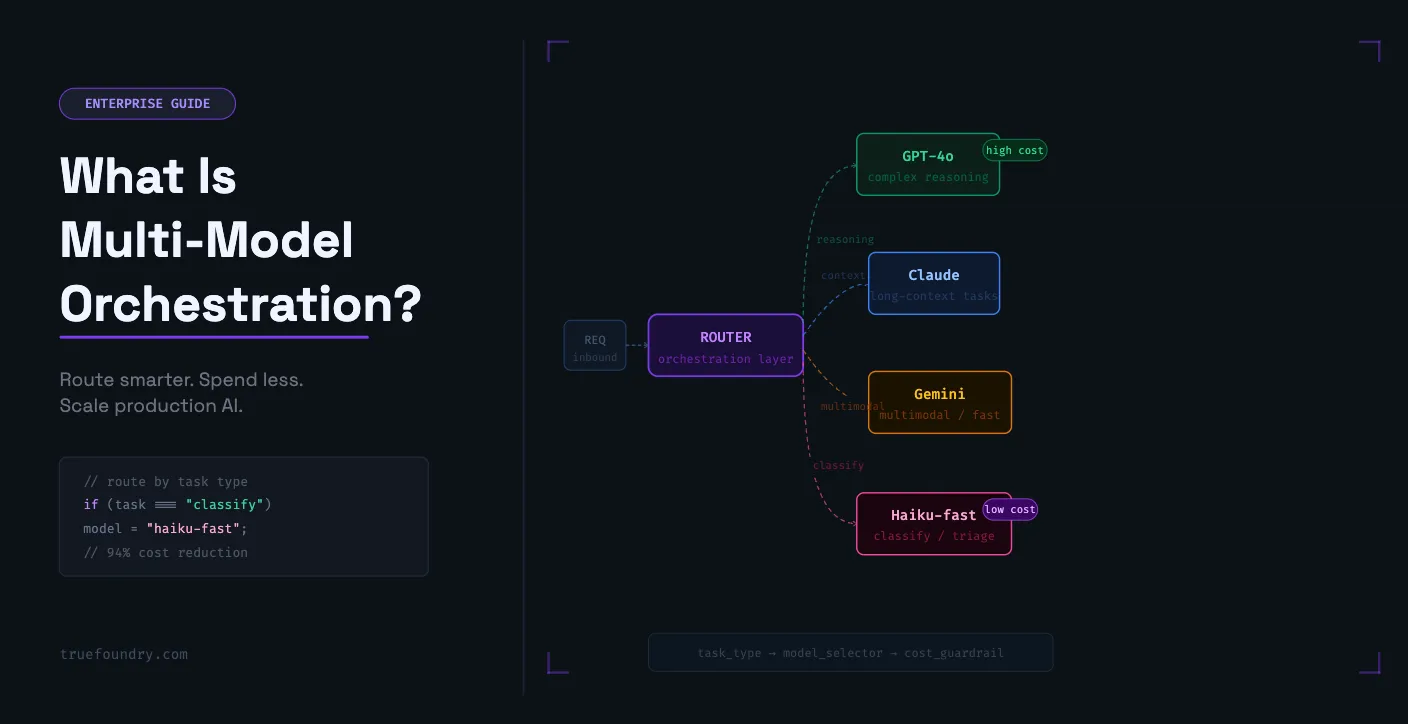
Blazingly fast way to build, track and deploy your models!
あらゆるタスクで勝利を収める単一のモデルは存在しません。GPT-4oは複雑な推論を得意とする一方、小型言語モデルは分類、ルーティング、データ抽出といった処理をより低コストで処理できることがよくあります。すべてのリクエストを最も高価なモデルにルーティングすることは、無駄な支出を生み出し、本番環境のAIチーム全体におけるリソース割り当てを最適でない状態にしてしまいます。
マルチモデルオーケストレーションは、この違いを運用レベルで活用するためのアプローチです。すべてのワークロードを単一のプロバイダーに固定するのではなく、タスクの種類、コスト、レイテンシ、品質要件に基づいてリクエストを異なるモデルへとルーティングします。本番環境を運用するチームにとって、これはもはや単なる局所的な最適化ではありません。エンタープライズAIにおけるオペレーティング層となりつつあります。
現在、企業はOpenAI、Anthropic、Google、Azure、AWS Bedrock、さらにはセルフホストモデルにまたがってAIアプリケーションを実行しています。マルチLLMオーケストレーションは、あれば便利なルーティングパターンから、不可欠なコアインフラストラクチャ要件へと変化しました。本ガイドでは、その動作の仕組み、単体では解決できない課題、そしてTrueFoundryがエンタープライズゲートウェイ層を通じてどのようにガバナンスを追加するかを解説します。
マルチモデルオーケストレーションとは、アプリケーション、単一のAIエージェント、あるいはワークフローを複数のAIモデルに接続する運用手法です。LLMオーケストレーション層は、個々のリクエストを、特定のタスク、コスト目標、レイテンシ要件、あるいは品質閾値に最も適したモデルへとルーティングします。
この用語には、静的ルーティングと動的ルーティングの両方が含まれます。静的ルーティングでは、あらかじめ定義されたモデルに異なるタスクを割り当てます。例えば、要約はコスト効率の高いモデルへ、コード補完はコーディング用モデルへ、深い調査・リサーチはより強力な推論モデルへと送信します。
動的ルーティングは、実行時にユーザーからの入力を評価します。オーケストレーションエンジンは、送信前に複雑さ、プロバイダーのヘルス状態、レイテンシ、コスト、および適用可能なルーティングポリシーを検査できます。大半の現実のシステムでは、速度、品質、レジリエンス(障害耐性)、コストのバランスを取るために、これら両方のアプローチを組み合わせて使用しています。
どちらの場合も、中心となるオーケストレーターがアプリケーションとバックエンドのモデル群の間に位置します。プロバイダー固有のAPIを抽象化し、ルーティングを処理し、レスポンスを正規化し、フェイルオーバーを管理します。アプリケーション側のエントリーポイントは1つで済み、ゲートウェイがモデルの選択とプロバイダーの動作を管理します。
マルチモデルオーケストレーションが不可欠となったのは、AIワークロードのコスト、リスク、複雑さ、レイテンシが明確に多用化・差別化されるようになったためです。シンプルな顧客からの問い合わせに回答するチャットボットには、規制対象となる意思決定や複雑なコード生成を扱うエージェントと同じモデルは必要ありません。
フロンティアモデルは推論品質と汎用性を最優先に最適化されています。一方、より小さな言語モデルは、明確に定義されたタスクにおける速度とコストを最優先に最適化されています。すべてのワークロードを単一の階層に固定してしまうと、両方の側面で本来得られるはずのメリットを逃すことになります。
デフォルトですべてのトラフィックを主力の大規模言語モデル(LLM)にルーティングすることは、リクエストの大部分において過剰な支払いを行うことを意味します。より小さなモデルであっても、多くの定型的なプロンプトに対して同等の精度とより速いレスポンスタイムで回答できます。逆に安価なモデルへ標準化することは別の問題を引き起こします。本当に難しいプロンプトに対して内容の薄い回答や不正確な回答が返ってくる原因となるためです。
支出グラフが明確な要因もないまま上昇していくのを目にしたことがあるなら、その原因はきわめてシンプルであることがよくあります。デフォルトモデルが1つ、ルーティングルールが1つしかなく、より容易な作業をより安価なリソースへ割り振る手段が存在しないためです。マルチモデルオーケストレーションは、各タスクを最適なモデルに一致させるため、この課題に対する構造的な解決策となります。
LLM APIプロバイダーでは、障害、レート制限、パフォーマンスの低下が発生することがあり、これらは本番アプリケーションに直接影響を及ぼします。TrueFoundry自体のゲートウェイマニュアルでも、2025年2月から5月までのOpenAIおよびAnthropicのステータスページを引き合いに出し、4か月の間にインシデントが繰り返し発生したことを示しています。
これは極端な例外事例ではありません。本番環境の生成AIシステムにおける日常的な運用環境そのものです。
自動フェイルオーバーを備えたマルチモデルオーケストレーションは、プライマリ Chop エンドポイントの機能が低下した際に、本番ワークロードを利用可能な別のプロバイダーへとルーティングします。人間の介入やオンコールエンジニアによる緊急変更を必要とすることなく、アプリケーションの可用性が維持されます。このパターンは、他のあらゆるクリティカルな依存関係と同じです。つまり、冗長性、ヘルスチェック、自動フォールバックです。
規制下にある企業は、すべてのリクエストをあらゆるモデルに送信できるわけではありません。一部のワークロードには、機密データ、センシティブな情報、顧客記録、あるいは地域のデータ制限が含まれます。これらのケースでは、ルーティングの決定はコストやレイテンシだけでなく、ポリシーのルールを考慮して行われなければなりません。
ガバナンスが効いた制御層は、メタデータ、地理的ロケーション、チーム、環境、またはデータクラスに基づいてリクエストをルーティングできます。これは、外部データ、プライベートデータセット、または制限されたワークロードを承認済みの境界内に保持する必要がある場合に重要です。
TrueFoundryの場合、ターゲットに metadata_match ルールを設定できます。これにより、リクエストのメタデータ(またはゲートウェイ自体の tfy_gateway_region タグ)が設定値に一致した場合にのみトラフィックを受信させ、明示的にマッピングされていないリージョンに対してはキャッチオールターゲットを割り当てることが可能です。
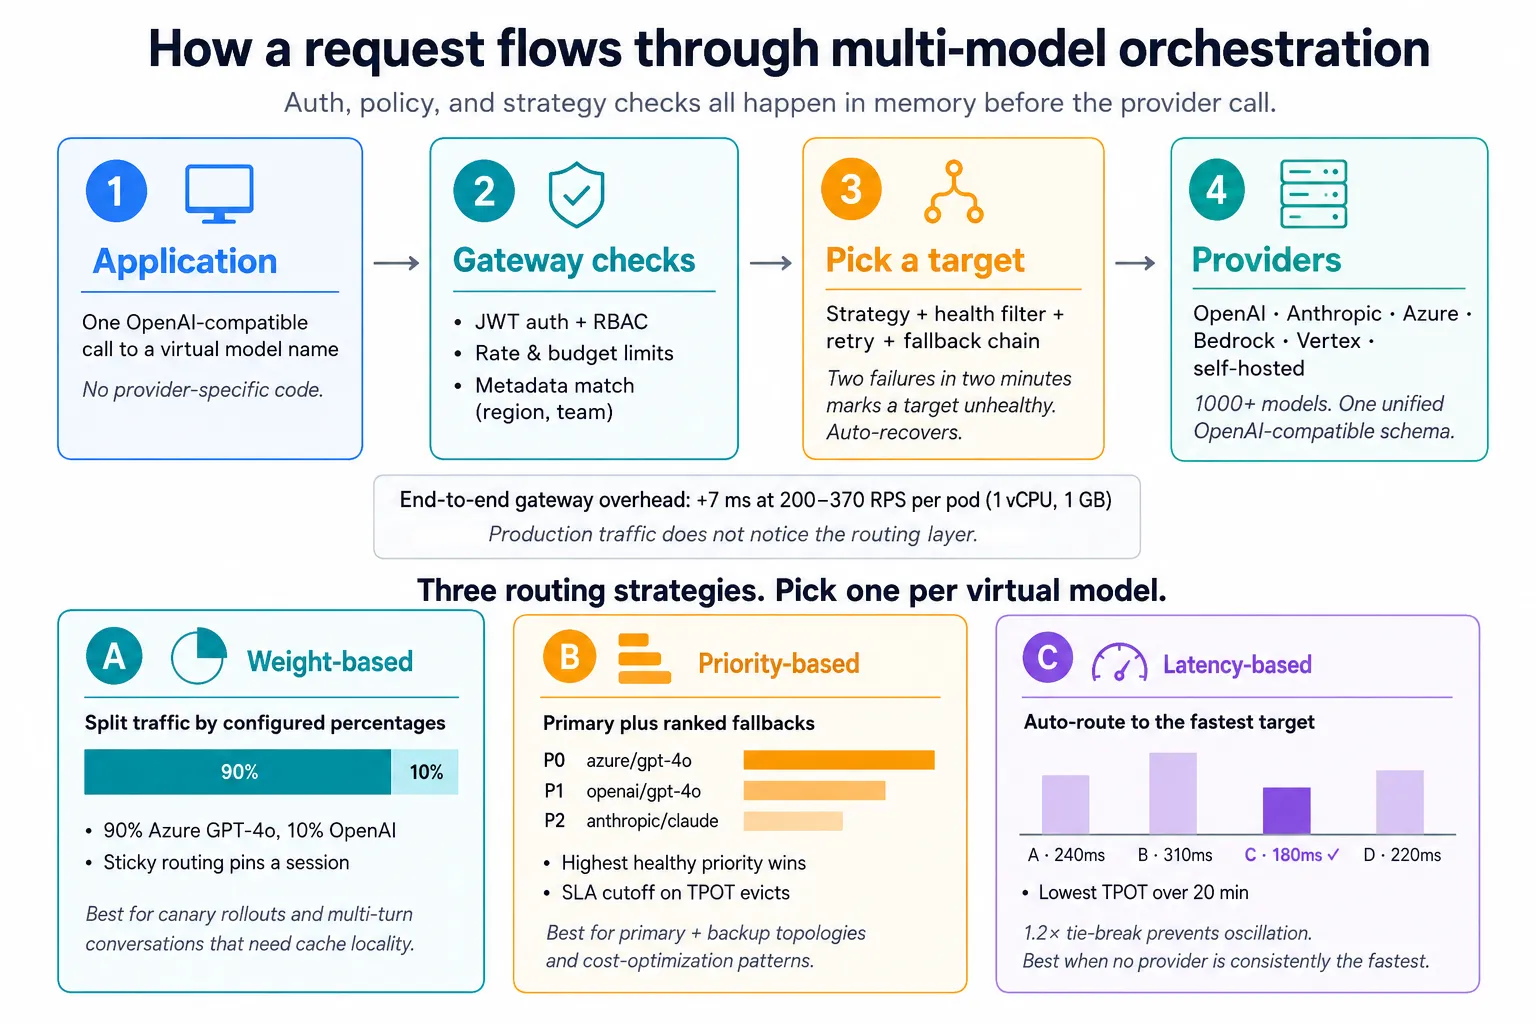
マルチモデルオーケストレーションは、通常、統一API層、ルーティングロジック、フェイルオーバーチェーン、レスポンスの正規化という4つのコアコンポーネントに依存しています。これらが連携することで、チームはアプリケーションコード内にすべての統合をハードコーディングすることなく、複数のプロバイダーを利用できるようになります。
プロバイダーごとにリクエスト形式、パラメータ名、エラーコード、レスポンス構造が異なります。AIオーケストレーションフレームワークは、これらの違いを単一のAPIの背後で正規化します。これにより、アプリケーションはホスト型、オープンソース、セルフホストの各モデル全体で一貫したインターフェースを持つことができます。
TrueFoundryのLLM Gatewayは、1,000以上のモデルにわたってOpenAI互換のスキーマを公開しています。これにより、チームはダウンストリームのサービスを一切変更することなく、プロバイダーの追加や交換を行えます。また、プロンプトエンジニアリング、テスト、チーム間でのロールアウト管理も簡素化されます。
この統一API層は、開発者やプラットフォームチームの利便性も高めます。様々なアプリケーションにわたるプロンプトエンジニアリング、統合テスト、ロールアウト管理を簡素化します。チームはサービスごとに個別のプロバイダー固有ロジックを構築する代わりに、モデルアクセス用の単一で一貫したエントリーポイントを使用します。
ここが、マルチモデルオーケストレーションの真価が発揮される部分です。TrueFoundryのバーチャルモデル(Virtual Model)は3つのルーティング戦略をサポートしており、バーチャルモデルごとに1つを選択します。
TrueFoundryにおける標準的なプライマリ+フォールバック構成のバーチャルモデル設定は、次のようになります。
この設定では、リクエストはまず azure/gpt-4o に送信されます。retry_config ブロックに基づき、ゲートウェイはレート制限エラーに対して 200 ms のディレイを入れて最大 3 回リトライを実行した上で、openai/gpt-4o へとフォールバックします。Anthropic ターゲットは、最高優先度の正常なターゲットである場合のみ実行され、他の2つのフォールバックとして実行されることはありません。
これらすべての処理はメモリ上で実行されます。
リクエストパスにおいて外部呼出しは発生しません。
これらのルーティングパターンは、カスタマーサービス、カスタマーサポート、紛争解決、コーディングアシスタント、コンプライアンスワークフロー、社内エンタープライズCopilotなど、多様なアプリケーションをサポートします。
フェイルオーバーチェーンは、各ルーティングルールに対して優先順位付けされたプロバイダーのリストを定義します。プライマリがフォールバック対象のステータスコード(TrueFoundryのデフォルト:401、403、404、429、500、502、503)を返した際、ゲートウェイはエラーをアプリケーションに直接返さず、次に適したターゲットへの試行を行います。
このパターンは、複雑なワークフローや自律型エージェントにとって特に有用です。エージェントが複数のモデル呼び出しに依存している場合、単一のプロバイダー障害によってワークフロー全体が破綻する可能性があります。自動フェイルオーバーにより、人間の介入を必要とすることなくユーザー体験が保護されます。
また、フォールバックが発動する前に、同一ターゲット上でリトライするロジックも存在します。ゲートウェイのデフォルト設定は、429、500、502、503 のエラーに対して 100 ms のディレイで 2 回のリトライを行うというものです。各ターゲットは自身の retry_config ブロック内でこれらのデフォルトをオーバーライドできます。上記のYAMLでは、azure/gpt-4o はこれらのデフォルトを 200 ms で 3 回のリトライにオーバーライドしており、openai/gpt-4o は明示的に 100 ms で 2 回(デフォルトと同等)に設定しています。anthropic/claude-sonnet には retry_config ブロックがないため、デフォルト設定を継承します。さらに、ゲートウェイは障害を継続的に追跡します。ターゲットが2分間のローリングウィンドウ内で2回以上の障害を起こすと、非正常(Unhealthy)とマークされ、エラーが期限切れになるまでスキップされ、自動復旧が行われます。障害が解消された際にも、人間の介入や手動による設定変更は不要です。
モデルごとに、返されるレスポンスの形状、メタデータ、終了理由(finish reasons)、トークンカウント形式が異なります。オーケストレーション層はこれらすべてを正規化します。そのため、リクエストがOpenAI、Anthropic、あるいはセルフホストのLlamaに送信されたかどうかにかかわらず、コードは同一のレスポンス構造を読み取ります。
デバッグ用途として、TrueFoundryはリクエストを実際に処理したターゲットを x-tfy-resolved-model レスポンスヘッダーに含めて返します。これにより、バーチャルモデル名が10個の候補ターゲットをカバーしている場合でも、どのモデルがその出力を生成したかを特定・追跡できます。この可視性は、品質の低下を調査しており、スティッキールーティングの設定によってユーザーが同一のプロバイダーにとどまっていたのか、それともセッションの途中でフォールバックが発生したのかを知る必要がある場合に極めて重要です。
マルチモデルオーケストレーションは、チームがルーティングの決定をビジネスの成果と結びつけることで真の価値を生み出します。ゴールは単に使うモデルの数を増やすことではありません。コスト、品質、可用性、コンプライアンス、ガバナンスを改善しながら、各リクエストに適切なモデルを適用することです。
たとえば、サポートワークフローでは、定型的な顧客からの問い合わせを小型モデルにルーティングできます。一方で、複雑な請求に関する紛争やテクニカルサポートのケースは、より強力なモデルに送信できます。これにより、回答の品質を落とすことなくコスト制御を改善できます。
別のユースケースとして、企業の調査・リサーチアシスタントが、自然言語理解に1つのモデルを使い、データ検索に別のモデルを使い、自然言語生成にさらに別のモデルを使用することが挙げられます。オーケストレーションロジックが、どのモデルまたはエージェントが最終的な回答に貢献するかを決定します。
このアーキテクチャは、モデルの選択を運用可能なプロセスに変えるため、企業に競合上の優位性をもたらします。チームはすべてのAIアプリケーションを再構築することなく、ルーティングルールの調整、プロバイダーのテスト、コストの削減、レスポンス品質の向上を行えます。
ルーティング単体は、ガバナンスと同義ではありません。
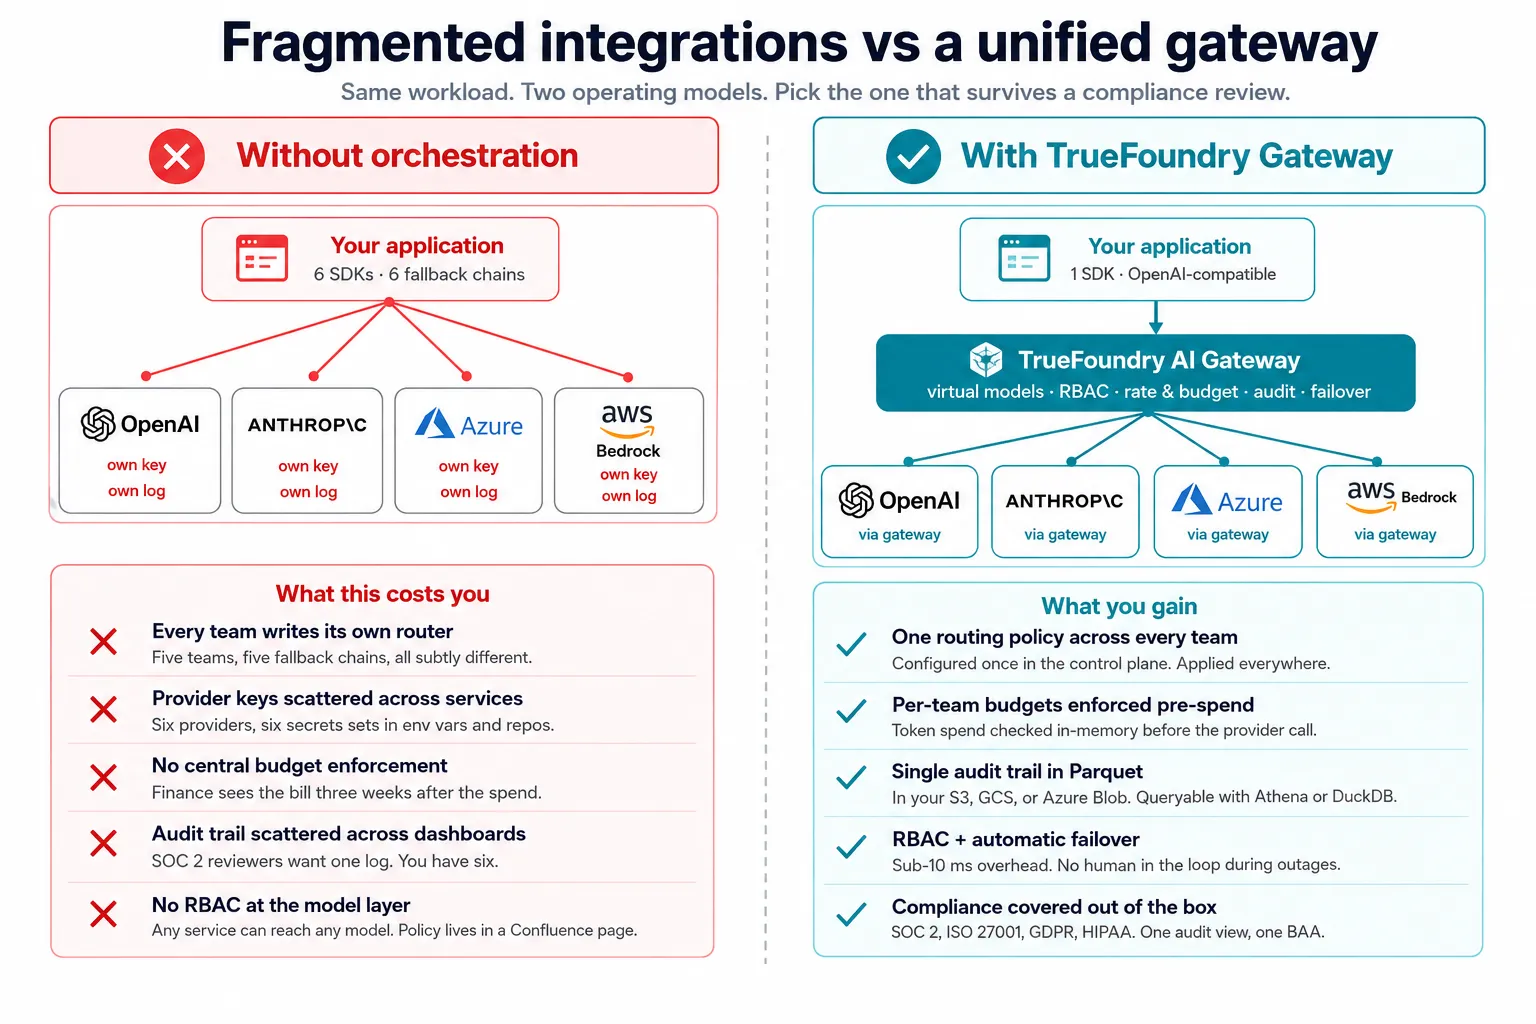
独自のルーターを構築し、ロードバランシングの計算を正しく行えたとしても、予行演習していなかった4つの問題に直面するチームは数多く存在します。
アプリケーションごとの個別のルーティングは、すべてのチームが同じロジックをそれぞれ独自に記述することを意味します。5つのチームがあれば、5つの微妙に異なるフォールバックチェーン、5組のプロバイダーキーが環境変数の中に浮遊することになります。この不整合は組織の規模が大きくなるほど増幅され、「マルチモデルオーケストレーションがある」状態から「各チームが個別のマルチモデルオーケストレーションを持っている」状態へと変貌してしまいます。
リクエストが実行される前にチームごとの予算制限を強制するルーティングフレームワークは存在しません。トークン消費量は、ルーティングされたすべてのプロバイダーにわたって蓄積されていきます。財務部門がOpenAIの請求額が3倍になった理由を尋ねてくる頃には、予算オーバーの事態はすでに発生しており、対応が3週間遅れることになります。
マルチプロバイダーのルーティングは、マルチプロバイダーの監査(オーディット)問題を引き起こします。OpenAIのダッシュボードのログ、Anthropicのコンソールのログ、Azureのポータルのログ。これらはどれも、SOC 2やHIPAAの監査レビューが実際に必要とする、ユーザー属性が紐づけられた統合監査ログとして繋ぎ合わされることはありません。
可用性はアクセス制御と同義ではありません。フェイルオーバーは、正常なプロバイダーであればどれでもリクエストを処理できることを意味します。ゲートウェイ層でのRBACがなければ、アクセスすべきでないエンジニアやAIエージェントであっても、正常なプロバイダーであればアクセス可能になってしまいます。マーケティング用のプロンプトを、臨床ワークフロー専用に承認されたモデルに決して到達させてはならない場合、そのポリシーはConfluenceのページではなく、ゲートウェイに存在させる必要があります。
ここで、コンテキストエンジニアリングと状態管理も運用の懸念事項となります。システムは、データソース、ナレッジベースシステム、ベクトルデータベース、および外部データソースから関連情報を検索する場合があります。ガバナンスの効いた制御層がなければ、システム全体で情報が露出したり、リクエストが誤ってルーティングされたりする可能性があります。
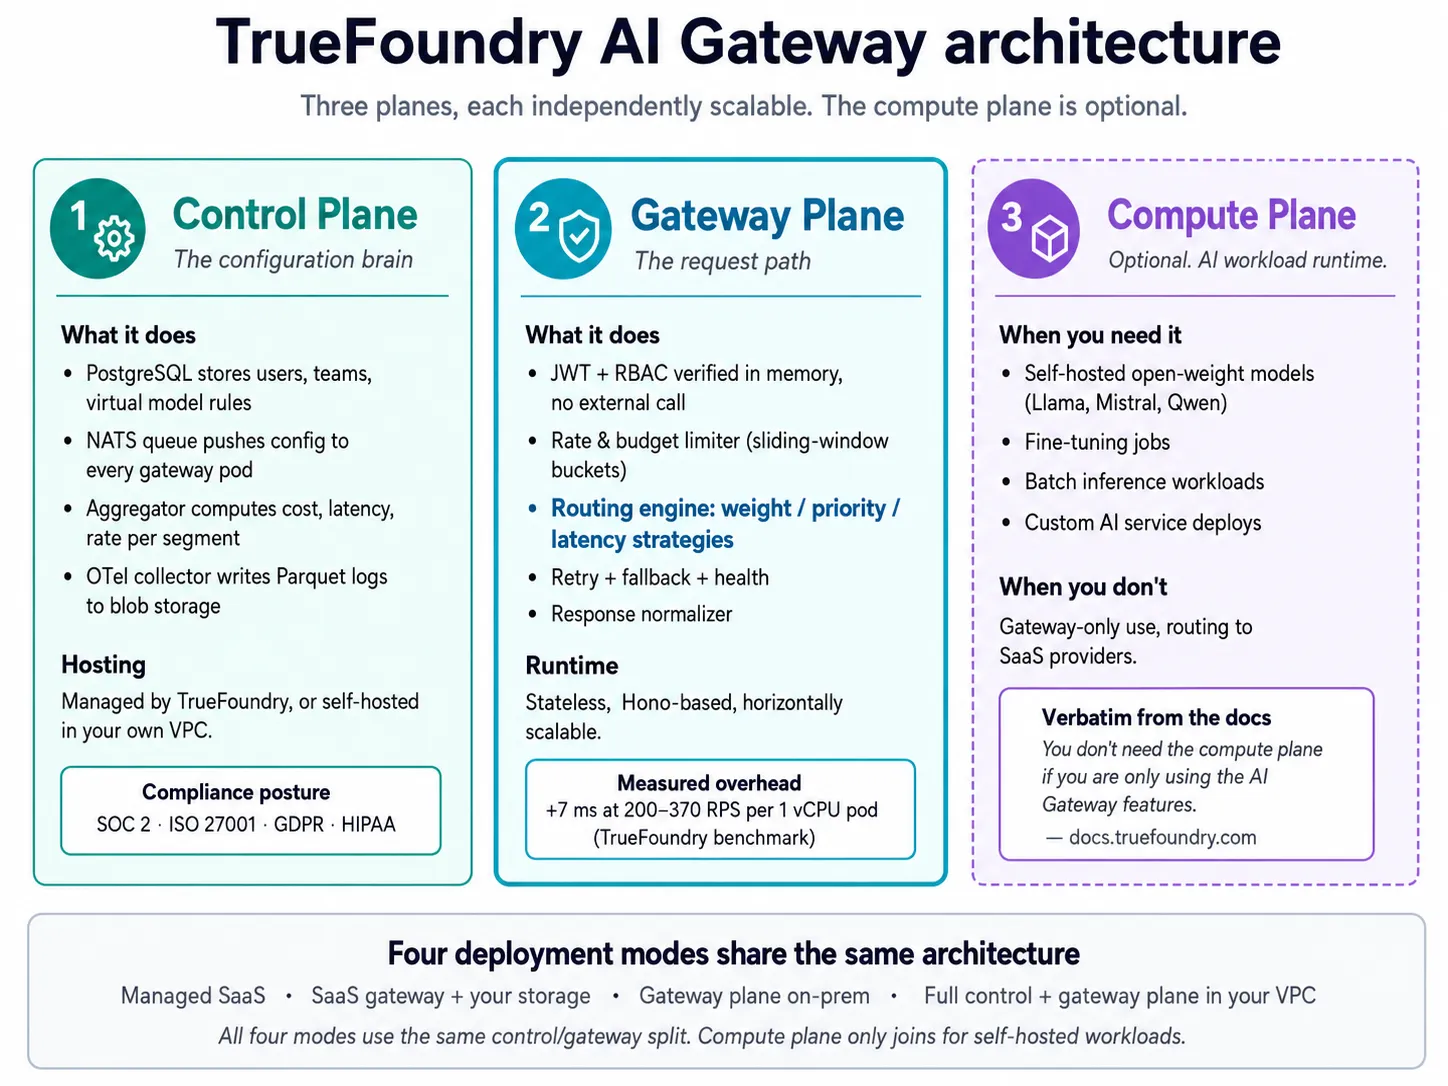
TrueFoundryのLLM Gatewayは、コントロールプレーンで管理されるルーティング層としてマルチモデルオーケストレーションを提供します。マネージドSaaS、ハイブリッド、あるいは自社のVPC内で完全に実行することが可能です。本番運用において、以下の4つの特性が重要となります。
AI Gatewayは、本番AIワークロード全体にわたって、より広範なガバナンス、レート制限、予算、ガードレール、可視性(Observability)を追加します。MCP Gatewayは、モデル駆動型アプリケーションのためのツールアクセス、認証、MCPサーバーの可視性を管理します。Agent Gatewayは、自律型エージェント、専門エージェント、および単一のAIエージェントが複数のモデルやツールを呼び出す複雑なワークフローを制御します。
TrueFoundryが自社VPC内でどのようにマルチモデルルーティング、エージェント、MCPツール、および監査ログをガバナンスするか確認するには、デモを予約してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




マルチモデルオーケストレーションとは、アプリケーションを 複数のAIモデル に接続し、タスクの種類、レイテンシ、コスト、プロバイダーの可用性といった要素に基づいて、各リクエストを最適なモデルへ動的にルーティングするアーキテクチャパターンです。オーケストレーション層は、基盤となるプロバイダーを単一のAPIの背後に抽象化し、モデルが利用できない場合のフェイルオーバーを処理し、レスポンスを正規化することで、アプリケーション側でプロバイダー固有のコードを記述する必要をなくします。本番環境において、プロバイダーの障害発生時にもAI機能を維持し、利用拡大に伴うコストを予測可能にするための手法です。
マルチLLMオーケストレーションとは、大規模言語モデル(LLM)に特化した同様のパターンを指します。アプリケーションと複数のLLMプロバイダー(OpenAI、Anthropic、Google、Bedrock、セルフホストなど)の間にオーケストレーション層を配置することで、各リクエストを適切なモデルにルーティングし、フェイルオーバーや再試行を管理します。これにより、どのプロバイダーが応答を生成する場合でも、アプリケーションに対して一貫したインターフェースを提供することが可能になります。基盤となるモデルがすべてLLMである場合、この用語はマルチモデルオーケストレーションと同義で使われることが一般的です。
目的は、すべてのワークロードを「能力」「コスト」「信頼性」という3つの軸で最適なモデルに割り当てることです。高性能なフロンティアモデルはコストがかかりますが、複雑なタスクをより適切に処理できます。一方、小規模なモデルは日常的な作業に適しており、安価で高速です。マルチモデルオーケストレーションは、これらをインテリジェントに振り分け、プロバイダーのパフォーマンス低下時にはフェイルオーバーを行い、運用チームが一元的にコスト、レート、アクセスに関するポリシーを適用できるようにします。これは、AIを単なるプロバイダー統合の集合体として運用するのか、それともガバナンスの効いたプラットフォームとして運用するのかという違いを生み出します。
オーケストレーション層がそれらを正規化します。各プロバイダーは、独自のレスポンス形式、トークンカウントのフォーマット、エラーコード、終了理由の規約を持っています。ゲートウェイは、アプリケーションに返す前に、すべてを単一の一貫した形式(通常はOpenAI互換スキーマ)に変換します。プロバイダー固有の処理はアプリケーションコード内ではなく、ゲートウェイ内に留まります。TrueFoundryの場合、解決されたターゲットモデルもレスポンスヘッダー「x-tfy-resolved-model」で返されるため、どのプロバイダーがどのリクエストを処理したかを追跡できます。
TrueFoundryのゲートウェイのようなシステムでは、仮想モデルを定義して複数の実ターゲットを指定し、ルーティング戦略を選択します。戦略には、重み付け(トラフィックをパーセンテージで分割)、優先順位付け(メインとランク付けされたフォールバック)、レイテンシベース(最も高速で正常なターゲットを自動選択)があります。さらに、リトライポリシー、フォールバックのステータスコード、出力トークンあたりの時間に基づくSLAカットオフ、マルチターンセッション向けのスティッキーなルーティング、ターゲットごとのメタデータベースのフィルタリングなどを組み合わせることも可能です。ルールはゲートウェイの設定に保存され、その仮想モデル名を使用するすべてのチームに適用されます。更新は数秒で反映されます。























