


November 17, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
OpenCodeのようなAI支援コーディングツールは、開発者がコードと対話する方法を根本から変えています。分離されたコードスニペット上で操作するのではなく、これらのシステムはファイル、依存関係、過去のコンテキスト全体にわたって推論を行います。その結果、生産性が大幅に向上する一方で、多くのチームが軽視しがちな新しいコストと拡張性の課題、つまりトークン使用量が発生します。
予測可能なライセンスコストを持つ従来の開発ツールとは異なり、OpenCodeの使用はトークンベースの価格設定によって管理されます。すべてのインタラクション、コード生成、リファクタリング、デバッグ、あるいはレビューにおいて、トークンが消費されます。チームが開発者、リポジトリ、自動化エージェントにわたって利用を拡大するにつれて、トークン消費が最大のコスト要因となります。
これを特に複雑にしているのは、トークン使用量がしばしば直感的ではない点です。コンテキストサイズ、プロンプト構造、エージェントの動作におけるわずかな変更が、トークン消費量の大きな変動につながる可能性があります。トークンがどのように使用されているかについての明確なメンタルモデルがないと、チームはコストの予測、ワークフローの最適化、ガバナンス(ガードレール)の強制に苦労することになります。
本ブログでは、OpenCodeにおけるトークン使用の技術的な仕組み、コード関連のワークロードが特にトークン消費の多い理由、そして本番環境で運用をスケールさせる前にプラットフォームチームが理解しておくべきポイントを詳しく解説します。
根本において、OpenCodeのトークン使用量は多くのLLM駆動システムと同じメカニズムに従います。つまり、入力と出力の両方でトークンが消費されます。ただし、コーディングワークロードの性質上、さらなる複雑さが生じます。
OpenCodeのトークン使用量は、大きく2つのカテゴリに分けることができます。
OpenCodeにおいて、プロンプト・トークンには通常以下が含まれます:
コンプリーショントークンには以下が含まれます:
コストの視点からは、特にリポジトリやコンテキストサイズが大きくなるにつれて、プロンプト・トークンがOpenCodeの使用量において支配的な要因となることがよくあります。
コード関連のタスクは、自然言語のクエリとは大きく異なる挙動を示します。トークン消費量が高くなる原因には以下の要因があります:
チャットベースのユースケースとは異なり、OpenCodeは多くの場合以下を送信します:
複数のファイルが含まれる場合、「小さな」コードベースであっても、あっという間に数十万トークンに変換されることがあります。
ソースコードは高密度です。構文、インデント、記号、フォーマットはすべてトークンとしてカウントされます。数千行のコードは、同等量のプレーンテキストよりもはるかに多くのトークンを消費する可能性があります。
OpenCodeのワークフローには、頻繁に以下が含まれます:
各ステップでコンテキストや中間出力が再送信される可能性があり、単一のタスク全体でトークン使用量が掛け合わされます。
OpenCodeがエージェントや自動化を介して使用される場合(たとえば、複数ファイルにわたるリファクタリングやCIパイプラインでの実行)、トークン使用量は急速に増大します:
これにより、エージェント駆動型の使用は強力になりますが、制御しないと非常に高コストになります。
OpenCodeのトークン使用における最大の課題の1つは、開発者がモデルに送信されている完全なコンテキストを直接確認することが稀である点です。エディタやツールは以下を抽象化して隠してしまいます:
その結果、一見似たような2つのタスクであっても、トークンフットプリントが大きく異なる場合があります。リクエストレベルでの明示的な追跡がなければ、チームは使用量が急増した後に初めてコストの問題に気づくことになります。
これが、トークンのメカニズムを理解するだけでは不十分である理由です。情報に基づいた最適化の決定を下すには、タスクごと、開発者ごと、ワークフローごとの実際のトークン消費量に対する可視性がチームに不可欠となります。
トークン使用量の理解は、すべてのAI駆動型アプリケーションにとって重要ですが、開発者、エージェント、エンタープライズプラットフォーム全体にAI導入が拡大するにつれて、特に不可欠なものとなります。トークン消費を監視および最適化することで、組織はコストを管理し、効率を向上させ、予測可能なAI支出を維持することができます。
OpenCode、Claude Code、および同様のAIコーディングアシスタントは、大規模なコードベース、広範なコンテキストウィンドウ、およびマルチターンの会話を頻繁に処理します。開発者が一日を通じてこれらのツールとやり取りする中で、トークン消費量は急速に増加する可能性があります。
トークン使用量を追跡することで、エンジニアリングチームは以下のことが可能になります:
AIエージェントは、計画、推論、ツールの呼び出し、検索、コード生成を含む複雑なワークフローを実行することがよくあります。これらのマルチステップのインタラクションは、従来のチャットアプリケーションよりも大幅に高いトークン使用量を発生させる可能性があります。
トークン消費量を監視することで、チームは以下のことが可能になります:
エージェントの導入が進むにつれて、予測可能な運用コストを維持するためにトークンの可視性が不可欠になります。
大企業では、複数のチーム、製品、事業部門にわたってAIアプリケーションを展開することがよくあります。中央集権的な可視性がないと、トークンがどのように消費され、どこでコストが増加しているかを把握するのが困難になります。
組織はトークンモニタリングを活用して以下のことを行います:
AIの採用が広がるにつれ、トークン使用量はレイテンシ、信頼性、モデルパフォーマンスと並ぶ重要な運用メトリクスとなります。トークン消費を積極的に監視および最適化する組織は、コストを管理しながらAIワークロードを効率的にスケールさせるための優位性を確保できます。
OpenCodeのトークン使用量の急増のほとんどは、単一の明白なミスによって引き起こされるわけではありません。それらは、実際のエンジニアリングワークフローでOpenCodeがどのように使用されているか、特にツールやエージェントが開発や自動化パイプラインに深く統合されている場合に生じます。
以下は、トークン消費量を不釣合いに増加させる最も一般的なシナリオです。
トークン高使用量の最大の原因の1つは、過剰に広範なコンテキストの含有です。多くのOpenCodeワークフローでは、コードのわずかな部分しか関連していない場合でも、「念のため」リポジトリのディレクトリ全体や大規模なサブセットを含めてしまいます。
例としては以下が挙げられます:
プロンプト・トークンはコンテキストサイズに応じて線形にスケールするため、このパターンだけでコストが急速に倍増する可能性があります。
OpenCodeは多くの場合、反復的(イテレーティブ)に動作します。コードを生成し、レビューし、調整し、再生成します。多くの設定では、各イテレーションでファイルや過去の出力を含むフルコンテキストが再送信されます。
これにより以下が発生します:
キャッシングやインテリジェントなコンテキスト再利用がない場合、イテレーションは最もコストのかかるパターンの1つになります。
OpenCodeがエージェントや自動化ワークフローを介して使用される場合、実行が明示的に制限されていないとトークン使用量が急速に拡大する可能性があります。
主な原因は以下の通りです:
これらのプロセスはバックグラウンドで実行されることが多いため、コストが急増するまで暴走した使用量にチームが気づかないことがあります。
リファクタリングやレビューのタスクは、コード生成よりもトークン集約的になる傾向があります。これらには以下が必要となるためです:
これらのタスクが大規模なコードベースや複数のプルリクエストに適用されると、トークン使用量が大幅に増加します。
CIパイプラインや自動化ワークフローに組み込まれたOpenCodeの使用は、異なるリスクプロファイルをもたらします。これらのシステムは:
実行ごとのトークン使用量がわずかであっても、多数のビルドやデプロイメントにわたって掛け合わされると、高額になる可能性があります。
最後に、見落とされがちな高トークン使用量の要因の1つは、可視性の欠如です。チームが以下を確認できない場合:
最適化は推測作業になってしまいます。チームはコストの原因となっている特定のワークフローに対処するのではなく、全体的な使用制限を設けることで対応しがちになります。
トークン使用量がどこから発生しているかをチームが理解したら、次のステップは最適化です。重要なのは、最適化とは使用量を無差別に制限することではなく、生産性の向上が野放しのコストに変わらないよう、意図的にトークンを使用することです。
以下は、出力品質を低下させることなく、OpenCodeのトークン使用量を一貫して削減する実用的なベストプラクティスです。
最も効果的な最適化のレバーは、モデルに送信されるコンテキストをコントロールすることです。特に無関係な情報が含まれている場合、コンテキストが多ければ多いほど良いというわけではありません。
実用的なテクニックには以下が含まれます:
良い経験則として:変更について推論するためにファイルが必要ない場合、それをプロンプトに含めるべきではありません。
前もって大量のコードを送信する代わりに、チームはオンデマンドの検索(Retrieval)へと移行すべきです。
例:
このアプローチにより、モデルはよりターゲットを絞った情報を受け取るため、推論品質を向上させながらプロンプトサイズを削減できます。
汎用的なプロンプトは、より広範な推論と大きな出力を促す傾向があり、これによりプロンプトとコンプリーショントークンの両方が増加します。
より優れたパターン:
タスクのスコープを絞ったプロンプトは、トークン使用量を削減するだけでなく、決定論(再現性)も向上させます。
エージェントベースのワークフローは、チェックしないでおくとトークン使用量を増幅させます。すべてのエージェントは、明確に定義された制限内で動作させる必要があります。
主なガードレールには以下が含まれます:
これらの境界がないと、エージェントは大きなコンテキストを誤って複数回再処理し、使用量を押し上げる可能性があります。
多くのOpenCodeワークフローは、イテレーションやユーザー間で同様のタスクを繰り返します。キャッシングを行うことで、冗長なトークン消費を大幅に削減できます。
適用可能なシナリオ:
ワークフローレベルでの部分的なキャッシングであっても、有意義なコスト削減をもたらす可能性があります。
プロンプト・トークンが支配的であることが多いものの、特にリファクタリングや説明の多いワークフローではコンプリーショントークンも重要です。
テクニックには以下が含まれます:
明確な出力制約を設けることで、不必要な冗長さを減らすことができます。
最後に、最適化はリアクティブ(事後対応的)であってはなりません。チームは初日からトークン使用量を計測(インストゥルメンテーション)すべきです。
最低限、以下を追跡することを意味します:
このデータがなければ、チームは生産的な使用と無駄を区別することができません。
ほとんどのチームは、導入初日にOpenCodeのトークン使用量で悩むことはありません。問題は、開発者、リポジトリ、自動化ワークフロー全体で使用が広がるにつれて徐々に表面化します。個人の生産性ツールとして始まったものが、すぐに共有インフラストラクチャになり、トークンの使用量は予測や管理が困難な方法でスケールします。
スケールした環境では、OpenCodeはエディタ内の単一の開発者だけによって使用されるものではなくなります。以下によって使用されます:
これらの消費者はそれぞれ独立してトークン使用量を発生させます。中央集権的な視野がないと、「誰がトークンを使っているのか」、「何のために使っているのか」、「コストはいくらか」といった基本的な質問に答えることが困難になります。
初期の最適化作業は、個別のアプリケーションやツールのレベル(独自のプロンプト制限、コンテキストの削減、再試行ロジックなど)で実装されることが多くあります。これらはローカルでは役立ちますが、以下全体にはスケールしません:
その結果、ポリシーが分断され、不整合が生じます。あるチームが積極的に最適化を行う一方で、別のチームが知らず知らずのうちにコストを押し上げることになります。
自動化は計算を狂わせます。1回の実行で適度なトークンを消費するワークフローであっても、次のような場合に高額になる可能性があります:
これらのジョブは人間の直接的な監視なしで実行されるため、非効率性が急速に複合化します。トークン使用量の急増は、対話型の使用ではなく自動化から発生することが多くあります。
きめ細やかな割り当てがないと、チームには集計された使用量データしか見えません。これにより、最適化が事後対応的で大雑把なものになります。
一般的な失敗パターンには以下が含まれます:
効果的なコントロールを行うには、どのワークフローが価値を生み出し、どのワークフローが無駄を生み出しているかを知る必要がありますが、これは集計メトリクスでは明らかにできません。
多くの組織では、AIツールの採用がガバナンスよりも速く進みます。OpenCodeの使用は、以下よりも速く広がります:
トークンの使用量が懸念事項となる頃には、ツールはすでにワークフローに深く組み込まれており、さかのぼってコントロールを行うことが困難で障害を伴うものになります。
根本的な問題は誤用ではなく、中央集権的なコントロールのない分散型の使用です。OpenCodeが共有インフラになるにつれて、チームがコンピューティング、ストレージ、CIリソースを管理するのと同じ方法でトークン使用量を管理する必要があります。
これには以下が必要です:
この転換がなければ、トークンの使用量は予測不可能なままであり、最適化の取り組みも事後対応的なものにとどまります。
OpenCodeの使用が本番スケールに達すると、アドホックな追跡や手動の最適化は機能しなくなります。この段階では、トークン使用量を他の共有インフラリソースと同様に扱い、継続的に計測し、中央で管理し、所有権に紐付ける必要があります。
多くのチームは、個々のツールやワークフロー内でトークン使用量を追跡することから始めます。これはローカルな洞察を提供しますが、次のような場合にすぐに破綻します:
統合ごとに報告される使用量が異なり、全体像を提供するものは一つもありません。その結果、プラットフォームチームはトークン消費に関する単一の信頼できる情報源(Single Source of Truth)を欠くことになります。
スケール環境では、モニタリングはツールレベルだけでなく、リクエストレベルで行う必要があります。効果的なセットアップでは以下を捕捉します:
これにより、チームは次のような疑問に答えることができるようになります:
この粒度がなければ、最適化の取り組みは大雑把なままであり、しばしば見当違いな方向に向かってしまいます。
ガバナンスは割り当てから始まります。トークンの使用量は、それに対して行動を起こすことができる所有者にマッピングされる必要があります。
一般的な割り当てモデルには以下が含まれます:
所有権が明確になれば、コストに関する議論は抽象的な予算管理から、どのワークフローが十分な価値を提供しているかについての具体的な意思決定へとシフトします。
モニタリングだけではコストオーバーランを防ぐことはできません。本番システムには、リアルタイムで動作する強制メカニズムが必要です。
典型的なガードレールには以下が含まれます:
これらのコントロールは、すべてのOpenCode駆動ワークフローが自動的に継承できるように、中央で強制される必要があります。
効果的なガバナンス設定に共通するテーマは、中央集権化(Centralization)です。Token使用量ポリシー、制限、および可視性は、ツールごとに再実装するのではなく、共有の制御ポイントに存在する必要があります。
ここにTrueFoundryのようなインフラ指向のプラットフォームが自然に適合します。AIトラフィック、可視性、ポリシ一適用を中央集権化することで、プラットフォームチームは個々のチームの速度を落とすことなく、開発者、エージェント、自動化システム全体でOpenCodeのToken使用量を一貫して管理できます。
AIの導入が進むにつれ、Token使用量の追跡と管理はますます重要になっています。個々の開発者は多くの場合、手動でToken消費を管理できますが、複数のアプリケーション、チーム、モデルを運用する組織では、通常、中央集権的な可視性とガバナンスが必要です。
手動モニタリングは小規模な展開には有効ですが、AIワークロードが拡大するにつれて、支出の追跡、非効率性の特定、使用制限の適用が困難になることがよくあります。AI Gatewayは、組織全体でToken使用量を監視し、コストを管理し、モデルの利用を最適化するための中央集権的なレイヤーを提供します。
プラットフォームの観点から見ると、OpenCodeのToken使用量における核心的な課題は、Tokenがどのように消費されているかを理解することではなく、制御と可視性をどこに配置すべきかということです。
TrueFoundryは、OpenCodeのような開発者向けツールを含むAIおよびLLMの使用を、デフォルトで可視化され、管理可能で、コストを意識すべき共有インフラストラクチャとして扱うことでこの問題に対処します。このアプローチの中心にあるのがAI Gatewayであり、組織全体のすべてのLLMトラフィックのコントロールプレーンとして機能します。
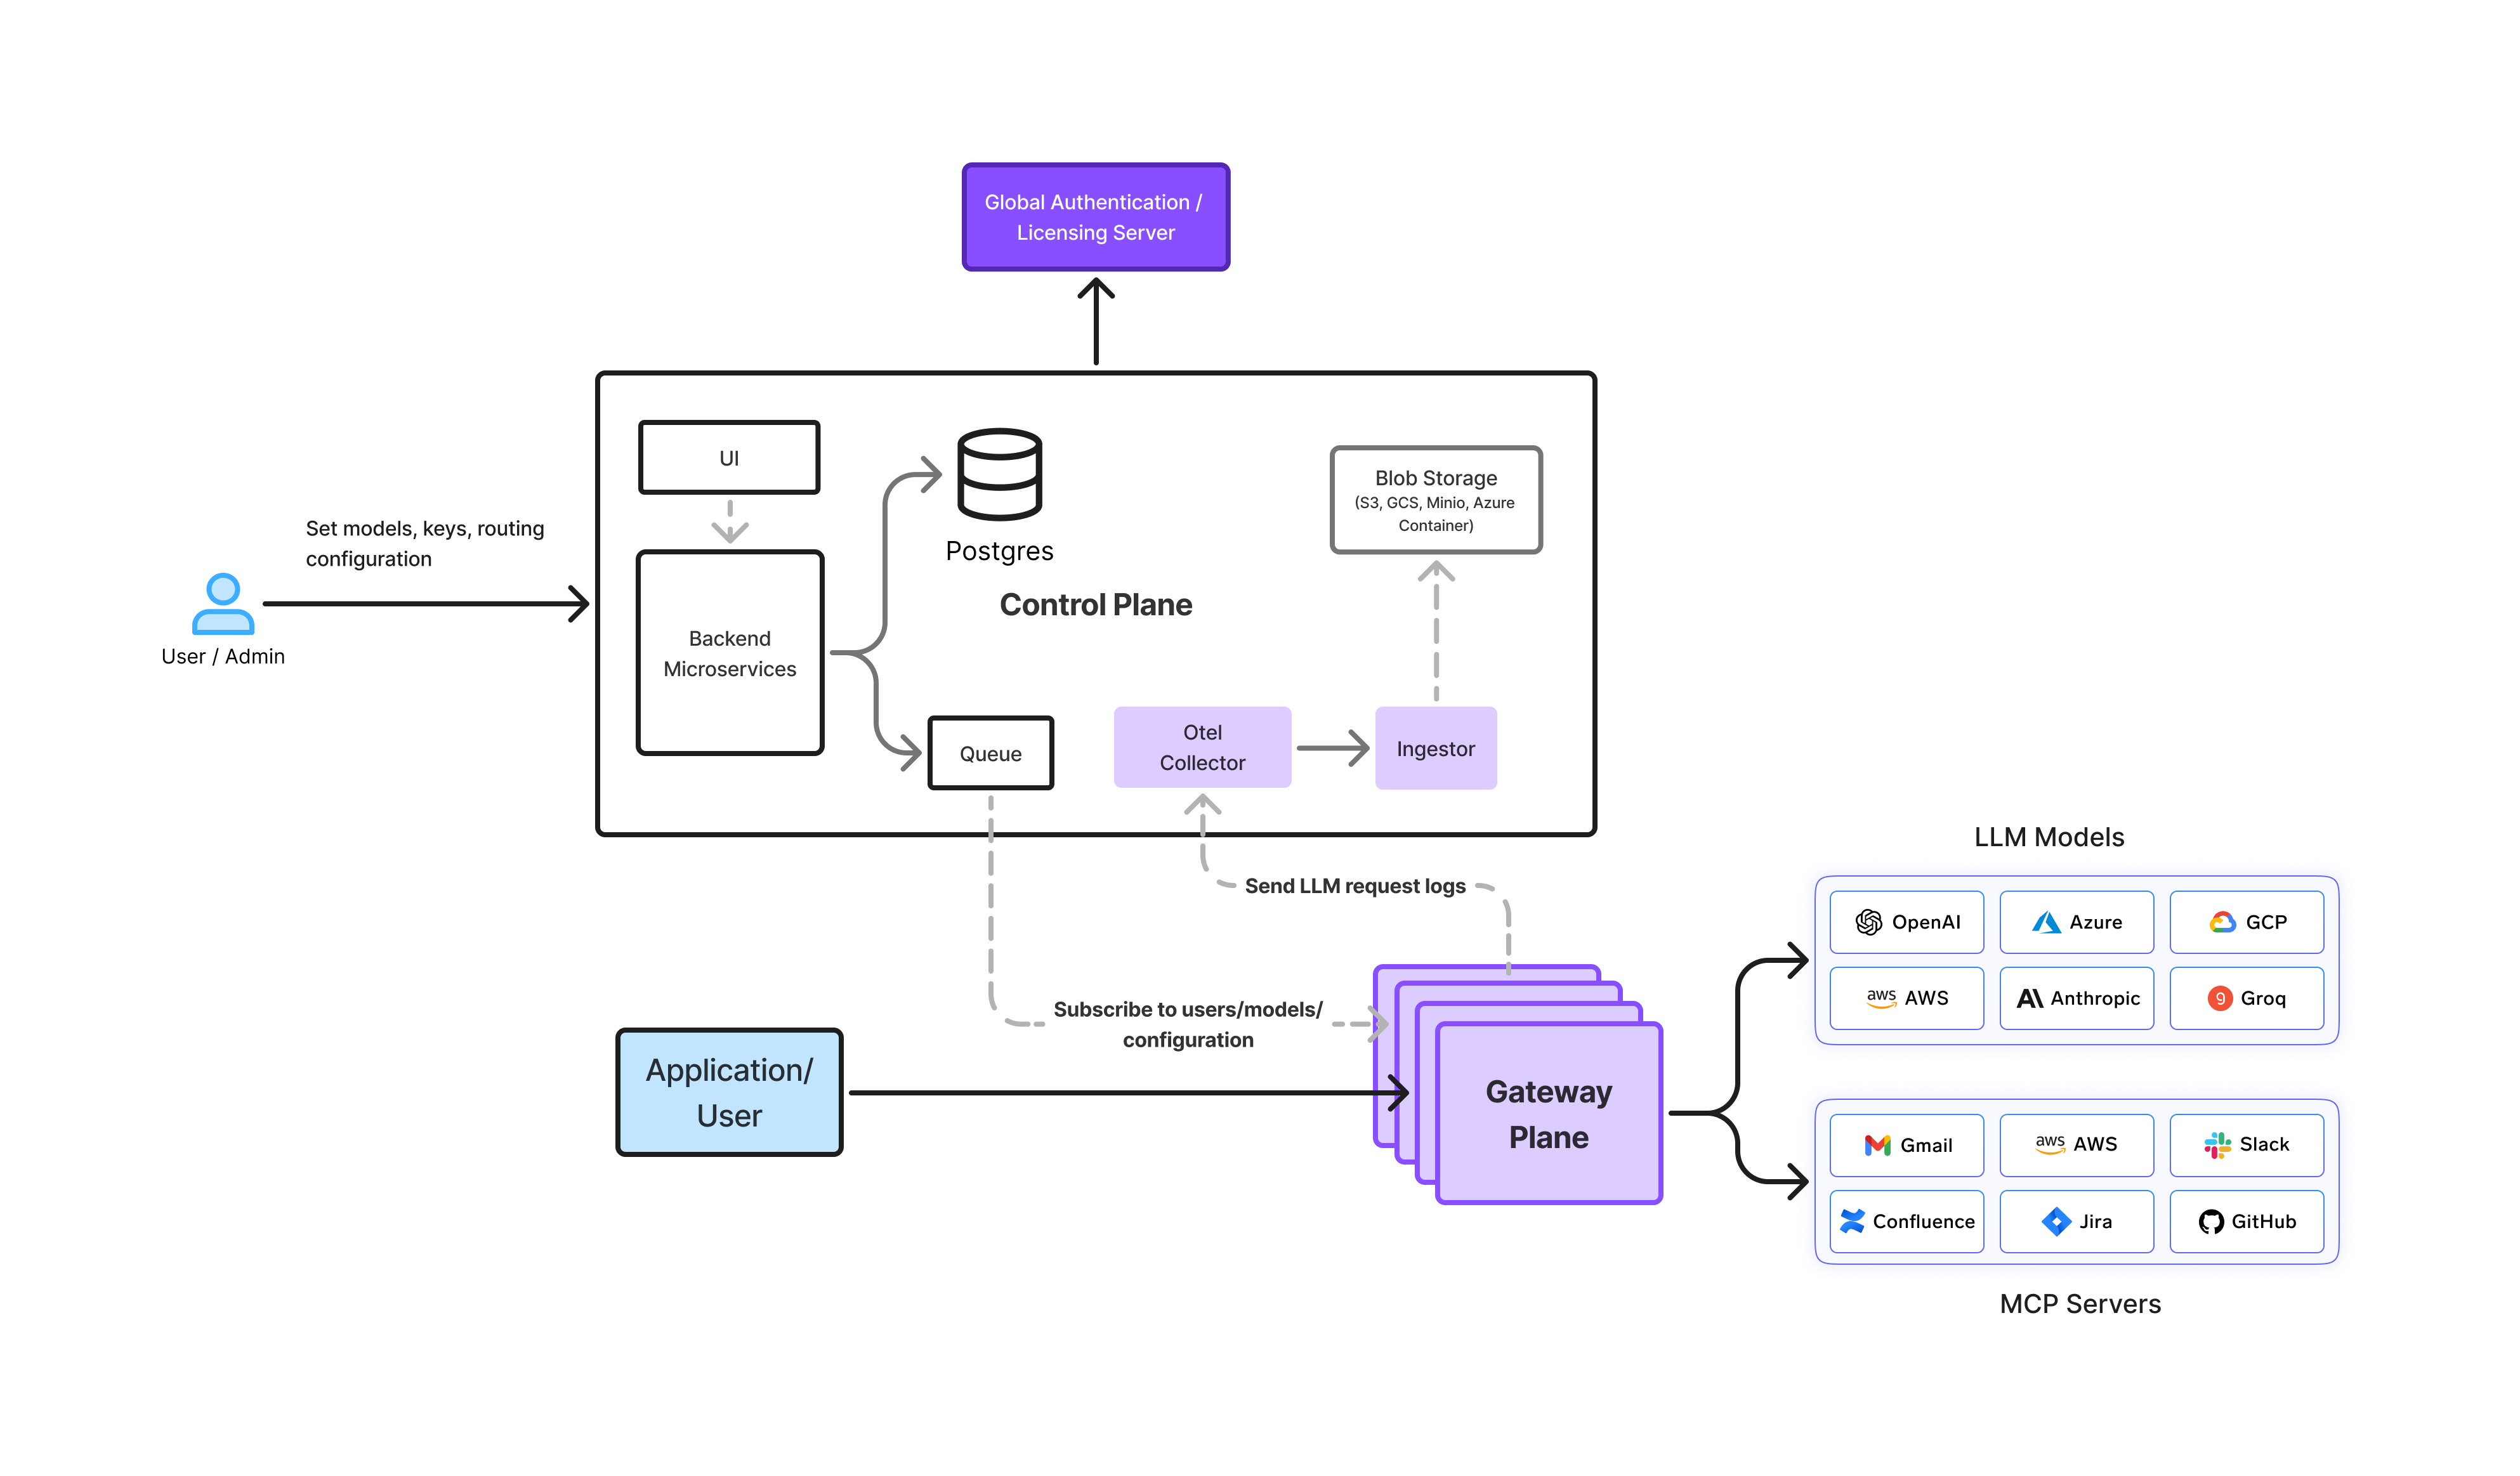
TrueFoundryの構成では、OpenCodeは基盤となるLLMプロバイダーと直接やり取りしません。代わりに、すべてのリクエストはAI Gatewayを経由し、推論のための単一で一貫したインターフェースを提供します。
アーキテクチャ上、これにより以下が可能になります:
個々のツールから直接的なモデルアクセスを排除することで、プラットフォームチームは、開発者、エージェント、自動化全体でOpenCodeが実際にどのように使用されているかを完全に可視化できます。
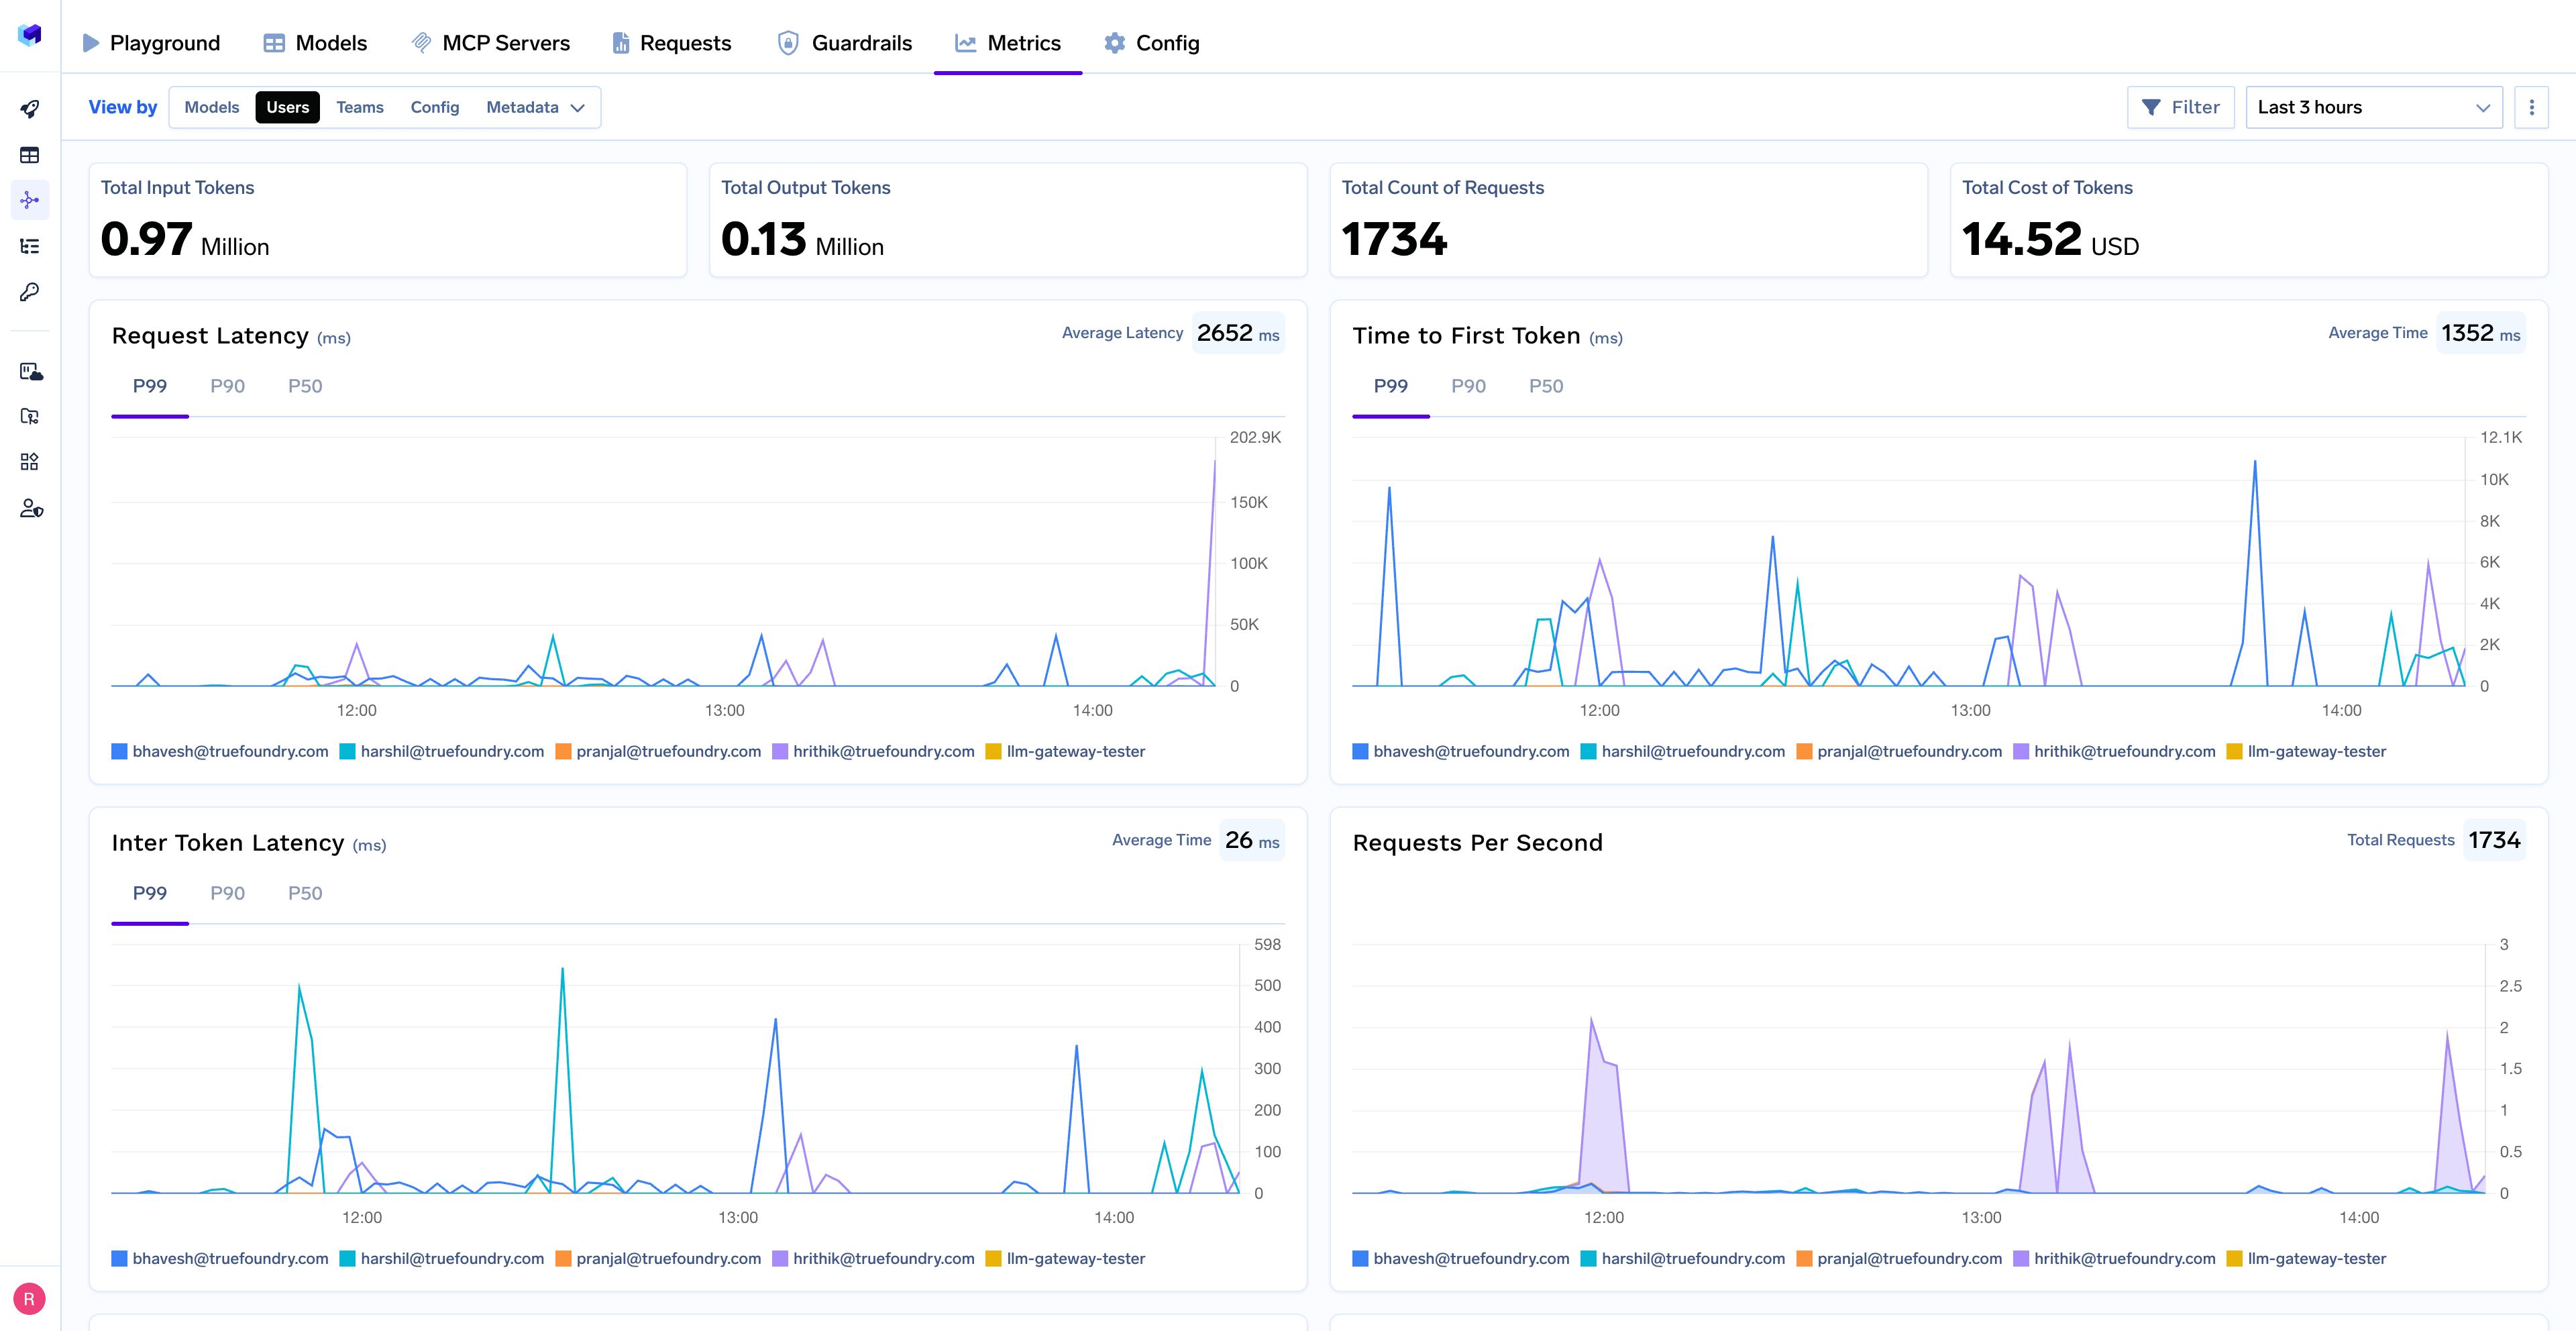
TrueFoundryのAI Gatewayは、以下を含むリクエストレベルでのToken使用量を取得します:
重要なのは、このテレメトリがベンダー管理のシステムに閉じ込められないことです。ログとメトリクスは顧客自身のクラウドとストレージに保持されるため、チームは以下を行うことができます:
これにより、AIツールによくある「ブラックボックス」問題を回避し、長期的な最適化が可能になります。
すべてのOpenCodeトラフィックがゲートウェイを通過するため、コスト管理を一貫してリアルタイムで適用できます。
プラットフォームチームは以下を行うことができます:
これらのポリシーはゲートウェイで一度適用され、エディタ、プラグイン、または内部ツールを変更することなく、すべてのOpenCode駆動ワークフローに自動的に適用されます。
TrueFoundryのアーキテクチャは、OpenCodeの使用がIDEを超えて広がる環境向けに設計されています。CIパイプライン、バックグラウンドジョブ、エージェントは、多くの場合、最も大きく最も見えにくいToken消費を生成します。
これらのワークロードを同じAI Gateway経由でルーティングすることにより、チームは以下が可能になります:
これにより、予測可能性やコントロールを失うことなく、組織全体でOpenCodeの使用量をスケールさせることができます。
OpenCodeのToken使用量は、AI支援コーディングの実質的なスケーリング制約です。使用量が開発者、リポジトリ、自動化、エージェント全体に広がるにつれ、Token消費は中央集権的な可視性とガバナンスなしには予測および制御が困難になります。
これをツールやアプリケーションレベルで管理することはスケールしません。Token使用量には、リクエストレベルの可視性、明確な帰属、およびリアルタイムの適用が必要であり、AI支援コーディングを孤立した機能ではなく共有インフラストラクチャとして扱う必要があります。
TrueFoundryのようなプラットフォームは、AI Gatewayを通じてOpenCodeトラフィックを中央集権化し、チームがToken使用量を一貫して監視、管理、最適化できるようにすることで、このアプローチを反映しています。プラットフォームおよびエンジニアリングのリーダーにとってのポイントはシンプルです。OpenCodeがソフトウェア構築の核心であるなら、Token使用量は他の重要なインフラリソースと同じ厳格さで管理されなければなりません。
OpenCodeのToken使用量を正確に確認するには、リクエストレベルでの明示的な追跡とインストゥルメンテーションが必要です。ツールはモデルに送信される全体のコンテキストを抽象化することが多いため、タスク、開発者、ワークフローごとの実際のToken消費量を可視化することは、コストを予測し使用量を効果的に最適化するために非常に重要です。
OpenCode Token使用量は、OpenCodeのようなAI支援コーディングツールのTokenベースの従量課金モデルです。入力プロンプトやコードコンテキストから、生成されたコードや説明に至るまで、すべてのやり取りがTokenを消費します。米国での開発チームにとって主要なコスト要因となるため、このOpenCode Token使用量を管理することが極めて重要です。
OpenCodeのToken使用量を減らすには、コンテキストの注入を必須ファイルのみに限定し、広範なリポジトリを含めないようにします。反復間で出力を知的に再利用することで、重複したコンテキストの再ロードを防止します。複雑なタスクを小さなステップに分解し、正確なプロンプトを使用します。タスクごとのToken消費量を監視することで、コストと効率を最適化するための重要なインサイトが得られます。
プロンプトの長さを最適化し、不要なコンテキストを制限し、タスクに適したモデルを使用することで、OpenCodeのToken使用量を削減できます。大きなプロンプト、長い会話履歴、過度なコードコンテキストは、Token消費量を大幅に増加させる可能性があります。使用パターンを定期的に見直すことで、効率を向上させコストを削減する機会を特定できます。
OpenCodeでのToken使用量を増加させる要因には、以下のものがあります:
これらの要因を理解することで、チームはAIの利用を最適化し、支出をより効果的に管理できるようになります。
組織は通常、中央集権的なダッシュボード、アナリティクスツール、またはAI Gatewayプラットフォームを通じてToken使用量を監視します。これらのソリューションは、ユーザー、チーム、アプリケーション、モデル全体でのToken消費の可視性を提供し、組織が支出を追跡し、異常を特定し、AI予算をより効果的に配分するのに役立ちます。
チームレベルでToken使用量を監視することで、最適化の機会を特定し、予期せぬコスト増加を防ぐことも容易になります。
はい。AI Gatewayは、使用パターンの可視化、予算とレート制限の適用、インテリジェントなモデルルーティングの有効化により、組織がToken消費を最適化するのに役立ちます。
例えば、AI Gatewayは、より単純なリクエストを低コストのモデルに自動的にルーティングする一方で、プレミアムモデルをより複雑なタスク用に確保することができます。使用量のアナリティクスとガバナンスコントロールを組み合わせることで、パフォーマンスと信頼性を維持しながらAIコストを削減できます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























