


October 19, 2026
|
5 min read

Published: October 6, 2026
Blazingly fast way to build, track and deploy your models!
AIは常に意思決定を行っています。エージェントは顧客と直接対話し、リクエストをルーティングし、ツールを実行し、実際にコストを発生させています。システムは稼働していますが、その内部で実際に何が起きているのか、ほとんど把握できていないのが現状ではないでしょうか。
これはチームの能力不足を指摘しているわけではありません。AIを大規模に運用する上での現実です。データはトレース、設定、ログの中に存在していますが、それらにアクセスするには、どこを見るべきか、何をフィルタリングすべきか、そして複数の画面にまたがる情報をどう関連付けるかを正確に把握しておく必要があります。すべてが順調なときは意識しませんが、何かが壊れた途端、監視ダッシュボード、ガードレールの設定、ルーティングルール、ドキュメントの間を行き来し、問題が深刻化する前に原因を突き止めようと奔走することになります。
多くのチームが現在直面しているのがこの状況です。そして、それは 疲弊を招きます。
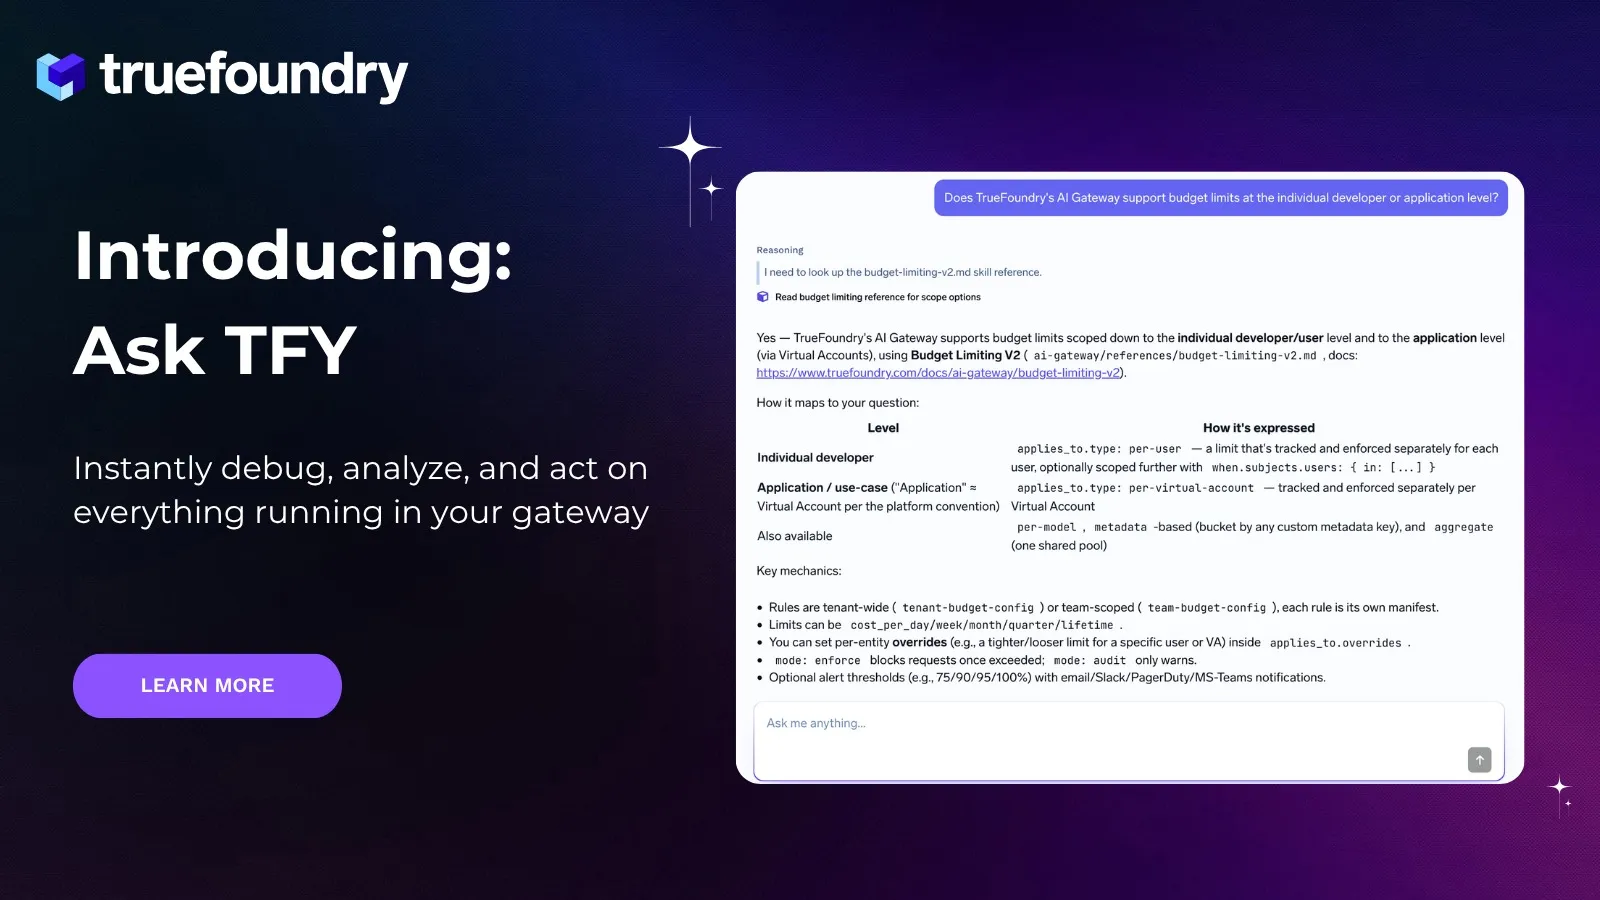
Ask TFYは、TrueFoundry上のAIゲートウェイと対話するための新しい手段です。これは単なる検索バーや、ドキュメントを読み上げるだけのチャットボットではありません。TrueFoundry内に構築されたエージェントであり、モデル、トレース、MCPサーバー、ガードレールの設定、予算ルール、データアクセス権限など、ゲートウェイ内で実行されているすべての情報にリアルタイムでアクセスできます。質問を投げかければ、システムで今まさに起きていることに基づいた回答が返ってきます。
よくあるシナリオを想像してみてください。アプリケーションでエラーが発生し始めました。モデルの問題なのか、ルーティングの問題なのか、予算上限に達したのか、あるいは全く別の原因なのか分かりません。そこで、手動でトレースをフィルタリングし、パターンを探し、設定を一つずつ確認するという作業を始めることになります。
Ask TFYを使えば、問題を言葉で説明するだけで済みます。
「過去7日間、アプリケーションで断続的にエラーが発生しています。何が原因ですか?」
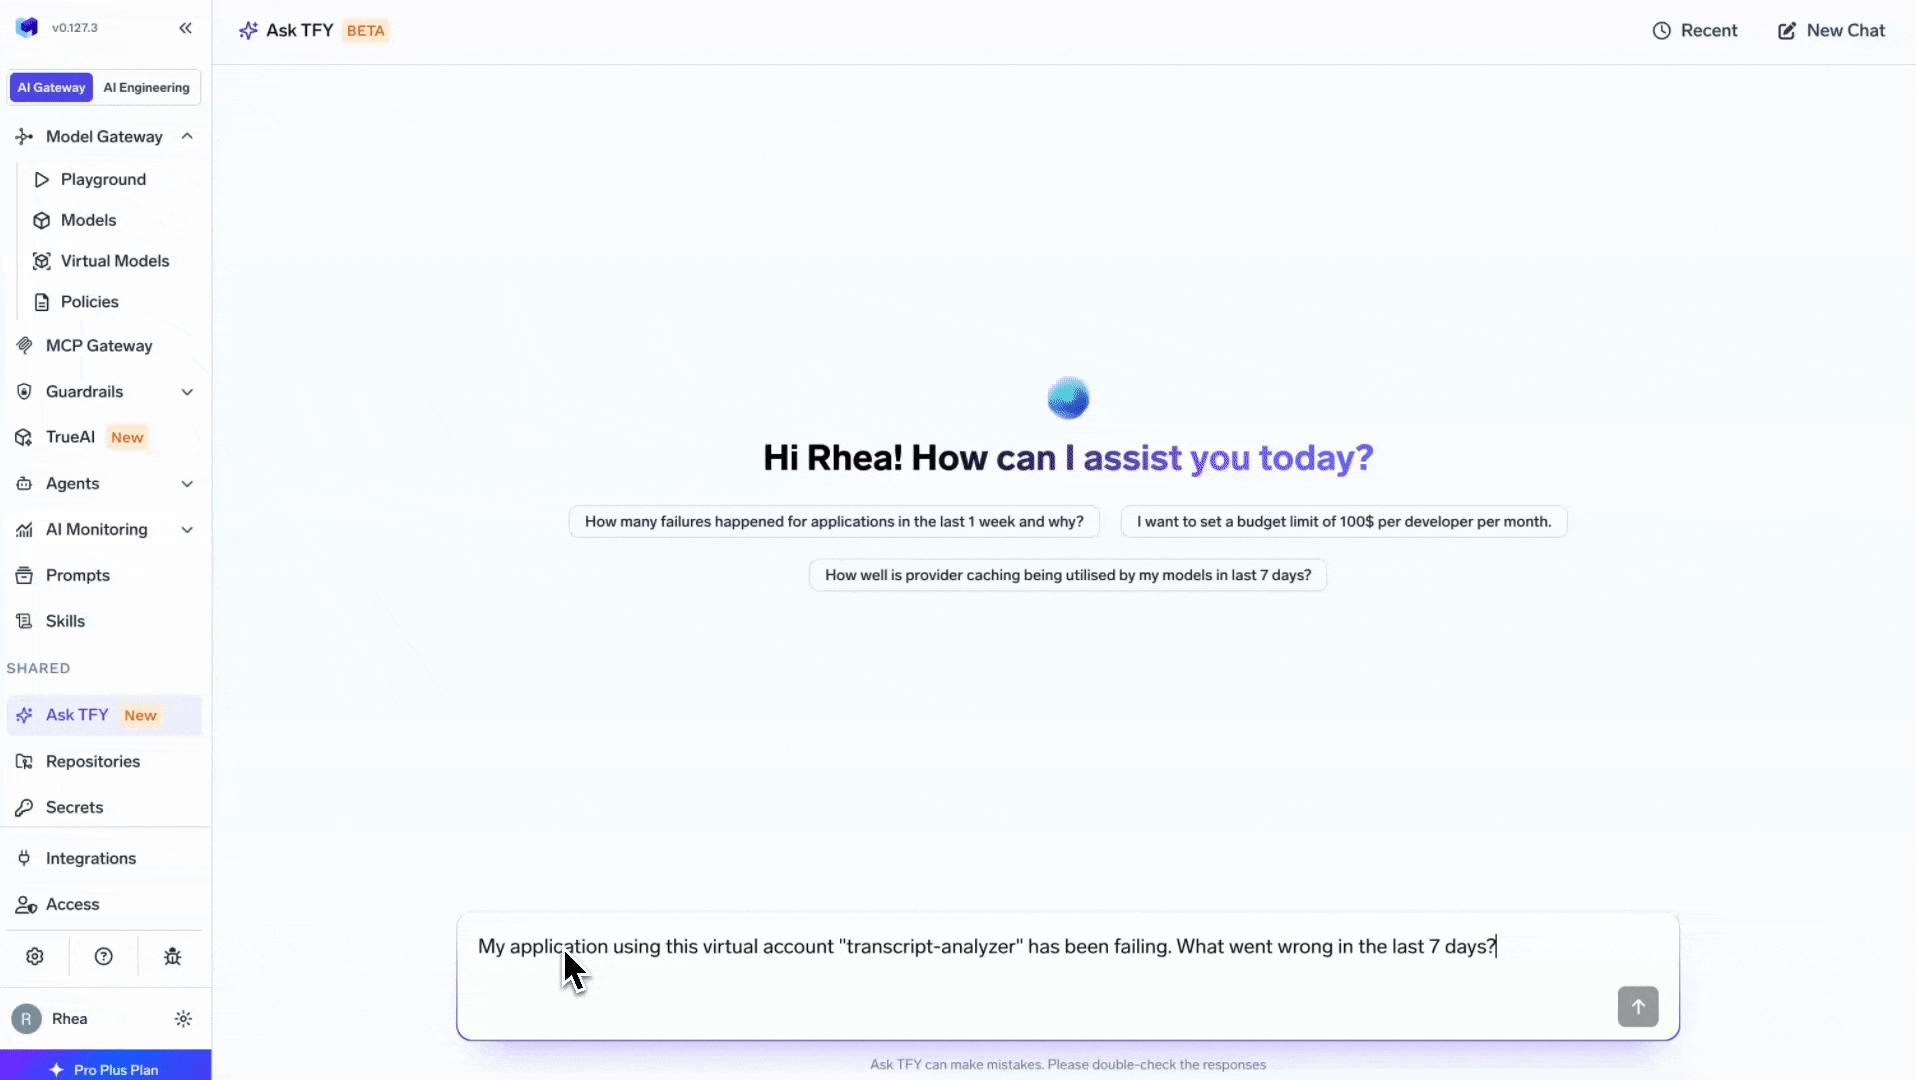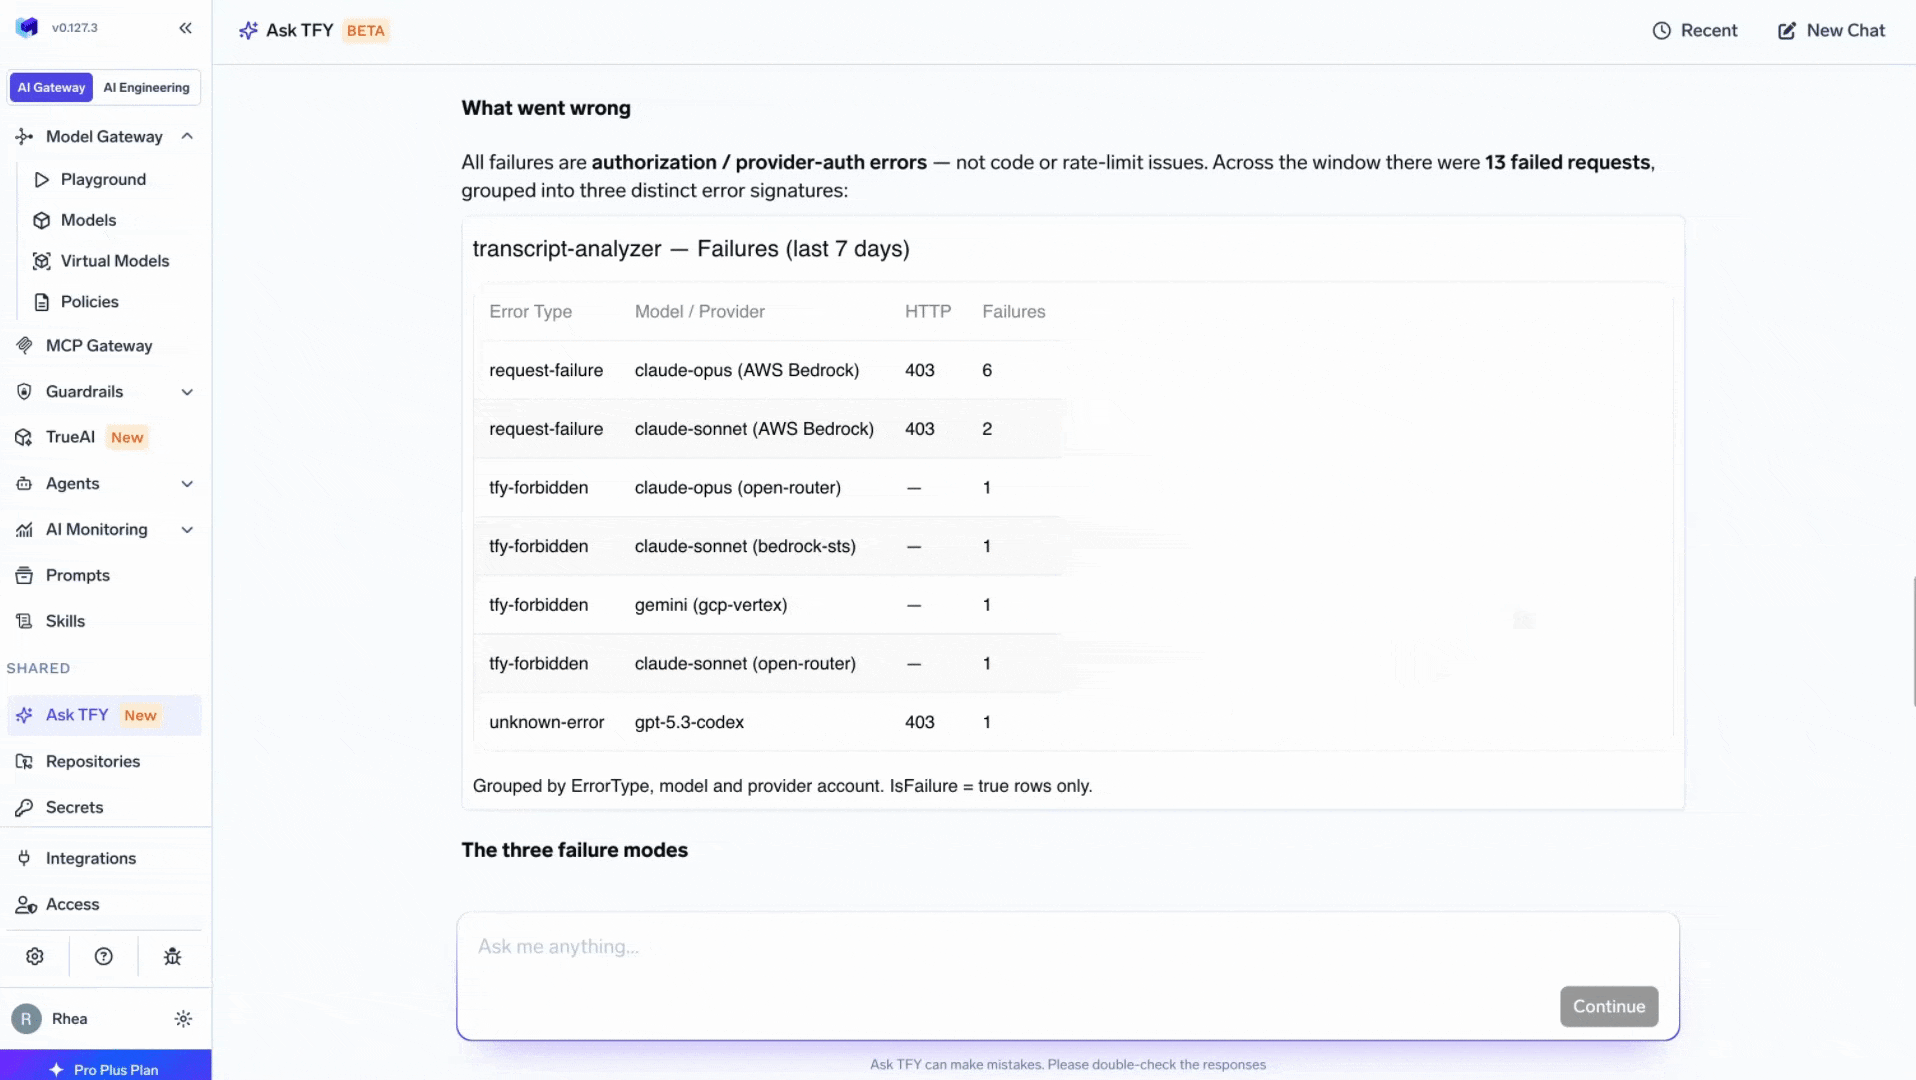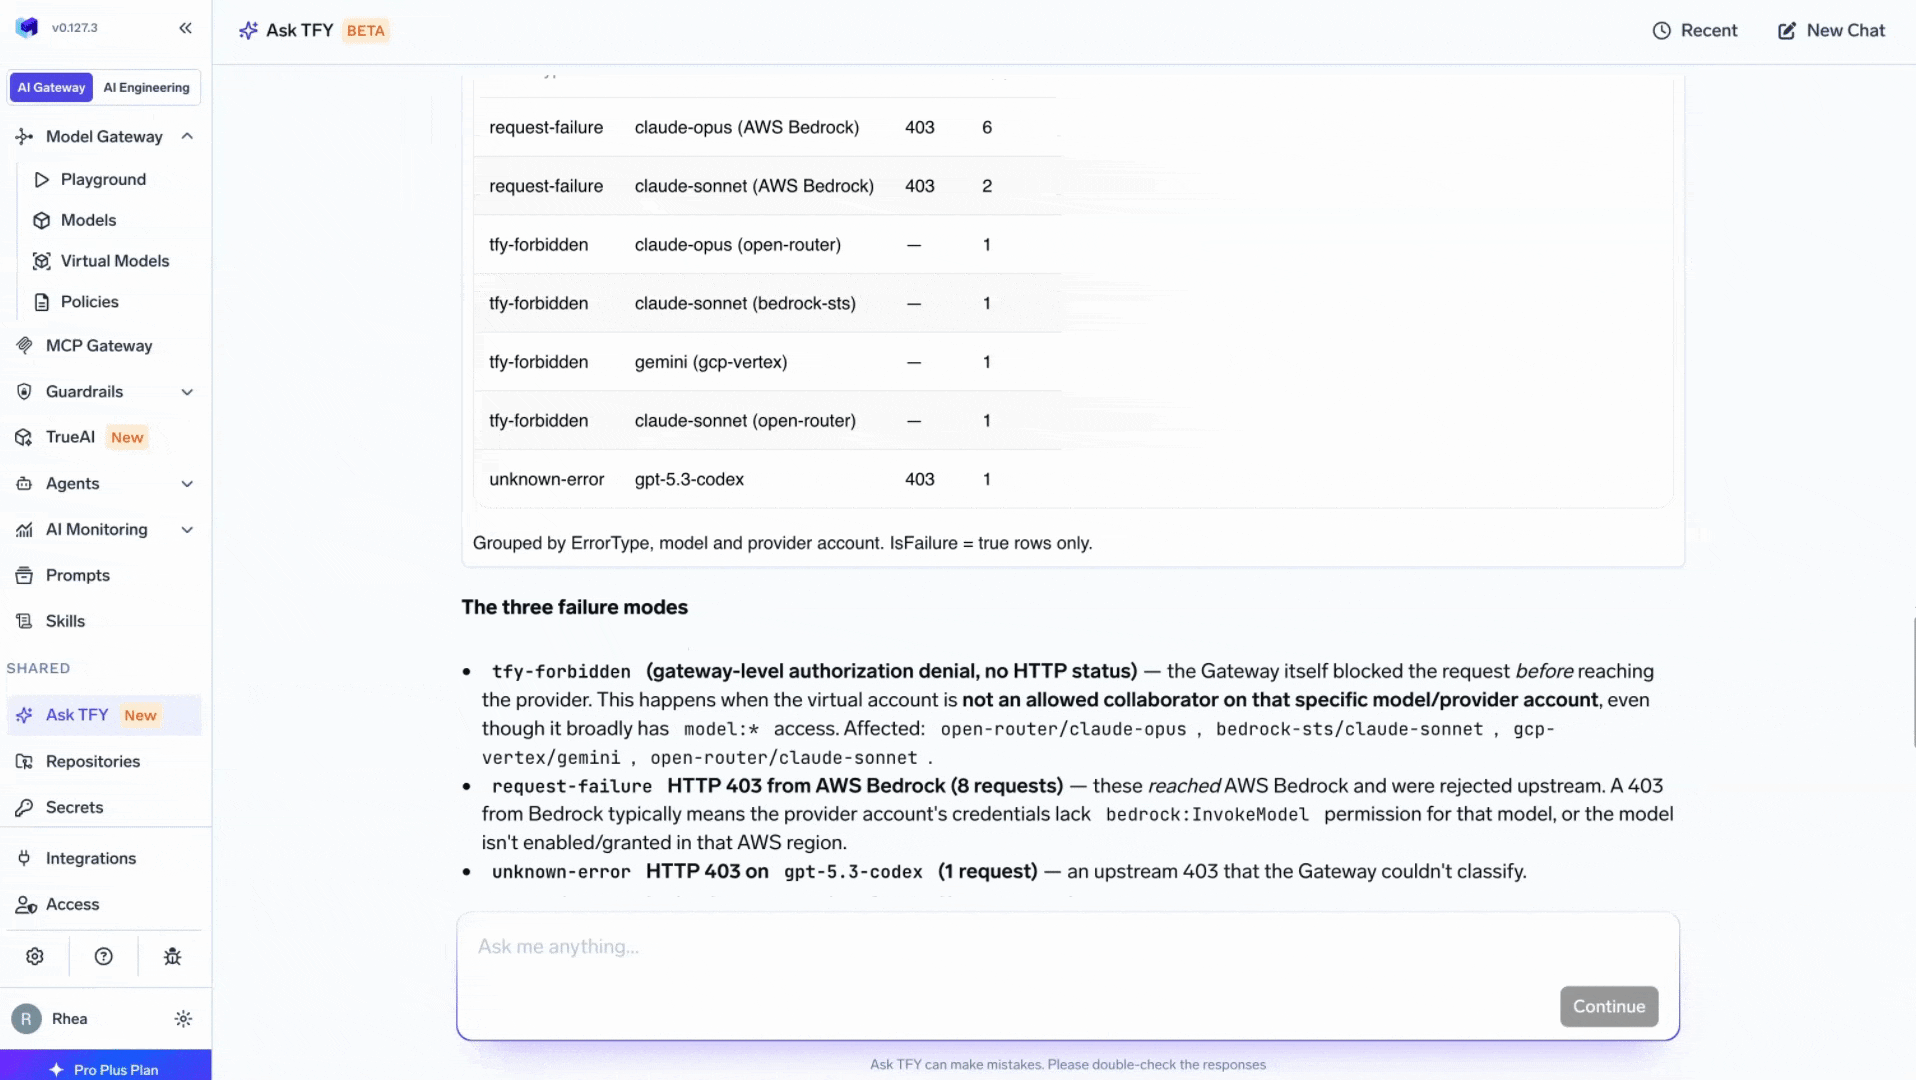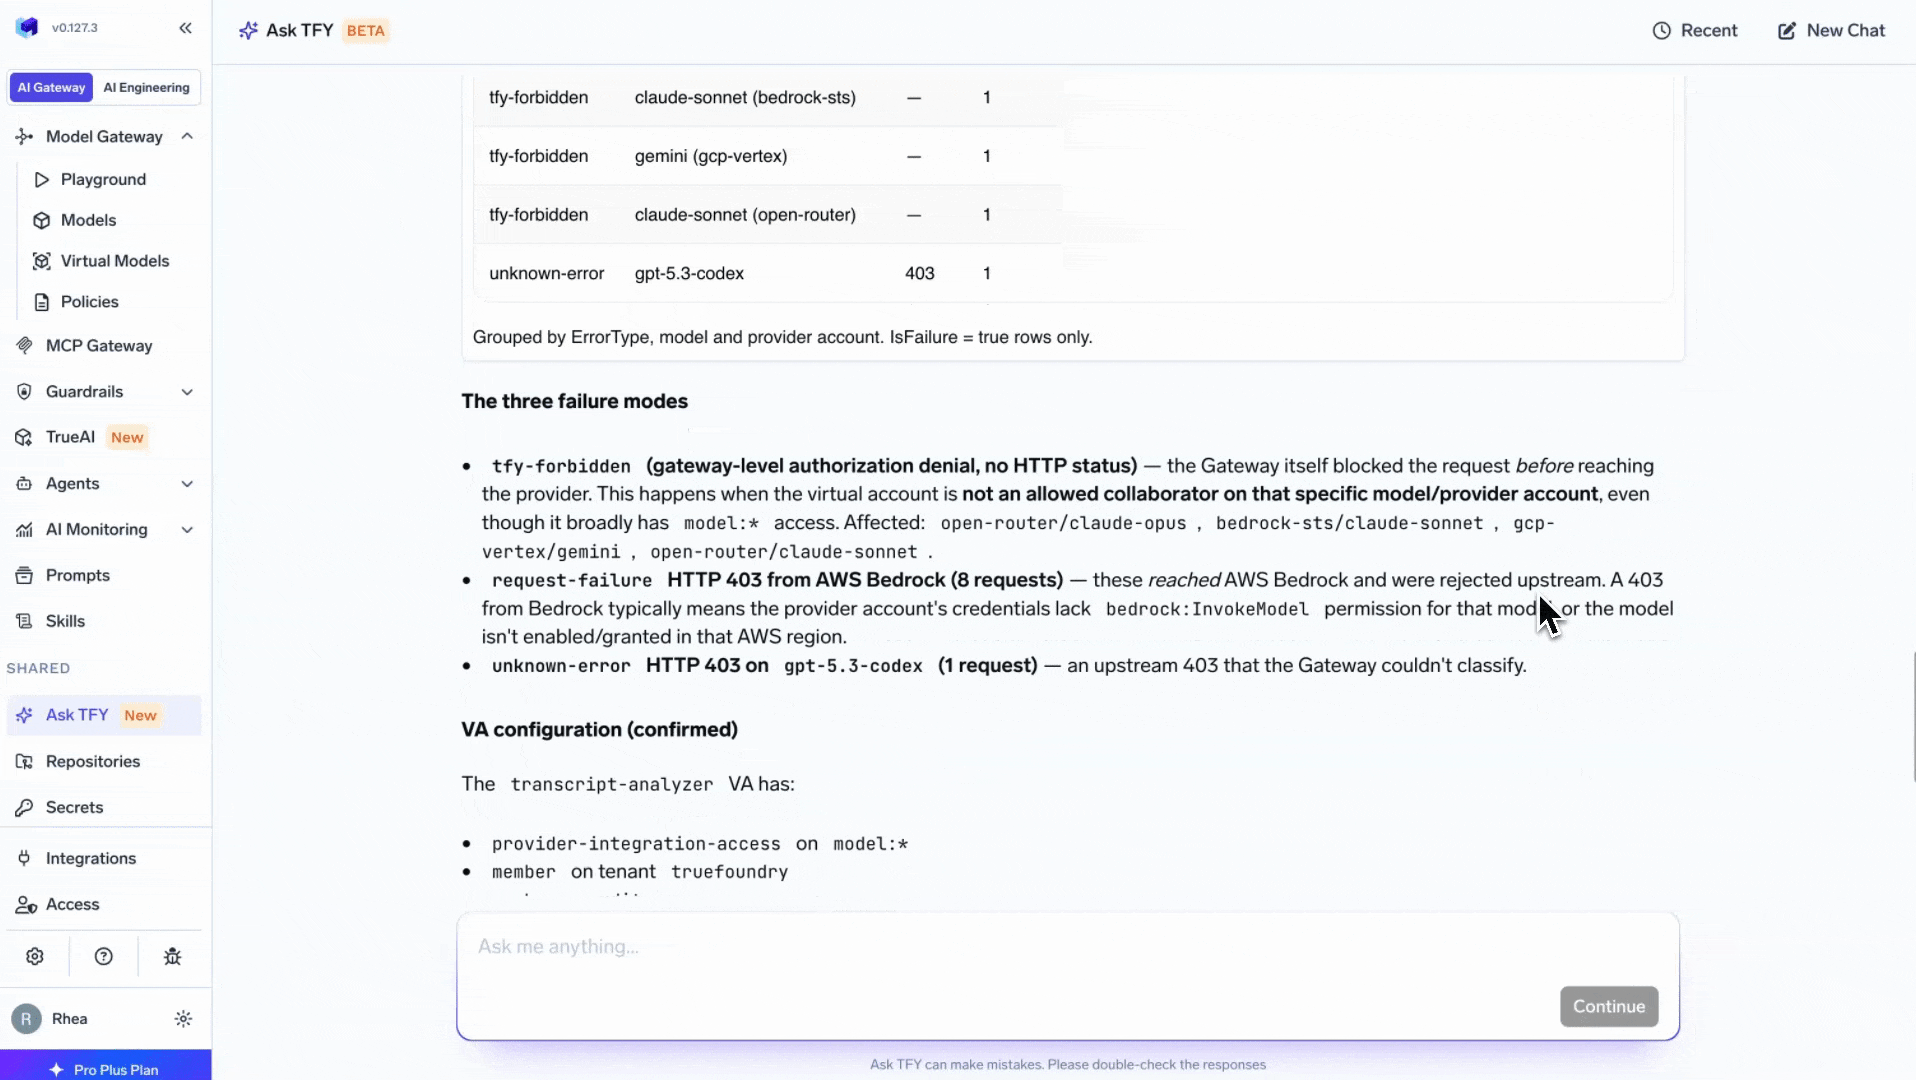
Ask TFYはトレース履歴を分析し、エラーを分類します。障害がクライアントサイドによるものか、アップストリームのモデルプロバイダーのダウンによるものかを特定し、パターンを提示します。何が壊れたのか、なぜ壊れたのかを、抽象的ではなく具体的に教えてくれます。そして、どう対処すべきかも提案します。
「これをより強固にするために、設定をどう修正すればいいですか?」
あなたの環境に最適な解決策を推奨します。例えば、フォールバック付きの仮想モデルを設定することや、ルーティングルールを調整することなどが考えられます。システムを熟知しているため、一般的なトラブルシューティングガイドではなく、実際に適用可能な回答を提供します。
さらに、その推奨事項に基づいて直接実行させることも可能です。
「推奨された予算とフォールバック設定を、そのエージェントに適用して。」
これだけです。一つの画面から離れることなく、3つの質問をするだけで問題は解決します。YAMLをコピーして別の画面に貼り付けたり、タブを切り替えたりする必要はありません。
デバッグはもちろんですが、Ask TFYは一見問題がないように見える時こそ真価を発揮します。本番環境において最もコストがかさむのは、リソースを密かに浪費したり、誰かが気づく前にセキュリティリスクを生じさせたりするような、目に見えにくい問題です。
例えば、プロバイダーレベルのプロンプトキャッシュが実際にどれほど活用されているかを問いかけてみてください。単に数値を示すだけでなく、どのリクエストがキャッシュから漏れているのか、どこにキャッシュブロックを追加すれば解決できるのかを具体的に提示します。熟練のエンジニアが手作業で抽出するのに1時間かかるようなインサイトも、請求書が届くまで緊急性が低いと判断され、見過ごされがちです。
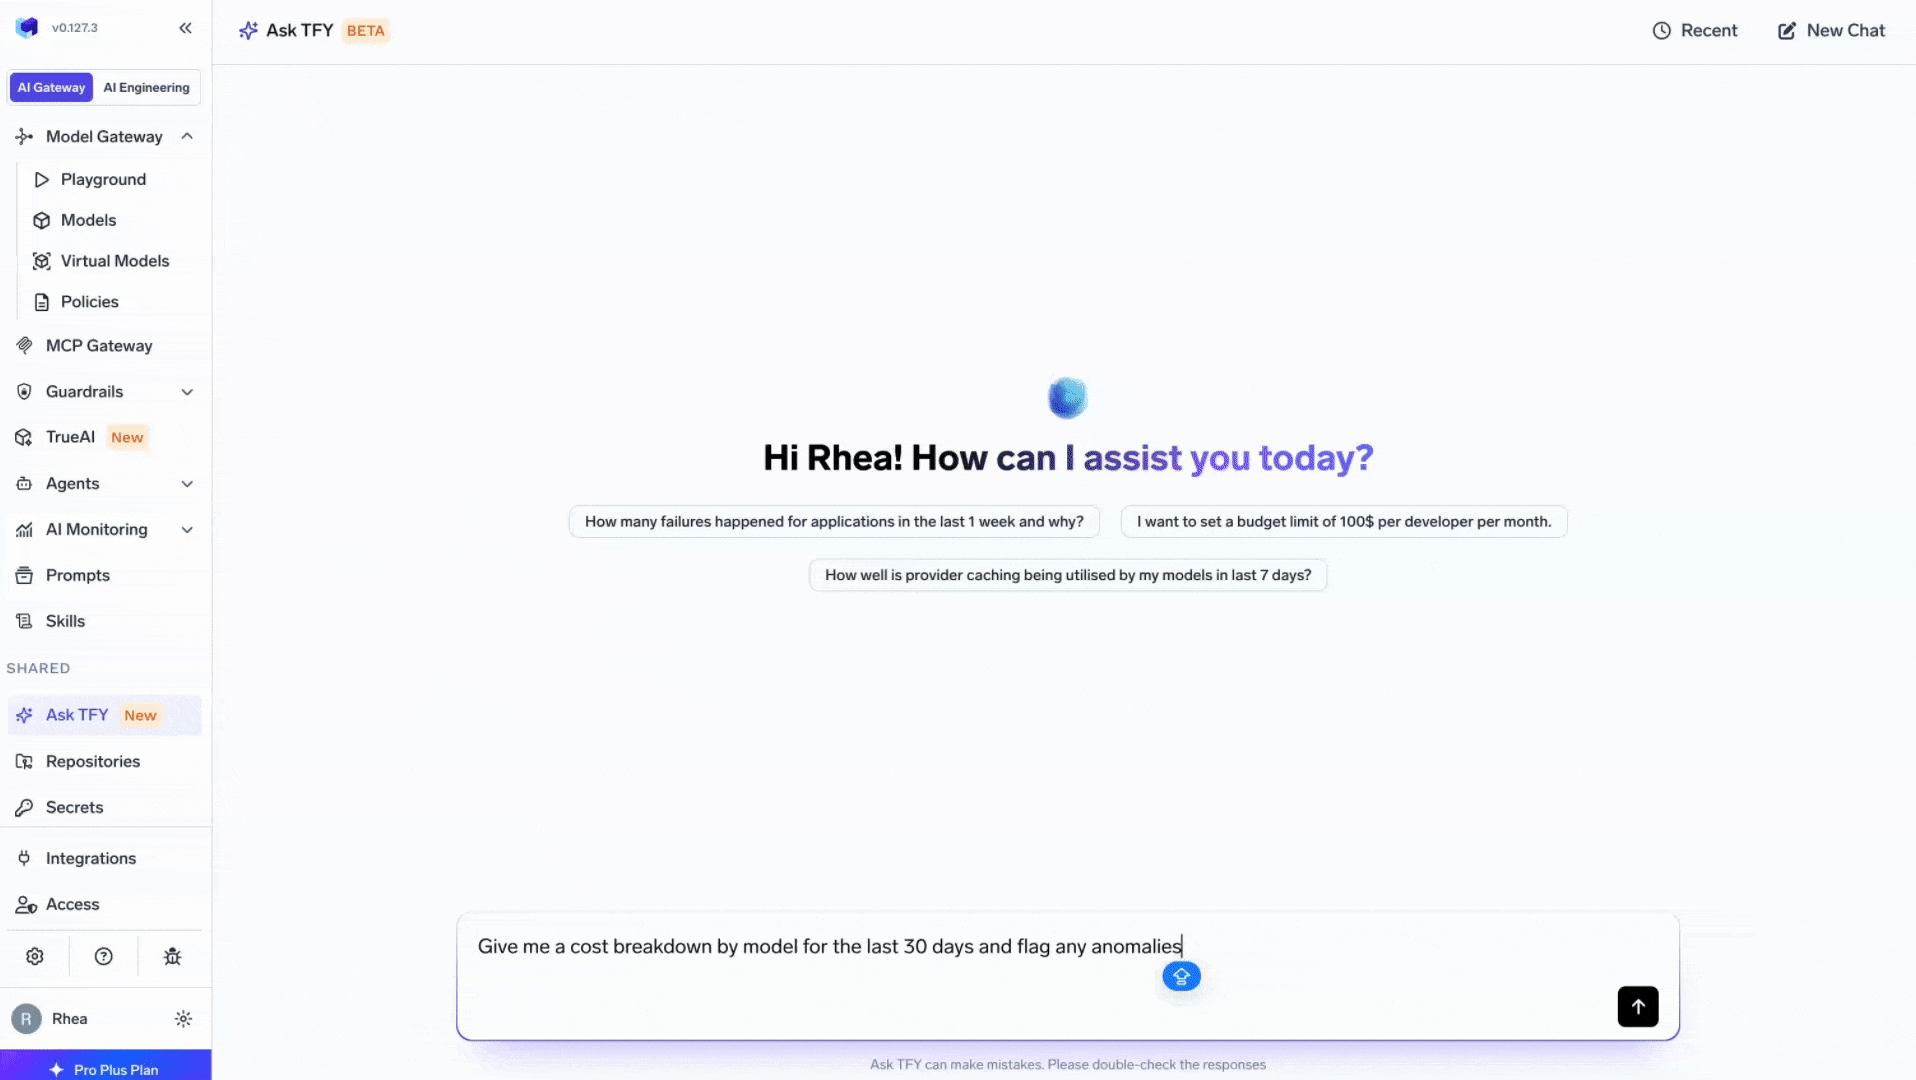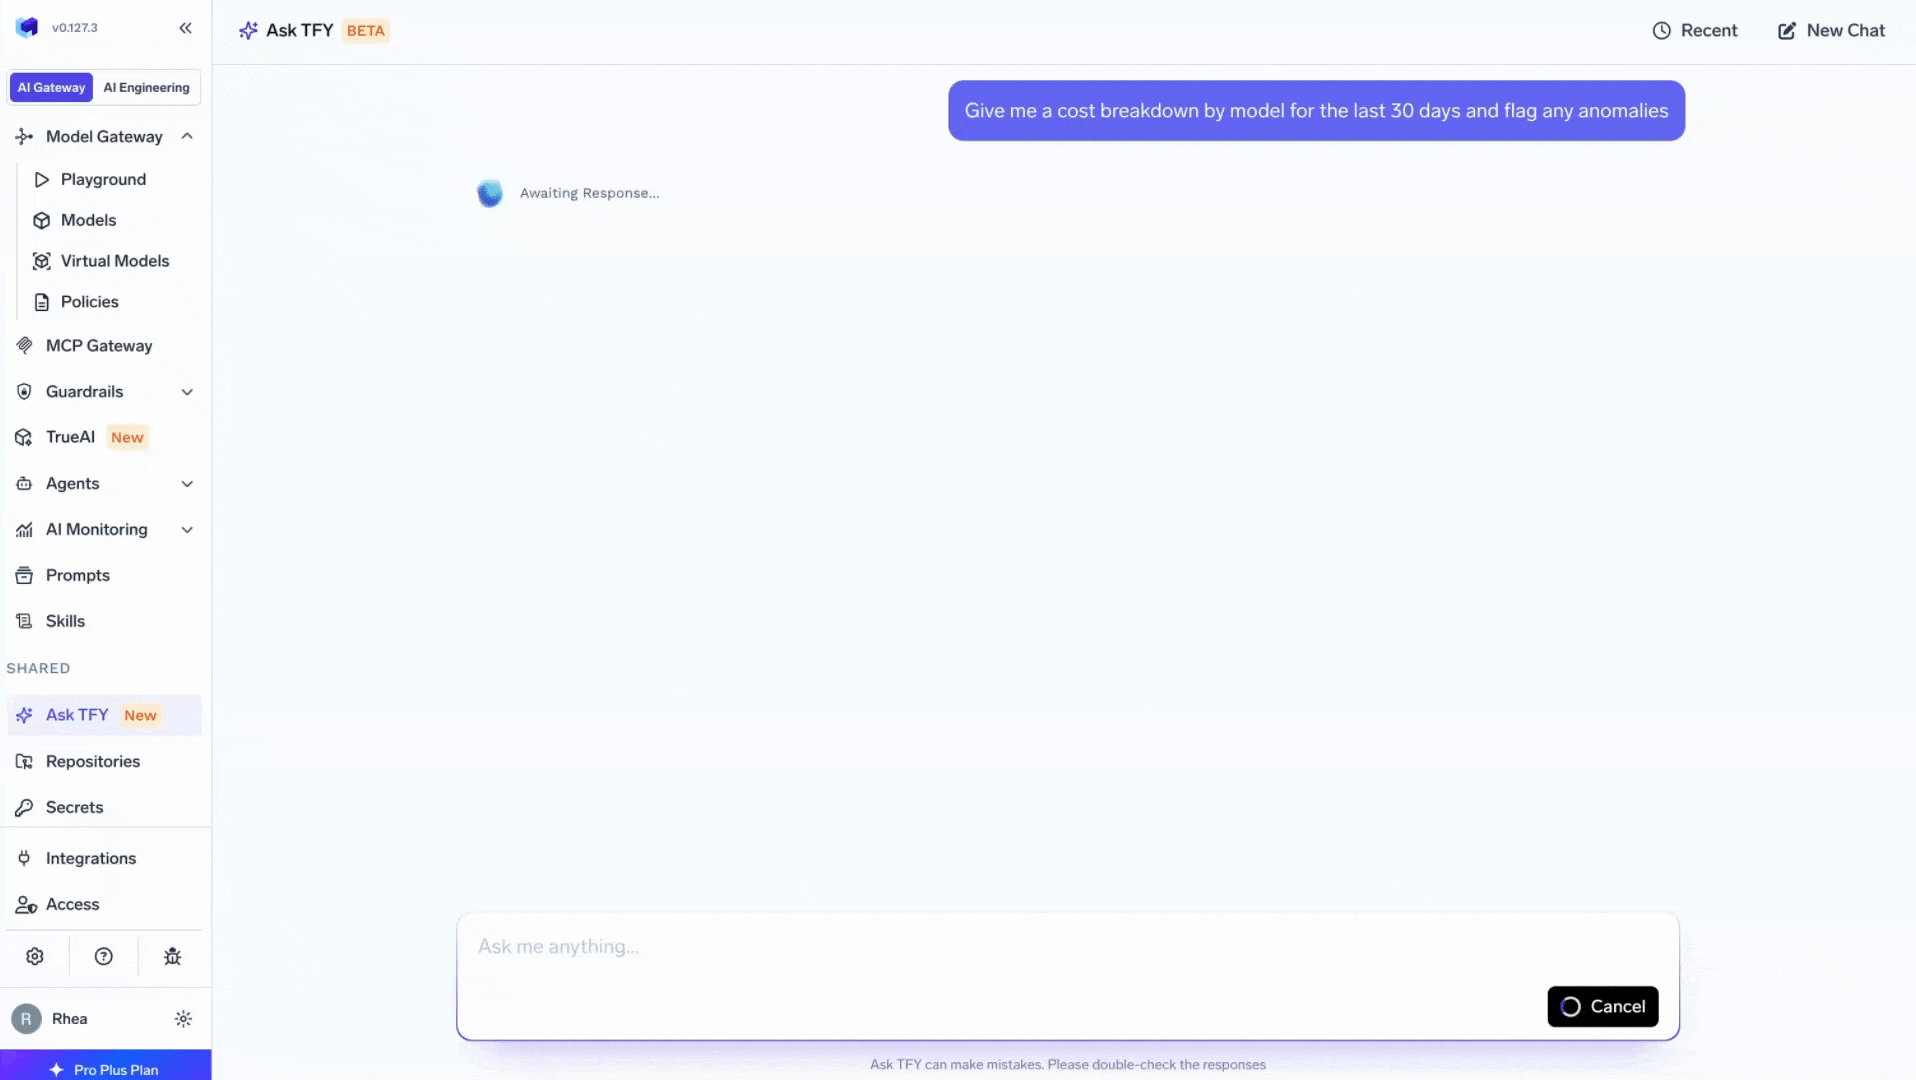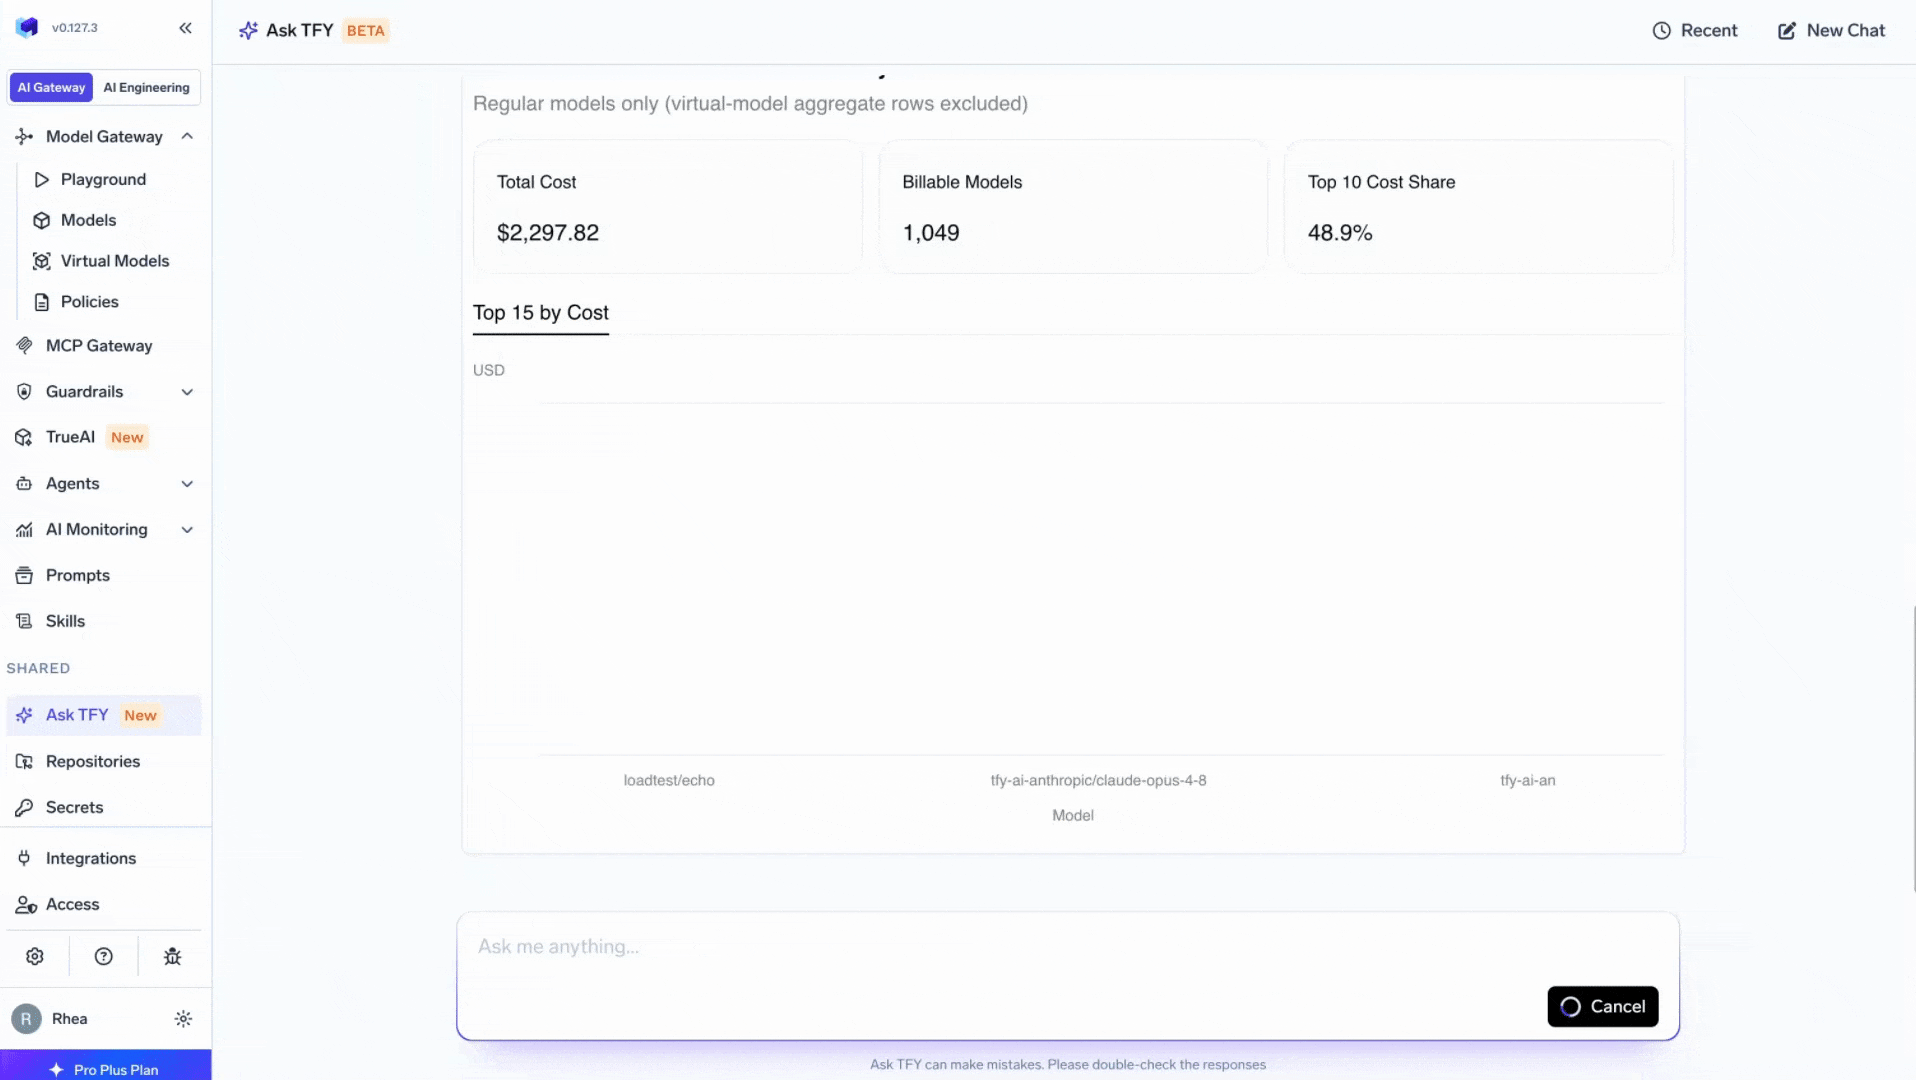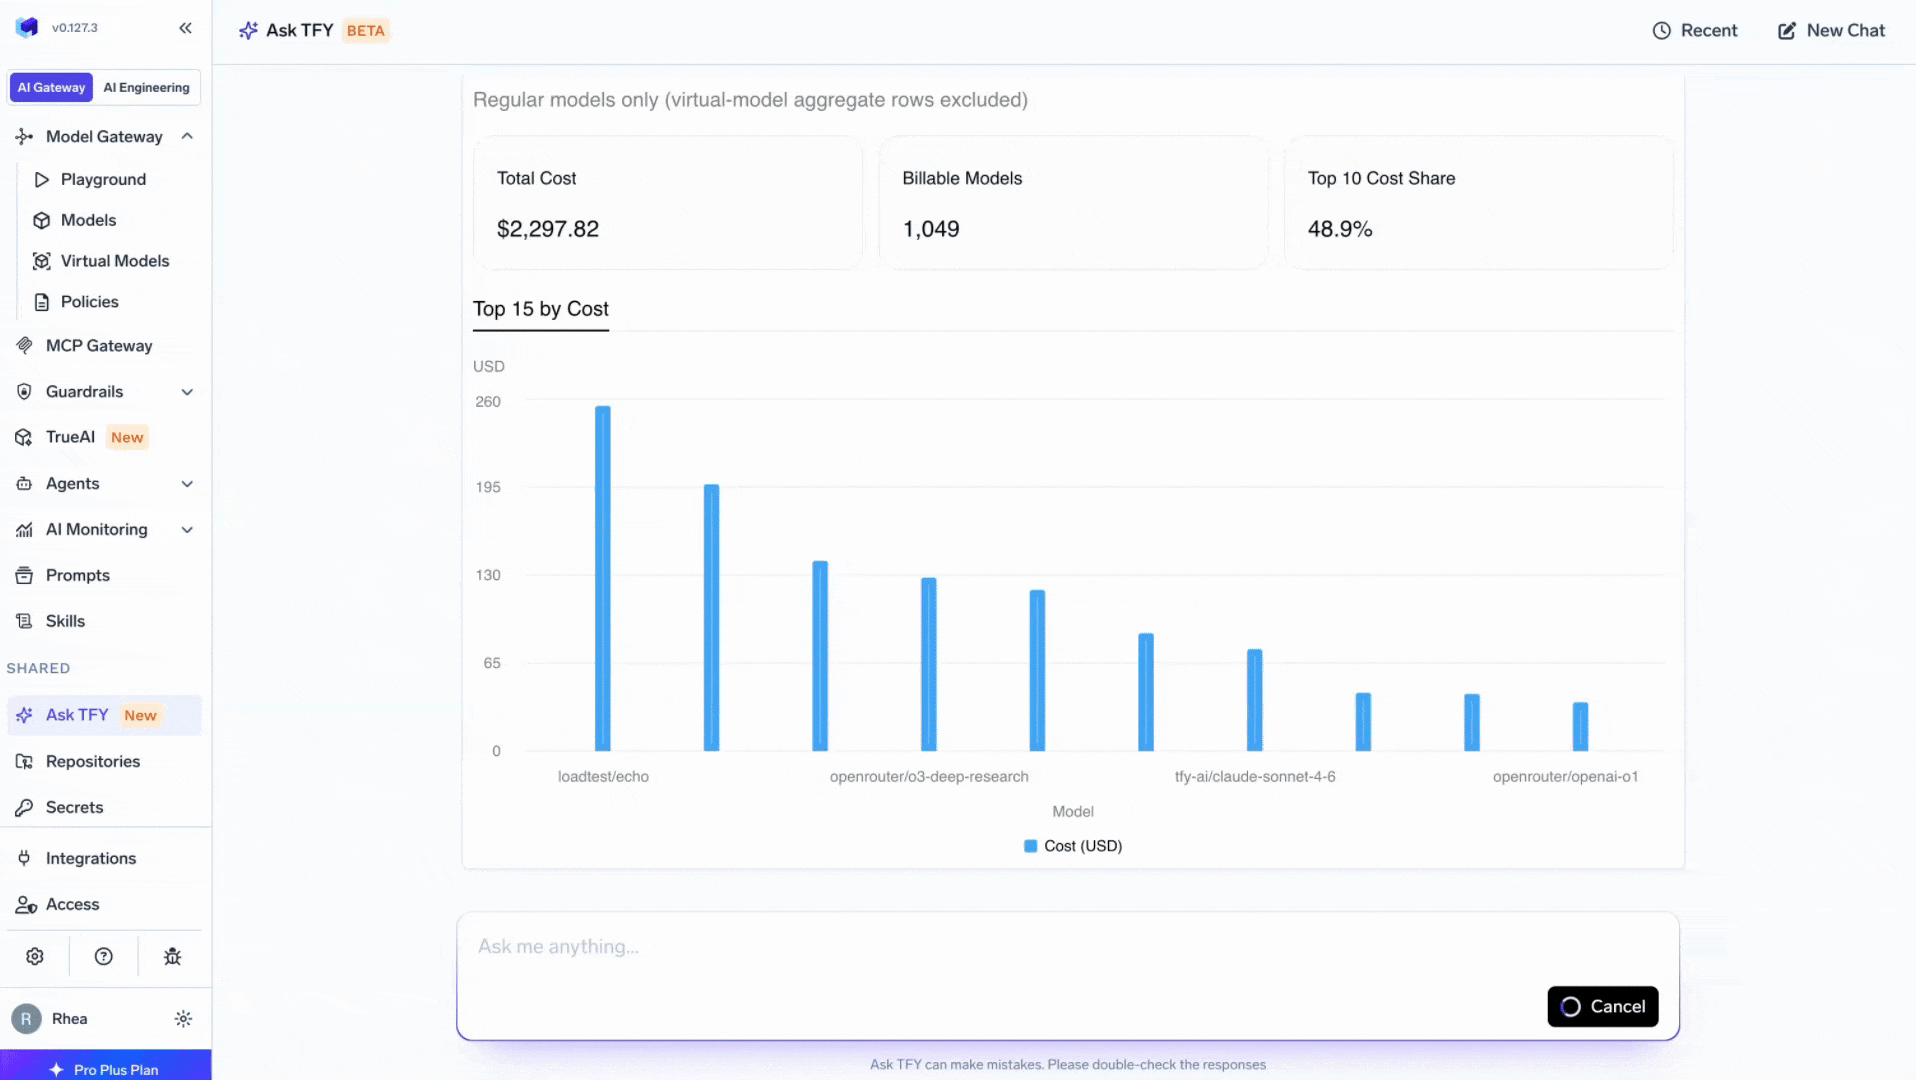
コストについても同様です。期間を指定し、開発者別、アプリケーション別、モデル別など、分析したい切り口を伝えるだけで、分析結果を生成し、そのまま適用可能な予算構成案を提案します。
AI運用において本当に重要な問いは、標準的なダッシュボードでは答えられないことがほとんどです。従来の可観測性ツールは「何が起きたか」を表示するだけですが、Ask TFYは「なぜ起きたのか」を理解し、次に何をすべきかを判断し、さらに会話を中断することなくその場で実行までサポートします。
タブを切り替えてコンテキストを再構築したり、手作業で情報を照らし合わせたり、監視で見つけた問題を構成変更に反映させるために頭を悩ませる必要はありません。Ask TFYはすべての情報を統合し、あなたに代わって横断的に処理を行います。
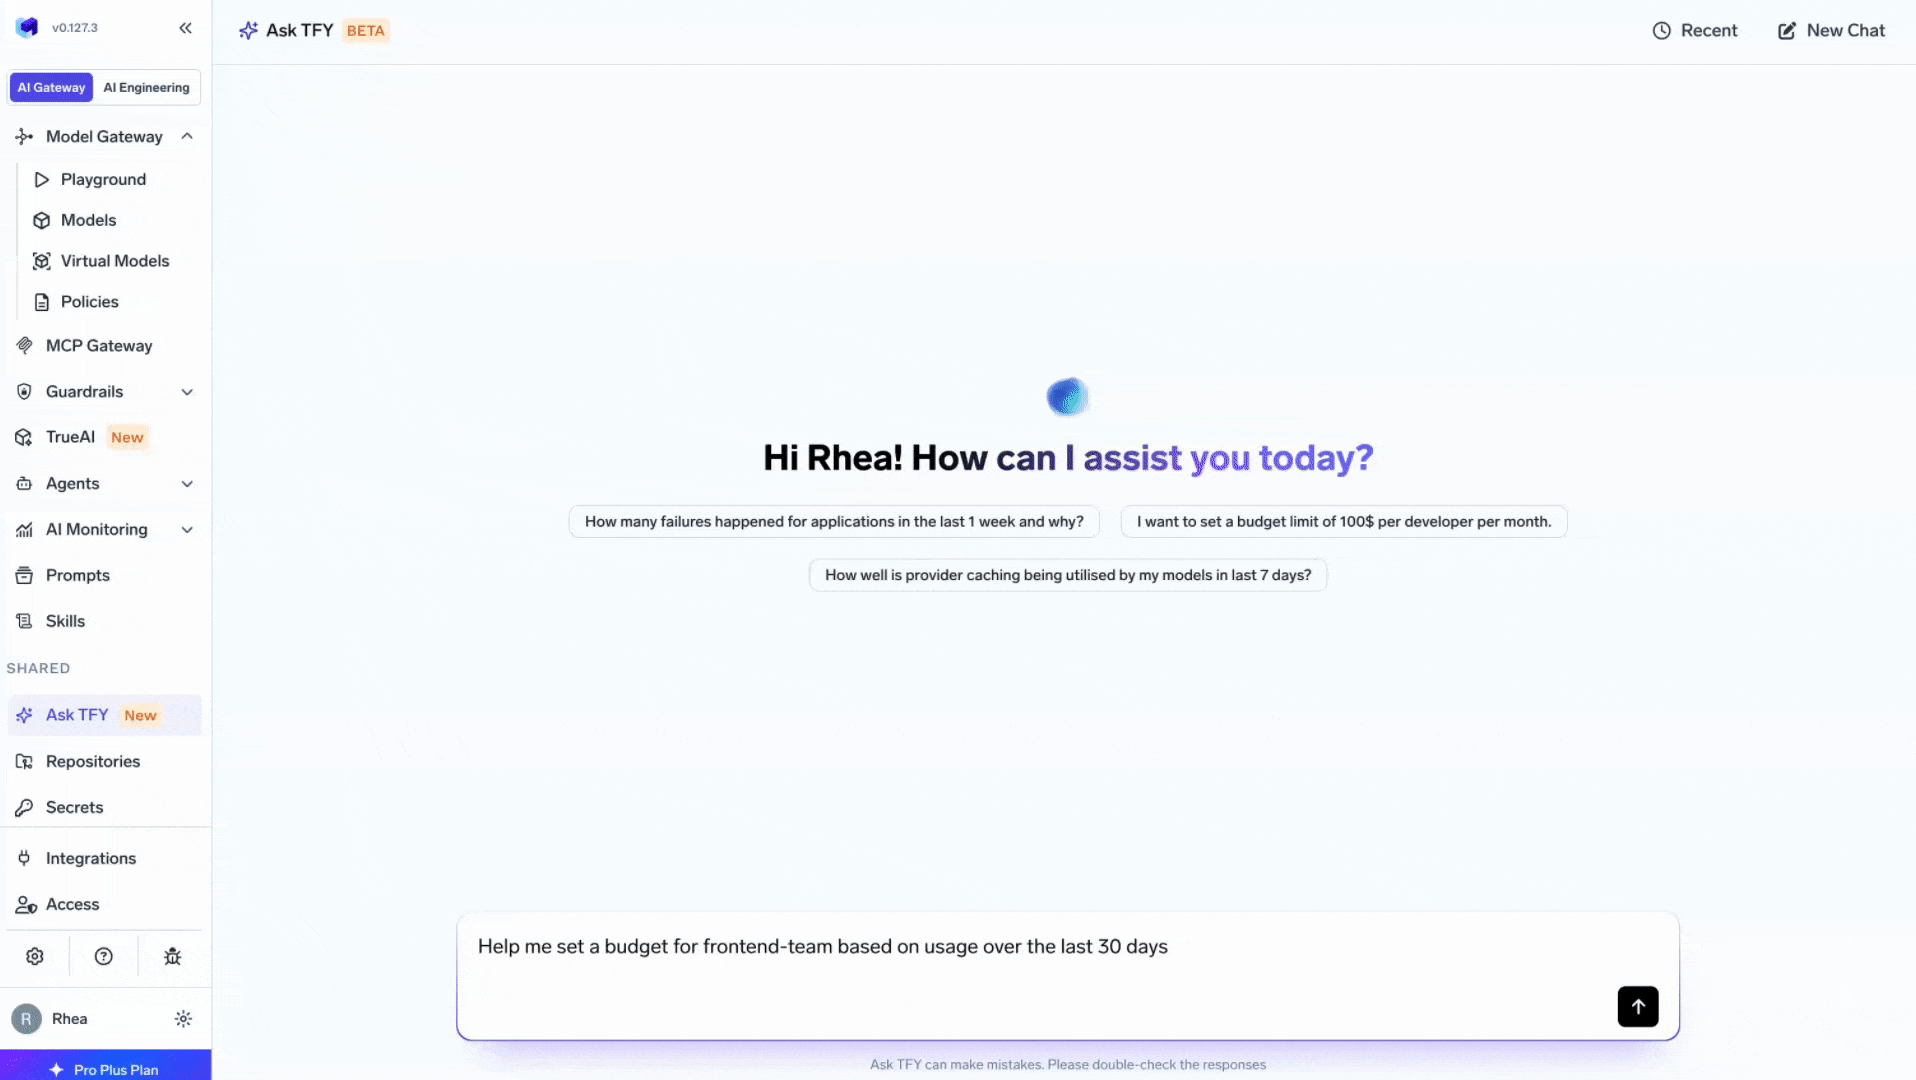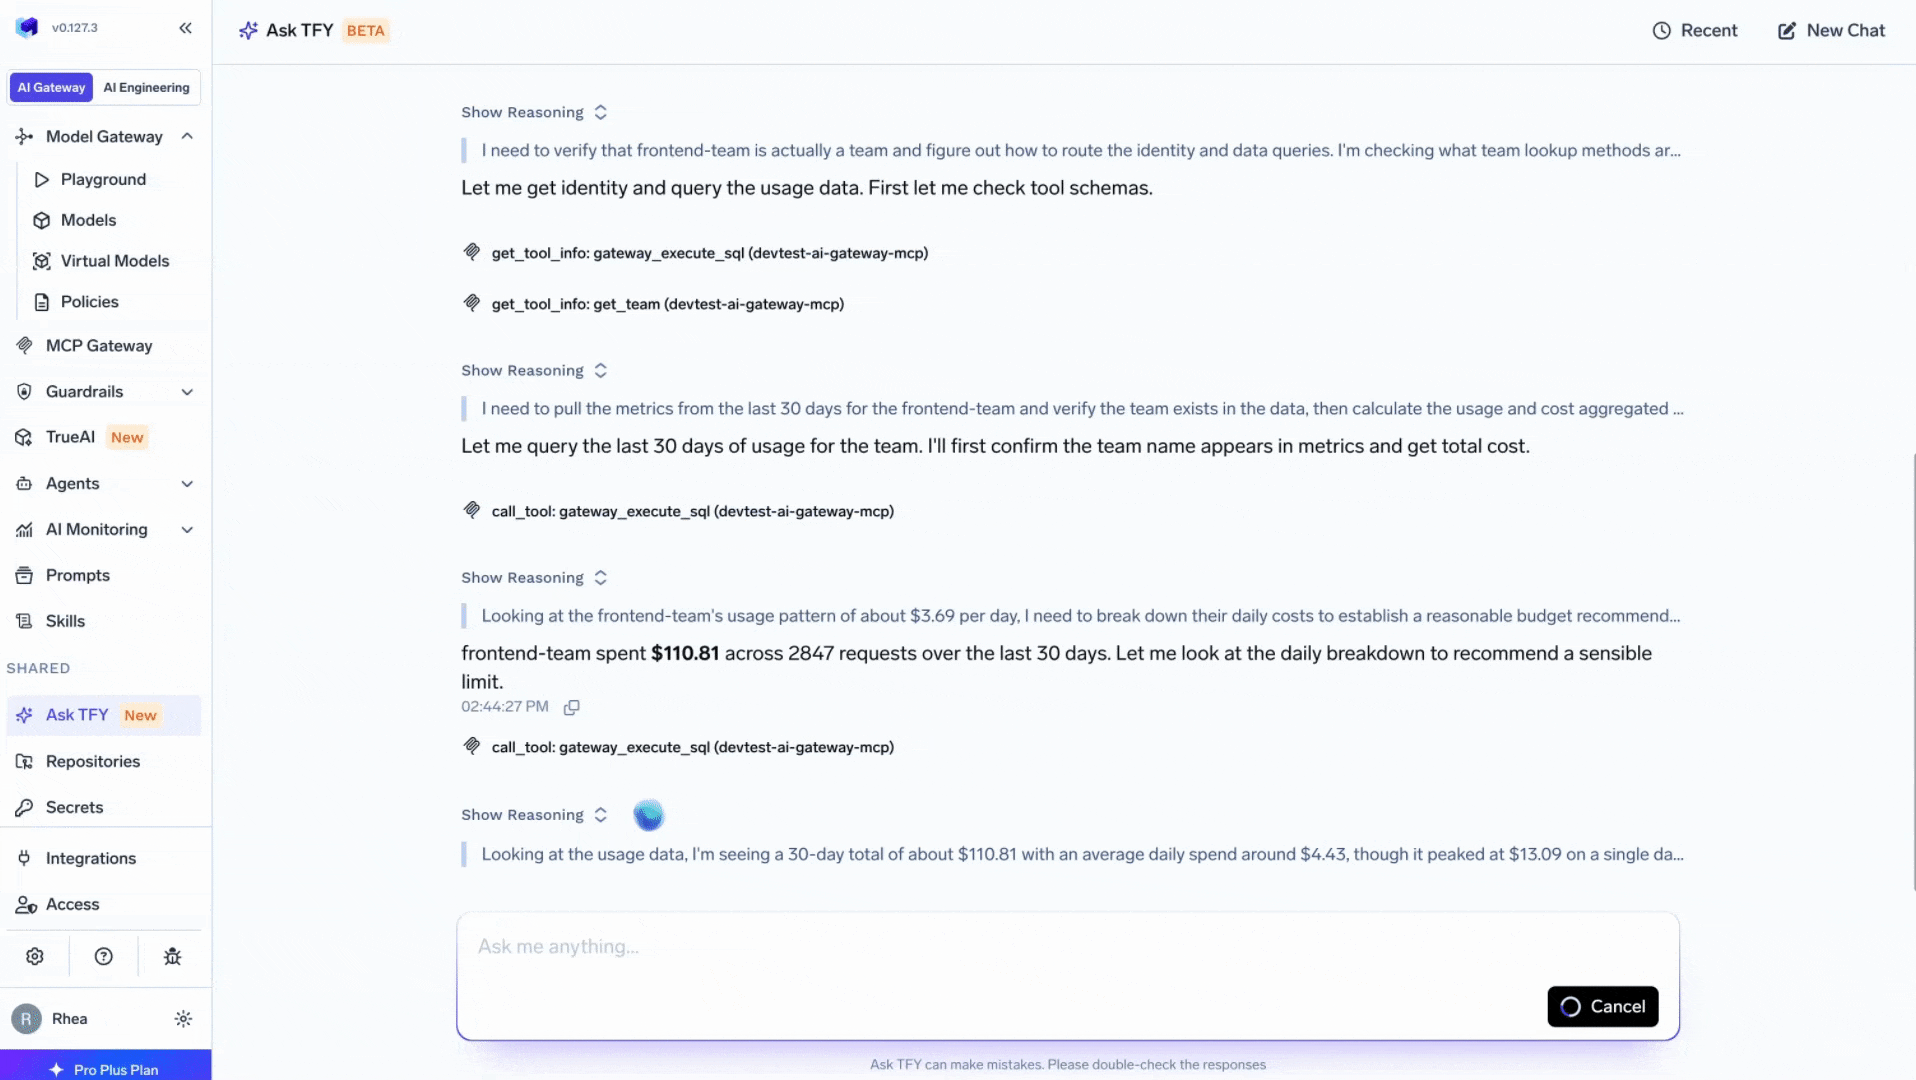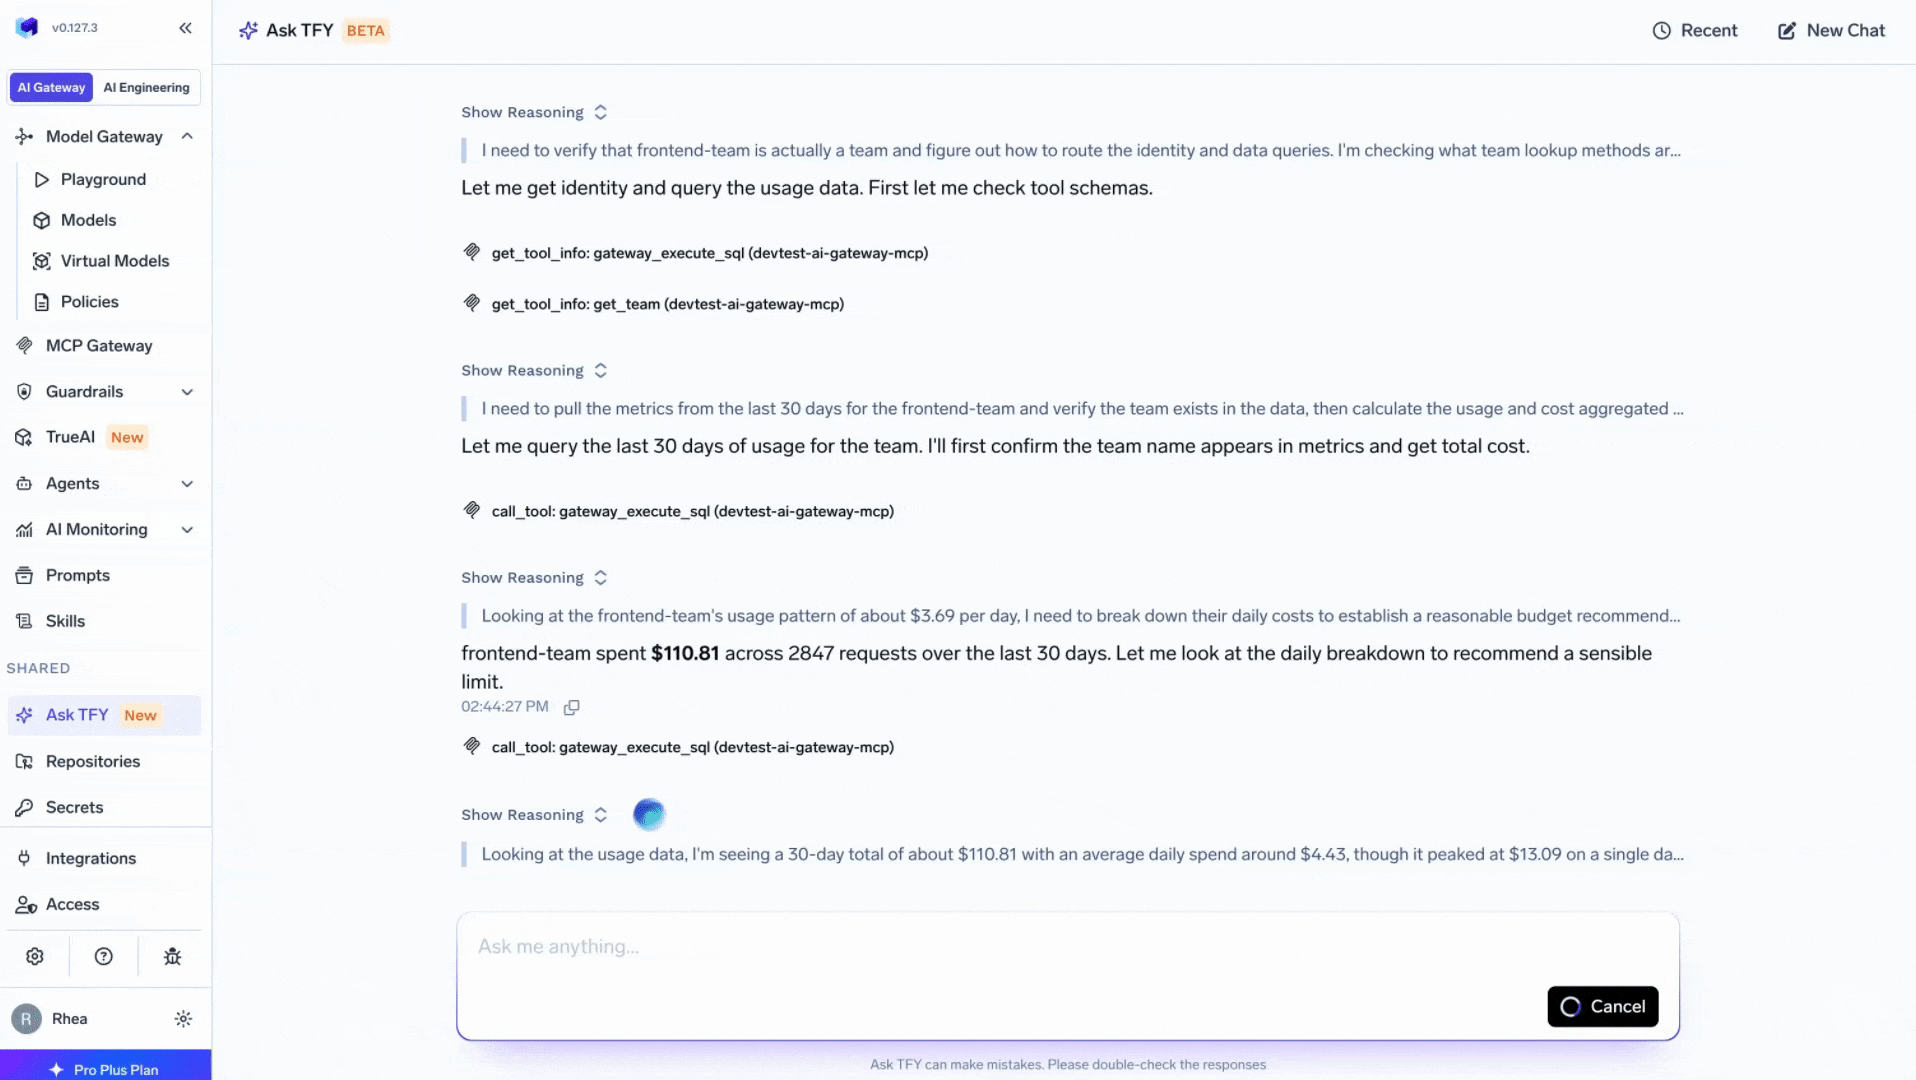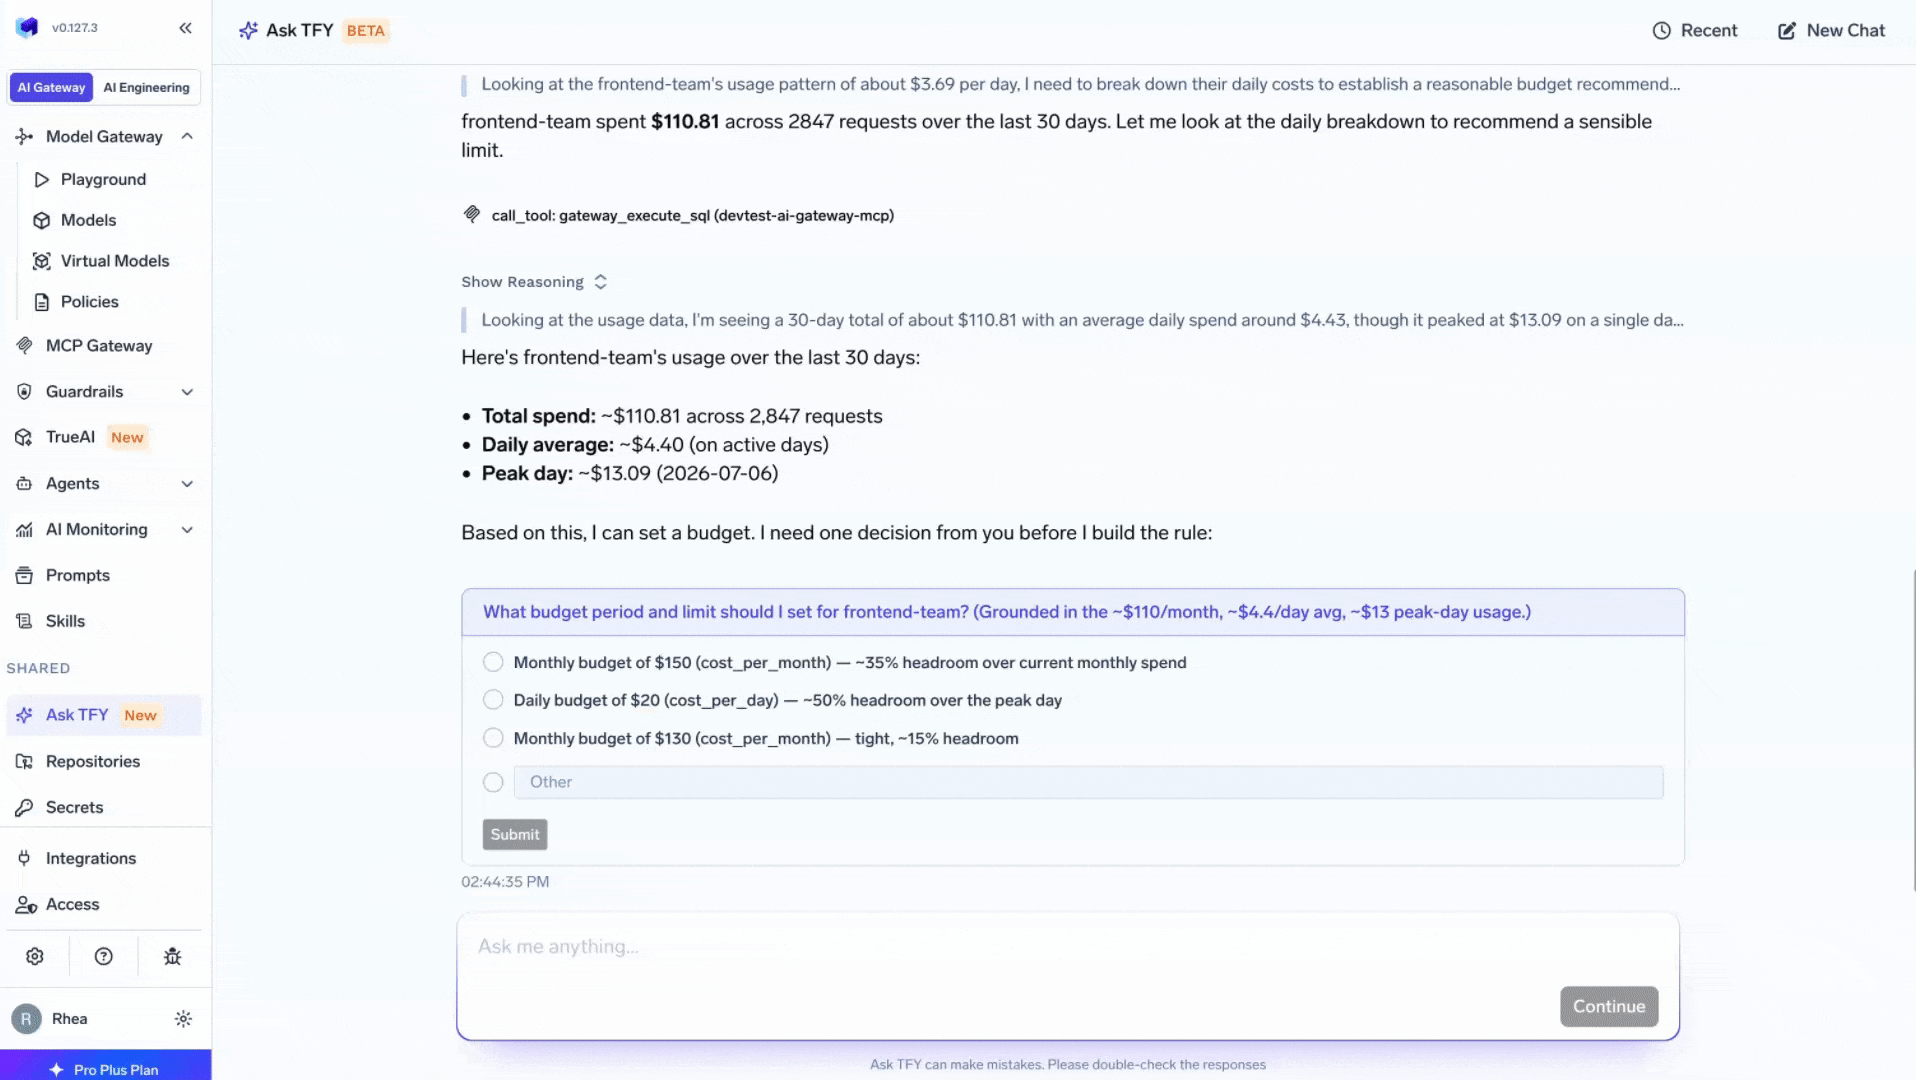
また、Ask TFYが知っているのはあなたのデータだけではありません。ゲートウェイの枠を超えた質問も可能です。例えば、新しいサードパーティ製ライブラリと自社環境の統合方法、特定のモデルプロバイダーのAPI仕様、あるいはこれまで設定したことのない構成の構築方法など、TrueFoundryのドキュメントやWeb検索を活用して不足している情報を補完します。
本番環境でAIが実際に何をしているのかを把握したい時、あるいは迅速に対処が必要な時は、いつでもAsk TFYに尋ねてください。
Ask TFYは、TrueFoundry AI Gatewayで今すぐご利用いただけます。 サインアップ して、今すぐ始めましょう。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.
























