



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Il arrive un moment dans la plupart des programmes IA d'entreprise où apparaît une charge de travail qui ne peut pas envoyer ses données à une API tiers : un jeu de données réglementé, une exigence de souveraineté, ou une courbe de coûts devenue effrayante à grande échelle. La réponse est un modèle open-weight que vous exécutez vous-même. La raison pour laquelle les équipes le redoutent n'est pas le modèle ; c'est que l'auto-hébergement signifie généralement une deuxième stack différente — une API non-OpenAI, une couche de serving, des opérations GPU — greffée sur une plateforme construite autour d'API commerciales. Cet article explique comment une gateway réduit cette complexité, en faisant d'un modèle Llama ou Mistral auto-hébergé une alternative directement intégrable aux côtés des modèles commerciaux que vous appelez déjà.
Ravi, ingénieur plateforme ML, a reçu la demande qu'il attendait : une nouvelle charge de travail allait traiter des enregistrements qui, par politique interne, ne pouvaient pas quitter le cloud de l'entreprise. Aucune API commerciale n'était envisageable. Un modèle open-weight s'exécutant dans leur propre VPC était la réponse évidente — et le cœur de Ravi a un peu flanché, parce que l'application qui en avait besoin était écrite pour l'API OpenAI, l'équipe n'avait pas de stack de serving, et il pouvait déjà imaginer l'univers parallèle d'un second SDK, d'un second ensemble de tableaux de bord, et d'un problème d'autoscaling GPU que personne n'avait résolu. Le modèle était la décision facile. La stack tout autour était la source d'appréhension.
Ce qui a changé la semaine de Ravi, c'est de réaliser que le modèle auto-hébergé n'avait pas du tout besoin d'être une stack différente. S'il se trouvait derrière la même gateway que les modèles commerciaux, en parlant la même API compatible OpenAI, alors pour l'application, ce n'était qu'un autre nom de modèle — et pour la plateforme, c'était un endpoint de plus régi par les mêmes règles. L'exigence de souveraineté a été satisfaite sans diviser l'architecture. Cet article explique comment cela fonctionne, et où réside le véritable travail d'ingénierie.
L'auto-hébergement d'un modèle open-weight concerne rarement la qualité — les API frontier sont excellentes et s'améliorent sans cesse. Il s'agit de quatre autres facteurs. La souveraineté : certaines données ne peuvent pas, légalement ou contractuellement, quitter votre environnement, ce à quoi répond par conception un modèle s'exécutant dans votre VPC ou on-premise. Le coût à grande échelle : au-delà d'un certain volume constant, l'amortissement des GPU peut être inférieur à la tarification par jeton, en particulier pour les charges de travail prévisibles à fort débit. Le contrôle : vous choisissez la version du modèle, vous pouvez effectuer du fine-tuning sur des données propriétaires, et vous n'êtes pas soumis à la dépréciation ou au changement d'un modèle par un fournisseur. La disponibilité : votre chemin d'inférence n'est plus directement lié à la disponibilité d'un fournisseur d'API de modèles — bien qu'il dépende désormais de votre propre infrastructure et de votre chaîne d'approvisionnement de déploiement.
Le contrepoids honnête est que vous gérez désormais les opérations d'inférence : la capacité GPU, la stack de serving, la mise à l'échelle et la fiabilité — un travail qu'une API commerciale masque entièrement. L'auto-hébergement en vaut la peine lorsque l'un de ces quatre facteurs est réel et que le coût opérationnel est maîtrisé. La plupart des entreprises finissent par adopter un modèle hybride : des API commerciales pour le trafic général, des modèles auto-hébergés pour les segments souverains ou à fort volume. L'objectif n'est pas de remplacer l'un par l'autre ; c'est de faire fonctionner les deux sans tout doubler.
La personnalisation mérite d'être extraite de cette liste, car c'est souvent le facteur qui incite une équipe à choisir spécifiquement l'open-weight. Une API commerciale vous donne un modèle que quelqu'un d'autre a entraîné pour tout le monde ; un modèle open-weight peut être adapté à votre domaine, vos formats, votre ton et vos cas particuliers en effectuant un fine-tuning sur des données que vous ne pouvez ou ne voulez envoyer nulle part. Pour des tâches précises et répétitives, un modèle open plus petit et affiné peut égaler ou battre un modèle généraliste beaucoup plus grand pour une fraction du coût de serving — ce qui ramène le facteur de personnalisation vers celui du coût. Le piège est que le fine-tuning est un pipeline à part entière : préparation des données, sessions d'entraînement, évaluation, gestion des versions, puis serving du résultat comme n'importe quel autre modèle. TrueFoundry prend en charge le fine-tuning sans code et avec code aux côtés de sa stack de serving, de sorte qu'un modèle affiné arrive derrière le même endpoint de gateway que tout le reste, plutôt que de devenir un artefact distinct que vous devez rendre opérationnel à la main. L'idée n'est pas que le fine-tuning en vaille toujours la peine — ce n'est souvent pas le cas, et un bon modèle de base avec du prompting solide l'emporte fréquemment — mais quand c'est le cas, la détention des poids est ce qui le rend possible.
Une mise en garde doit figurer dans cette prise de décision, et non après : open-weight ne signifie pas libre de toute obligation. Avant d'auto-héberger ou d'affiner un modèle, vérifiez sa licence, sa politique d'utilisation acceptable, ses conditions de redistribution, ses exigences d'attribution et toute restriction sur l'utilisation réglementée ou commerciale — certains modèles open-weight populaires comportent des seuils d'utilisation ou des limitations de domaine d'application qui comptent à l'échelle de l'entreprise. Traitez la revue de licence comme une étape de la liste de contrôle de déploiement, et non comme une note de bas de page découverte une fois le modèle déjà en production.
L'appréhension de Ravi était fondée, car la manière naïve d'auto-héberger produit exactement cette deuxième stack. Le modèle open-weight expose sa propre structure d'API, de sorte que l'application a besoin d'un chemin de code dédié. Il a besoin d'un moteur de serving, qui constitue sa propre surface opérationnelle. Il a besoin d'autoscaling GPU, qui ne se comporte absolument pas comme la mise à l'échelle d'un service web stateless. Et il a besoin de sa propre observabilité, car les tableaux de bord des API commerciales ne le voient pas. Multipliez cela par quelques modèles et vous obtenez une plateforme parallèle dont le seul rôle est d'être différente de celle que vous exploitez déjà.
L'idée qui désamorce cela est que presque aucune de ces différences n'a besoin d'atteindre l'application ou la surface de contrôle de la plateforme. Le moteur de serving et la mise à l'échelle des GPU sont réels et inévitables — c'est le véritable travail de l'auto-hébergement. Mais la structure de l'API, le routage, la gouvernance et l'observabilité peuvent être rendus identiques au chemin commercial en plaçant la même gateway en amont. La suite de cet article sépare la différence essentielle (serving, GPU) de la différence accidentelle (tout ce que la gateway peut absorber).
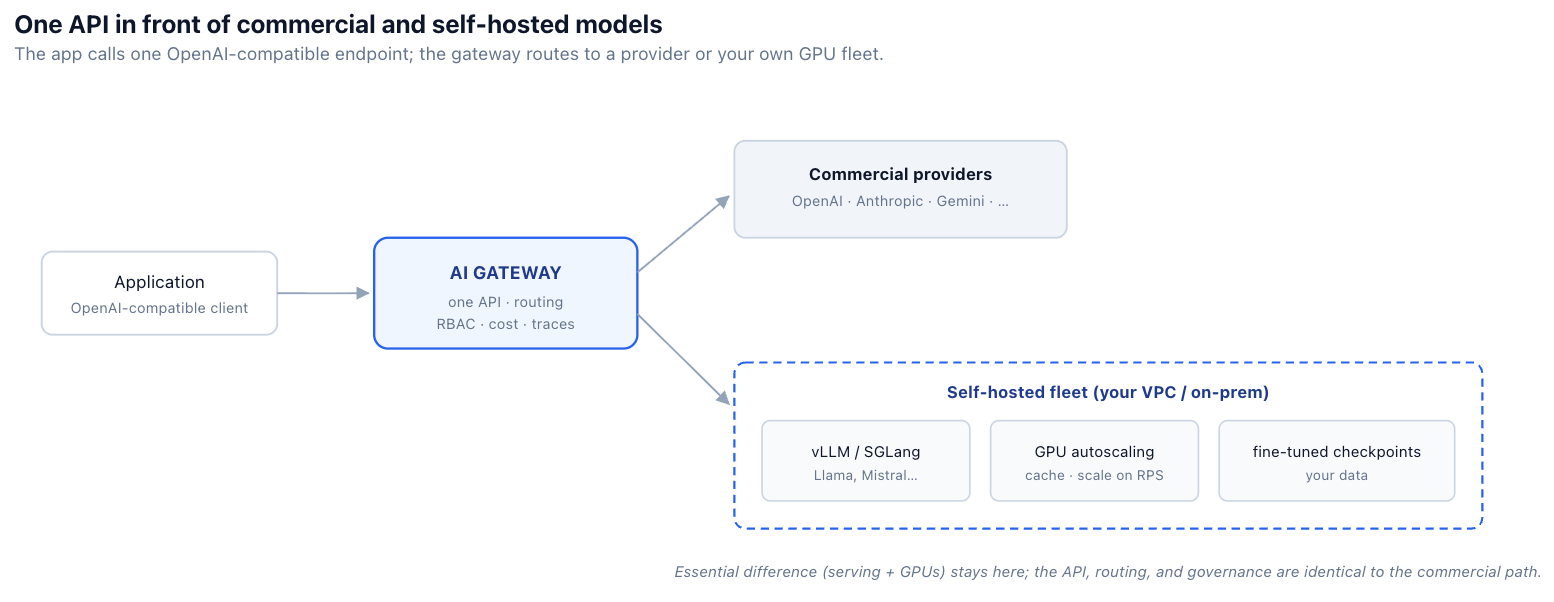
L'action qui rend l'auto-hébergement simple consiste à exposer le modèle auto-hébergé via la même API compatible OpenAI que celle que l'application utilise déjà. Lorsqu'un modèle Llama auto-hébergé répond à la même structure de requête qu'un modèle commercial, basculer de l'un à l'autre devient un changement de configuration et non un changement de code — et le routage, le basculement (fallback), le RBAC, les budgets et le tracing s'appliquent de manière uniforme car, du point de vue de la gateway, il s'agit juste d'un autre modèle derrière la même interface.
Même client, même appel — seul le nom du modèle change (à titre illustratif)
C'est la même unification que celle couverte dans notre article sur le routage, appliquée au cas de l'auto-hébergement : l'application est découplée de l'emplacement physique où s'exécute un modèle. La charge de travail réglementée de Ravi pointe vers un nom de modèle auto-hébergé ; tout le reste sur sa plateforme continue de fonctionner sans changement. L'AI Gateway de TrueFoundry est conçue pour être précisément cette interface centrale pour les modèles auto-hébergés et tiers.
Voici la différence qui vous appartient véritablement. Un modèle open-weight ne s'exécute pas tout seul ; il tourne dans un moteur d'inférence, et le moteur que vous choisissez affecte matériellement le débit, la latence et l'efficacité mémoire. vLLM a popularisé le continuous batching et la paged attention pour un débit élevé ; SGLang s'illustre sur les charges de travail structurées et à forte concurrence ; TGI est un serveur mature et largement déployé ; et TRT-LLM (Triton) tire le meilleur parti des performances spécifiques au matériel sur les GPU NVIDIA. Aucun n'est universellement le meilleur.
La discipline qui compte est le benchmarking : exécutez votre modèle réel, avec vos longueurs de séquence et votre concurrence réelles, sur les moteurs et GPU candidats, et choisissez en vous basant sur des chiffres plutôt que sur la réputation. La documentation de déploiement d'LLM de TrueFoundry répertorie vLLM, SGLang et TRT-LLM parmi les serveurs de modèles pris en charge (TGI et Triton figurant parmi les backends hébergés sur la passerelle), et la plateforme vise à sélectionner automatiquement une configuration GPU cohérente pour un modèle donné — ce qui transforme la question « quel moteur et combien de GPU » d'un projet de recherche en un choix que vous validez par rapport à vos propres benchmarks. Le moteur représente une complexité essentielle ; l'objectif est de rendre sa sélection et son exploitation routinières.
L'autoscaling d'un LLM auto-hébergé ne ressemble pas à celui d'un service web, pour une raison tenace : les poids sont énormes — de quelques gigaoctets à largement plus d'une centaine. Un autoscaler naïf qui télécharge un modèle de 100 GB à chaque fois qu'il ajoute une réplique passera des minutes et engagera un coût réseau important avant que le nouveau pod ne serve le moindre token, ce qui rend l'augmentation d'échelle lors d'un pic de trafic presque inutile. Le démarrage à froid (cold start) est le problème opérationnel déterminant de l'inférence auto-hébergée.
Les solutions sont simples et décisives. Le modèle de mise en cache (model caching) télécharge les poids une fois et les monte sur chaque pod, de sorte qu'une nouvelle réplique démarre à partir d'une copie locale au lieu d'un nouveau téléchargement. Le streaming d'images extrait l'image de serving beaucoup plus rapidement qu'un pull à froid. Les volumes de modèles partagés conservent les poids entièrement en dehors de chaque image. Ensemble, ces méthodes peuvent faire passer un démarrage à froid du statut « tout télécharger depuis zéro » à un chemin de mise à l'échelle suffisamment rapide pour que l'autoscaling basé sur le RPS suive la demande — bien que le temps de démarrage réel dépende toujours de la taille du modèle, de la classe de stockage, de l'emplacement du registry, de l'état du nœud (node warmth) et de la planification des GPU. La documentation de TrueFoundry décrit le caching de modèles (poids téléchargés une fois et montés sur chaque pod), le streaming d'images pour des pulls d'images vLLM et SGLang nettement plus rapides, ainsi que les volumes partagés précisément pour cette raison ; c'est ce qui fait la différence entre un autoscaling qui fonctionne et un autoscaling théorique.
L'auto-hébergement transfère également la responsabilité de la supply chain plus près de vous. Les poids, l'image de serving et leurs dépendances sont désormais des artefacts que vous possédez et livrez. Figez les versions des modèles et des images plutôt que d'utiliser un tag évolutif, vérifiez les sommes de contrôle (checksums) ou les signatures lorsque la source les fournit, contrôlez qui peut publier des checkpoints de modèles et des images de serving dans votre registry, analysez ces images comme n'importe quel autre conteneur de production, et conservez un chemin de restauration (rollback) tant pour le moteur que pour les poids. La passerelle régit qui peut appeler le modèle ; c'est cette discipline qui régit ce que vous exécutez réellement derrière elle.
Un modèle auto-hébergé en tant que déploiement gouverné (configuration illustrative)
L'auto-hébergement débloque une optimisation que les API commerciales vous masquent largement : le contrôle sur la façon dont les requêtes sont assignées aux GPU. Lorsqu'un modèle traite une séquence, il construit un cache clé-valeur (KV-cache) de ses calculs d'attention. Si la requête suivante partage un préfixe — le même prompt système, la même conversation jusqu'à présent —, la router vers la même instance GPU permet au moteur de réutiliser ce calcul mis en cache au lieu de le recalculer, ce qui réduit significativement la latence sur le trafic à fort taux de préfixes.
Pour en bénéficier, il faut un routage persistant (sticky routing) conscient des préfixes : la passerelle achemine les requêtes partageant un préfixe vers la même instance plutôt que de les répartir en round-robin. La documentation de TrueFoundry décrit exactement cela — un routage persistant qui envoie les requêtes avec le même préfixe vers la même machine GPU pour tirer parti de l'optimisation du KV-cache —, le pendant auto-hébergé au niveau GPU du caching sémantique au niveau passerelle présenté dans notre article sur le caching. L'un réutilise les calculs à l'intérieur du moteur de serving ; l'autre réutilise des réponses entières au niveau de la passerelle. Sur des charges de travail conversationnelles ou avec des prompts système partagés, les deux se cumulent.
Une fois que les modèles auto-hébergés et commerciaux vivent derrière une seule API, la mécanique de routage et de fiabilité présentée plus tôt dans cette série s'applique à l'ensemble de la flotte à la fois. Vous pouvez router une charge de travail souveraine vers le modèle auto-hébergé par politique, envoyer le trafic général vers une API commerciale, et — surtout — basculer d'un monde à l'autre : si la flotte auto-hébergée est saturée pendant un pic, effectuez un débordement (bursting) vers un modèle commercial au lieu de mettre en attente, et si un fournisseur subit une panne, basculez en failover vers le modèle auto-hébergé.
Routage traitant l'auto-hébergé et le commercial comme une seule flotte (illustratif)
Il s'agit du routage et du failover des articles 11 et 12, qui s'étendent désormais à la jonction commercial/auto-hébergé — avec une contrainte importante explicitée dans la politique : une route réglementée ne doit pas basculer vers un fournisseur commercial, car la disponibilité ne prime jamais sur la souveraineté. Coder cela sous forme de règle, plutôt que de compter sur la mémoire de chacun, est le type de garde-fou que la passerelle est conçue pour faire appliquer.
Le fil conducteur est que l'auto-hébergement se divise clairement en deux types de travaux. Le type essentiel — le moteur de serving et les GPU — est concret, et le prochain article de ce binôme traitera de ses aspects économiques. Le type accidentel — une API différente, un routage séparé, une gouvernance séparée, une observabilité séparée — est ce que la passerelle absorbe en étant la jonction unique entre vos applications et chaque modèle, quel que soit l'endroit où il tourne.
Placez la passerelle à cet endroit et un modèle auto-hébergé cesse d'être une plateforme parallèle pour devenir un endpoint gouverné de plus : même API compatible OpenAI, mêmes règles de routage et de failover, même RBAC et budgets, mêmes traces. TrueFoundry est conçu précisément autour de cette division — un serving haute performance sur vLLM, SGLang, TGI et TRT-LLM avec la mécanique de GPU et de caching pour le rendre exploitable, précédé par une AI Gateway qui rend le résultat indiscutable par rapport à un modèle commercial pour tout ce qui se trouve en amont. Pour Ravi, c'est la différence entre répondre à une exigence de souveraineté et reconstruire sa plateforme pour y parvenir.
L'auto-hébergement est-il moins cher qu'une API commerciale ?
Parfois, au-delà d'un certain seuil. Pour un trafic stable, à fort volume et prévisible, des GPU amortis (en particulier avec le partage fractionné et la capacité spot) peuvent être plus avantageux qu'une tarification par token ; pour un trafic ponctuel ou à faible volume, une API commerciale est généralement moins chère car vous ne payez pas pour des GPU inactifs. La réponse honnête consiste à modéliser votre propre volume — ce qui fait l'objet de l'article sur l'économie des GPU associé à celui-ci. Le coût est l'une des quatre raisons d'auto-héberger, pas la seule.
Dois-je réécrire mon application pour utiliser un modèle auto-hébergé ?
Pas si le modèle est précédé d'une passerelle compatible OpenAI. L'application continue d'appeler la même API et seul le nom du modèle change ; la passerelle résout ce nom vers votre flotte de GPU et applique les mêmes règles de routage, de RBAC et de tracing que pour les modèles commerciaux. Tout l'intérêt est que l'application ne sait pas ni ne se soucie d'où tourne le modèle.
Quel moteur de serving dois-je utiliser ?
Faites des benchmarks pour décider — il n'y a pas de gagnant universel. Les backends documentés — vLLM, SGLang, TRT-LLM, plus KServe et Triton — diffèrent en termes de débit, de latence, d'efficacité mémoire et de fonctionnalités prises en charge, et le bon choix dépend de votre modèle, des longueurs de séquence et de la concurrence. Exécutez votre charge de travail réelle sur les candidats et choisissez sur la base des mesures effectuées. Une plateforme qui les prend tous en charge vous permet de changer sans devoir repenser votre architecture.
Quelle est la partie opérationnelle la plus difficile ?
Les démarrages à froid (cold starts). Les poids des LLM sont volumineux, donc un autoscaler qui télécharge à nouveau le modèle par réplique est trop lent pour suivre la demande. Le caching de modèles, le streaming d'images et les volumes partagés sont ce qui rend la mise à l'échelle pratique — ils transforment un démarrage à froid de plusieurs minutes en quelque chose de suffisamment rapide pour que l'autoscaling basé sur le RPS et les politiques d'inactivité à échelle zéro fonctionnent réellement.
Puis-je mélanger des modèles auto-hébergés et commerciaux ?
C'est l'état final le plus courant, et c'est la force de placer les deux derrière une seule passerelle. Acheminez le trafic souverain ou à fort volume vers des modèles auto-hébergés, le trafic général vers des API commerciales, et basculez d'un côté à l'autre en cas de charge ou de panne — avec l'exception explicite selon laquelle les routes réglementées ne doivent pas basculer vers un fournisseur commercial. Une seule flotte, un seul ensemble de règles, deux types de backends.
Le problème de souveraineté de Ravi n'a jamais nécessité une seconde plateforme ; il nécessitait qu'un modèle tourne à un endroit spécifique et que tout le reste demeure identique. C'est ce qu'apporte une passerelle : la liberté de placer un modèle là où la souveraineté, le coût, le contrôle ou la disponibilité l'exigent, tandis que l'application et la plateforme voient une interface cohérente. Prenez en main le serving et les GPU — c'est le travail réel — et laissez la passerelle absorber le reste.
Ravi est donné à titre illustratif. Les fonctionnalités de serving et de gateway de TrueFoundry — moteurs d'inférence pris en charge, mise en cache de modèles, streaming d'images, routage persistant basé sur les préfixes et autoscaling — sont résumées à partir de la documentation publique du produit datant de mi-2026 et sont susceptibles d'évoluer ; vérifiez les détails par rapport à la documentation actuelle. Les comparaisons de coûts entre les modèles auto-hébergés et commerciaux dépendent entièrement de votre propre volume et matériel et doivent être modélisées directement. Les exemples de code et de configuration illustrent les schémas documentés et ne sont pas copiés d'une implémentation de référence.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















