



November 6, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Muse Spark est la première famille de modèles de Meta Superintelligence Labs, introduite le 8 avril 2026 pour remplacer la gamme Llama (Meta AI). La version 1.3 est la troisième itération et, d'après la documentation de Meta, l'option par défaut recommandée pour les nouveaux travaux.
Les spécifications, issues de la page des modèles et de la page de tarification de l'API Meta Model, en date de septembre 2026 :
Trois détails méritent d'être soulignés.
Ce n'est pas un modèle à poids ouverts. C'est la première erreur commise par la plupart des gens, en partie parce que Meta s'est positionnée pendant des années comme l'entreprise des poids ouverts. Muse Spark 1.3 est accessible uniquement via une API. La note de version de Meta se conclut d'ailleurs par une ligne de feuille de route mentionnant « la sortie des poids ouverts de Muse Spark » comme un projet futur — une affirmation claire que cela n'a pas encore eu lieu. Si vous avez besoin de poids Meta téléchargeables dès aujourd'hui, le modèle adéquat est Muse Glimmer : 30B de paramètres, multimodal dense, contexte par défaut de 128K, licence Apache 2.0, distillé à partir de Muse Spark (documentation Muse Glimmer). Une licence véritablement permissive, pour un modèle beaucoup plus petit. Il ne faut pas confondre les deux.
L'audio est dégradé sur la version 1.3 spécifiquement. En bas de la page des modèles de Meta, une note indique que la compréhension audio dans la version 1.3 « n'est actuellement pas pleinement prise en charge » et que la qualité des réponses peut en souffrir, recommandant d'utiliser plutôt la 1.2 ou le modèle dédié Muse Voice Transcribe. C'est une régression inhabituelle à admettre dans une mise à jour mineure, et cela a son importance si votre pipeline traite de l'audio.
La fenêtre de contexte offre un tarif forfaitaire. 1 048 576 tokens sans surcoût pour le contexte long, selon les termes de Meta — le tarif par token reste identique, que la fenêtre soit presque vide ou presque pleine. La plupart des fournisseurs appliquent un palier tarifaire au-delà d'un certain seuil. Ce n'est pas le cas ici.
[CAPTURE D'ÉCRAN : API Meta Model — le tableau de bord dev.meta.ai montrant l'entrée du modèle muse-spark-1.3 et la sélection de l'offre]
Meta présente la version 1.3 comme une mise à jour axée sur l'utilisabilité plutôt que comme un saut de capacités, et les écarts publiés confirment cette lecture.
Source : Introducing Muse Spark 1.3, Meta AI Research, 2 septembre 2026.
Les chiffres d'efficacité entraînent une conséquence commerciale directe : une réduction de 25 % des tokens sur un travail identique représente une baisse de 25 % de la facture, avant même toute décision de routage. Mais gardez à l'esprit la provenance de ces données — il s'agit d'une comparaison interne à l'ingénierie de Meta, et non d'une reproduction indépendante. La tendance est très probablement correcte ; l'ampleur exacte sur vos propres charges de travail reste à mesurer de votre côté.
Les changements de comportement constituent la partie la plus intéressante. Un modèle qui demande une confirmation avant d'effectuer une action irréversible, et qui admet être bloqué, présente une valeur opérationnelle différente d'un modèle qui poursuit son exécution sans retenue. Pour les exécutions d'agents à long horizon où un mauvais appel d'outil entraîne des coûts réels, cela a plus de valeur qu'un point de benchmark supplémentaire.
Meta publie un tableau comparatif de benchmarks opposant Muse Spark 1.3 à Muse Spark 1.2, GPT-5.6 Sol et Claude Opus 5 sur des évaluations d'agents, de codage, de respect d'instructions et de contexte long. La suite de tests, d'après le rapport méthodologique d'évaluation de Meta :
Les scores individuels doivent être vérifiés. Meta les publie uniquement sous forme d'image intégrée dans son article de présentation, et non sous forme de texte brut. Cet article ne retranscrira donc pas de chiffres qu'il ne peut citer avec une précision absolue. Veuillez vous référer directement au tableau comparatif sur la page de Meta avant de citer une valeur.
Ce que le rapport méthodologique détaille sous forme textuelle s'avère de toute façon plus utile que les scores eux-mêmes, et trois réserves majeures doivent accompagner toute valeur citée.
Les comparaisons ont été effectuées à des niveaux d'effort différents. Muse Spark 1.3, Opus 5 et GPT-5.6 Sol ont été évalués avec un effort de raisonnement maximal, tandis que Muse Spark 1.2 l'a été avec un niveau nommé xhigh. Une partie de l'écart entre la 1.2 et la 1.3 découle donc d'une différence de configuration, et non purement d'une différence de modèle.
La comparaison OSWorld n'utilise pas des versions identiques. Chaque modèle a été évalué sur OSWorld 2.0 version 08.08, à l'exception de Muse Spark 1.2 qui a tourné sur la version 06.24. Meta le précise clairement, ce qui est à son crédit, mais cela signifie que cette ligne spécifique n'est pas un comparatif rigoureusement équivalent.
Les scores retiennent les meilleurs résultats enregistrés. Meta indique rapporter « la valeur de métrique principale comparable la plus élevée disponible à partir de nos évaluations, du classement officiel ou des résultats déclarés par le fournisseur du modèle ». Sélectionner le meilleur chiffre disponible pour chaque modèle sur chaque ligne est une méthode défendable, mais elle ne correspond pas à un essai contrôlé unique.
Meta fait également preuve d'une transparence inhabituelle sur les limites de ses propres tests concurrents, en notant que ses exécutions « peuvent ne pas être optimisées pour des modèles propriétaires et peuvent ne pas refléter leur meilleure performance optimisée par le fournisseur ». C'est une mise en garde honnête, et une excellente raison de considérer chaque tableau comparatif d'un éditeur — y compris celui-ci — comme une hypothèse de départ plutôt que comme un résultat définitif. Le seul benchmark décisif pour vos choix de routage reste l'analyse de votre propre trafic sur vos propres prompts, d'où l'intérêt d'exécuter vos propres évaluations avant d'engager vos ressources.
Meta propose deux offres, et l'écart de prix entre elles constitue l'élément le plus déterminant de cet article.
Source : Tarification et limites de débit de l'API Meta Model, septembre 2026.
L'offre Contributor est 92 % moins chère sur l'entrée et 95 % moins chère sur la sortie. Meta est totalement transparente sur la contrepartie : des tokens fortement remisés « en échange de l'autorisation d'utiliser vos prompts et vos réponses pour entraîner les futurs modèles de Meta ». Les identifiants de modèle sont distincts — muse-spark-1.3-contributor au lieu de muse-spark-1.3 — le choix s'effectue donc explicitement au moment de l'appel API, et non de façon masquée dans un paramètre de compte.
Cette transparence est une bonne pratique. Elle crée toutefois un risque opérationnel spécifique sur lequel nous reviendrons.
Deux remarques tarifaires supplémentaires. Le grounding pour la recherche Web coûte 2,50 $ pour 1 000 requêtes en sus du coût des tokens ; tout usage de l'outil web_search déclenche donc une seconde facturation. De plus, le raisonnement maximal est réservé à l'offre Standard — l'offre économique ne peut pas accéder au mode qui génère les résultats de benchmark de référence.
Quatre modes de défaillance sont spécifiques à cette version plutôt qu'à l'adoption globale de modèles.
L'offre Contributor est à une seule ligne de configuration d'un incident de confidentialité des données. Une remise de 92 % est exactement le genre d'économie qu'un ingénieur applique lors d'une revue de coûts sans lire la seconde moitié de la condition, alors que les deux identifiants de modèle ne diffèrent que par un suffixe. Si un développeur pointe un service de production vers muse-spark-1.3-contributor pour atteindre un objectif budgétaire, les prompts des clients deviennent des données d'entraînement pour Meta sans que rien ne paraisse différent au niveau de l'application. Cette règle doit être appliquée de manière centralisée, car elle ne sera pas systématiquement respectée dans chaque dépôt de code.
Les limites de débit s'appliquent par équipe, et non par clé API. Meta est explicite : toutes les clés d'une même équipe partagent le budget de 3 000 RPM et 4M TPM. Générer une clé par service ne partitionne pas la capacité ; une tâche par lots mal configurée peut donc priver de ressources un produit interactif. Meta conseille de lire l'en-tête x-ratelimit-remaining-tokens et de ralentir avant d'atteindre la limite — ce qui implique qu'un composant de votre infrastructure gère réellement cette logique.
Les poids fermés mettent fin prématurément aux débats sur la résidence des données. Avec un modèle à poids ouverts, vous pouvez débattre de l'endroit où l'exécuter. Ici, la réponse est unique : les prompts sont envoyés à l'API de Meta. Vos équipes juridiques décideront de ce qui est acceptable ; retenez que l'option de l'hébergement autonome qui existe pour Muse Glimmer n'existe pas pour Muse Spark.
Le rythme de mise à jour est rapide. Trois versions entre avril et septembre 2026, environ quatre semaines entre la 1.2 et la 1.3, et une régression audio documentée dans une mise à jour mineure. Toute intégration qui définit en dur une chaîne de caractères de modèle devra être révisée plus tôt que ne le prévoient vos cycles de planification — d'où l'utilité des noms de modèles virtuels et des basculements progressifs.
Un modèle fermé modifie l'objectif d'une passerelle (gateway). Avec un modèle à poids ouverts, le rôle de la passerelle est d'assurer la portabilité. Ici, il s'agit de contrôle, d'imputation des coûts et de flexibilité stratégique.
Faites du choix de l'offre une politique globale, non une préférence individuelle. La décision d'utiliser l'offre Contributor doit être prise une fois par les responsables concernés, puis strictement appliquée. L'application de politiques au niveau de la passerelle vous permet d'exposer muse-spark-1.3 aux services de production tout en restreignant la variante contributor à un environnement de test — ou en la bloquant totalement. Les applications demandent un nom de modèle ; la passerelle détermine à quoi il correspond.
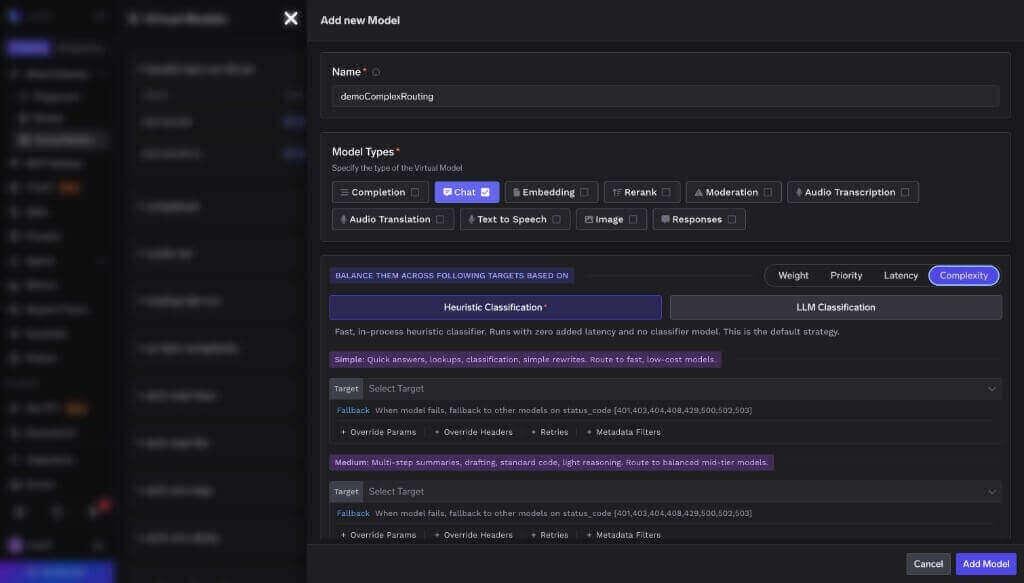
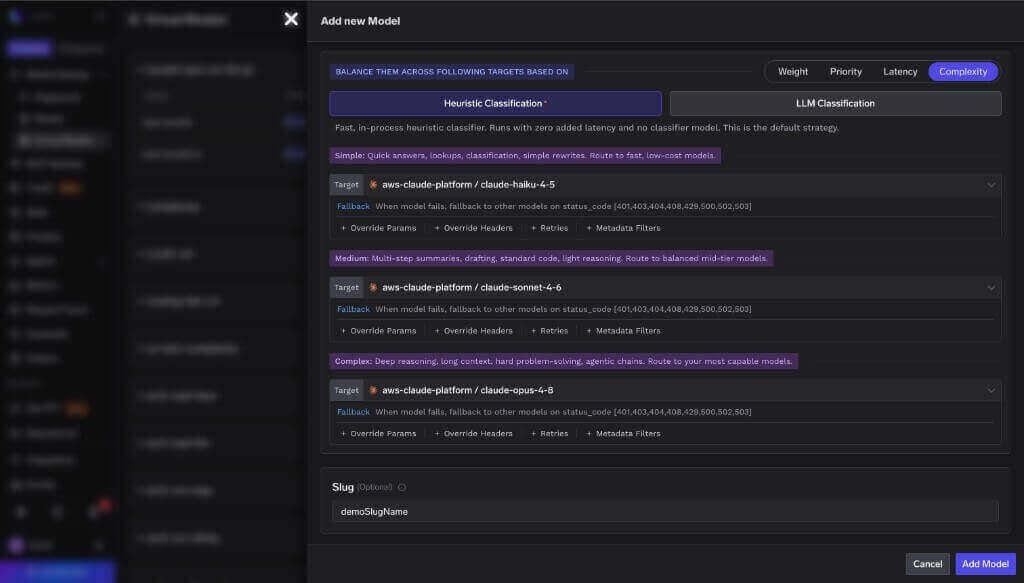
Routez par tâche, non par fidélité à un fournisseur. Le tableau comparatif de Meta positionne la version 1.3 face à Opus 5 et GPT-5.6 Sol au lieu de prétendre les surpasser sur tous les plans, ce qui plaide pour une flotte de modèles mixte. Les exécutions d'agents à long horizon et les traitements nécessitant un million de tokens de contexte sont dirigés vers Muse Spark ; les autres tâches vont vers les modèles les plus performants pour leur usage. Lors des tests d'Auto Routing de TrueFoundry sur 550 prompts, cette hiérarchisation des requêtes a réduit les coûts de 69 % tout en conservant 98 % de la qualité de référence, avec une latence moyenne passant de 7,6 s à 4,0 s ; sur un trafic représentatif de la production, la réduction a atteint 80 %.
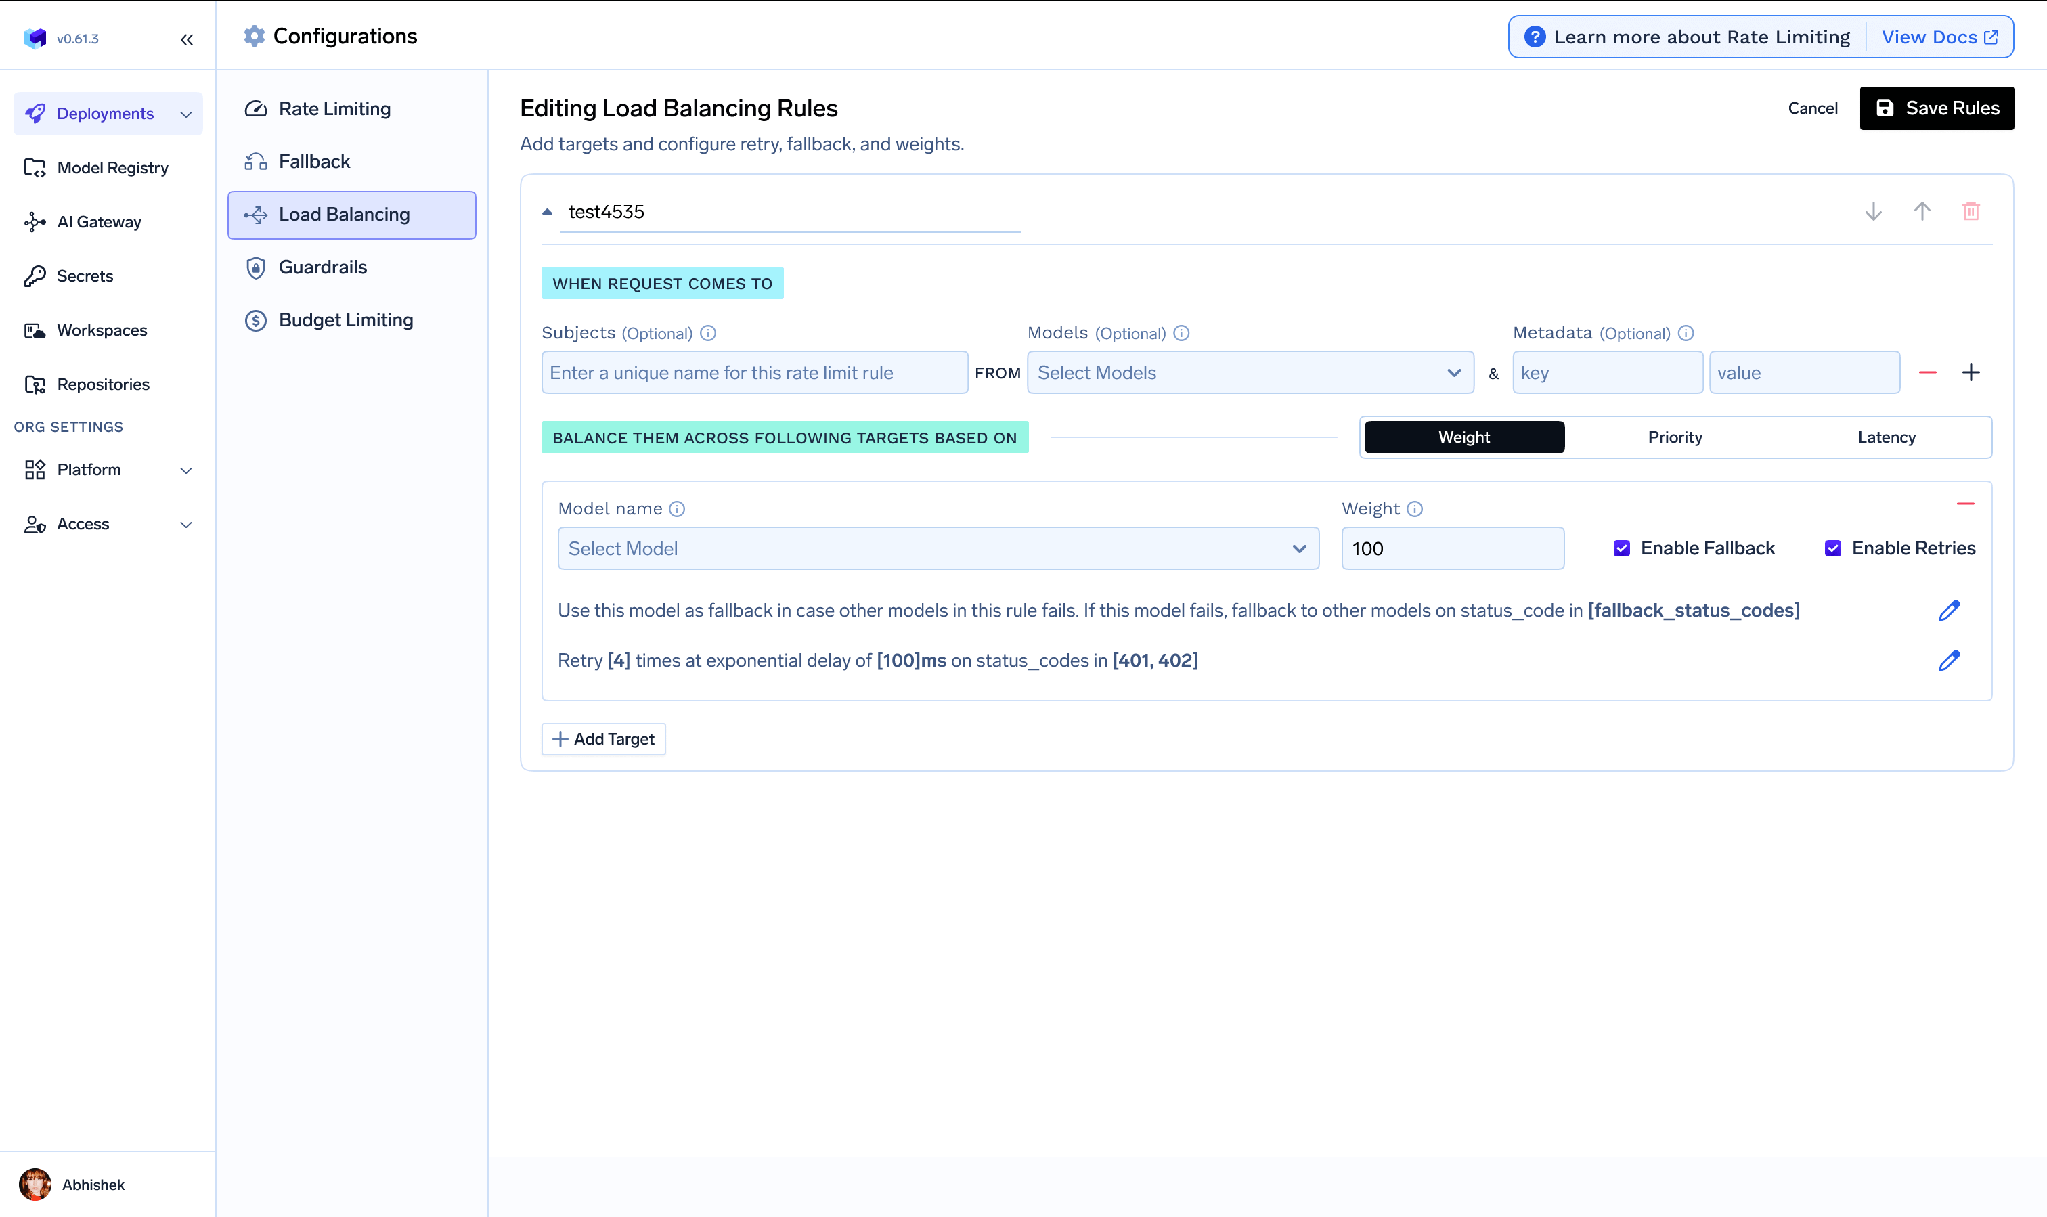
Gérez la limite de débit partagée. Comme le quota de Meta est défini par équipe, la passerelle est l'endroit naturel pour le centraliser : limitation de débit par équipe consommatrice, mise en file d'attente et basculement automatique (failover) vers un autre fournisseur quand Meta renvoie un code 429. Un budget partagé nécessite un point d'entrée unique capable de le piloter.
Conservez vos propres garde-fous (guardrails). Meta annonce une meilleure résistance à l'injection de prompts sur la 1.3, ce qui est une bonne chose mais reste un contrôle externe que vous ne maîtrisez pas. Les garde-fous de la passerelle s'exécutent sur le flux des requêtes et des réponses quel que soit le fournisseur qui répond ; votre politique de sécurité reste donc inchangée lorsque votre modèle change.

Vérifiez les gains d'efficacité annoncés. Meta indique que la 1.3 utilise ~25 % de tokens en moins que la 1.2. Le suivi des coûts par requête et l'imputation des tokens par équipe vous permettent de valider ce chiffre sur votre trafic réel plutôt que d'accepter cette estimation sans vérification.

La marche à suivre synthétique, en date de septembre 2026 :

[CAPTURE D'ÉCRAN : Muse Code — session de terminal montrant une exécution d'agent sur Muse Spark 1.3]
Muse Spark 1.3 est une mise à jour pragmatique et fonctionnelle. Meta n'a pas revendiqué la franchissement d'une nouvelle frontière d'intelligence. L'entreprise a annoncé moins d'appels d'outils, moins de tokens, un meilleur comportement dans les longs fils de discussion et un meilleur discernement concernant les actions irréversibles — autant d'éléments qui déterminent si l'exécution d'un agent se termine correctement ou consomme des ressources inutilement. Pour une équipe qui route déjà son trafic entre plusieurs fournisseurs, cela en fait une quatrième option crédible pour le travail d'agent à long horizon, avec une fenêtre de contexte d'un million de tokens à tarif fixe comme élément différenciateur.
Restez lucide sur ses points faibles. Les poids sont fermés, les arguments de portabilité et de résidence des données propres aux modèles à poids ouverts ne s'appliquent donc pas — et si vous cherchiez le modèle ouvert de Meta, il s'agit de Muse Glimmer, d'une taille beaucoup plus réduite. La gestion de l'audio a régressé sur cette version. Les scores officiels sont publiés sous forme d'image, mesurés en partie avec des configurations non alignées, et retiennent les meilleurs résultats enregistrés. Enfin, la méthode la plus économique pour l'exécuter implique de céder l'usage de vos prompts.
En conclusion : tout dépend de ce que vous souhaitez maîtriser. Si vous voulez le modèle le plus performant de Meta, vous le louez selon les conditions de Meta. La décision stratégique ne porte pas sur son adoption, mais sur l'endroit où réside la politique d'accès à l'offre et sur qui peut la modifier. Placez cette décision derrière une passerelle avant qu'une équipe ne l'intègre directement, et l'ajout de Muse Spark 1.3 à votre rotation ne nécessitera qu'un changement de configuration plutôt qu'une migration de code.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Muse Spark est la famille de modèles de Meta Superintelligence Labs, présentée le 8 avril 2026 et désormais successeur de la gamme Llama de Meta. Muse Spark 1.3, sorti le 2 septembre 2026, est la version actuelle, avec une fenêtre de contexte de 1 048 576 tokens et des entrées texte, image, vidéo et PDF.
Non. Muse Spark 1.3 est fermé et accessible uniquement par API. L'article de lancement de Meta mentionne une publication des poids comme un élément futur de la feuille de route. Le modèle à poids ouverts de Meta disponible aujourd'hui est Muse Glimmer — 30 milliards de paramètres, Apache 2.0, distillé à partir de Muse Spark, avec une fenêtre de contexte par défaut de 128K.
Sur l'offre Standard, 1,25 $ par million de tokens d'entrée, 0,15 $ pour l'entrée mise en cache et 4,25 $ par million de tokens de sortie, sans supplément pour les longs contextes. L'offre Contributor est à 0,10 $ en entrée et 0,20 $ en sortie, en échange de l'autorisation d'entraîner les modèles sur vos prompts et vos réponses.
Meta évalue la version 1.3 face à Muse Spark 1.2, Claude Opus 5 et GPT-5.6 Sol sur GDPVal-AA v2, JobBench, OSWorld 2.0, DeepSearchQA, AutomationBench, DeepSWE v1.1, SWE-Atlas Codebase QnA, Terminal-Bench 2.1, MRCR v2 et un indice interne de suivi des instructions. Les scores individuels ne sont publiés que dans une image de l'article de lancement de Meta — consultez-les à cet endroit plutôt que dans des sources secondaires.
L'AI Gateway de TrueFoundry ajoute environ 3 à 4 ms et soutient plus de 350 RPS sur 1 vCPU, ce qui est négligeable face à des temps de génération de plusieurs secondes.
Non, et la dispersion des benchmarks ci-dessus est l'argument qui s'y oppose. Router par type de tâche entre modèles ouverts et fermés est généralement moins coûteux et plus efficace que de standardiser sur un seul.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception



















