



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Los equipos empresariales comparan Obot AI y LiteLLM cuando su stack de IA empieza a superar las llamadas directas a modelos. LiteLLM suele ser la opción familiar para el enrutamiento multimodelo, claves virtuales, seguimiento de gastos, presupuestos y acceso compatible con OpenAI. Obot AI entra en la conversación cuando la gestión de servidores MCP, la visibilidad de clientes de IA, la identidad y la gobernanza de herramientas cobran importancia.
La verdadera cuestión no es si una herramienta sustituye a la otra en todos los casos. LiteLLM parte de la capa de proxy de LLM. Obot AI parte de un punto más cercano a la gobernanza de MCP y a la gestión del ecosistema de IA empresarial. Un equipo que ya utiliza LiteLLM sin problemas no tiene motivos de enrutamiento para cambiar. Un equipo que se ahoga en servidores MCP no gestionados en los portátiles de los desarrolladores no tiene motivos de enrutamiento para quedarse.
TrueFoundry cobra relevancia cuando los equipos necesitan gobernar conjuntamente el enrutamiento de modelos, herramientas MCP, flujos de trabajo de agentes, presupuestos, barreras de seguridad y registros de auditoría, que es normalmente el punto en el que dos pasarelas de código abierto empiezan a parecer dos proyectos de cumplimiento independientes.
Una comparación útil entre LiteLLM y Obot AI comienza con la intención de migración. Algunos equipos quieren sustituir un servidor proxy. Otros quieren añadir gobernanza MCP en torno a agentes, herramientas de codificación y clientes de IA internos. Estos representan diferentes motivaciones de compra.
La diferencia principal radica en dónde comienza el enfoque de cada proyecto. La configuración de LiteLLM describe principalmente los modelos y las reglas para acceder a ellos. El catálogo de Obot comienza con los servidores MCP y las políticas que definen quién puede acceder a ellos. Ambos proyectos se han expandido desde entonces al territorio del otro.
LiteLLM proporciona ahora una única API a través de más de 140 integraciones, junto con presupuestos, enrutamiento, barreras de seguridad y seguimiento del uso. Su arquitectura de pasarela LLM caso de uso sigue siendo un entorno natural para comparar el enrutamiento consciente de modelos con un enfoque de proxy general. LiteLLM posiciona ahora su producto como una pasarela de IA que abarca el tráfico de LLM, MCP y agentes.
Ambas pasarelas tienen un punto de entrada gratuito de código abierto, por lo que el precio del software por sí solo no ofrece una comparación completa. El coste de propiedad también incluye infraestructura, observabilidad, identidad, actualizaciones y operaciones de la pasarela.
El nivel OSS de LiteLLM cubre más de 140 proveedores, usuarios, equipos, presupuestos, limitación de velocidad, alternativas, registro de solicitudes y métricas de Prometheus. Los precios empresariales se ajustan según la capacidad anual de solicitudes de la pasarela, la arquitectura de despliegue y los requisitos de soporte. La versión empresarial añade SSO, SCIM, autenticación OIDC o JWT, registros de auditoría, gestores de secretos, soporte multirregión y acuerdos de nivel de servicio (SLA).
Esto hace que LiteLLM sea más fácil de evaluar cuando los equipos ya conocen el volumen de solicitudes esperado. El análisis de precios de LiteLLM de TrueFoundry proporciona contexto adicional sobre la infraestructura y el TCO empresarial.
Obot también tiene una vía gratuita. Su modelo de edición actual admite hasta 100 usuarios y dispositivos por defecto. La versión comunitaria mantiene esos límites al tiempo que añade opciones de identidad como Microsoft Entra, Okta, JumpCloud y Auth0. La versión empresarial elimina esos límites y añade soporte formal.
Por tanto, la comparación debe incluir el alojamiento, las bases de datos, el almacenamiento de observabilidad, la gestión de claves, los requisitos de cumplimiento y el esfuerzo de ingeniería. LiteLLM requiere PostgreSQL para funciones como las claves virtuales. Obot requiere infraestructura para la pasarela y las cargas de trabajo MCP alojadas.
No del todo. Obot admite un acceso significativo a modelos, aunque LiteLLM sigue estando más centrado en el enrutamiento entre proveedores.
LiteLLM proporciona una interfaz unificada para muchos proveedores de LLM. Las aplicaciones utilizan una URL base de puerta de enlace, una clave y un nombre de modelo configurado. El enrutamiento puede distribuir el tráfico entre proveedores, regiones y credenciales, aplicando a su vez mecanismos de reserva y control de costes.
La puerta de enlace LLM de Obot sigue un modelo diferente. Expone puntos de conexión compatibles con proveedores para modelos de OpenAI y Anthropic, puntos de conexión de respuestas genéricas, AWS Bedrock y Azure. Una clave de API de Obot con alcance de proxy LLM sustituye a las credenciales directas del proveedor.
Los administradores aplican entonces políticas de acceso a modelos para controlar qué modelos puede ver y llamar cada usuario final. La lista de modelos devuelta contiene solo las opciones aprobadas. La puerta de enlace mantiene las credenciales de origen dentro de Obot en lugar de distribuirlas entre las aplicaciones.
Obot también puede configurar Google Vertex como proveedor en otras partes de la plataforma. Sin embargo, las rutas actuales de la puerta de enlace específicas para proveedores externos no exponen Google Vertex.
LiteLLM sigue siendo el punto de partida más sólido cuando la decisión se basa en el enrutamiento de solicitudes y la reserva entre proveedores. Obot es más fuerte cuando la gobernanza empresarial en torno a usuarios, agentes, modelos y sistemas MCP es la prioridad.
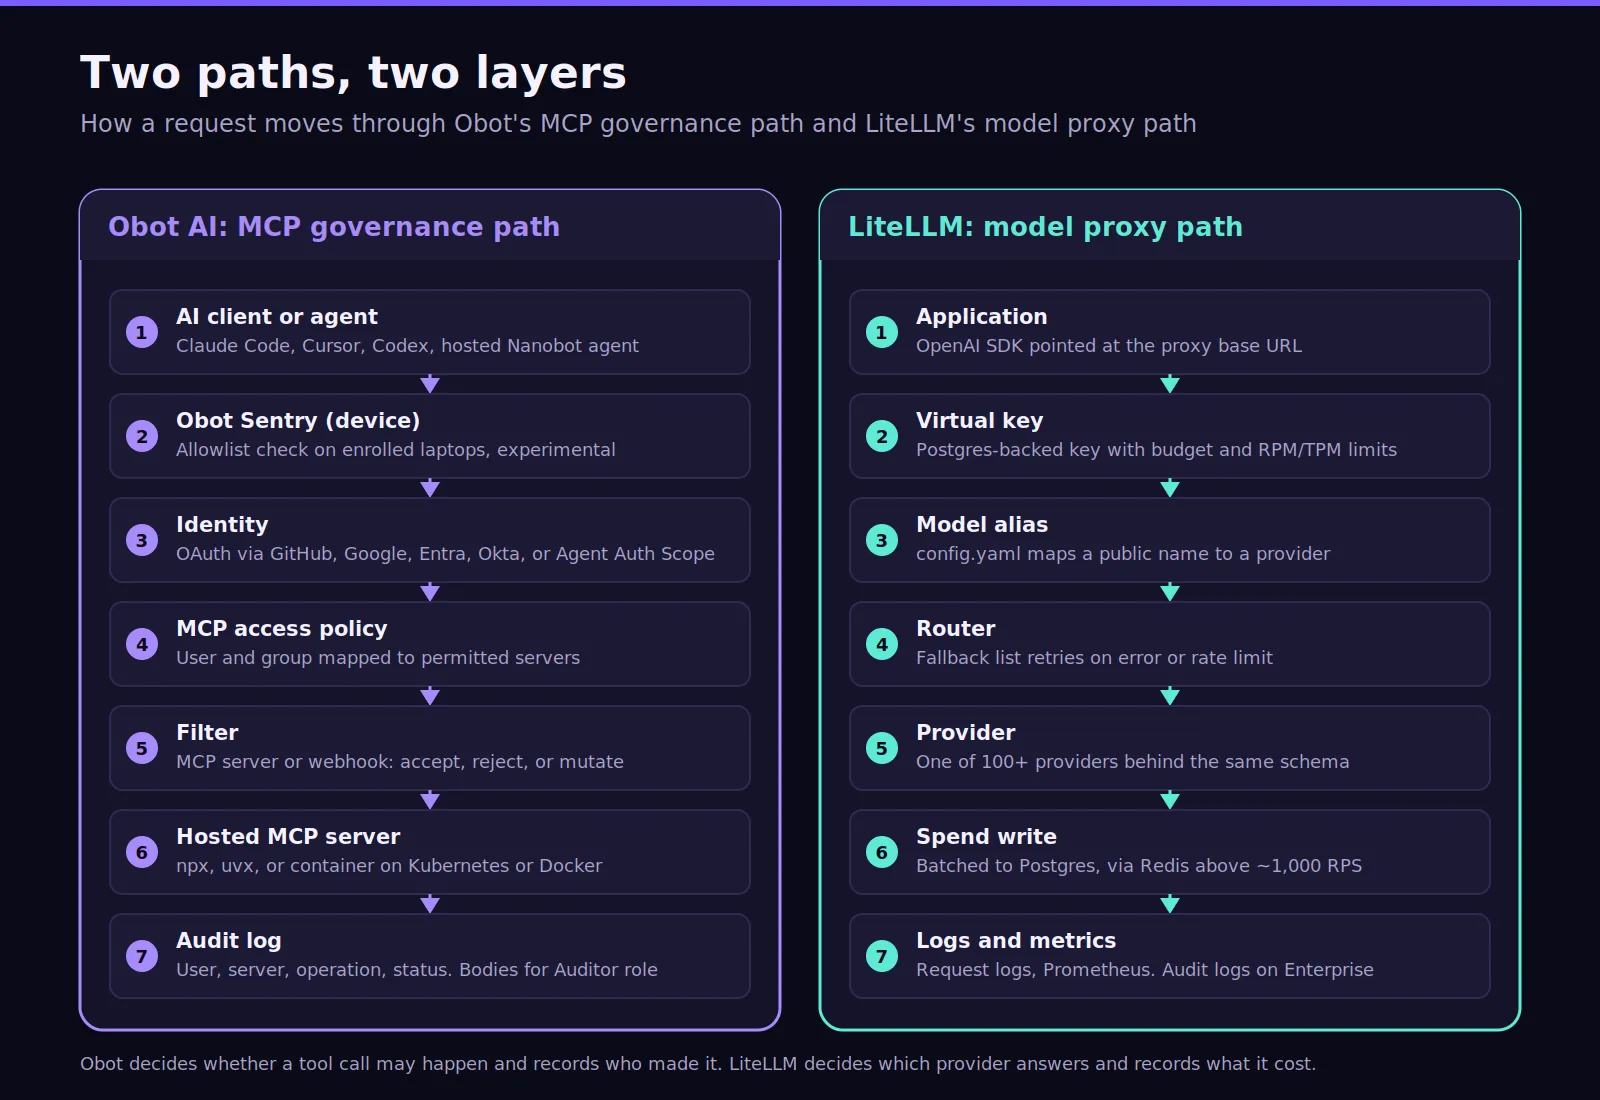
LiteLLM es más eficaz cuando las aplicaciones generan principalmente tráfico de LLM. La decisión cambia cuando un agente de IA comienza a llamar a herramientas, recuperar datos confidenciales o actuar a través de sistemas empresariales. En ese caso, el enrutamiento de modelos se convierte en una capa de control más.
LiteLLM merece reconocimiento en este aspecto, ya que sus capacidades actuales son más amplias de lo que sugieren las comparaciones antiguas. Su capa MCP presenta un punto de conexión fijo para servidores registrados. Los clientes se autentican utilizando el mismo modelo de credenciales de puerta de enlace, mientras que el acceso puede asignarse por clave o equipo.
La puerta de enlace de LiteLLM también separa la autenticación del cliente de los flujos OAuth de origen. Esto permite que la credencial de la puerta de enlace permanezca distinta de las credenciales OAuth del lado del servidor. Las herramientas de codificación como Claude Code pueden conectarse tanto al enrutamiento de modelos de LiteLLM como a los puntos de conexión MCP.
Obot profundiza más en las operaciones de MCP. Su MCP Gateway punto de comparación es la profundidad de alojamiento y políticas. Obot puede ejecutar cargas de trabajo MCP mediante npx, uvx, contenedores y de forma remota, al tiempo que aplica autenticación y autorización.
Las políticas de acceso de Obot asignan servidores aprobados a usuarios específicos o grupos de proveedores de identidad. Los filtros pueden inspeccionar llamadas a herramientas individuales y, a continuación, aceptar, rechazar o modificar las solicitudes antes de que continúen. Los filtros personalizados pueden admitir controles como el enmascaramiento de PII cuando sea necesario.
Obot Sentry también extiende la gobernanza hacia las herramientas de IA locales. La gestión de dispositivos puede inventariar la actividad de Claude Code, Codex, Cursor y VS Code. Esto crea una integración más profunda cuando la actividad del desarrollador local debe aparecer junto a los eventos de la puerta de enlace.
La observabilidad es otra diferencia práctica entre LiteLLM y Obot AI. Cada plataforma observa la capa que gobierna principalmente.
LiteLLM realiza un seguimiento del gasto, los presupuestos, el uso por clave o equipo, el comportamiento de las solicitudes, los resultados de los proveedores y la actividad de la puerta de enlace. Puede atribuir el uso de tokens entre claves, usuarios, equipos, organizaciones, herramientas, agentes y cargas de trabajo MCP.
Obot se centra más en las solicitudes MCP, la actividad del cliente local, las llamadas a modelos, los dispositivos y la gobernanza de la plataforma. Su sistema de auditoría correlaciona la actividad entre servidores MCP, proveedores de modelos, cargas de trabajo alojadas y dispositivos de usuario. Los administradores pueden filtrar la actividad por usuario, servidor, herramienta, proveedor, modelo, cliente, dispositivo o sesión.
Para los equipos de plataforma, la diferencia es importante. La observabilidad de modelos responde a qué modelo se llamó y cuánto costó. La observabilidad de MCP responde a qué identidad accedió a qué herramienta y qué sucedió después.
TrueFoundryanálisis de observabilidad de la puerta de enlace explica cómo la latencia, los errores, el gasto, las políticas y los seguimientos de los modelos pueden correlacionarse en la capa de puerta de enlace.
Migrar un proxy rara vez es la parte más difícil. El desafío consiste en migrar las suposiciones que ya están integradas en el código de la aplicación. Antes de realizar el cambio, los equipos deben comprobar:
Tres elementos requieren especial atención. Las aplicaciones de LiteLLM pueden usar alias públicos, mientras que Obot espera nombres nativos del proveedor para las rutas de puerta de enlace admitidas. Esto significa que los identificadores de modelo pueden convertirse en trabajo de migración en las aplicaciones de producción.
LiteLLM también conlleva un comportamiento de respaldo que no se asigna directamente al modelo de acceso a modelos de Obot. Las variables de entorno que contienen la configuración y las credenciales del proveedor pueden requerir actualizaciones a medida que cambian las responsabilidades entre las puertas de enlace.
Los modelos clave también difieren. LiteLLM utiliza credenciales de puerta de enlace que incluyen presupuestos y acceso. Obot puede emitir credenciales con alcance a través de la API de Obot, mientras que un token de Obot puede autenticar flujos de trabajo de cliente compatibles. Estos modelos de permisos no tienen una correspondencia uno a uno.
Por lo tanto, los equipos pueden mantener LiteLLM para los modelos mientras añaden Obot para MCP. Otra opción surge cuando los flujos de trabajo de agentes requieren políticas en ambas capas. TrueFoundry Agent Gateway proporciona cuotas de flujo de trabajo, seguimientos e identidad centralizada para agentes autónomos.
TrueFoundry sirve como capa de consolidación empresarial. Su puerta de enlace de IA empresarial proporciona enrutamiento, observabilidad, barreras de seguridad, presupuestos, aplicación de políticas y gobernanza de modelos. Puede ejecutarse a través de patrones de despliegue SaaS o controlados por el cliente.
La plataforma admite enrutamiento de proveedores, respaldo, limitación de velocidad y visibilidad de costes en más de 1600 modelos. Las políticas también pueden existir como YAML, lo que permite a los equipos revisar la gobernanza a través del control de versiones en lugar de mantener los controles de forma independiente dentro de las aplicaciones.
Las políticas presupuestarias pueden limitar el uso a usuarios, equipos, aplicaciones, modelos o entornos. Esto proporciona una aplicación en tiempo real antes de que continúen las costosas llamadas a LLM.
name: budget-limiting-configtype: gateway-budget-configrules: - id: 'coding-agents-daily' when: subjects: ['team:platform'] metadata: environment: 'production' limit_to: 200 unit: cost_per_day budget_applies_per: ['user'] alerts: thresholds: [75, 90, 100] notification_target: - type: slack-bot notification_channel: 'budget-alerts-channel' channels: ['#ai-spend']Si se superan los 200 $ al día, la puerta de enlace responde con un error 429 que incluye `error_origin_level: rate_limit_budget`, con el ID de la regla infringida en el encabezado `x-tfy-applied-rules`. El modo de auditoría rastrea la misma regla sin bloquear, lo cual es la forma segura de introducir un límite en un equipo que nunca ha tenido uno.
El MCP Gateway gestiona el acceso a las herramientas mediante un registro centralizado, RBAC por servidor, gestión de tokens OAuth 2.0 con actualización automática y servidores MCP virtuales que exponen un subconjunto seleccionado de herramientas de múltiples servidores como un único punto de conexión, sin necesidad de realizar un nuevo despliegue. Las directrices de seguridad (guardrails) se aplican a las llamadas de herramientas MCP en el mismo archivo de políticas que rige las llamadas a los LLM:
name: guardrails-controltype: gateway-guardrails-configrules: - id: github-tools-pii when: target: operator: or conditions: mcpServers: values: - github-mcp condition: in subjects: operator: and conditions: in: - team:platform llm_input_guardrails: [] llm_output_guardrails: [] mcp_tool_pre_invoke_guardrails: - pii/pii-detection mcp_tool_post_invoke_guardrails: []La capa MCP conecta la gobernanza de modelos con el acceso a herramientas, en lugar de tratar las herramientas como una preocupación más de la aplicación. La identidad federada, el RBAC, OAuth 2.0, la observabilidad y el registro de servidores dan soporte a las cargas de trabajo MCP empresariales.
Por tanto, TrueFoundry es una opción de plataforma única cuando los productos de proxy y MCP por separado generan políticas duplicadas. Los equipos también pueden comparar esta arquitectura directamente a través de la comparativa entre TrueFoundry y LiteLLM.
Elige TrueFoundry cuando:
TrueFoundry ofrece actualmente el plan Developer a 0 $ al mes, Pro a 499 $ al mes, Pro Plus a 2999 $ al mes y precios personalizados para empresas. La versión Enterprise admite despliegues de gateway y plano de control en VPC y entornos aislados (air-gapped)
Elija LiteLLM cuando el requisito inmediato sea el acceso a modelos, el enrutamiento de proveedores, los presupuestos, las alternativas de respaldo (fallbacks) y el seguimiento del gasto. Sigue siendo un candidato sólido cuando las cargas de trabajo de producción necesitan principalmente un gateway consciente de los modelos.
Elija Obot AI cuando la gobernanza MCP, la visibilidad del cliente de IA, el alojamiento de servidores, las políticas de acceso a modelos y los controles basados en la identidad impulsen la decisión. Es ideal para equipos que se enfrentan a la proliferación de MCP y a conexiones de herramientas de desarrollo no gestionadas.
Elija TrueFoundry cuando los modelos, las herramientas, los agentes, los presupuestos, las directrices de seguridad y la observabilidad requieran una arquitectura de gobernanza única. Este enfoque proporciona un control total sobre múltiples capas de IA sin necesidad de mantener sistemas de políticas separados.
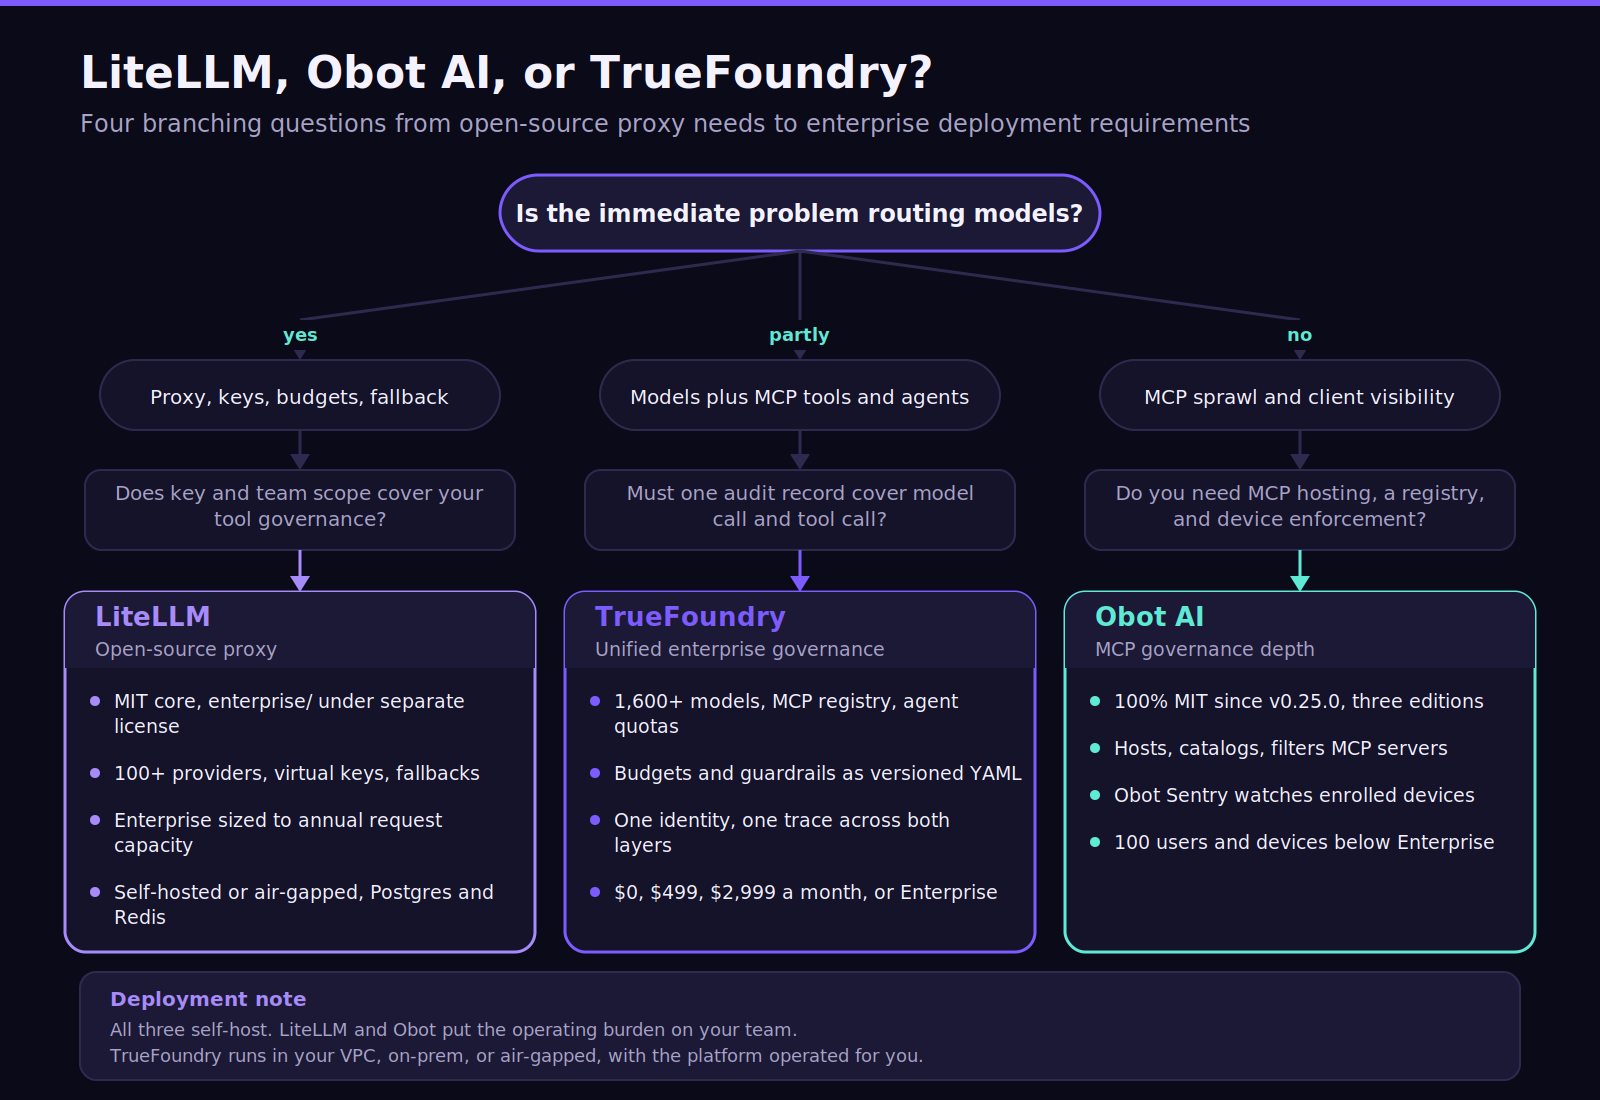
La decisión entre Obot AI y LiteLLM es, por tanto, una elección sobre la capa de inicio. La respuesta correcta depende de si el enrutamiento de modelos o la gobernanza MCP es la limitación operativa inmediata.
Los equipos que consideren otra ruta de API gateway, como Kong Gateway o Kong AI Gateway, deberían evaluar esa categoría por separado. Esas plataformas parten de preocupaciones más amplias sobre el tráfico de IA y la gestión de API.
Reserve una demostración gratuita hoy mismo para ver cómo TrueFoundry conecta la gobernanza de modelos, MCP y agentes en entornos de producción.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















