



October 22, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Crear una aplicación básica de LLM ya no es el desafío de ingeniería más difícil. La complejidad en producción aparece cuando los flujos de trabajo coordinan modelos, herramientas, memoria, recuperación, permisos y costes. Los equipos suelen descubrir que el framework elegido gestiona la lógica de ejecución, pero no aborda la gobernanza empresarial.
Los frameworks de orquestación de LLM coordinan llamadas entre modelos, herramientas, memorias y sistemas de recuperación. Una mala elección puede generar deuda técnica en el despliegue, la depuración, el escalado y el mantenimiento. El framework adecuado permite flujos de trabajo claros mientras los controles de infraestructura permanecen en una capa gobernada independiente.
Esta guía compara los principales frameworks de orquestación de LLM, sus puntos fuertes y sus limitaciones operativas. También explica cómo cambian los requisitos de producción bajo la orquestación a escala empresarial. Los equipos pueden aplicar estos criterios al trasladar prototipos a entornos gobernados.
La orquestación de LLM coordina modelos, herramientas, memorias y recuperación en un flujo de trabajo cohesivo. Una solicitud simple contiene un prompt y una finalización. Los flujos de trabajo orquestados conectan varias acciones de modelos a través de rutas de ejecución secuenciales, paralelas, condicionales o iterativas.
Un orquestador puede seleccionar una herramienta, consultar una base de conocimientos o solicitar la aprobación humana. Gestiona el estado, las transferencias, la memoria y la recuperación de datos a lo largo de una ejecución de varios pasos. Estas capacidades ayudan a los agentes de IA a completar tareas complejas que involucran múltiples sistemas.
La capa de orquestación define la comunicación, la invocación de herramientas y la persistencia del contexto. Coordina llamadas a API, API externas y otros servicios externos a través de la automatización de flujos de trabajo. Estos flujos de trabajo dan soporte a la atención al cliente, la investigación y las operaciones internas.
Un framework de orquestación suele indicar a los equipos empresariales tres cosas:
Una capa gobernada puerta de enlace de LLM (LLM Gateway) puede estandarizar el acceso a los modelos sin cambiar la lógica de orquestación. TrueFoundry proporciona una interfaz unificada con seguridad, observabilidad y gobernanza en todos los modelos compatibles.
Estos frameworks modernos admiten diferentes combinaciones de agentes, recuperación, herramientas, memoria y control de flujo de trabajo. Muchas opciones de código abierto priorizan la flexibilidad del código en las aplicaciones de IA. Algunas opciones introducen una curva de aprendizaje más pronunciada para los desarrolladores.
LangGraph utiliza una orquestación basada en grafos para gestionar flujos de trabajo de agentes con estado a través de rutas de ejecución complejas. Su capa de persistencia admite puntos de control, recuperación duradera, aprobación humana y depuración con viaje en el tiempo. Los equipos pueden inspeccionar estados anteriores, reanudar tareas interrumpidas y controlar con precisión la lógica de ramificación. Los controles de gobernanza empresarial siguen requiriendo una infraestructura independiente y capacidades centralizadas de aplicación de políticas.
Características principales
Ventajas y desafíos
Ideal para: Equipos de ingeniería que desarrollan sistemas multiagente complejos que requieren un estado duradero, lógica de ramificación, aprobaciones humanas, recuperación controlada y una depuración detallada del flujo de trabajo.
LangChain proporciona abstracciones reutilizables para modelos, agentes, herramientas, recuperación, middleware y flujos de trabajo de prompts. Su amplio ecosistema de integración conecta rápidamente bases de datos vectoriales, fuentes de datos empresariales y servicios externos. El framework permite un desarrollo rápido de aplicaciones, aunque los flujos de trabajo multiagente altamente estructurados pueden requerir un control de estado más sólido, durabilidad y capacidades de gobernanza de producción centralizada de forma segura.
Características principales
Ventajas y desafíos
Ideal para: Equipos de aplicaciones que desarrollan soluciones de LLM integradas que requieren una amplia conectividad con modelos, recuperación, herramientas y servicios empresariales en diversos casos de uso.
LlamaIndex se centra en conectar la información empresarial con los flujos de trabajo de modelos de lenguaje mediante la recuperación y la indexación. Sus abstracciones admiten la ingesta de documentos, la preparación de datos, la extracción y la consulta de bases de conocimiento a través de diversas fuentes. Los equipos pueden fundamentar las respuestas de manera eficiente en un contexto relevante, aunque la orquestación compleja de agentes y la gobernanza empresarial a menudo requieren plataformas y controles complementarios en otros lugares.
Características principales
Ventajas y desafíos
Ideal para: Equipos que desarrollan aplicaciones con alta carga de recuperación que requieren una fundamentación precisa en documentos, bases de conocimiento internas, bases de datos, archivos y otras fuentes de información empresarial.
CrewAI estructura los flujos de trabajo multiagente en torno a roles, responsabilidades, tareas, equipos y procesos definidos. Este diseño facilita la comprensión y configuración de la colaboración entre agentes en procesos complejos. Es compatible con memoria, herramientas, conocimiento, medidas de seguridad y observabilidad. Una mayor autonomía puede aumentar significativamente el número de llamadas al modelo, el consumo de tokens y los costes operativos durante un uso sostenido en producción.
Características principales
Ventajas y desafíos
Ideal para: Equipos que crean flujos de trabajo multiagente colaborativos donde la claridad de roles, las responsabilidades delegadas, las estructuras de ejecución legibles y la experimentación rápida son más importantes que minimizar el uso de tokens.

OpenAI Agents SDK ofrece bloques de construcción basados en código para herramientas, transferencias, medidas de seguridad, sesiones, aprobaciones y seguimiento. Su ejecutor coordina la actividad de los agentes y el uso de herramientas recurrentes en los flujos de trabajo. Los equipos logran una gran alineación con los modelos de OpenAI, aunque el estado persistente, la portabilidad entre proveedores y una gobernanza de infraestructura más amplia pueden requerir servicios adicionales o una implementación personalizada.
Características principales
Ventajas y desafíos
Ideal para: Equipos centrados en modelos de OpenAI que requieren orquestación basada en código, transferencias estructuradas, seguimiento, barreras de seguridad y ejecución flexible de herramientas en flujos de trabajo de agentes.
Microsoft Agent Framework permite el desarrollo de agentes y la orquestación de flujos de trabajo en .NET, Python y Go. Incluye estado de sesión, middleware, telemetría, puntos de control y ejecución basada en grafos. El marco se integra estrechamente con los entornos de Microsoft y Azure. Los equipos que operan en entornos multinube deben evaluar la portabilidad entre proveedores, la dependencia del ecosistema y los límites de datos externos antes de estandarizar las decisiones de adopción a nivel empresarial.
Características principales
Ventajas y desafíos
Ideal para: Empresas que utilizan tecnologías de Microsoft y Azure y necesitan orquestación con estado, telemetría, puntos de control, middleware y soporte de desarrollo en .NET, Python y Go.
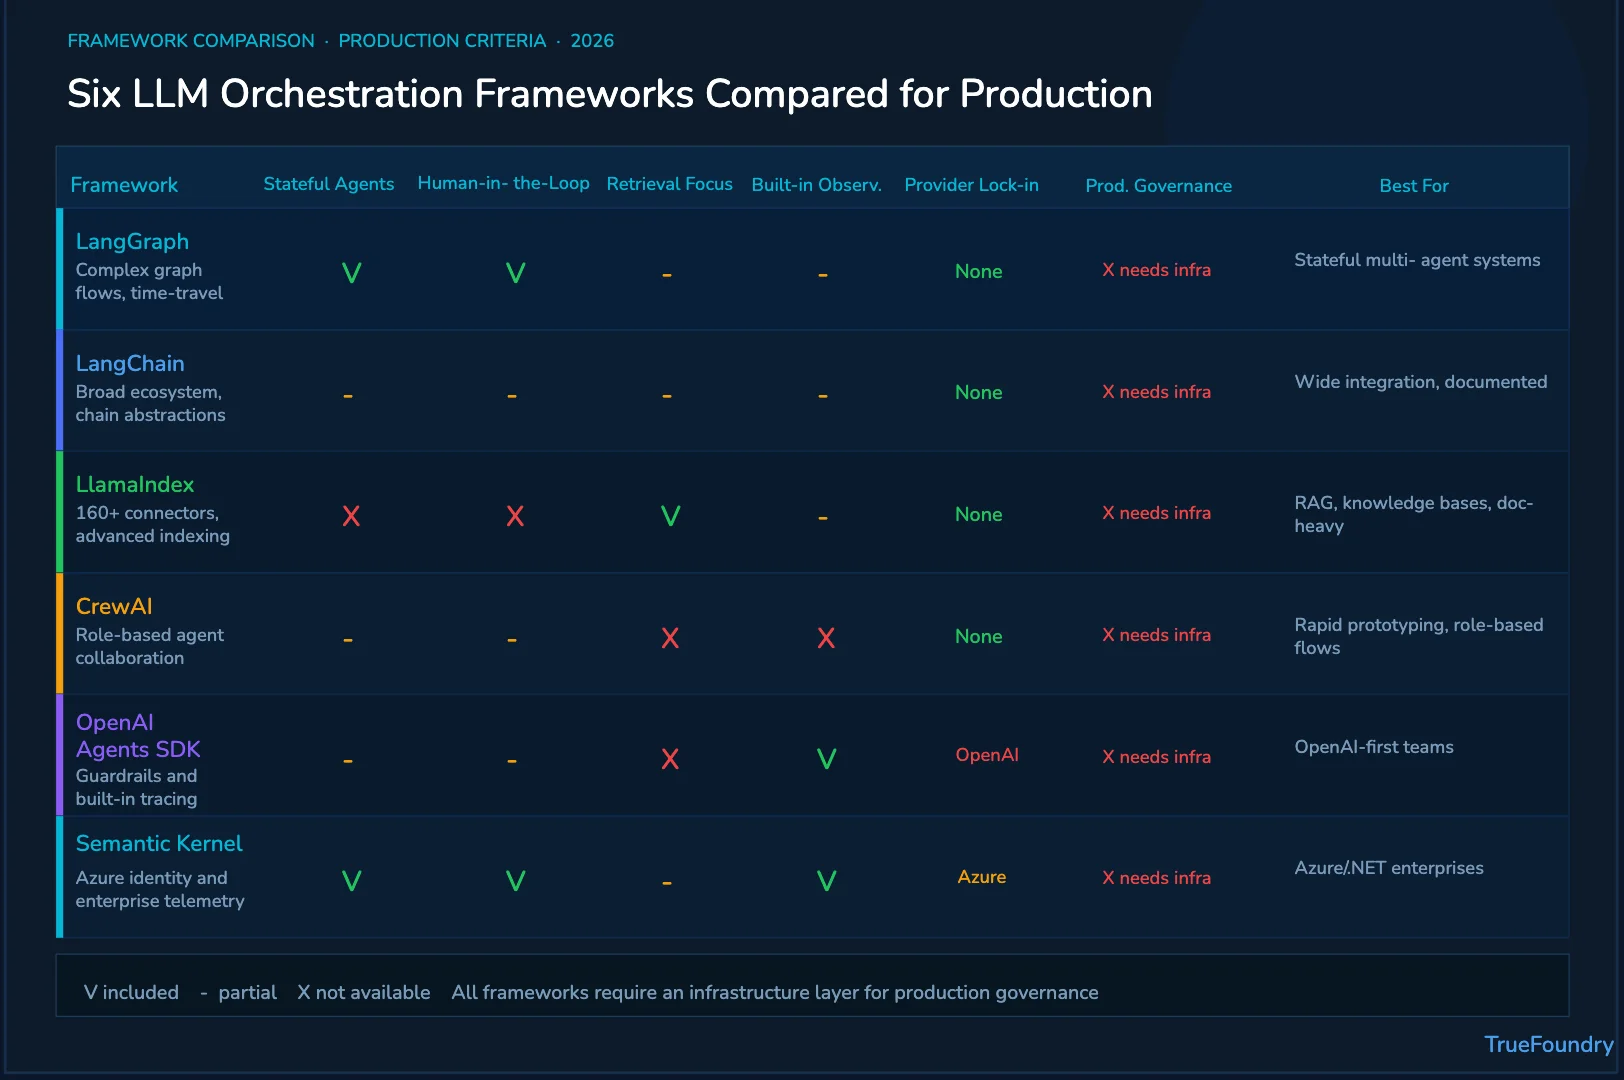
Las prácticas eficaces conectan el diseño del flujo de trabajo con una gobernanza de infraestructura independiente. Los equipos deben evaluar conjuntamente la calidad, la seguridad, la durabilidad del estado y el gasto. La elección del marco es importante, aunque el diseño operativo es lo que determina si los sistemas siguen siendo fiables a escala.
Los marcos definen la coordinación de los agentes, mientras que la infraestructura gobierna el acceso a modelos y herramientas. Esta separación evita que las políticas queden integradas en el código de la aplicación. Además, permite aplicar controles coherentes en todos los flujos de trabajo, proveedores e instancias de LLM.
Los agentes deben operar dentro del ámbito de permisos de cada usuario que inicia la acción. Las identidades compartidas pueden exponer información confidencial y permitir un acceso excesivo a los datos. La ejecución basada en la identidad restringe el acceso a herramientas y datos sensibles según los roles y las tareas aprobadas.
La latencia, el rendimiento y las tasas de error revelan el estado de la infraestructura, pero no pueden confirmar la precisión, la fundamentación o la selección correcta de herramientas. El monitoreo del rendimiento debe combinar métricas de rendimiento, precisión de recuperación, calidad de respuesta y comportamiento del flujo de trabajo.
Los totales de tokens no revelan qué flujos de trabajo generan valor empresarial. Los equipos deben vincular el gasto en modelos con los flujos de trabajo, los usuarios, los departamentos y los presupuestos. Este enfoque mejora la gestión de recursos a la vez que favorece un alto rendimiento y unos tiempos de respuesta controlados.
Los flujos de trabajo multiagente requieren un almacenamiento de datos fiable para las sesiones, los puntos de control y la recuperación. Un estado fallido puede provocar la repetición de acciones, la pérdida de contexto o la obtención de resultados incorrectos. Los equipos deben probar la recuperación de sesiones antes de realizar el lanzamiento a producción.
Los marcos de orquestación de LLM coordinan modelos, herramientas, memoria y la ejecución de flujos de trabajo. Las implementaciones empresariales también requieren controles que las bibliotecas de estos marcos suelen dejar en manos de los equipos de plataforma. Estas carencias se vuelven críticas cuando los sistemas procesan información regulada o ejecutan acciones autónomas.
Estas carencias también afectan a la gestión de prompts, a la ingeniería de prompts y al tratamiento de las entradas de los usuarios. Una arquitectura de puerta de enlace de IA centraliza estos controles por encima de los marcos de aplicación.
Los controles de producción deben proteger el lenguaje natural, el procesamiento del lenguaje natural y la generación de lenguaje natural. La gobernanza debe cubrir todos los modelos de lenguaje extensos y los servicios conectados.
TrueFoundry proporciona infraestructura sobre marcos de orquestación de LLM sin reemplazar la lógica del flujo de trabajo. El puerta de enlace de IA (AI Gateway) enruta, asegura, observa y gobierna el tráfico de los marcos compatibles. Las aplicaciones conservan sus bloques de construcción preferidos mientras las políticas permanecen coherentes.
Esta arquitectura es compatible con la IA generativa en todos los marcos y proveedores admitidos. TrueFoundry añade gobernanza sin obligar a los equipos a rediseñar sus componentes principales o diversos componentes. Admite inteligencia artificial en producción preservando la flexibilidad del marco.
Reserve una demostración para ver cómo TrueFoundry gobierna la orquestación entre modelos, agentes, herramientas, flujos de trabajo, proveedores, identidades, costes y entornos de producción.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















