


November 13, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Un juez es un modelo al que se le proporcionan tres elementos: una salida que debe evaluar, una rúbrica que define qué se considera "bueno" y una instrucción para devolver un veredicto legible por máquina (aprobado/reprobado, una puntuación o una preferencia entre dos candidatos).
Su uso se justifica porque la alternativa no es escalable. Las métricas de coincidencia exacta funcionan cuando solo existe una respuesta correcta; sin embargo, carecen de utilidad para una respuesta de soporte donde cinco opciones distintas son igualmente válidas. Los evaluadores humanos las juzgan bien, pero con lentitud. Un juez se sitúa en un punto intermedio: es inferior a un humano meticuloso, pero infinitamente superior a una comparación estricta de cadenas de texto, y resulta lo suficientemente rápido como para procesar miles de muestras. Debe considerarse como una aproximación económica, con cierto ruido pero correlacionada con el criterio humano.
El error más habitual en este ámbito consiste en tratar la evaluación offline y el filtrado en línea como si fueran un mismo concepto con dos entornos de despliegue diferentes.
La fila correspondiente al modo de fallo es la más importante de asimilar. En modo offline, una puntuación incorrecta cuesta una decisión que se puede revisar en el siguiente sprint; en línea, supone un usuario observando un error en pantalla. Por ello, es necesario ajustar un juez en línea primando la precisión, incluso a costa de la cobertura (recall). Copiar una rúbrica idéntica entre ambos modos es la razón por la que muchos equipos terminan bloqueando un porcentaje del tráfico legítimo.
Los jueces destacan en criterios que son descriptibles pero no computables (por ejemplo, verificar si una respuesta está fundamentada en el contexto recuperado o si el tono es adecuado para un entorno clínico). Se puede redactar la regla en un párrafo, pero no expresarla mediante una regla de regex. Fallan principalmente en tres escenarios.
Sesgo de posición. Al evaluar dos opciones candidatas, los jueces suelen favorecer una posición determinada; si se invierte el orden, una proporción significativa de los veredictos cambia. La solución pasa por evaluar cada par dos veces intercambiando las posiciones y contabilizar únicamente las coincidencias, lo que duplica el coste.
Sesgo de verbosidad. Las respuestas más extensas reciben puntuaciones más altas, independientemente de si las palabras adicionales aportan valor real. Esto impulsa de forma sutil los prompts de producción hacia el relleno: se optimiza en función del juez, el juez premia la longitud, la factura de tokens aumenta y nadie conecta ambos factores.
Autopreferencia. Un modelo evalúa con mejor nota el texto que se asemeja a sus propias generaciones. Si GPT juzga la salida de GPT, la puntuación se ve favorecida artificialmente; este es el argumento más sólido para utilizar un juez de una familia diferente a la del modelo evaluado.
Los jueces también muestran una deficiente calibración en escalas continuas: si se solicita una puntuación del 1 al 10, la mayoría de los resultados se concentran en el 7 y el 8. Un veredicto binario de aprobado/reprobado frente a un criterio estricto resulta mucho más fiable. Además, un juez no puede verificar un hecho que desconoce: sin material de referencia de entrada, ofrecerá sus sesgos previos en lugar de una comprobación de hechos real.
Debe pertenecer a una familia diferente a la del modelo evaluado, ya que el sesgo de autopreferencia es real y fácil de evitar. Debe ser más pequeño de lo que piensa, porque juzgar consiste en una clasificación frente a un prompt largo, no en un razonamiento complejo. Utilice versiones fijadas, no flotantes, ya que un alias de proveedor que se actualice automáticamente puede alterar su nivel de calidad sin realizar cambios en el código. Y debe ofrecer un p99 inferior al elemento que protege; de lo contrario, el juez se convertirá en el cuello de botella de su latencia.
A continuación, el cálculo financiero. Un juez en línea representa una segunda inferencia; si analiza tanto el prompt como la respuesta, supone dos inferencias adicionales. Esto no es un coste marginal que se pueda eliminar mediante ingeniería, por lo que la cuestión radica en determinar a qué fracción del tráfico se aplica:
Si puede expresar la regla mediante código, exprésela mediante código.
Trasladar la rúbrica offline directamente a la ruta de la solicitud. Una rúbrica de diez dimensiones que funciona correctamente en una ejecución nocturna se convierte en un filtro lento y de alta varianza al pasar a producción. Las rúbricas en línea deben centrarse en un único criterio, ser binarias y estar redactadas de forma lo suficientemente precisa como para que un modelo pequeño responda de manera consistente.
No medir nunca el rendimiento del propio juez. Se trata de un modelo en producción que carece de su propia evaluación. Etiquete manualmente unos cientos de ejemplos reales y analice la precisión y el recall de forma independiente. Si no puede determinar la tasa de falsos positivos, tampoco podrá saber a qué porcentaje de usuarios está fallando la barrera de seguridad.
Aplicar el bloqueo directo desde el primer momento. Un juez con una precisión del 90% bloqueará una de cada diez respuestas correctas el mismo día que active el modo estricto. Realice primero una auditoría, analice una semana de trazas y, posteriormente, aplique el bloqueo.
Olvidar las respuestas en formato streaming. Al enviar tokens de forma fluida al navegador, el juez de salida no tiene contenido que evaluar hasta que el stream finaliza. La mayoría de los gateways, incluido TrueFoundry, omiten las barreras de seguridad de salida en las solicitudes con streaming.
TrueFoundry no es un producto de evaluación. No dispone de una sección dedicada a evals, ni de gestión de datasets, ni de seguimiento de experimentos, ni de interfaz para puntuaciones. La evaluación offline corresponde a plataformas diseñadas específicamente para tal fin, siendo la función de TrueFoundry la exportación de trazas mediante OpenTelemetry (trazas, no métricas OTEL, desde esa pantalla). Para gestionar un conjunto de datos puntuado y una tabla de clasificación, utilice Braintrust, Arize o una alternativa equivalente apuntando el exportador hacia dicha plataforma.
TrueFoundry implementa la variante en línea: un juez que actúa como barrera de seguridad en la ruta de la solicitud, registrando su veredicto, latencia y consumo de tokens en la misma traza que la solicitud protegida.

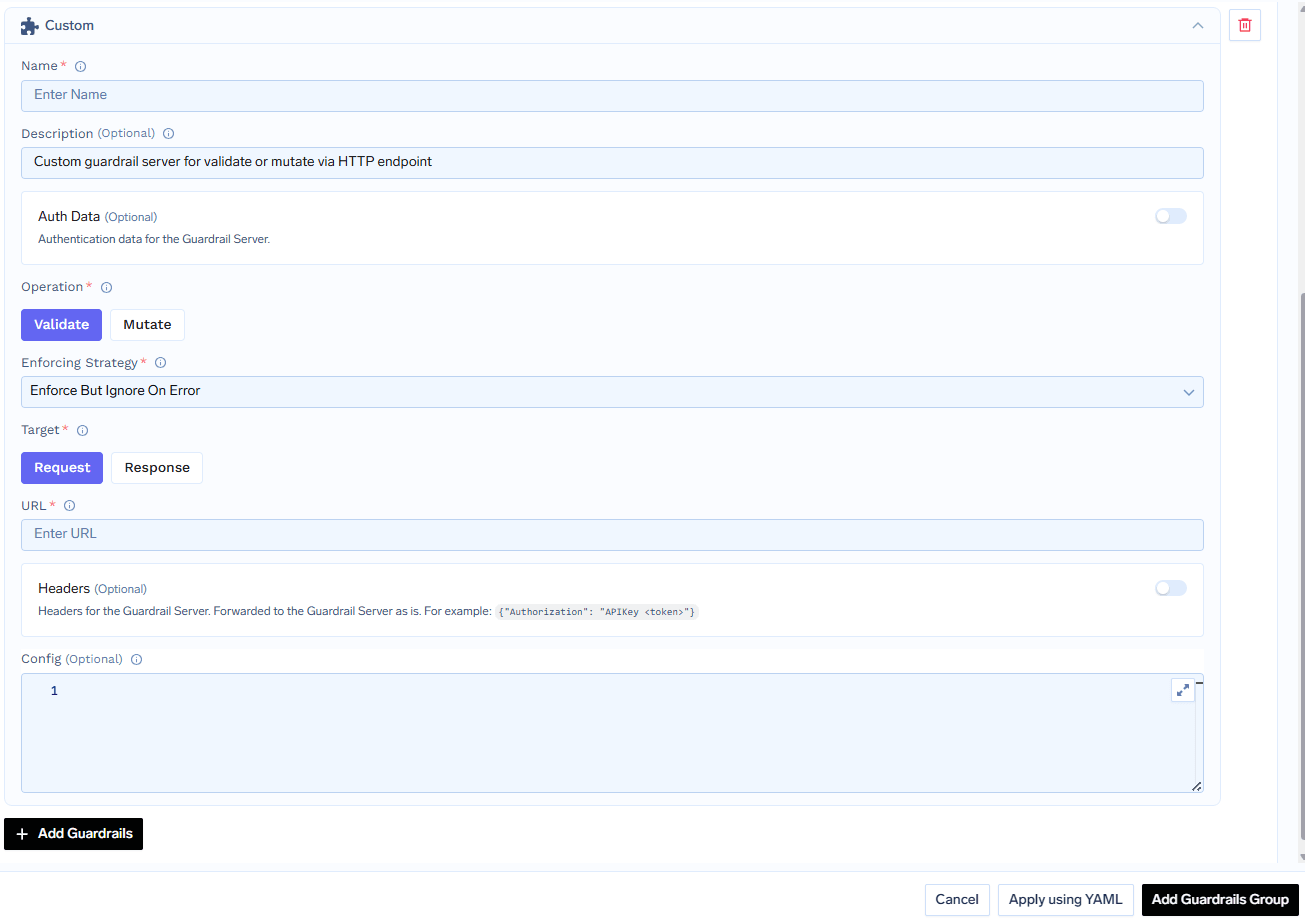
Cada uno de los jueces descritos a continuación es un servicio independiente que usted despliega, el cual es invocado por el gateway como una regla a través del contrato de barreras de seguridad personalizadas (custom guardrails). Este contrato incluye una regla fundamental: un código HTTP 2xx indica que la barrera de seguridad completó su ejecución correctamente, residiendo la decisión de la directiva exclusivamente en el cuerpo JSON. La documentación advierte que un estado de "bloqueado" devuelto como HTTP 400 puede interpretarse como un error de tiempo de ejecución y permitir el paso de la solicitud. Devuelva 2xx con verdict: false.
NeMo se ejecuta como un wrapper de FastAPI desplegado en TrueFoundry, sin realizar llamadas nativas al SDK de NeMo desde el gateway ni requerir cambios en el SDK del cliente en su aplicación. Internamente, utiliza un LLM juez de menor tamaño junto con Colang (un lenguaje específico de dominio) para evaluar prompts y respuestas a través de las barreras self_check_input y self_check_output. La rúbrica reside en el paquete de Colang, donde el archivo config/prompts.yml contiene ejemplos few-shot que en su versión v1 detectan juegos de rol tipo DAN, instrucciones del tipo "ignore previous instructions", extracción del prompt del sistema y marcadores de elusión de directivas.
El detalle operativo clave: el LLM juez realiza llamadas de retorno a través del propio gateway de TrueFoundry. El archivo .env del wrapper contiene TFY_BASE_URL, TFY_API_KEY y JUDGE_MODEL (el ejemplo de la documentación utiliza openai-main/gpt-4o-mini). Dado que la inferencia del juez genera tráfico en el gateway, sus tokens, costes y latencias se reflejan en los mismos paneles de control que el resto de las operaciones, lo que permite visualizar el coste real de las barreras de seguridad. Cambiar de juez requiere modificar una sola línea: ajuste JUDGE_MODEL (la documentación muestra openai-main/gpt-4o) y vuelva a desplegar.
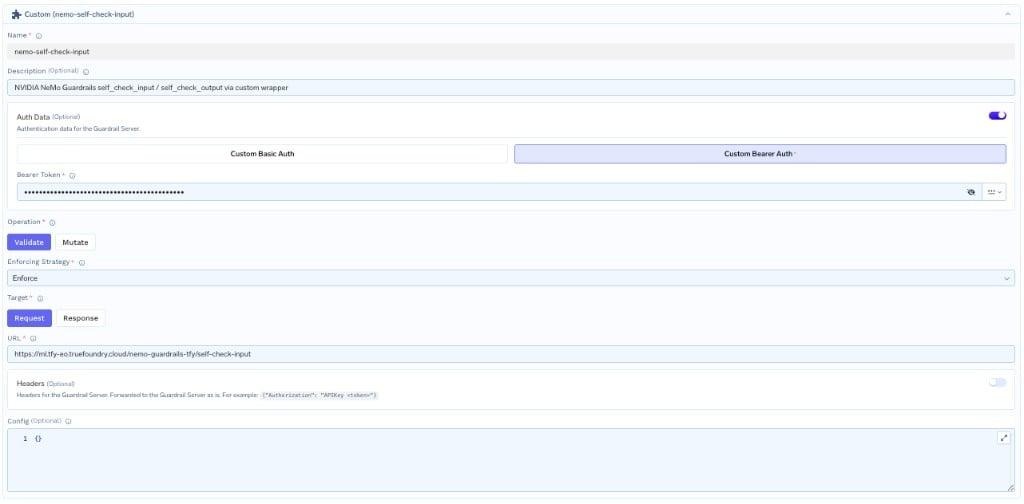
Registre dos configuraciones de barreras personalizadas (Custom Guardrail Configs), ambas de tipo Validate —con los selectores nemo-self-check/nemo-self-check-input y .../nemo-self-check-output— recomendando la opción Enforce But Ignore On Error. El contrato del veredicto es conciso: HTTP 200 acompañado de {"verdict": bool, "message": Optional[str]}; un fallo real del servicio devolverá un código 5xx.
El gateway envía la llamada de la barrera de entrada y la llamada al modelo en paralelo, evitando que el juez añada tiempo de espera hasta el primer token (time-to-first-token); en caso de bloqueo, cancela la llamada al modelo que está en curso. La barrera de salida se ejecuta de forma secuencial por necesidad estructural.
La documentación expone de forma transparente este coste. Entre las limitaciones conocidas, indica literalmente: cada solicitud protegida suma una o dos llamadas adicionales al LLM, una por cada dirección. Asimismo, señala que no existen barreras adaptadas para streaming debido a que el contrato procesa datos en búfer, y que el estado en memoria se mantiene de forma independiente por réplica.
Patronus representa la solución más directa de tipo "llave en mano" del catálogo, operando exclusivamente en modo Validate-only (su función es únicamente validar y la documentación confirma que no puede aplicar mutaciones).
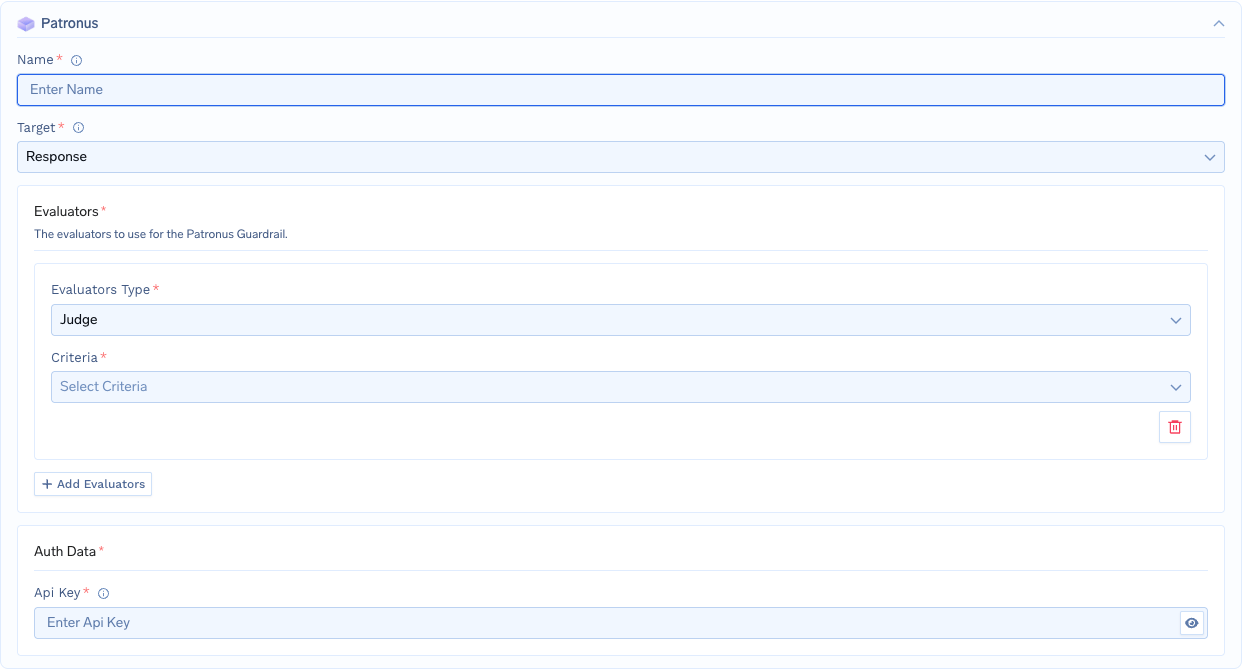
El tipo de configuración corresponde a integration/guardrail-config/patronus. Defina target como request o response y, a continuación, especifique los evaluadores; existen seis tipos disponibles: answer-relevance, glider, judge, pii, phi y toxicity. El tipo judge corresponde al enfoque de LLM como juez, siendo su campo criteria obligatorio. Los quince valores documentados son los siguientes:
La familia equivalente glider añade cinco criterios adicionales: patronus:is-compliant, patronus:is-factually-consistent, patronus:is-good-summary, patronus:is-harmful-advice y patronus:is-informal-tone.
Al contrastar esto con la tabla de decisiones anterior, la diferencia resulta clara: is-json e is-csv son comprobaciones de formato que un validador resuelve de forma más eficiente y económica, mientras que no-harmful-therapeutic-guidance e is-good-summary constituyen los criterios basados en texto explicativo para los que está diseñado un juez.
Si el parámetro data.results[].evaluation_result.pass es false, la solicitud se bloquea y se devuelve un código 400. El ejemplo de respuesta de la documentación muestra los campos evaluator_id: "judge-large-2024-08-08", evaluator_family: "Judge", profile_name: "patronus:prompt-injection", pass: false, score_raw: 0, evaluation_duration: "PT4.44S", usage_tokens: 687 y evaluation_metadata.highlighted_words. Aunque la documentación menciona tiempos de respuesta de hasta 100 ms, esa duración de 4,44 segundos del ejemplo evidencia que los valores máximos de latencia de un juez difieren de su mediana.
La mayor parte de Guardrails AI está diseñada deliberadamente para no actuar como un juez. Su conjunto de componentes v1 —DetectPII, SecretsPresent, ToxicLanguage, ProfanityFree a lo largo de siete endpoints— se ejecuta de forma local dentro del pod del wrapper, sin llamadas adicionales al LLM por solicitud y con una latencia estable inferior a 100 ms.
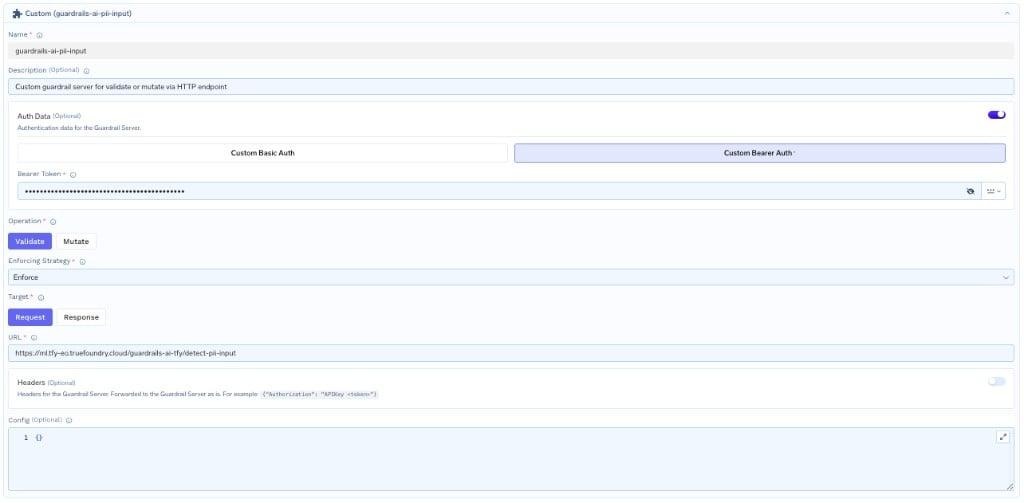
Los validadores basados en jueces constituyen un nivel opcional del Hub: hub://guardrails/restricttotopic (evaluado mediante LLM), hub://guardrails/provenance_llm —marcado en la documentación como costoso— y hallucination_check. Se configuran mediante variables de entorno LITELLM_* y se enrutan a través de su gateway para mantener una observabilidad unificada, siguiendo el mismo patrón que emplea NeMo para JUDGE_MODEL. Junto a ellos existen alternativas más económicas: competitor_check se basa en listas de permitidos y regex_match es, según la propia documentación, una opción de bajo coste.
La página sobre alucinaciones de TrueFoundry describe cuatro tipos —factual, contextual, lógica y de fuente— y únicamente dos vías de implementación: AWS Bedrock Guardrails, donde se activan las opciones de Grounding y Relevance, se establece la acción en Block y se define un umbral; o la creación de una barrera personalizada basada en el repositorio de plantillas.
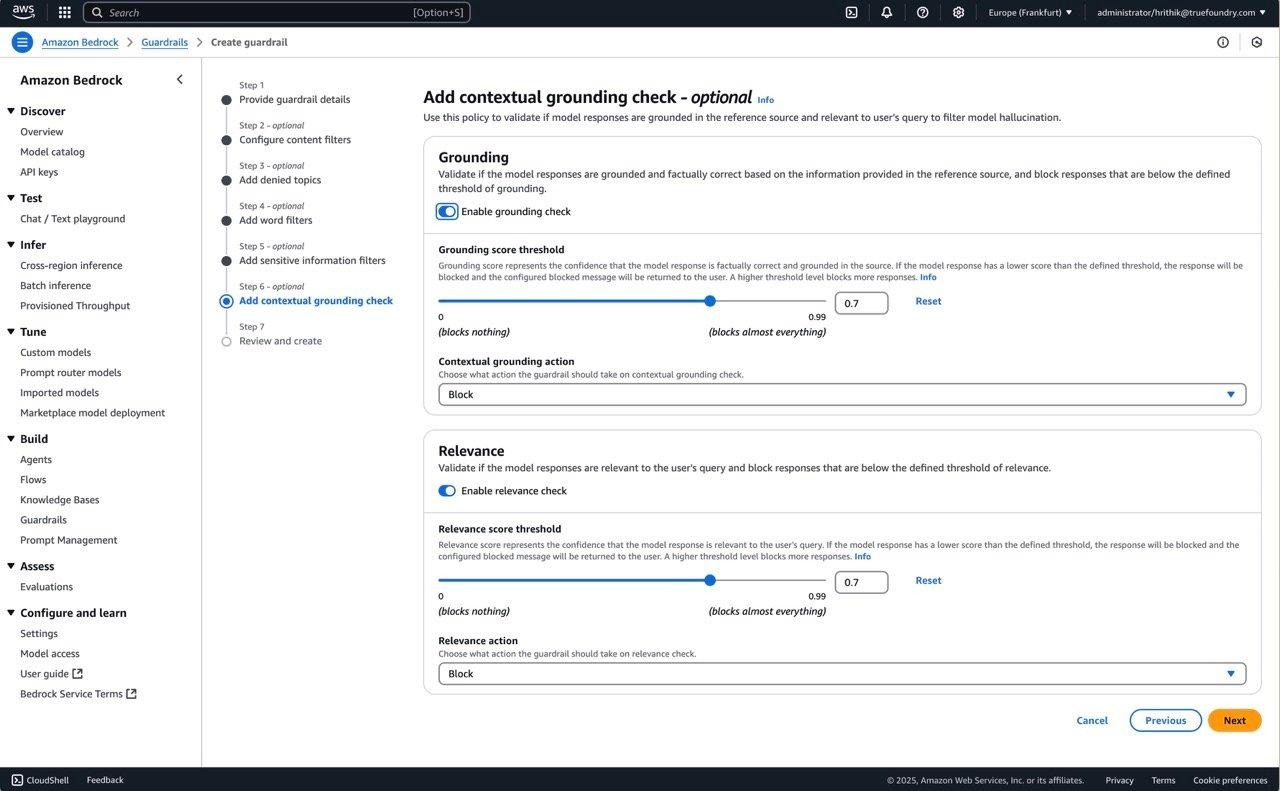
La documentación aclara explícitamente que el repositorio de plantillas no incluye actualmente una barrera de alucinaciones integrada por defecto, sino que ofrece ejemplos como la redacción de PII o el filtrado de contenido NSFW. La implementación personalizada requiere un desarrollo específico.
El Playground ejecuta las cuatro fases de captura (hooks), lo que permite enviar un prompt malicioso contra la barrera de entrada antes de aplicar cualquier directiva en producción.
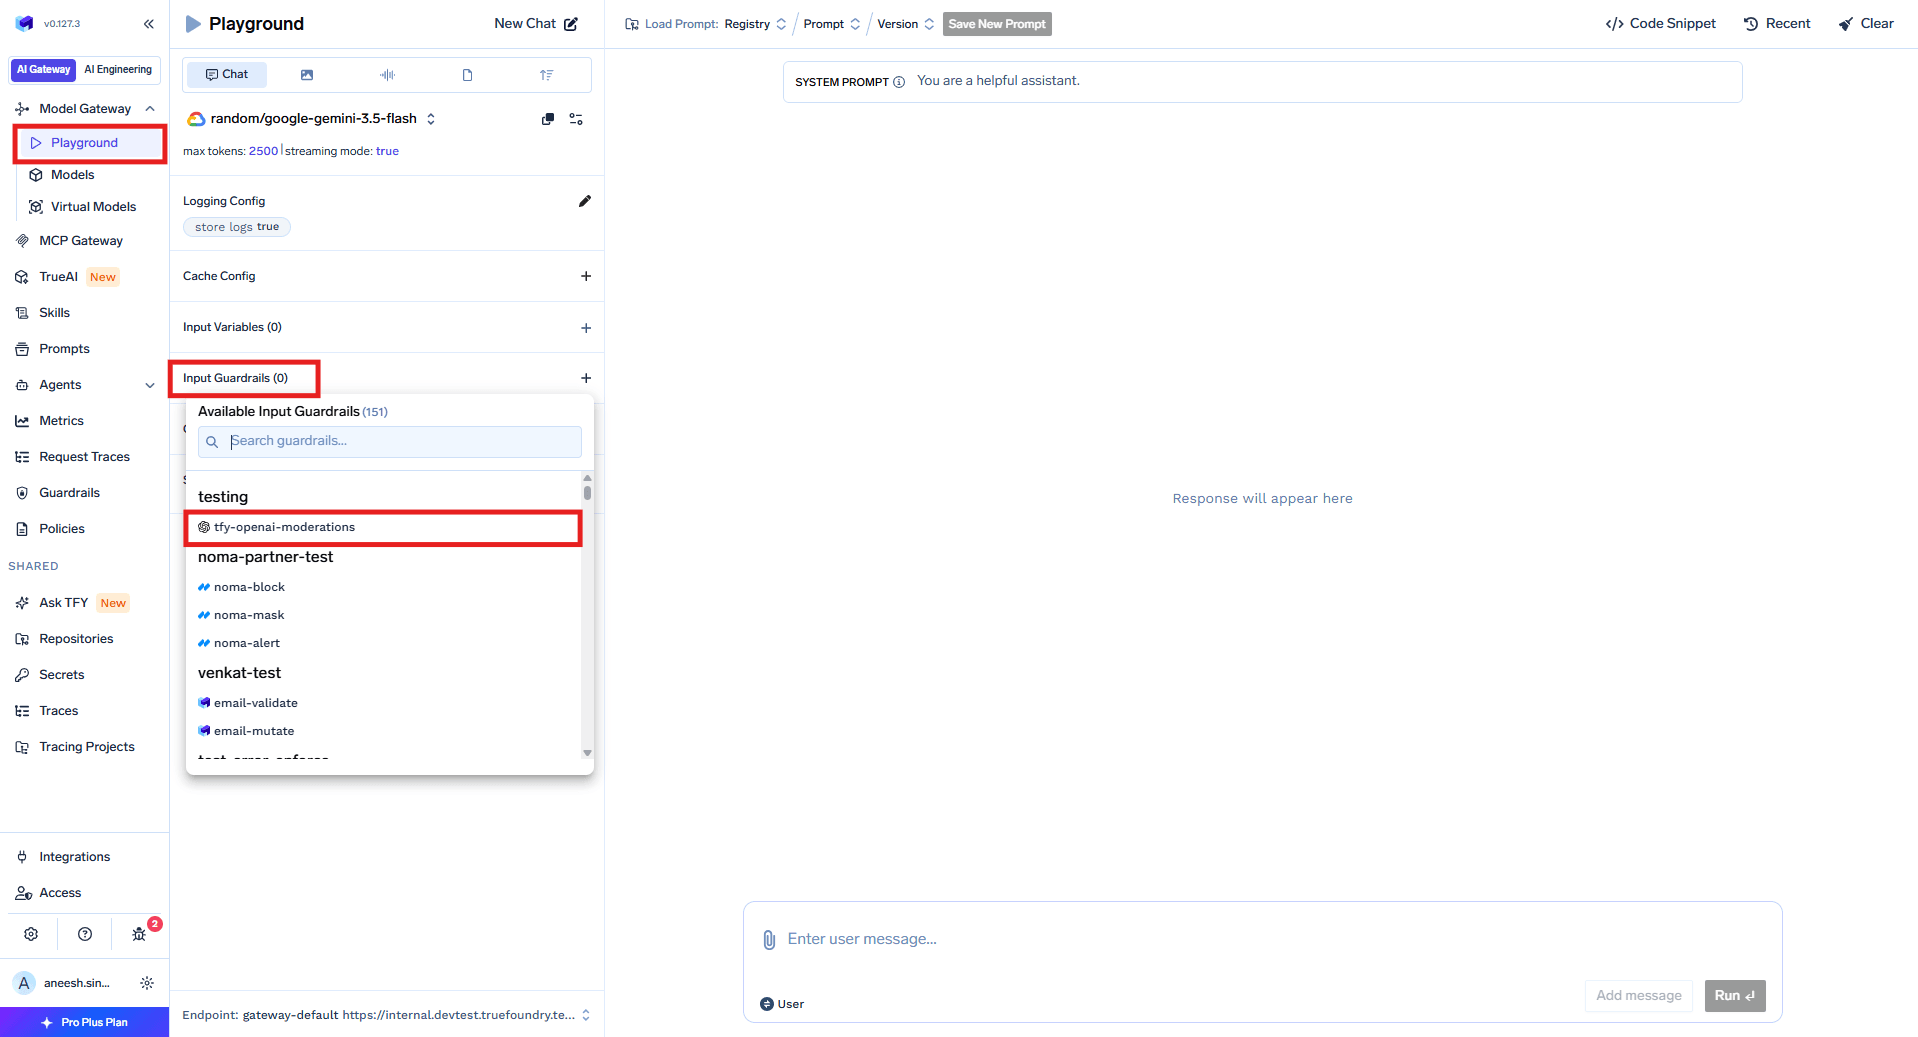
Una vez en producción, cada evaluación de una barrera de seguridad genera su propio span en Monitor → Request Traces, incluyendo el tiempo de ejecución, el resultado, el alcance, la entrada y la salida; esto se registra también para las solicitudes bloqueadas, garantizando que una llamada rechazada deje evidencia trazable.

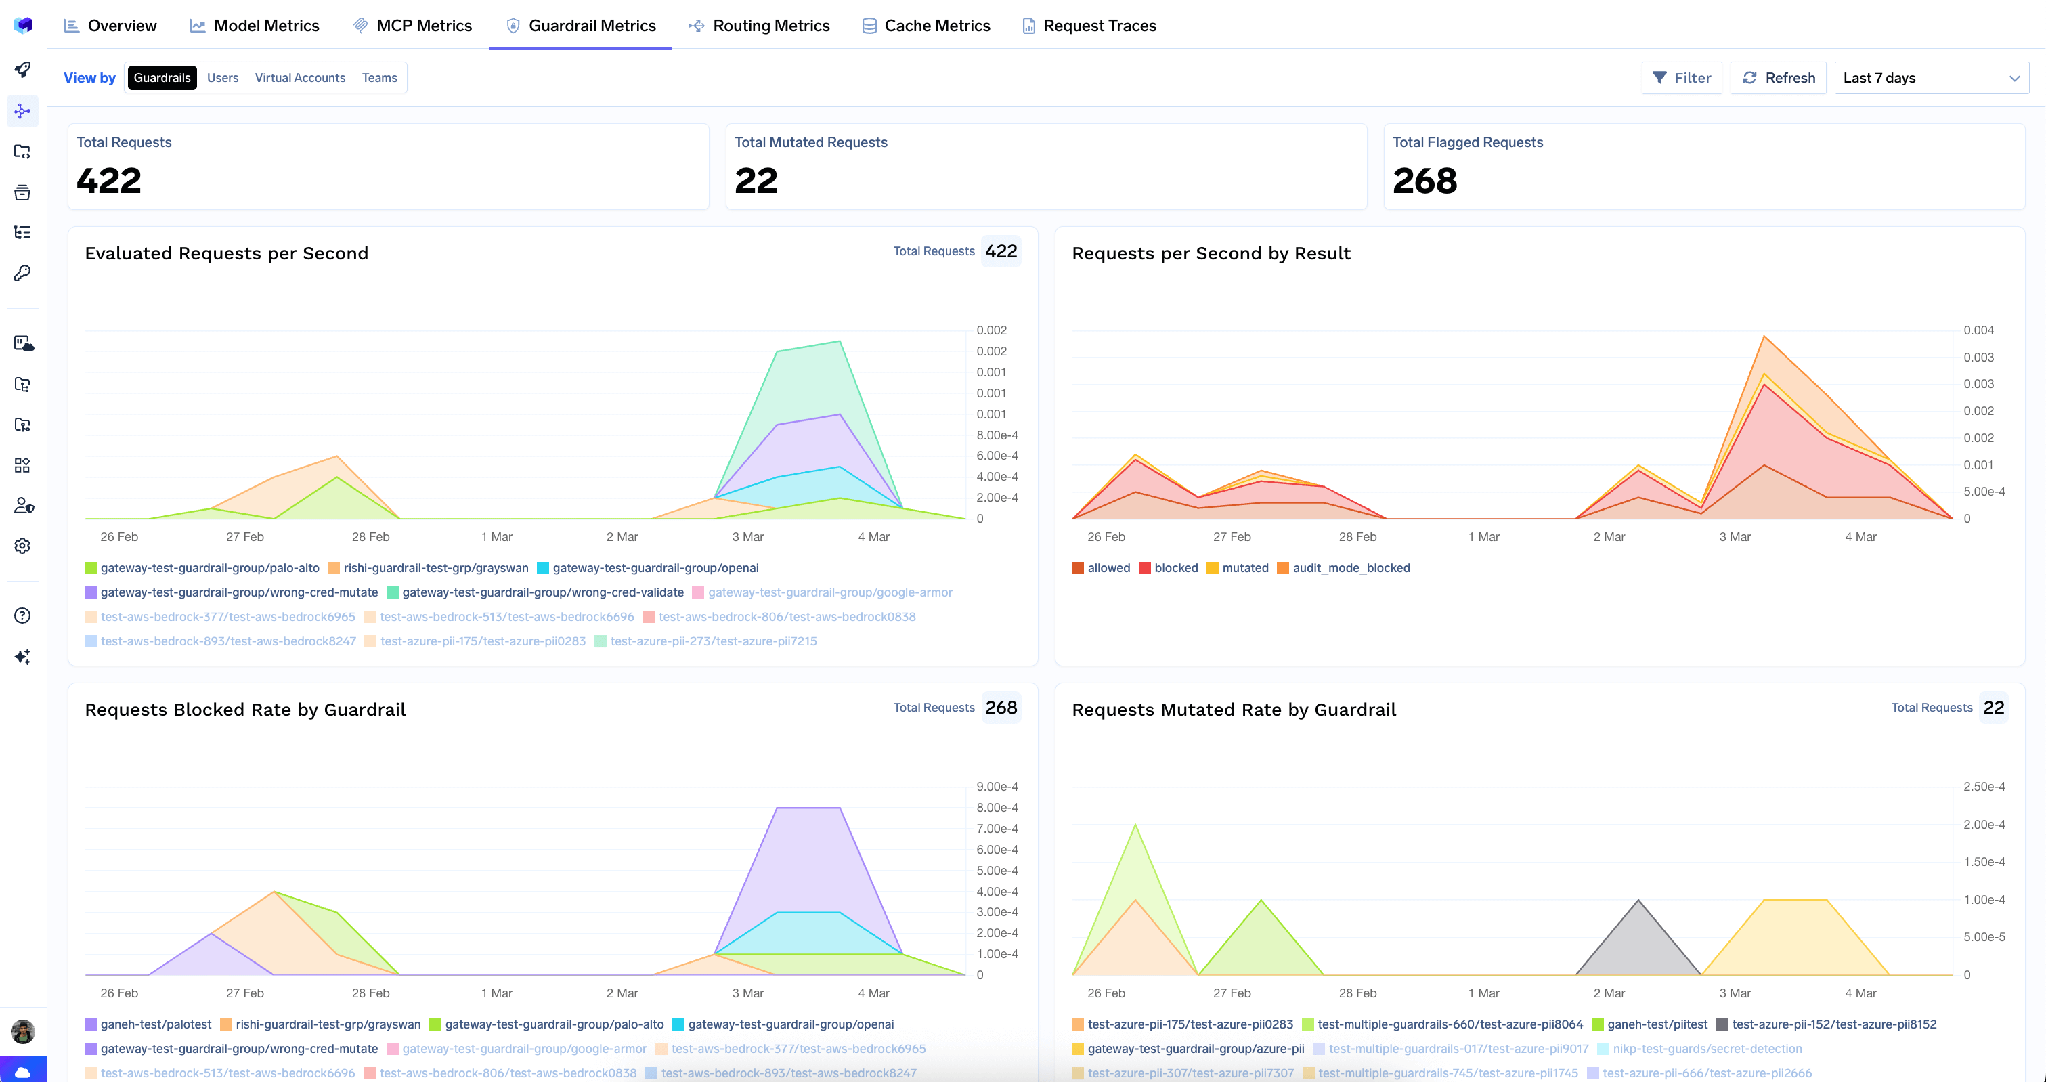
De forma agregada, la vista de barreras de seguridad en el Metrics Dashboard desglosa las solicitudes por segundo en permitidas, bloqueadas, mutadas y audit_mode_blocked, mostrando las tasas de bloqueo y mutación por barrera, así como la latencia de las barreras en los percentiles P50, P75, P90 y P99. Este último gráfico es fundamental para identificar si el comportamiento extremo de un juez está afectando a la latencia global del sistema.
El veredicto de un juez constituye una estimación sobre la calidad, siendo la evaluación humana sobre la misma solicitud la única forma de validar su precisión. Cada respuesta emitida por AI Gateway incluye la cabecera x-tfy-feedback-target-id. Envíe una solicitud de tipo POST a https://{control_plane_url}/api/svc/v1/gateway-feedback con la estructura {"target": {"feedbackTargetId": "<base64>"}, "rating": 4, "comment": "...", "metadata": {...}} —donde rating acepta valores de 1 (mínimo) a 5 (máximo)— para recibir una respuesta del tipo {"data": {"id": "..."}}. Las modificaciones se realizan mediante PUT .../gateway-feedback/{feedback_id} y las eliminaciones con DELETE. Esta información se muestra junto al span correspondiente, quedando el registro completo disponible en Raw Data bajo la etiqueta tfyGatewayFeedbacks.
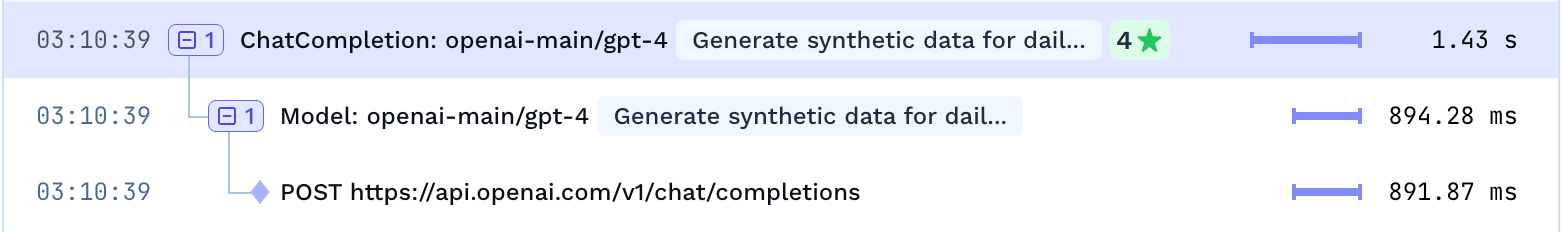
Una limitación a tener en cuenta: el ID de destino hace referencia exclusivamente al span raíz, por lo que la retroalimentación se vincula a la solicitud global y no a un paso intermedio.
Imaginemos un asistente interno que responde a preguntas de coordinadores de atención médica. El departamento de cumplimiento exige dos condiciones: no ofrecer nunca orientación terapéutica perjudicial y mantener un tono clínicamente adecuado. Al no ser posible expresar estos requisitos mediante expresiones regulares, nos encontramos en el escenario idóneo para aplicar un juez.
1. Seleccione la rúbrica más acotada posible. Defina únicamente dos criterios de juez en Patronus en lugar de diez —patronus:no-harmful-therapeutic-guidance y patronus:clinically-inappropriate-tone— con el parámetro target: response. El resto de requisitos del departamento de cumplimiento se delega en detectores más económicos.
2. Inicie la operación en modo Audit. Configure una regla de directiva en AI Gateway → Policies → Guardrails limitando su alcance a los modelos del asistente y al equipo de coordinadores, aplicando la estrategia Audit: esta opción registra el veredicto sin efectuar bloqueos.
3. Analice el registro de trazas durante una semana. La métrica audit_mode_blocked indica cuántas solicitudes reales habría bloqueado esta regla; por su parte, evaluation_metadata.highlighted_words detalla los motivos del bloqueo. Habitualmente, el criterio de tono suele activarse en respuestas correctas que resultan ser concisas.
4. Valide los resultados con evaluaciones humanas. El control de valoración del asistente se conecta a la API de retroalimentación mediante la cabecera x-tfy-feedback-target-id. Si las solicitudes marcadas coinciden con aquellas que los usuarios puntuaron con un 1 o un 2, el juez está cumpliendo su función. De lo contrario, ajuste la rúbrica en lugar de modificar el umbral.
5. Pase a producción y supervise el consumo. Cambie el modo a Enforce But Ignore On Error para que una caída del servicio de Patronus degrade el sistema a un estado sin barreras en lugar de provocar una interrupción general. Dado que Patronus informa de los usage_tokens por evaluación y la inferencia del juez se enruta a través del gateway, el coste del proceso de evaluación es plenamente visible, permitiéndole determinar la tasa de muestreo adecuada.
Las barreras de salida se omiten en respuestas con streaming. Al utilizar "stream": true, las reglas de salida no se ejecutan, manteniéndose únicamente activas las de entrada. Si su aplicación utiliza streaming, el juez evaluará únicamente el prompt inicial.
Los prompts del sistema no son visibles para las barreras de seguridad. El gateway elimina estas instrucciones antes de enviar el contenido a cualquier barrera de seguridad, siendo CrowdStrike AIDR la única excepción documentada de solo lectura. Por tanto, un juez no puede evaluar si el modelo ha seguido las instrucciones del sistema.
La validación de salida no evita el coste de la llamada al modelo. Si una barrera de entrada falla durante el procesamiento, el gateway puede cancelar la solicitud. En cambio, las barreras de salida se ejecutan una vez generada la respuesta, habiéndose incurrido ya en los costes del modelo según detalla la documentación.
LLM como juez constituye una técnica eficaz siempre que se aplique en su ámbito específico. Representa el único método para evaluar texto subjetivo a gran escala, si bien presenta sesgos hacia respuestas extensas, hacia las salidas de su misma familia de modelos y hacia la primera opción presentada.
La clave para su aplicación práctica reside en la distinción planteada al inicio de este artículo. La evaluación offline es un proceso sobre conjuntos de datos que debe gestionarse en plataformas de eval específicas, exportando TrueFoundry las trazas correspondientes mediante OTEL. Por su parte, el filtrado en línea actúa directamente en la ruta de la solicitud: requiere un criterio acotado, un juez pequeño con versión fija perteneciente a una familia distinta, un despliegue inicial en modo auditoría, prioridad de la precisión sobre el recall y una visibilidad transparente de los costes asociados.
Implemente las reglas mediante código siempre que sea posible. En los casos en que la regla solo pueda definirse en lenguaje natural, utilice un juez y monitorice su rendimiento con el mismo rigor que el del modelo principal.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Consiste en usar un modelo de lenguaje para puntuar la salida de otro según una rúbrica escrita, devolviendo un veredicto legible por máquina: aprobado o suspenso, una puntuación o una preferencia entre candidatos. Existe porque el texto abierto no tiene una métrica de corrección calculable, y lo mejor es tratarlo como un sustituto barato y ruidoso de un evaluador humano.
Para criterios acotados, binarios y redactados con precisión, a menudo sí; para rúbricas de calidad amplias, normalmente no. Mida primero la precisión y la exhaustividad por separado con ejemplos etiquetados a mano: un juez con un 90 % de acierto bloquea aproximadamente una de cada diez respuestas legítimas el día que usted lo pone en vigor.
Al menos una llamada adicional al modelo por cada solicitud protegida, y dos si se juzgan tanto el prompt como la respuesta; la documentación de NeMo de TrueFoundry expone esa aritmética de forma explícita. La única palanca es la cobertura: muestree para la telemetría y reserve la cobertura completa para las comprobaciones que nunca deben fallar.
Sí. TrueFoundry se ejecuta en su VPC, on-prem, en entornos air-gapped o híbridos, de modo que los prompts y las respuestas nunca salen de su dominio, incluso cuando enruta entre muchos proveedores.
Aproximadamente 3-4 ms, manteniendo más de 350 RPS en una sola vCPU con más de 1.000 LLM. El tiempo de los guardrails se mide aparte y se reporta en P50, P75, P90 y P99.
Sí. El gateway es compatible con OpenTelemetry y exporta trazas a backends externos, que es como los datos del gateway llegan a plataformas como Braintrust, Langfuse o Arize. TrueFoundry no ejecuta por sí mismo trabajos de puntuación offline.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















