



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Una API de pagos es fácil de observar porque es predecible. La misma entrada produce la misma ruta de código, por lo que tres métricas —tasa de peticiones, tasa de errores y duración— te dicen casi todo. Cuando algo falla, lees un seguimiento de pila (stack trace), y este es un hecho sobre el programa, no una suposición sobre la intención.
Un agente rompe todas las premisas de esa frase. El modelo elige la ruta en tiempo de ejecución, por lo que la misma entrada no produce la misma ruta de código. A menudo no hay error alguno: el agente termina, devuelve texto y todas las llamadas HTTP que realizó devolvieron un 200. Y lo que sale mal no suele ser un bloqueo, sino una decisión : eligió la herramienta incorrecta, volvió a leer un archivo que ya tenía, o siguió reintentando una búsqueda que nunca funcionaría.
Por lo tanto, la pregunta cambia: no es si estaba activo, sino por qué hizo eso. Y el "porqué" es una propiedad de toda la secuencia, no de una única petición; por eso un panel de control puede parecer saludable mientras tu agente falla. Una latencia P99 de 900 ms en cada llamada al modelo no te dice nada sobre una ejecución que realizó 140 de ellas.
Los datos tienen cuatro niveles anidados, de los cuales solo los dos inferiores se parecen a una petición convencional.
Los dos niveles intermedios contienen el valor y son exactamente los dos que un trazador con alcance de petición no modela. Este ve una dispersión de llamadas salientes sin un padre significativo y no puede decirte que las llamadas de la 11 a la 27 fueron un mismo turno intentando lo mismo siete veces.
Una propiedad hace que esto sea genuinamente diferente del rastreo distribuido: cualquier nivel puede entrar en bucle. No hay equivalente en un gráfico de servicio normal: A llama a B, B llama a C, y si A se llama a sí mismo, tienes un error. En un agente, un paso que decide llamarse a sí mismo de nuevo es el caso normal, y la única forma de distinguir un bucle productivo de uno bloqueado es leer la secuencia.
Cada nivel necesita sus propias señales. Recopilar todo en todas partes produce datos sin conocimiento, así que esto es lo mínimo que realmente aporta valor.
La última celda es la señal de mayor rendimiento en la observabilidad de agentes, y casi nadie la registra: la misma herramienta llamada dos veces con los mismos argumentos dentro de un mismo turno es un bucle. Es trivial una vez que los argumentos están en el span. Imposible a partir de métricas agregadas.
Tres patrones cubren casi todos los incidentes en producción.
1. El bucle de reintento silencioso. Un agente busca en una base de conocimientos, no obtiene nada útil, reformula, vuelve a buscar... veinte veces. Cada búsqueda devuelve un 200 en 300 ms, por lo que los paneles de tasa de solicitudes y tasa de errores muestran un pequeño pico de tráfico y nada más. A nivel de sesión es inconfundible: un turno, veinte llamadas a herramientas, dos minutos de duración. El diagnóstico no está en ningún span individual; está en la repetición.
2. La herramienta que tiene éxito mientras devuelve basura. Una herramienta de recuperación de documentos se topa con un muro de permisos y devuelve un educado 200 cuyo cuerpo es una página de inicio de sesión HTML. El modelo lo lee e informa de que dicha política no existe. Cero errores en cualquier parte. La única forma de detectar esto es capturar el resultado bruto, razón por la cual la captura de resultados, y no solo los códigos de estado, es fundamental.
3. La ejecución 40x. El coste medio de una sesión es de 0,04 $; una sesión costó 1,60 $ y nada falló. Un solo paso volvió a leer un archivo grande en el contexto, ese archivo se arrastró en cada turno posterior y los tokens de entrada se acumularon durante el resto de la ejecución. Se encuentra ordenando las sesiones por coste y leyendo los recuentos de tokens por turno de los valores atípicos hasta ver el cambio de paso. Nunca en una media.
El patrón común en los tres: la anomalía es una relación entre pasos. Una herramienta que almacena los pasos de forma independiente ha descartado lo que necesitas.
Esto se puede capturar sin instrumentar el código de tu agente porque la aplicación y la observación ocurren en el mismo lugar. Cada llamada a modelos y herramientas pasa por una pasarela, por lo que la trayectoria se registra como un efecto secundario de su servicio: nada se reconstruye a partir de registros dispersos y no hay forma de evitarlo.
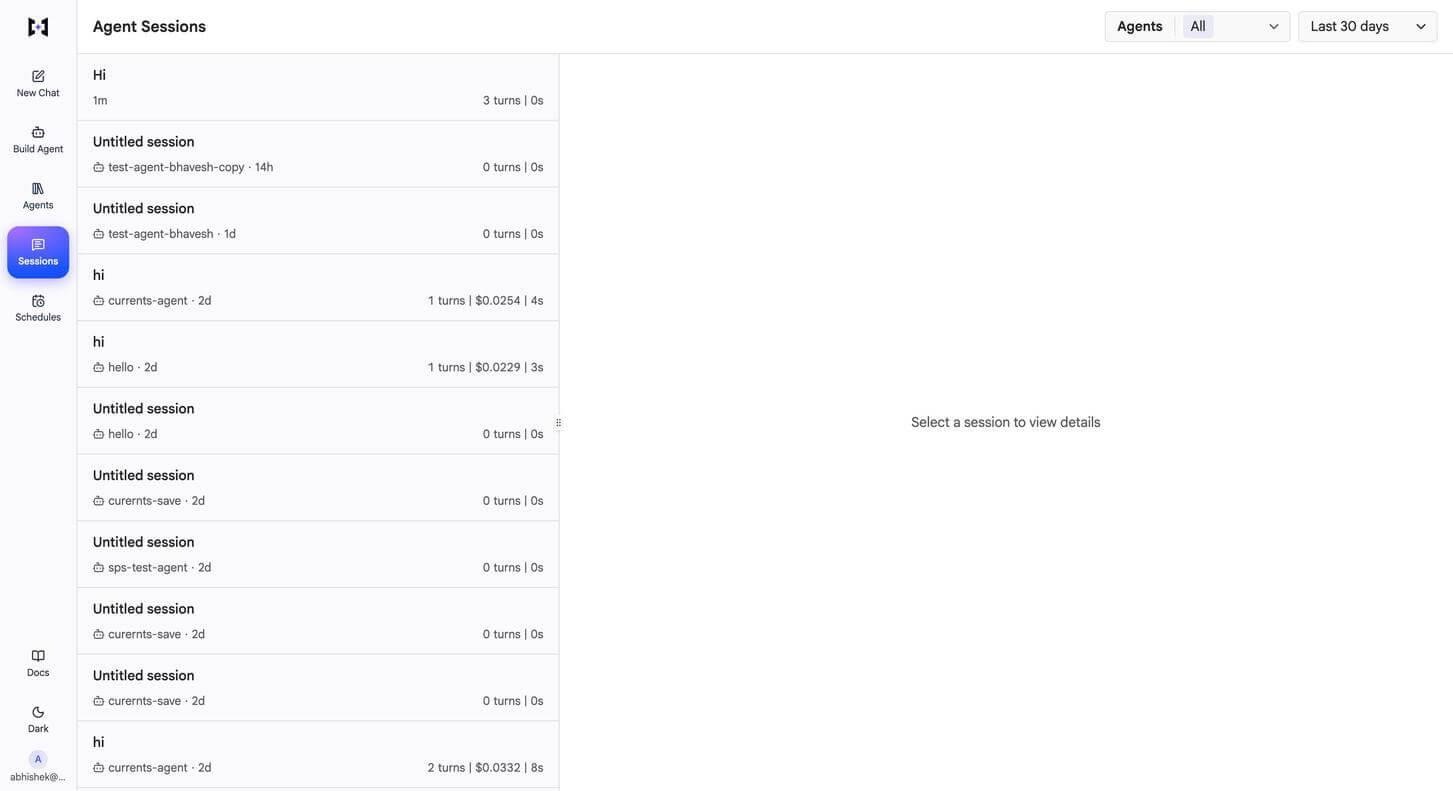
Para los agentes en el harness de agentes de TrueFoundry, Sesiones enumera cada conversación en todos los agentes: mensaje inicial, agente, número de turnos, coste, duración. Suficiente para detectar ejecuciones costosas o demasiado largas sin abrir nada, que es exactamente lo que requiere el modo de fallo 3.
Abrir una sesión proporciona los tres elementos que requiere la jerarquía. Las métricas agregadas cubren turnos, duración, coste, tokens, contexto, llamadas a herramientas, subagentes y errores. Una línea de tiempo basada en eventos desglosa la ejecución en segmentos de sistema, usuario, modelo y llamadas a herramientas por turno; un turno dominado por el color de llamada a herramienta está vinculado a herramientas, uno dominado por el color del modelo está vinculado al modelo, visible de un vistazo en lugar de calculado. Debajo se encuentra la transcripción, con tokens por turno, duración y coste, y un panel desplegable de pasos del agente que enumera las llamadas a herramientas en orden con sus resultados.
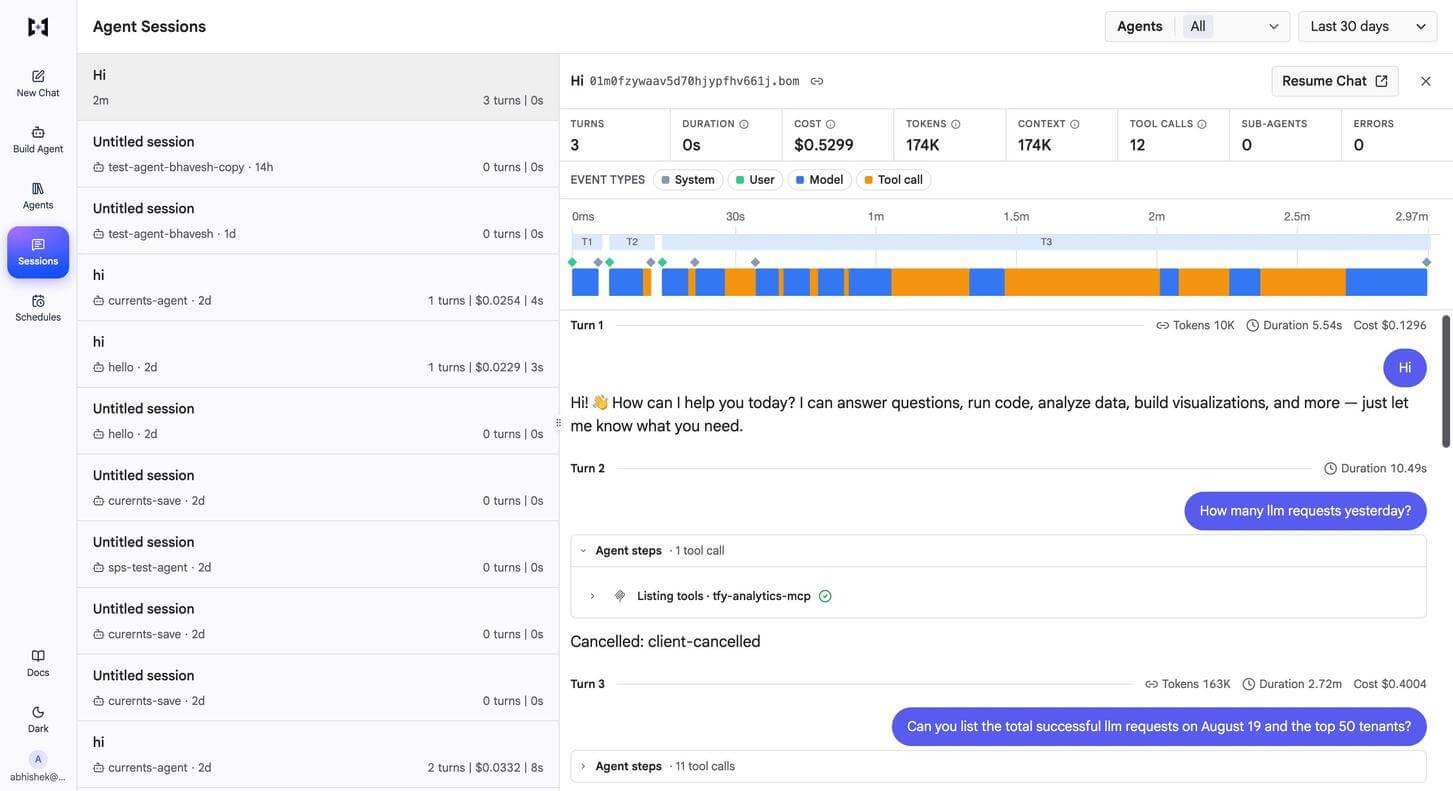
Esa lista ordenada de pasos es donde un turno cancelado, un servidor MCP fallido o un resultado de herramienta vacío se vuelven visibles. Una sesión puede reanudarse como un chat en vivo desde la misma vista: así es como confirmas una corrección.
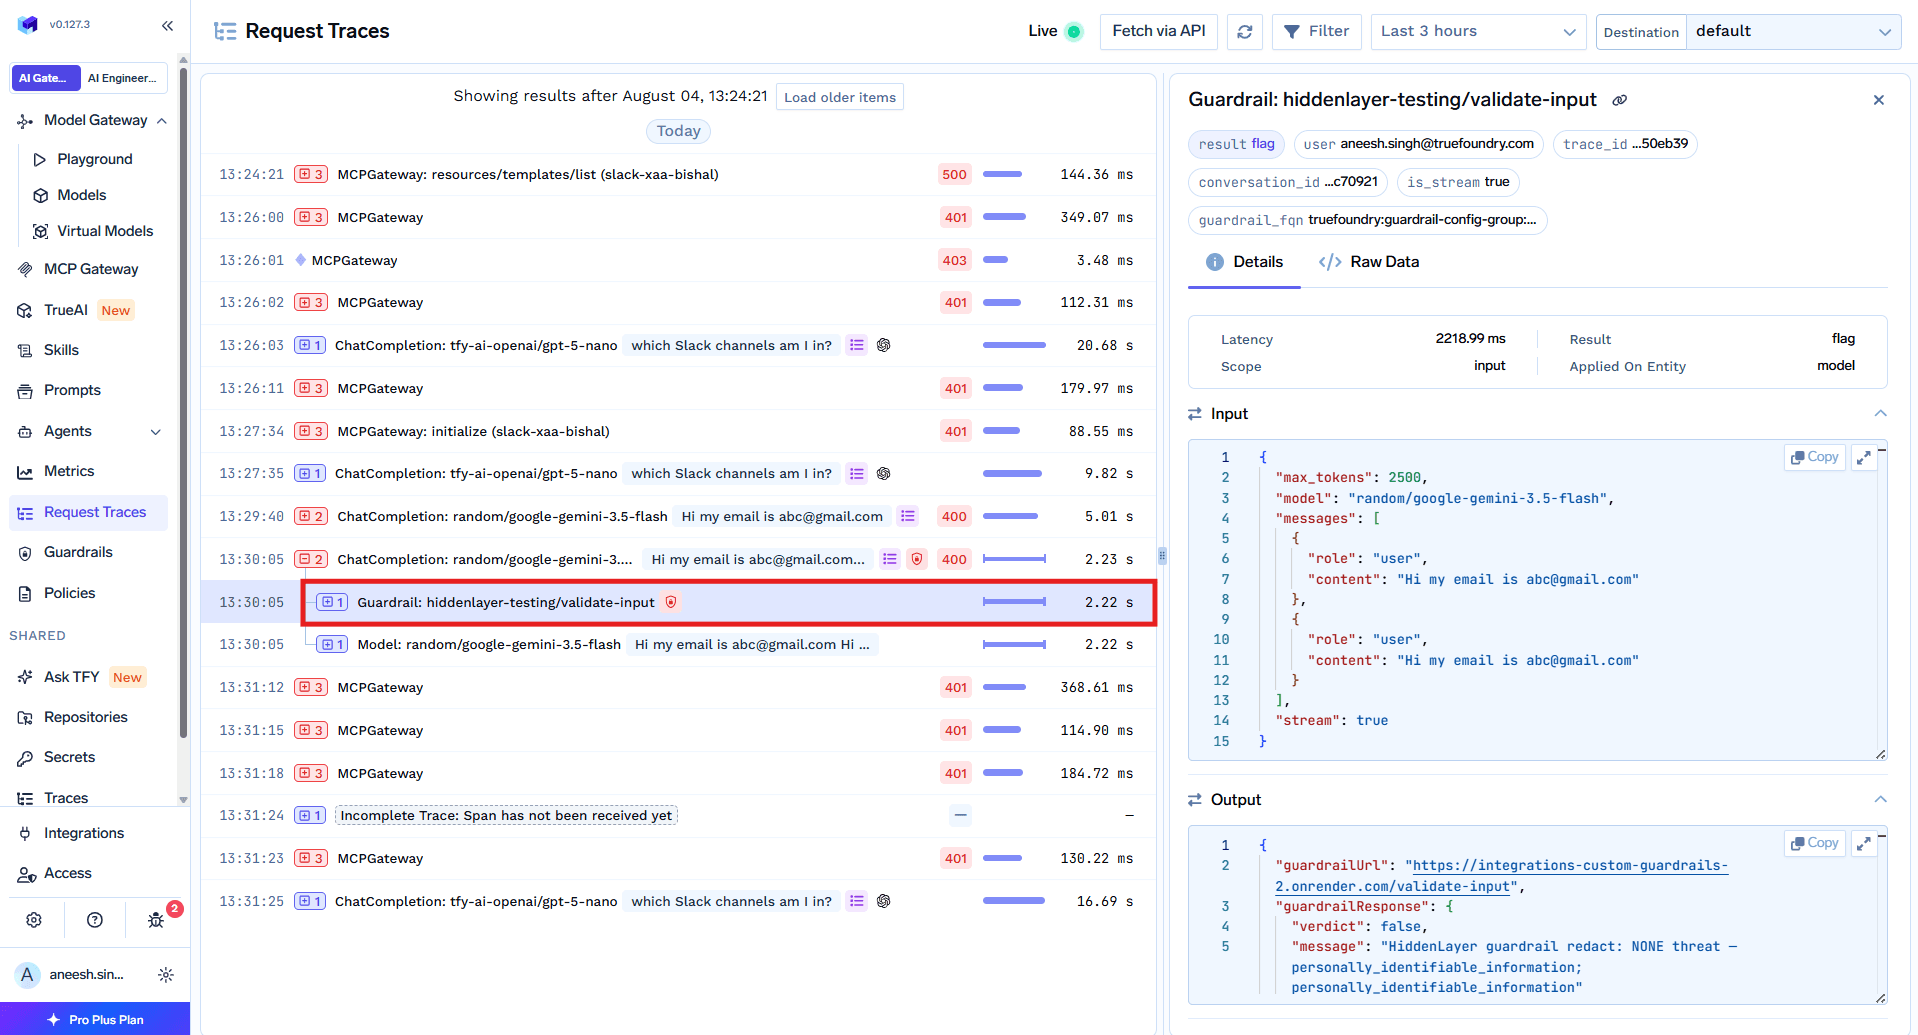
Un nivel más abajo, un seguimiento es una jerarquía real de spans, no un registro plano. Una única finalización de chat con un guardrail de PII adjunto produce cinco spans: una raíz ChatCompletion sin padre, un span de Guardrail debajo, la llamada saliente del guardrail debajo de ese, un span de Modelo y la llamada saliente del modelo debajo de ese.
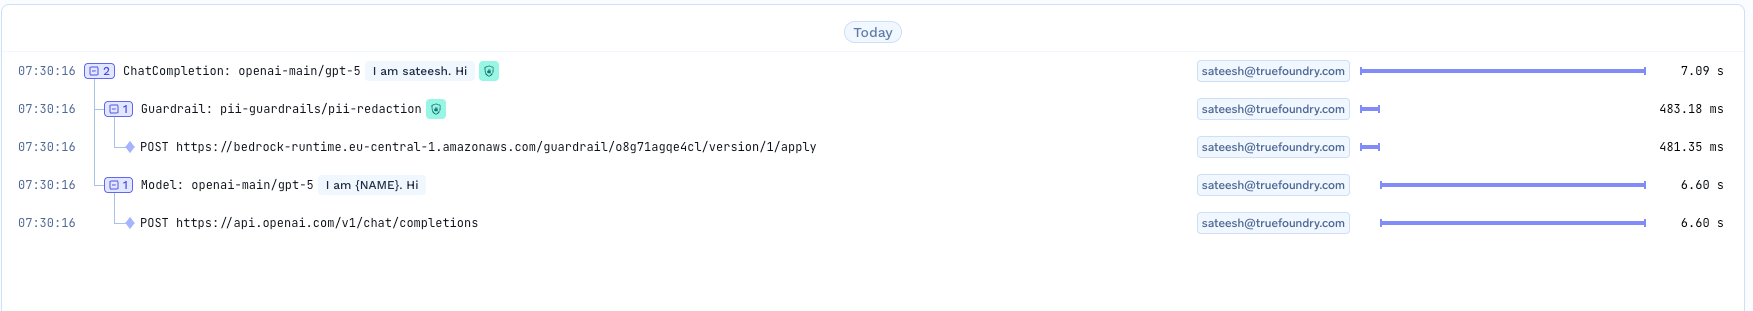
Los atributos de los spans hacen que el coste y la latencia sean atribuibles en lugar de estimados. El span raíz contiene tfy.model.metric.cost_in_usd, input_tokens, output_tokens, latency_in_ms, time_to_first_token_in_ms e inter_token_latency_in_ms, junto con tfy.input, tfy.output y tfy.triggered_guardrail_fqns, y cada span registra el sujeto que lo creó. Los spans se pueden consultar: client.traces.query_spans(...) con un filtro de trace_ids y una ventana de tiempo devuelve toda la jerarquía, paginada; así es como pasas de "esta sesión fue costosa" a "este span fue costoso".
La ejecución del guardrail aparece como su propio span con resultado, latencia y hallazgos, y las solicitudes bloqueadas también se rastrean: una llamada denegada es evidencia, no un vacío.
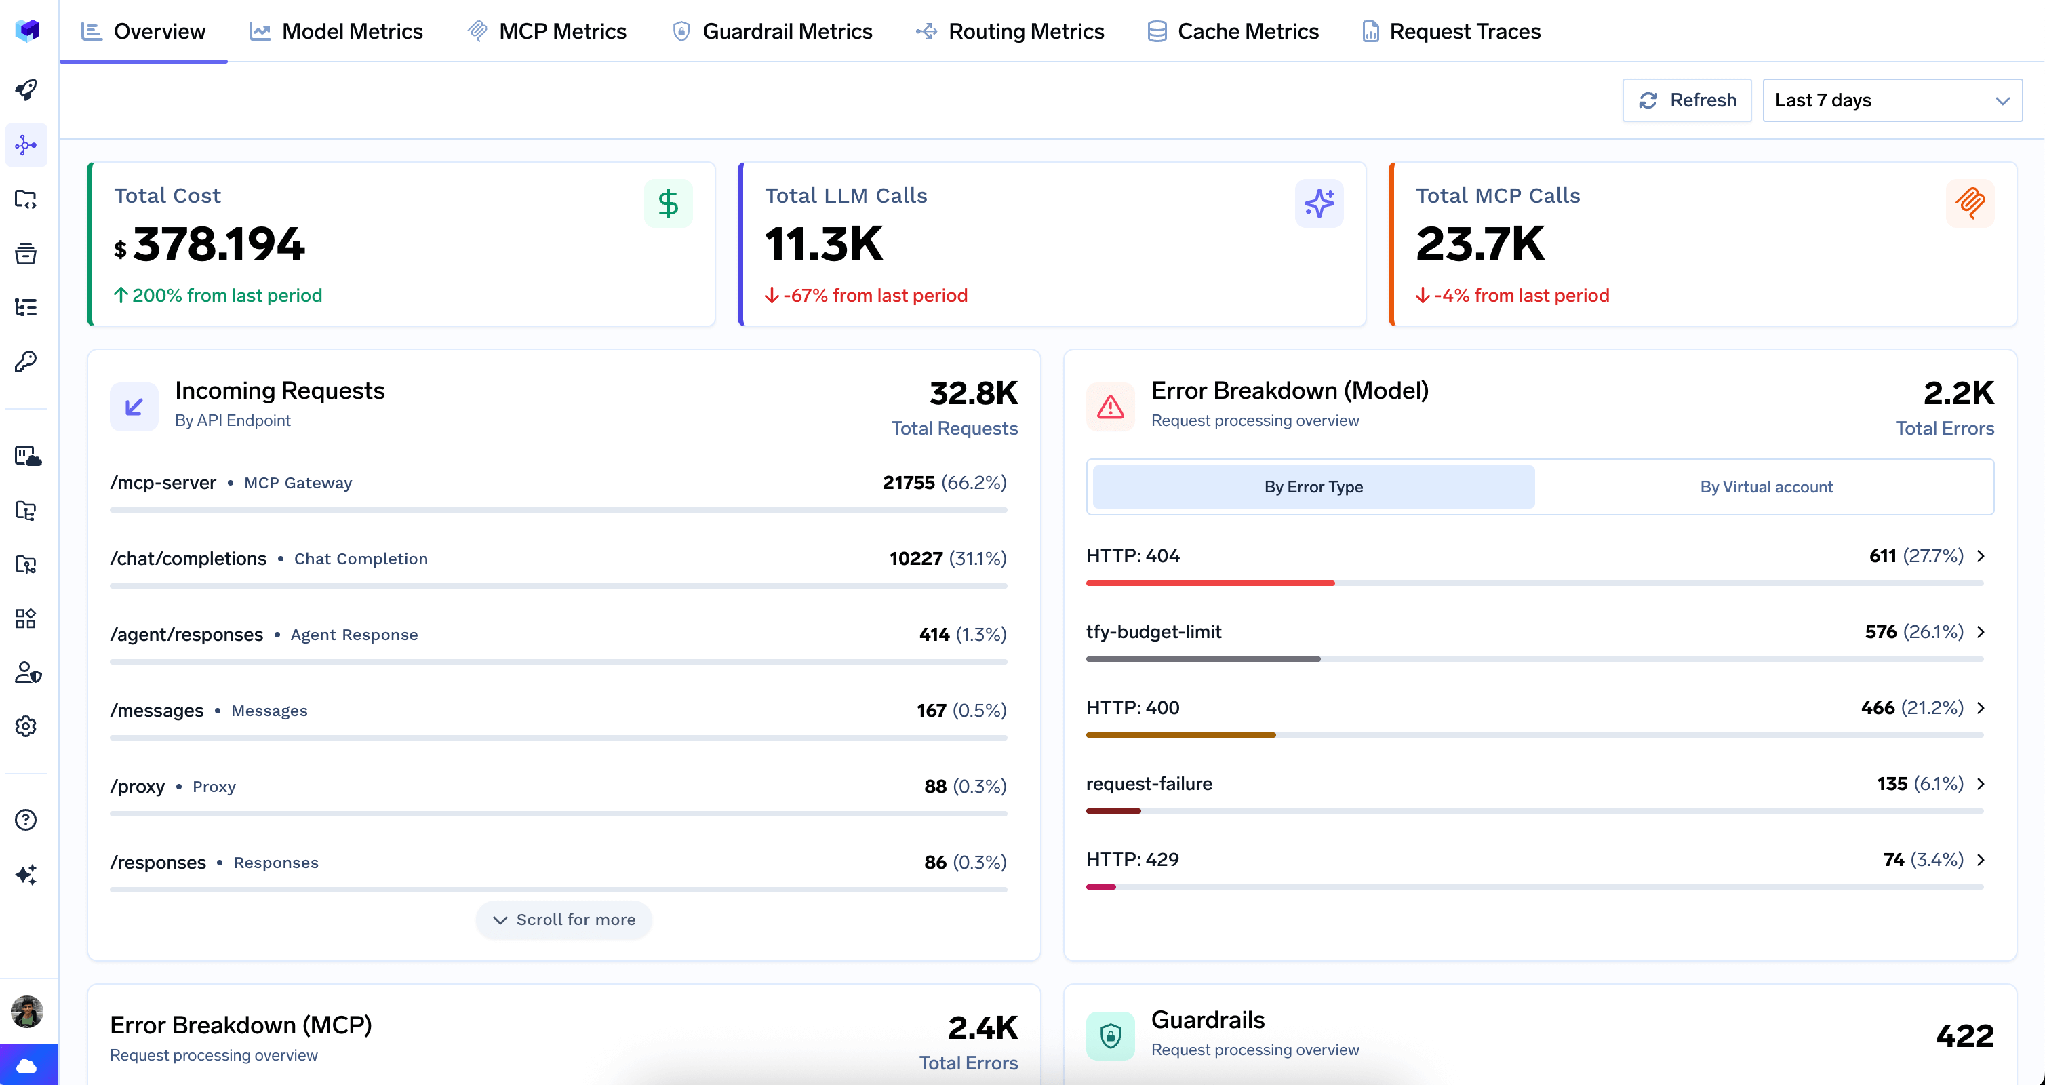
Los agregados se encuentran en el Panel de métricas. Las métricas del modelo incluyen tokens de entrada y salida, recuento de solicitudes y coste total, además del rendimiento, la tasa de fallos y el desglose de fallos por tipo de error. La latencia se presenta en P50, P75, P90 y P99 a través de cuatro medidas: latencia de extremo a extremo, tiempo hasta el primer token, latencia entre tokens y tiempo por token de salida, lo cual es importante porque un primer token lento y un flujo de tokens lento tienen causas diferentes.
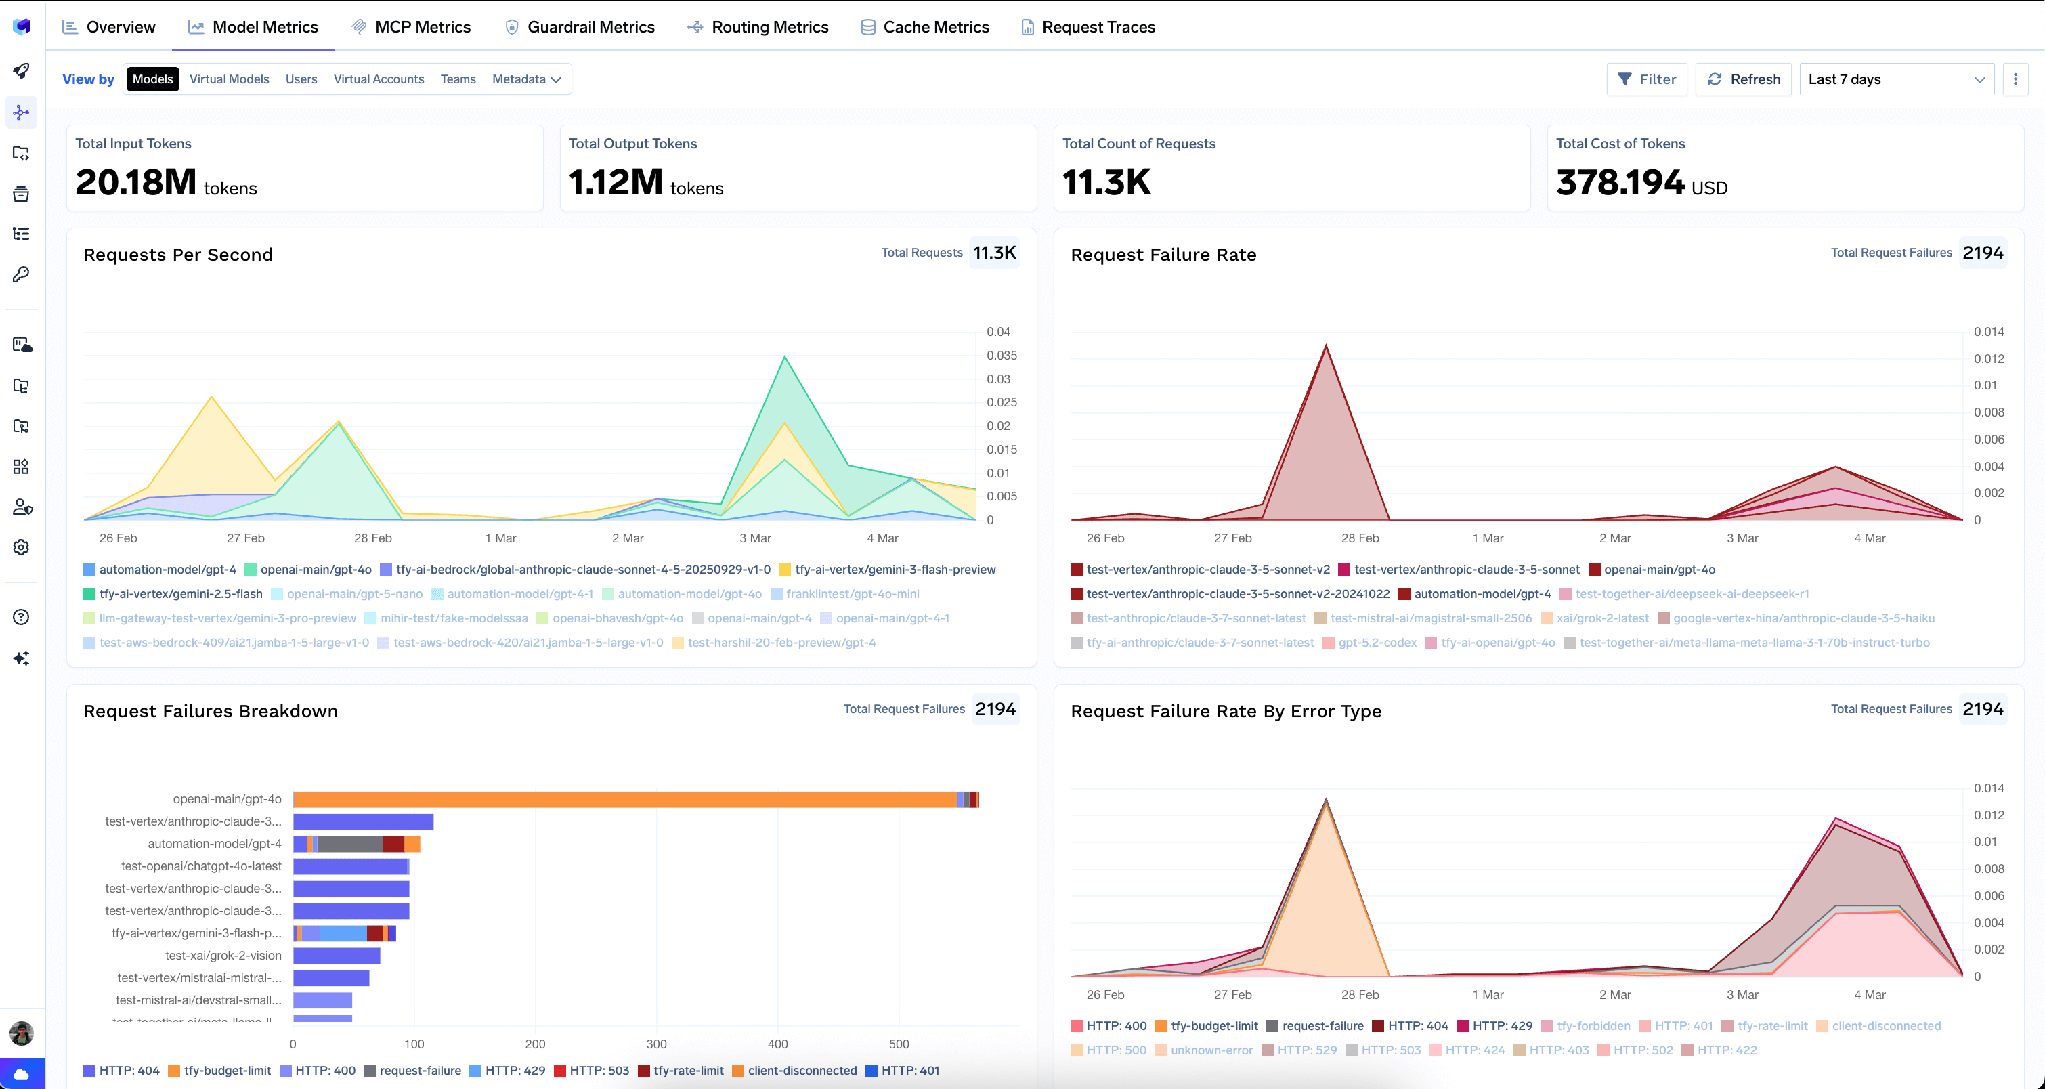
Cada gráfico se puede pivotar mediante un Ver por selector: modelos, modelos virtuales, usuarios, cuentas virtuales, equipos o claves de metadatos personalizados enviados como cabeceras de solicitud. Planifique los metadatos con antelación: envíe un nombre de agente o un ID de ejecución y obtendrá vistas de coste y latencia por agente sin tener que desarrollar nada.
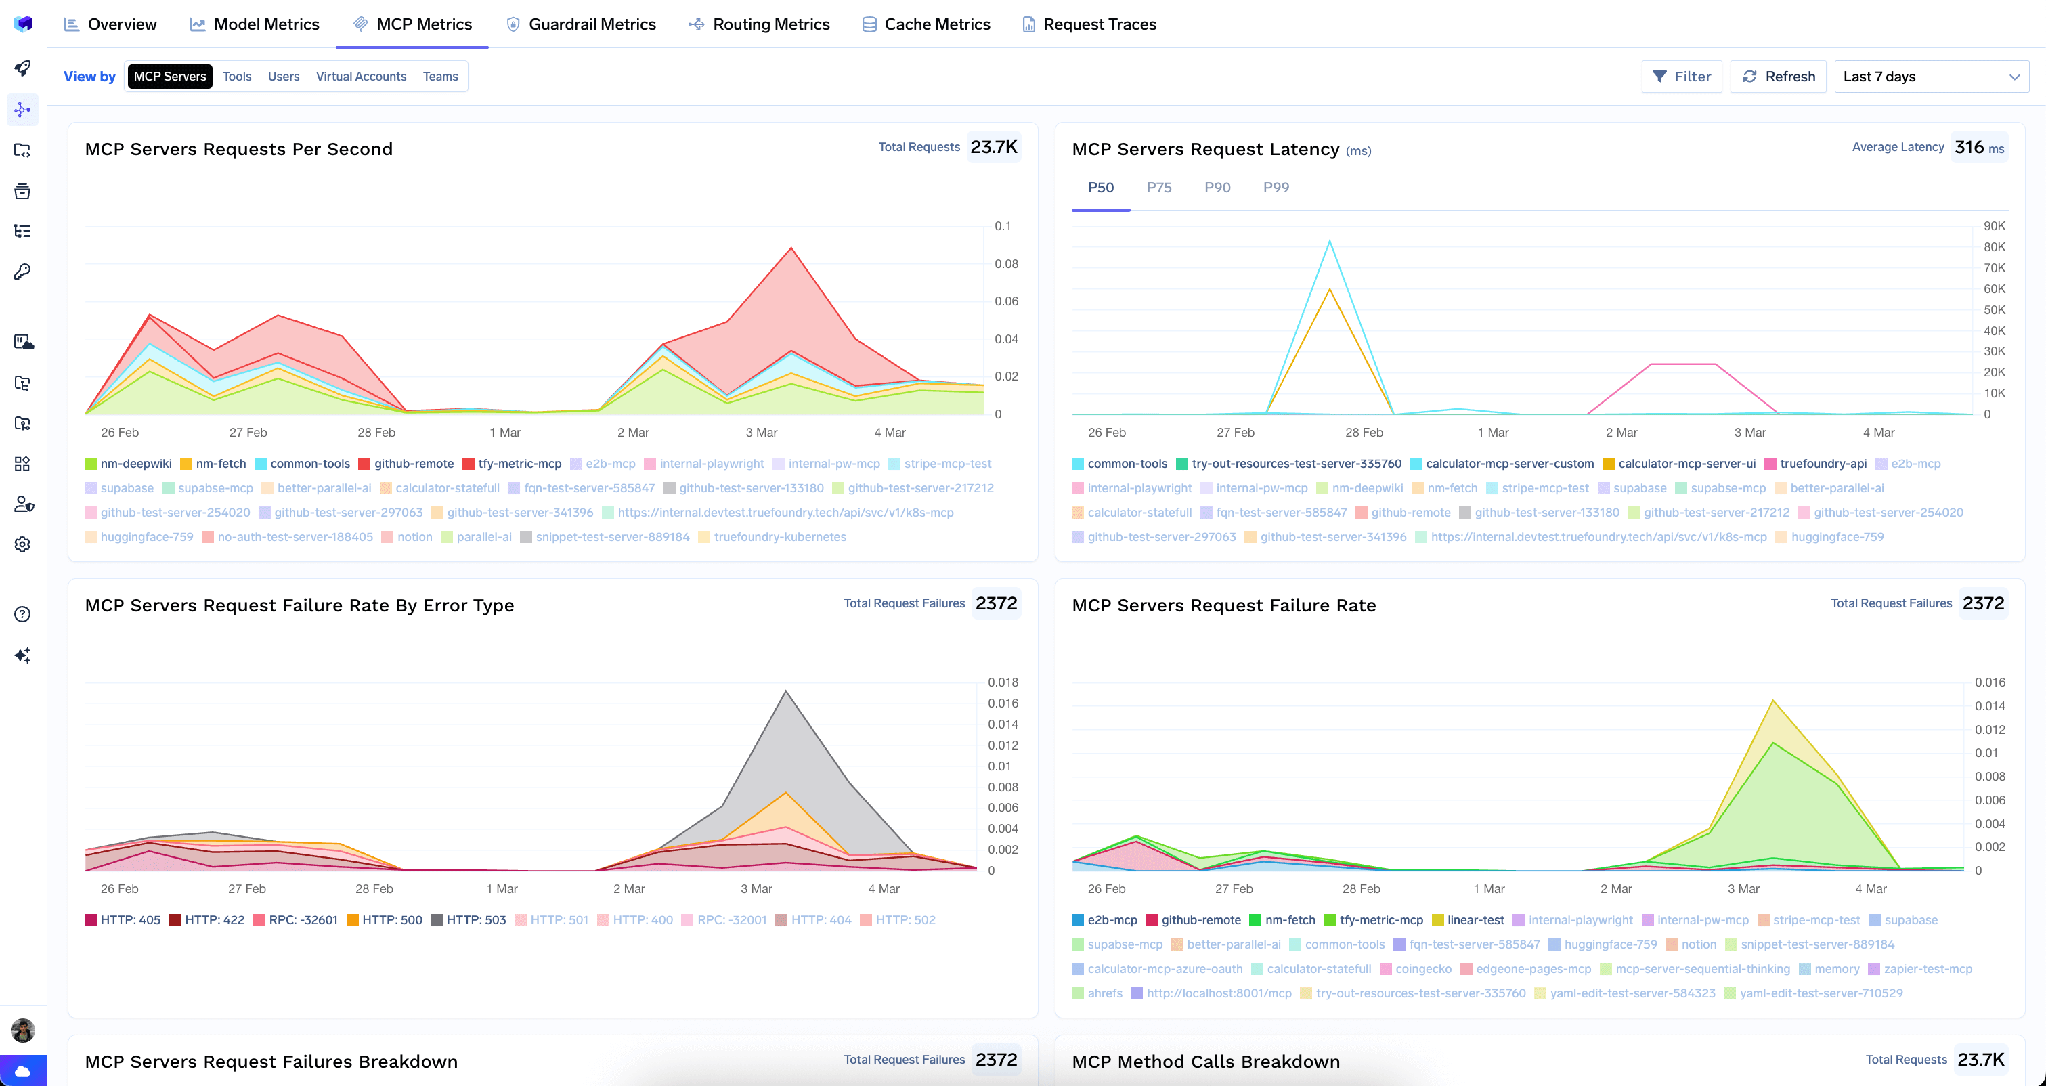
Las llamadas a herramientas reciben el mismo tratamiento a través de las métricas MCP, la parte que la mayoría de las configuraciones centradas en LLM omiten. La vista de servidores ofrece rendimiento por servidor, percentiles de latencia, tasa de fallos y desglose de errores, además de un desglose de llamadas a métodos en tools/list, tools/call, resources/list y el resto. Un agente que consume solicitudes en repetidas llamadas a tools/list tiene un problema de descubrimiento, no un problema de tareas.
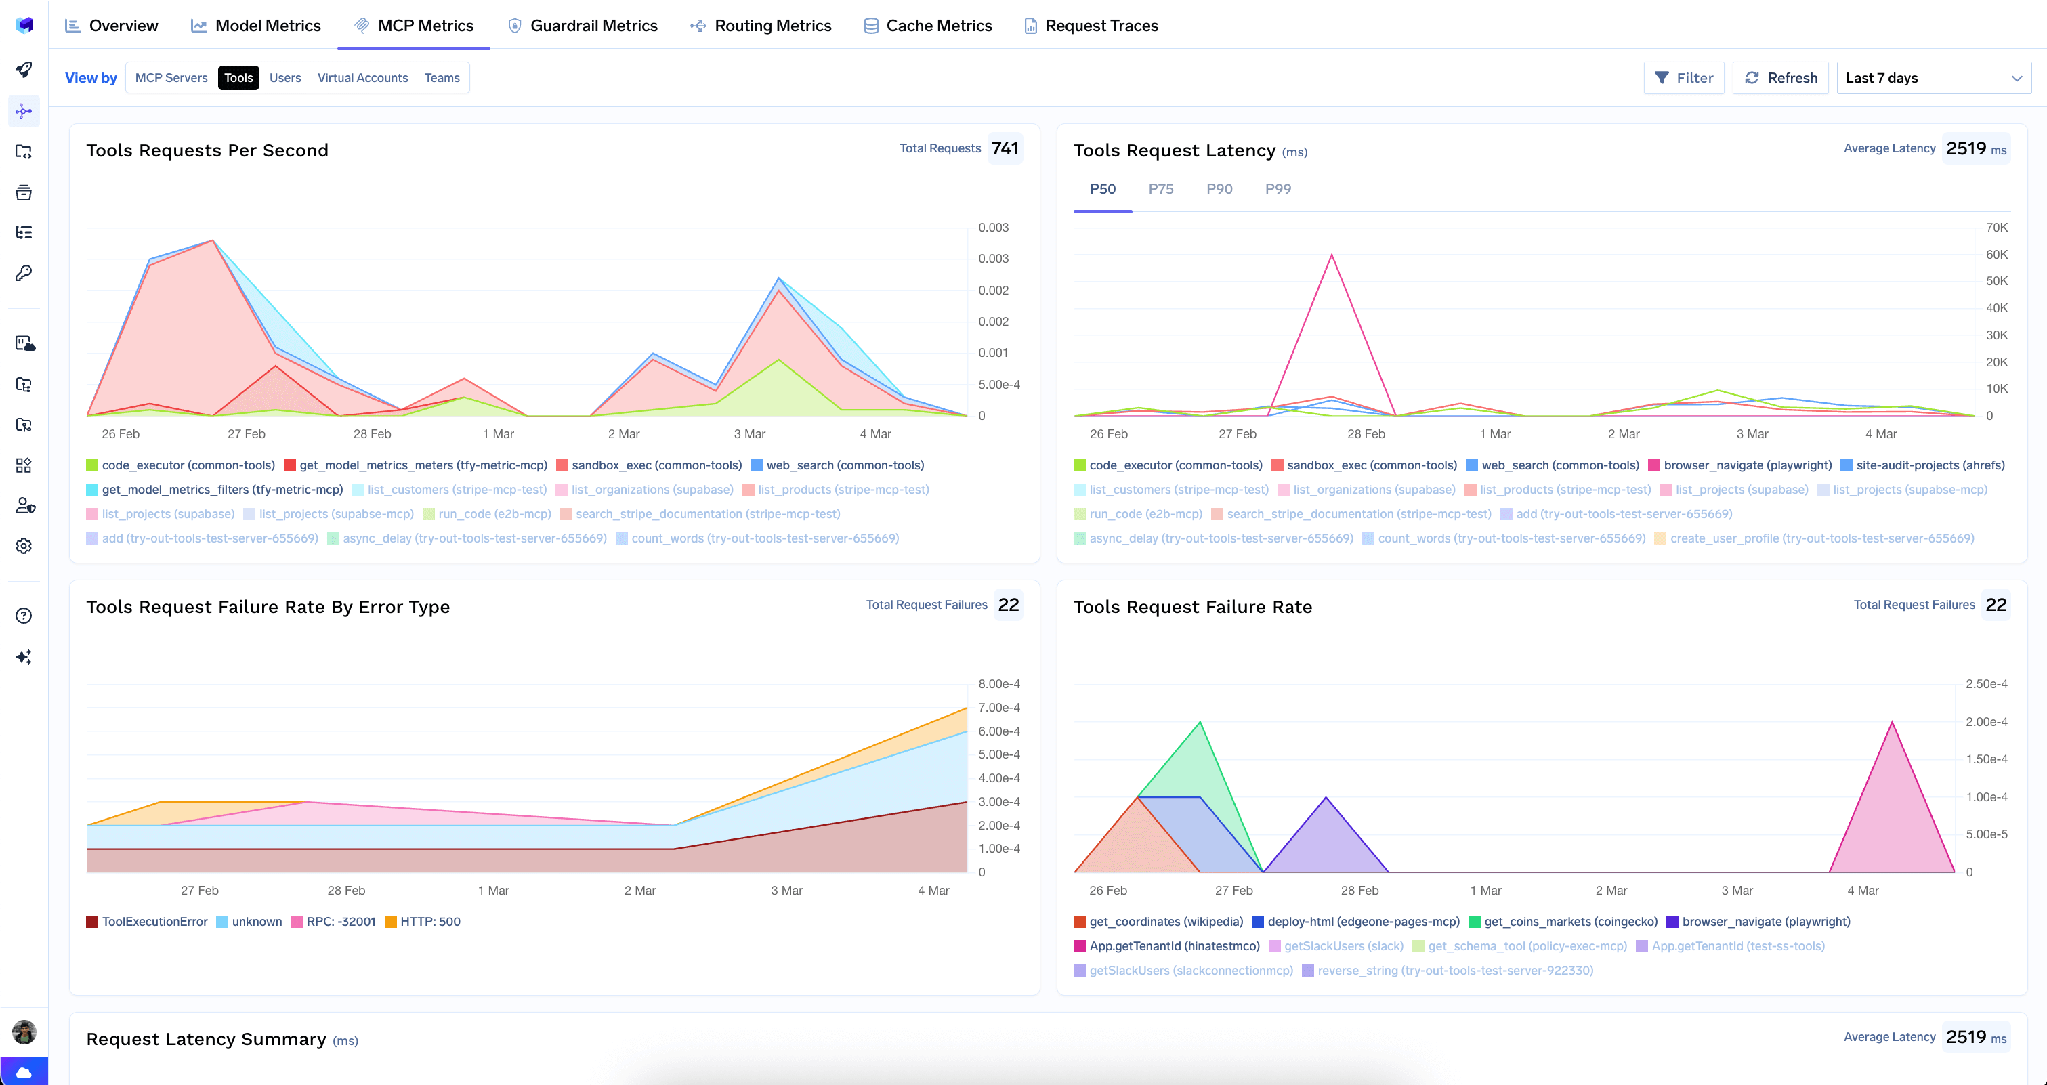
La vista de herramientas profundiza en herramientas individuales en todos los servidores: solicitudes por segundo, percentiles de latencia, tasa de fallos por tipo de error, un resumen de latencia comparativo y herramientas clasificadas por recuento de solicitudes. Esa clasificación es la forma más rápida de detectar una herramienta en la que el agente se apoya más de lo que esperaba.
Los filtros persisten entre pestañas, por lo que restringir a un usuario en la pestaña del modelo mantiene ese filtro al cambiar a MCP; así es como puede saber si sus sesiones lentas son un problema del modelo o de la herramienta sin tener que reconstruir la consulta.
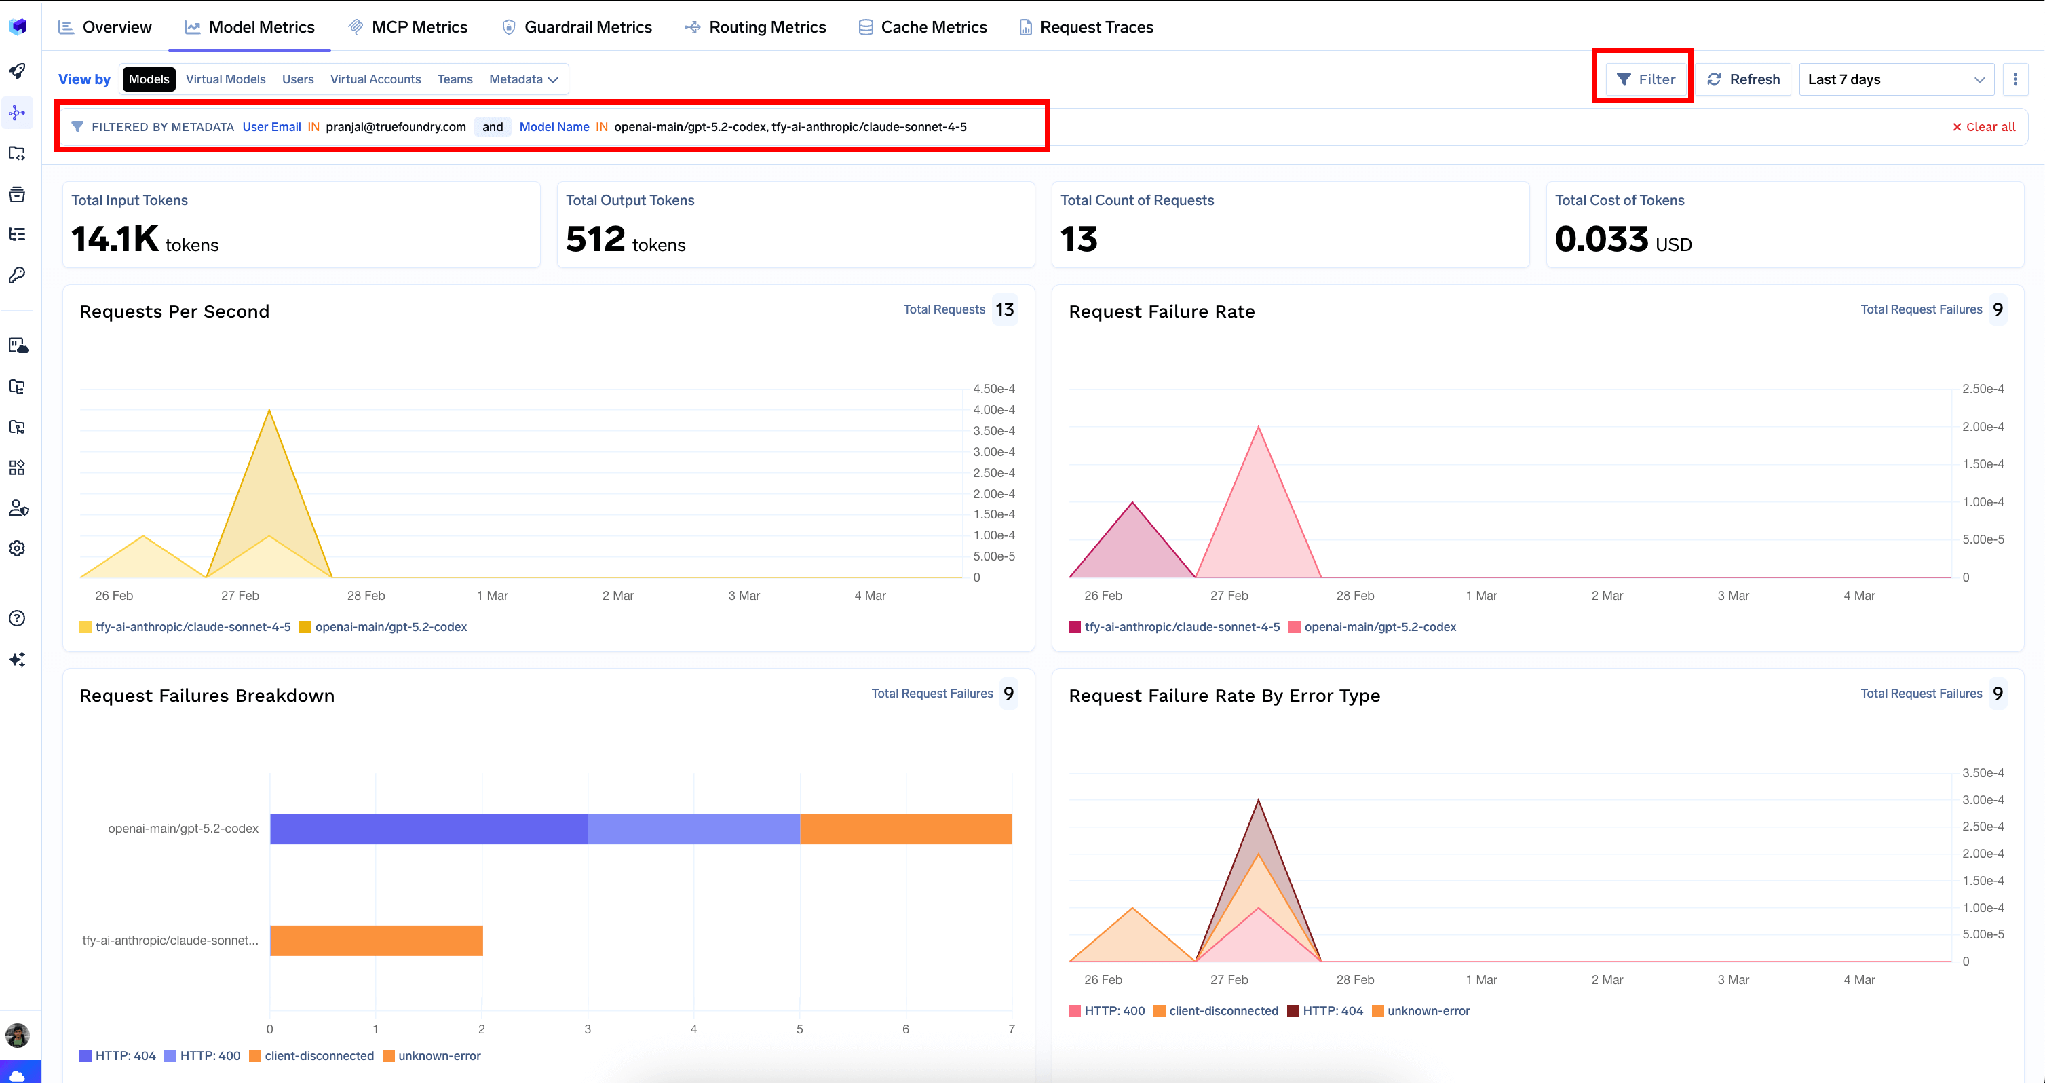
Los agentes registrados obtienen un panel que cubre el recuento de solicitudes, los percentiles de latencia, las tasas de error y el uso a lo largo del tiempo, idéntico tanto si el agente se ejecuta en Bedrock, LangGraph o un servicio personalizado.

Los mismos datos se pueden consultar: la API de métricas expone una fuente de datos agentMetrics que devuelve resultados de distribución o series temporales agrupados por agentName, agentFramework o agentServerType, con agregaciones de percentiles en latencyMs. En sistemas multiagente, Trazas de solicitud registra qué agente realizó cada llamada y para qué usuario actuó; es la atribución que permite rastrear la llamada a una herramienta de un subagente hasta una persona.
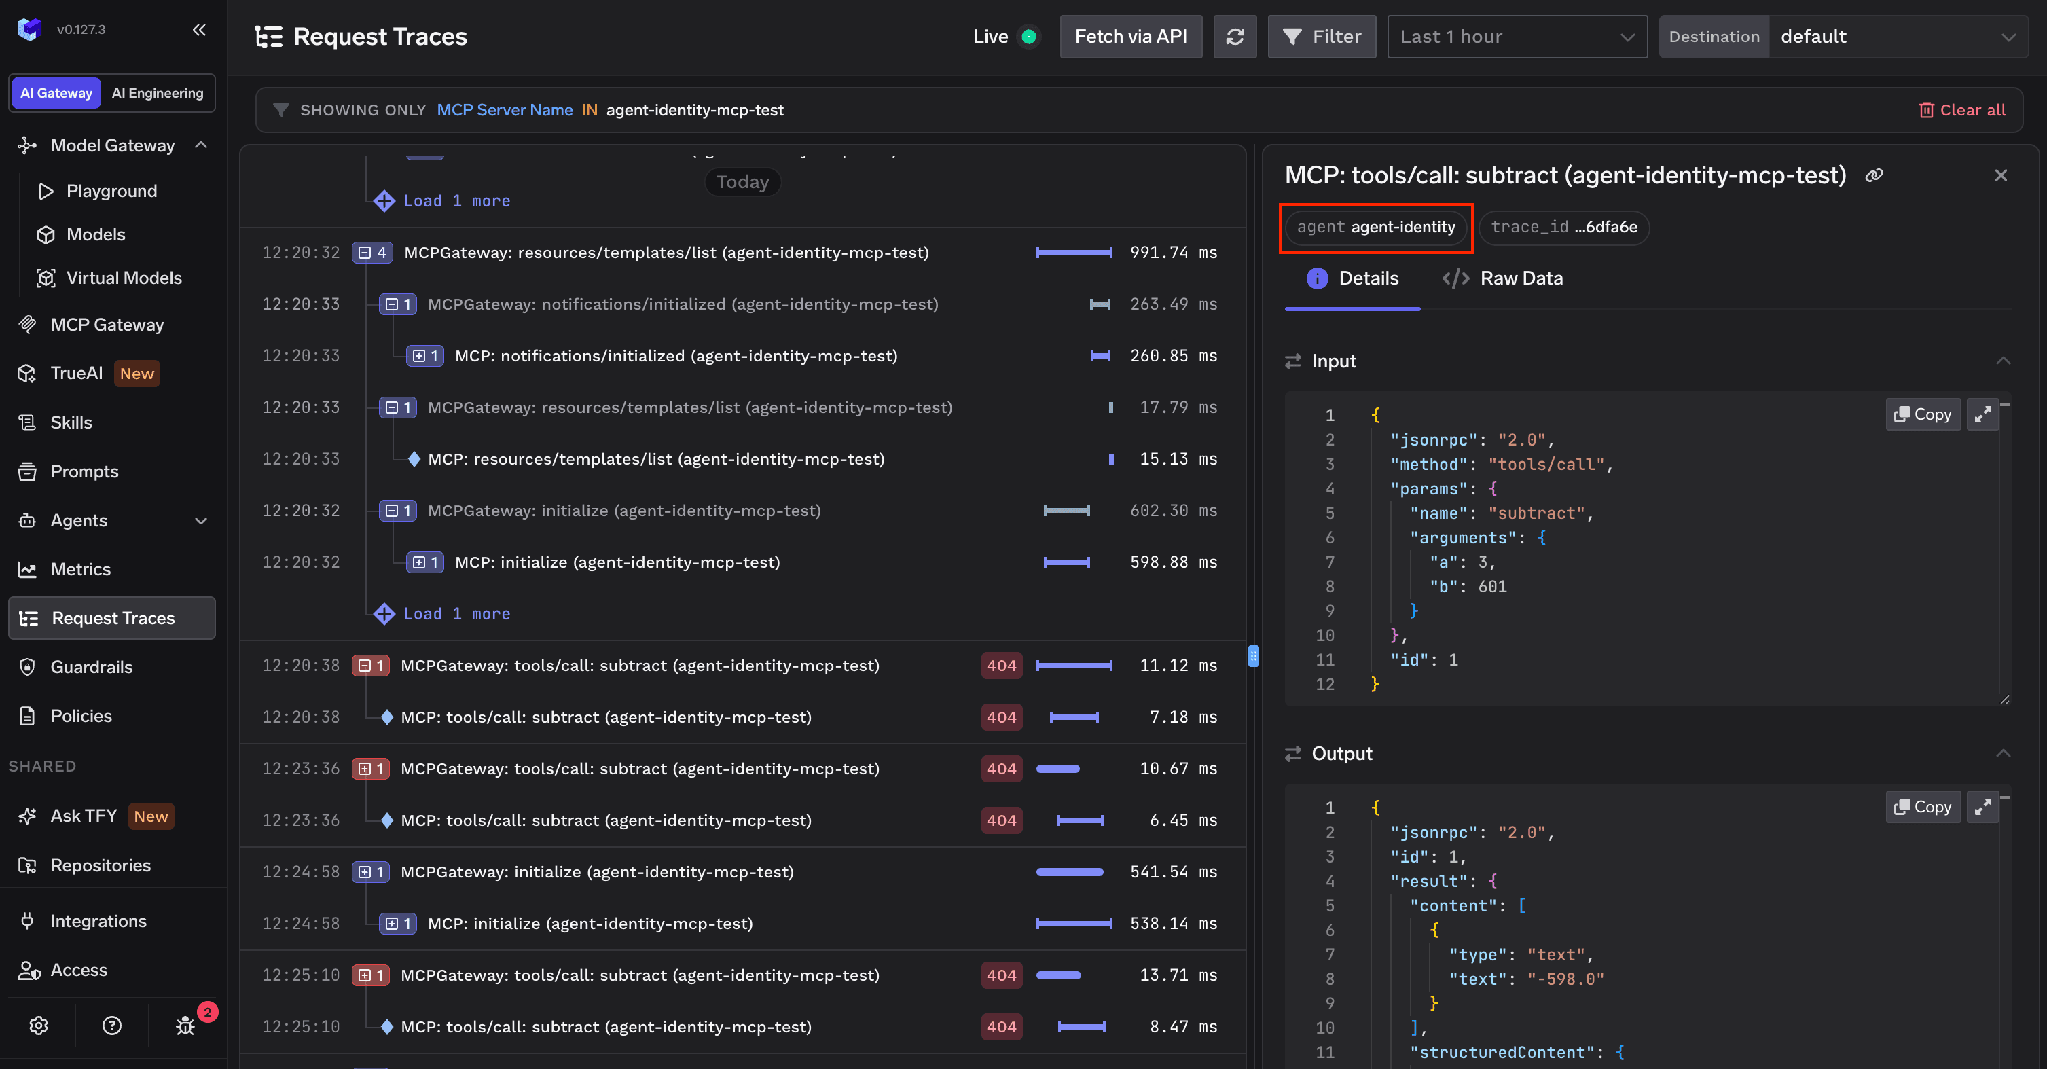
Una limitación honesta: una vista completa de la cadena de actores que conecta usuario → agente → subagente → herramienta en una sola traza renderizada estará disponible pronto, al igual que la detección de desviaciones, las alertas de anomalías y la suspensión de agentes con un solo clic. Actualmente, obtienes atribución por salto en cada traza en lugar de la cadena representada como una sola imagen.
La latencia y el coste son medibles; la calidad de la respuesta no, por lo que los comentarios deben ir en la traza y no en una tabla separada. Cada respuesta de la pasarela devuelve una cabecera x-tfy-feedback-target-id. Env ía eso a /api/svc/v1/gateway-feedback con una valoración del 1 al 5 y un comentario opcional, y aparecerá junto al span y en los datos sin procesar bajo tfyGatewayFeedbacks, pudiendo actualizarse o eliminarse mediante su ID devuelto. El ID de destino actualmente se refiere al span raíz, por lo que los comentarios se aplican a la solicitud, no a un subpaso.
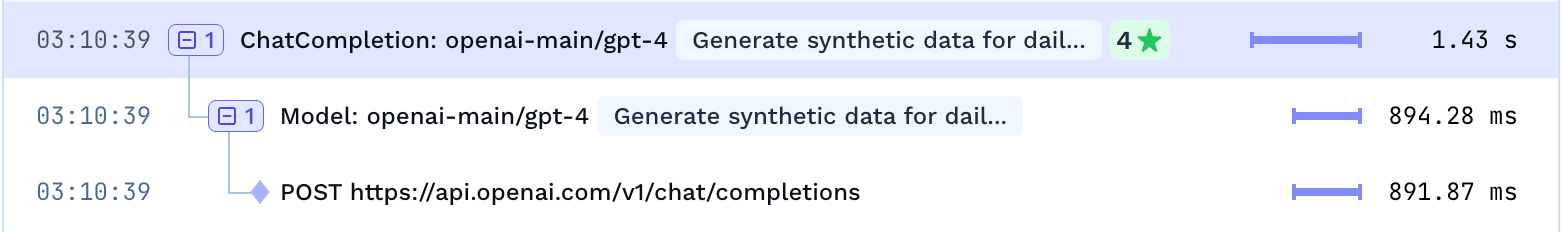
Conecta eso a un control de pulgar hacia arriba en tu producto y las sesiones atípicas obtendrán una etiqueta de calidad, convirtiendo "esta ejecución costó 40 veces más" en "esta ejecución costó 40 veces más y el usuario la valoró con un 2".
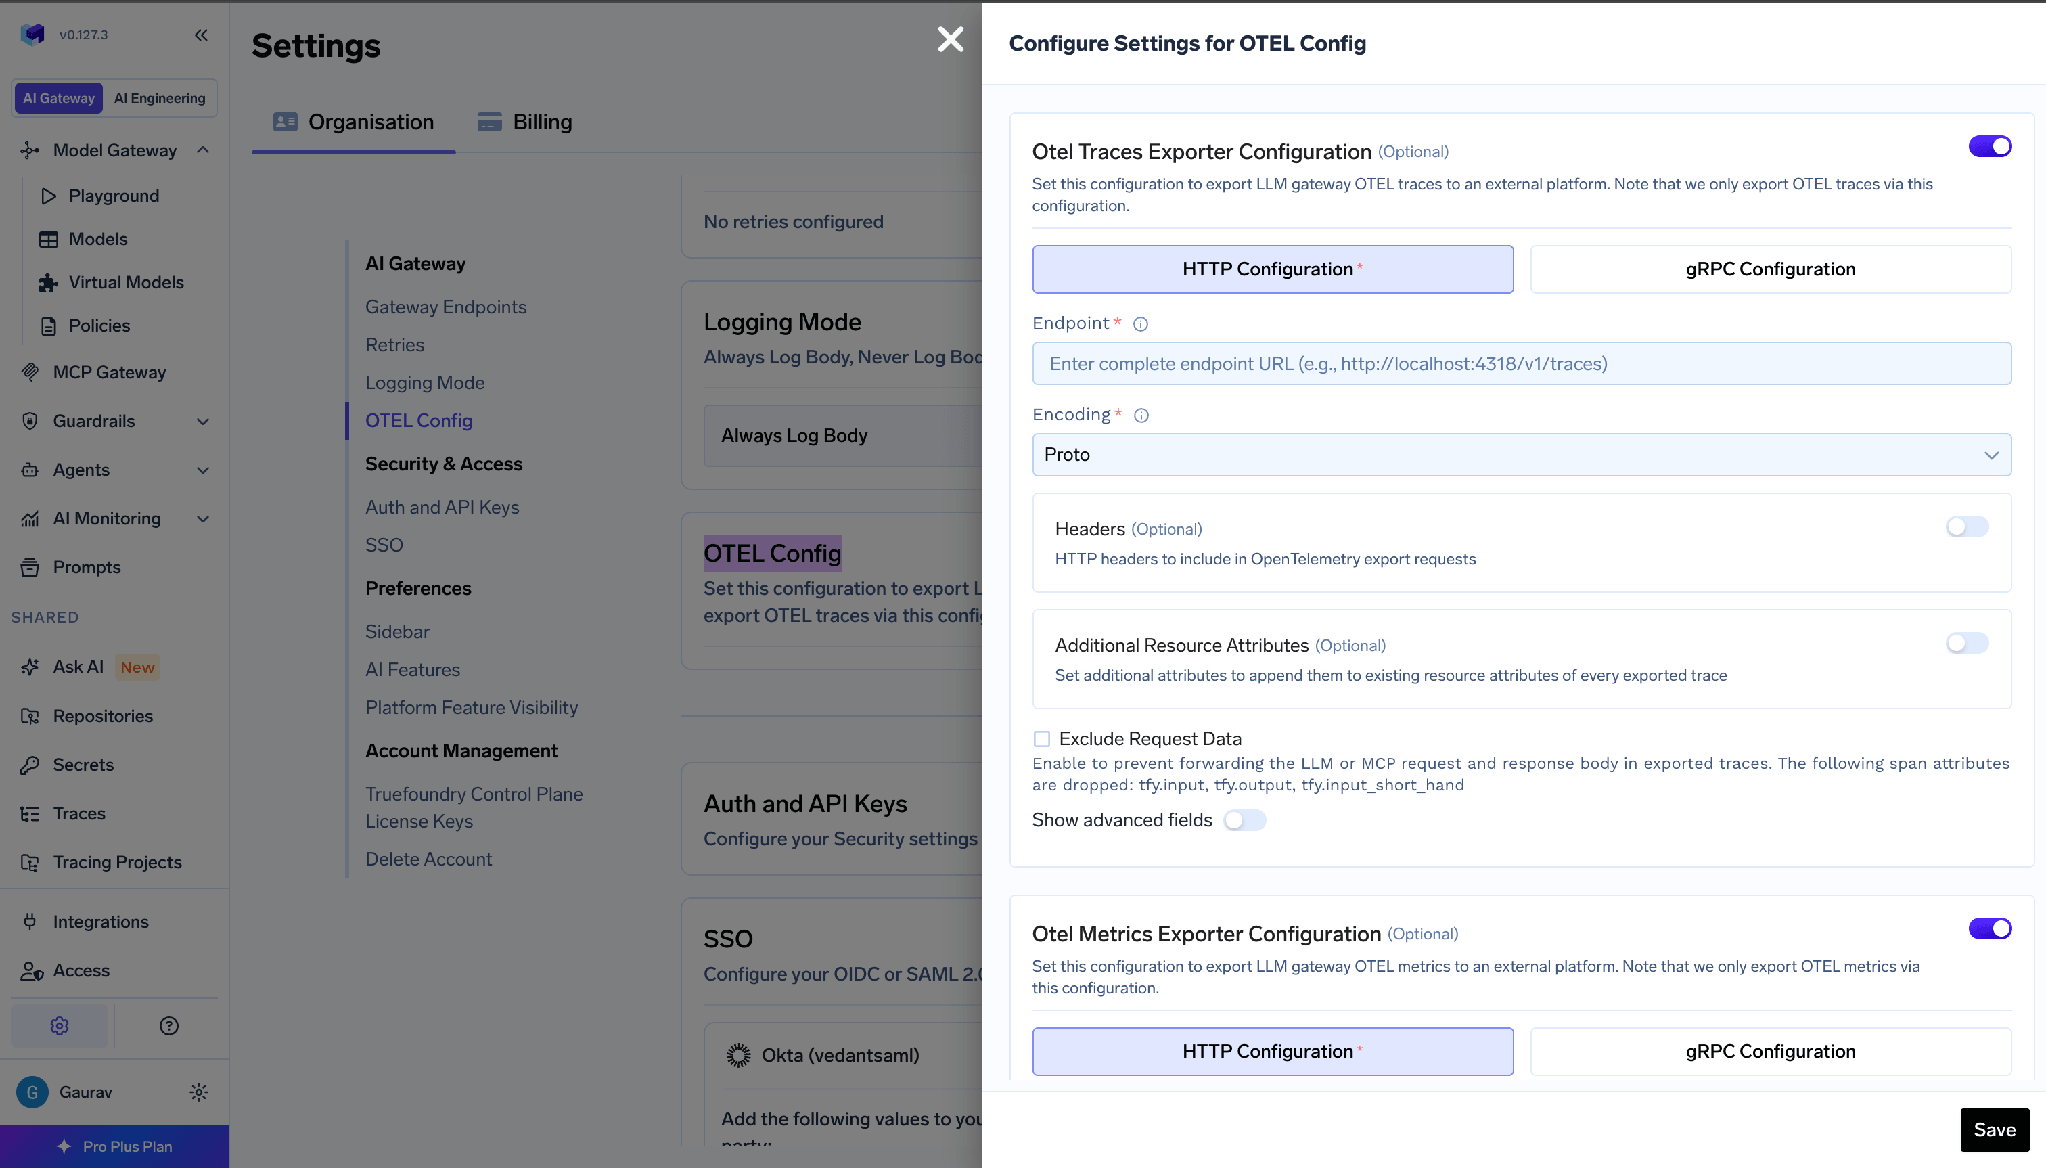
Nada de esto requiere abandonar la infraestructura que ya tienes. La pasarela es compatible con OpenTelemetry, y las trazas y métricas se exportan de forma independiente; ambas se configuran en AI Gateway → Controls → Settings → OTEL Config, a través de HTTP o gRPC, con codificación proto o json y cabeceras de autenticación arbitrarias. Los backends que esperan métricas codificadas en delta, como Datadog y CloudWatch, necesitan el conmutador Export Delta Metrics además de una variable de entorno de temporalidad en el despliegue de la pasarela. Prometheus puede realizar scraping de /metrics en pasarelas autohospedadas.
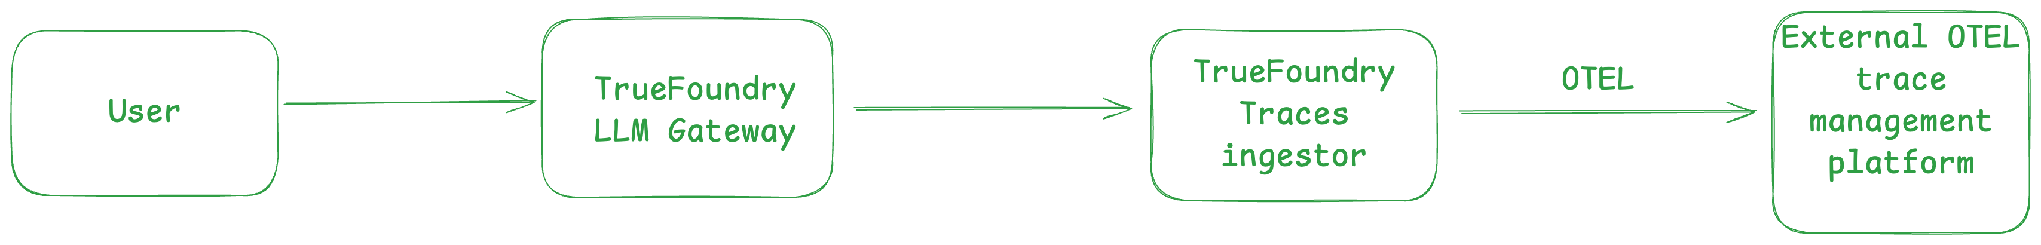
Flujo de trazas de OpenTelemetry: trazas almacenadas por TrueFoundry y exportadas a un backend externo
La exportación es aditiva, no una transferencia: TrueFoundry sigue almacenando las trazas en cualquier caso, por lo que las vistas de sesiones y spans dentro del producto permanecen disponibles mientras Grafana o Datadog reciben los mismos datos.
Copiloto de soporte, una semana en producción. Finanzas pregunta por qué la factura se ha triplicado.
Empieza a nivel de sesión. Ordena por coste. La mediana es de unos pocos céntimos; cuatro sesiones superan el dólar, todas con un número de turnos de un solo dígito; por lo tanto, no se trata de conversaciones largas, sino de turnos individuales que consumen demasiado.
Abre una y lee la cronología. El turno 3 está casi totalmente coloreado por llamadas a herramientas. Llamadas a herramientas: 31. Errores: 0. No falló nada, por eso no se activó ninguna alerta.
Despliega los pasos del agente para el turno 3. La lista ordenada muestra una herramienta de obtención de documentos llamada repetidamente, y los tokens por turno aumentan drásticamente a partir del turno 3 sin volver a bajar: un documento grande entró en el contexto y permaneció allí.
Confirma a nivel de herramienta. En las métricas de MCP, en la vista de herramientas, esa herramienta encabeza el ranking de número de solicitudes por un amplio margen y tiene el peor p90.
Corrige y luego verifica. Tanto si la solución es una herramienta más específica, paginación o un cambio en el prompt indicando al agente que ya tiene el archivo, la verificación es la misma: filtra las sesiones de ese agente para el día siguiente y comprueba que la distribución de costes se ha estabilizado. Si has configurado la retroalimentación, comprueba si los valores atípicos también fueron las ejecuciones mal valoradas; normalmente lo son.
Cinco pasos, sin instrumentación personalizada, cada uno de ellos una pregunta sobre la trayectoria.
Las métricas del agente incluyen todas las solicitudes de puerta de enlace por defecto. Las filas que no pasaron por un agente devuelven null para agentName, agentFramework y agentServerType, y aparecen como buckets nulos en la salida de groupBy. IS_NULL no es compatible con esos tres campos, así que utiliza un ámbito con agentName IN [...] o un operador STRING_*.
La exportación de trazas y métricas se configura por separado. El exportador de trazas solo envía trazas, y el de métricas solo métricas. Habilitar uno y asumir que el otro le seguirá es una forma común de terminar con una visión incompleta.
Planifica los metadatos antes de necesitarlos. Las claves de metadatos personalizadas enviadas como cabeceras de solicitud se convierten en una Ver por dimensión en todo el panel de control. Añadir un nombre de agente, entorno o ID de ejecución desde el principio no cuesta nada; adaptarlo después significa que los datos del trimestre pasado no podrán segmentarse de esa manera.
La tentación con la monitorización de agentes es añadir un agente a los paneles que ya tienes, observar el percentil 99 y la tasa de errores, y darlo por observado. Eso funciona hasta el primer incidente, cuando descubres que la ejecución que agotó tu presupuesto devolvió un 200 en cada salto y no aparece en ningún gráfico.
La solución no es tener más métricas, sino una unidad de observación diferente. Registra la trayectoria —sesión, turno, llamada al modelo, llamada a herramienta, con argumentos y resultados en los spans— y los tres fallos que realmente ocurren se vuelven evidentes: un bucle es una llamada repetida con argumentos idénticos, un mal resultado de una herramienta es visible porque lo conservaste, y una ejecución 40x es el valor atípico que ordenas para ver primero.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.




Registrar la trayectoria de ejecución completa de un agente —sesiones, turnos, llamadas a modelos y llamadas a herramientas, con argumentos, resultados, tokens, coste y latencia— para poder responder por qué se comportó como lo hizo. Se diferencia de la monitorización de aplicaciones en la unidad de observación: una solicitud tiene un principio y un final, mientras que una trayectoria es una secuencia anidada en la que cualquier nivel puede entrar en bucle.
La observabilidad de LLM es un subconjunto que cubre la llamada al modelo: prompt, respuesta, tokens, latencia y coste. La observabilidad de agentes añade todo lo que la rodea: qué herramientas se ejecutaron, en qué orden, con qué argumentos y resultados, y cuántas vueltas dio un turno antes de detenerse. La mayoría de los fallos reales están en esa estructura, no en una única respuesta.
No si el tráfico de modelos y de herramientas ya pasa por un gateway, puesto que este registra cada salto como efecto secundario de atenderlo. La instrumentación con SDK a nivel de framework añade pasos internos de razonamiento que el gateway nunca ve, de modo que ambas son complementarias, no alternativas.
Sí: en VPC, on-prem, entornos air-gapped, híbridos o en varias nubes, sin que ningún dato salga de su dominio.
Sí. Incluye un MCP Gateway, un Agent Gateway y un MCP & Agents Registry con control de acceso a nivel de herramienta. Los agentes creados con LangGraph, CrewAI, AutoGen o un framework propio pueden gobernarse de forma centralizada.
Sí. La pasarela es compatible con OpenTelemetry y se integra con Grafana, Datadog, Prometheus o tu pila preferida. Rastrea cada solicitud desde la instrucción (prompt) hasta la ejecución de la herramienta y el modelo, así obtienes un registro unificado sin tener que reemplazar lo que ya tienes en funcionamiento.



Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















