October 15, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026

Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
In den meisten KI-Programmen von Unternehmen kommt der Moment, in dem eine Workload auftaucht, deren Daten nicht an eine Drittanbieter-API gesendet werden dürfen – sei es aufgrund regulierter Datensätze, Souveränitätsanforderungen oder einer Kostenkurve, die bei zunehmender Skalierung beängstigend wird. Die Lösung ist ein Open-Weight-Modell, das Sie selbst betreiben. Der Grund, warum Teams dies scheuen, ist nicht das Modell selbst, sondern die Tatsache, dass Self-Hosting meist einen zweiten, separaten Stack bedeutet – eine Nicht-OpenAI-API, eine Serving-Layer, GPU-Operationen –, der mühsam an eine auf kommerzielle APIs ausgelegte Plattform angeflanscht werden muss. Dieser Beitrag zeigt, wie ein Gateway diese Komplexität reduziert und ein selbst gehostetes Llama oder Mistral nahtlos neben die kommerziellen Modelle stellt, die Sie bereits nutzen.
Ravi, ein ML-Plattform-Ingenieur, erhielt die Anfrage, die er schon erwartet hatte: Eine neue Workload sollte Datensätze verarbeiten, die laut Richtlinie die Cloud des Unternehmens nicht verlassen durften. Eine kommerzielle API kam nicht infrage. Ein Open-Weight-Modell in der eigenen VPC war die logische Konsequenz – doch Ravi sank das Herz in die Schuhe. Die Anwendung war für die OpenAI-API geschrieben, das Team hatte keinen Serving-Stack, und er sah bereits das Paralleluniversum vor sich: ein zweites SDK, ein zweites Dashboard-Set und ein GPU-Autoscaling-Problem, das noch niemand gelöst hatte. Das Modell war die einfache Entscheidung. Der Stack drumherum war das Problem.
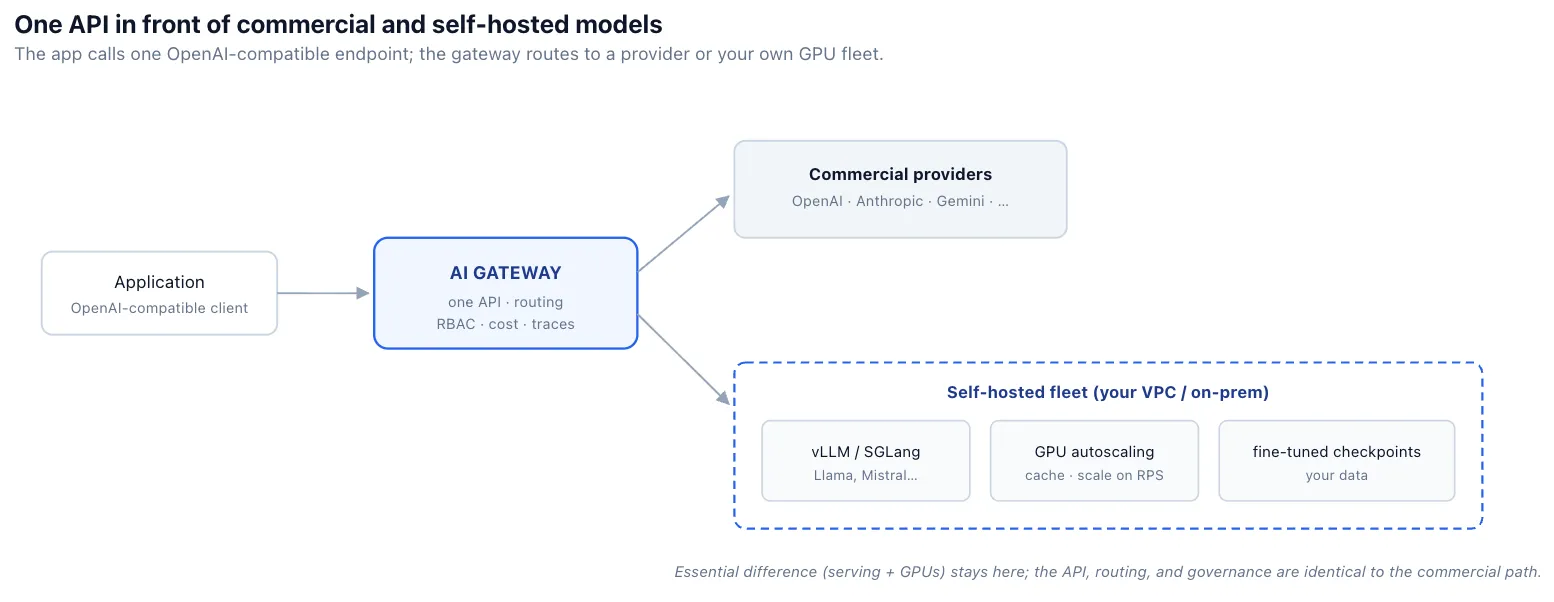
Was Ravis Woche rettete, war die Erkenntnis, dass das selbst gehostete Modell gar kein anderer Stack sein musste. Wenn es hinter demselben Gateway wie die kommerziellen Modelle saß und dieselbe OpenAI-kompatible API sprach, war es für die Anwendung einfach nur ein weiterer Modellname – und für die Plattform ein weiterer Endpunkt, der denselben Regeln unterlag. Die Souveränitätsanforderung wurde erfüllt, ohne die Architektur aufzuspalten. Dieser Beitrag erklärt, wie das funktioniert und wo die eigentliche technische Arbeit weiterhin liegt.
Beim Self-Hosting eines Open-Weight-Modells geht es selten um die Qualität – Frontier-APIs sind exzellent und werden ständig besser. Es geht um vier andere Faktoren. Souveränität: Bestimmte Daten dürfen rechtlich oder vertraglich Ihre Umgebung nicht verlassen. Ein Modell, das in Ihrer VPC oder On-Premises läuft, erfüllt dies von Grund auf. Skalierungskosten: Ab einem gewissen konstanten Volumen können amortisierte GPUs die Kosten pro Token unterbieten, insbesondere bei Workloads mit hohem Durchsatz und Vorhersehbarkeit. Kontrolle: Sie wählen die Modellversion, können auf proprietären Daten feinabstimmen (Fine-Tuning) und sind nicht davon abhängig, dass ein Anbieter ein Modell ohne Vorwarnung ändert oder einstellt. Verfügbarkeit: Ihr Inferenz-Pfad ist nicht mehr direkt an die Uptime eines API-Anbieters gebunden – allerdings hängt er nun von Ihrer eigenen Infrastruktur und Deployment-Supply-Chain ab.
Das ehrliche Gegenargument ist, dass Sie nun die Verantwortung für den Inferenz-Betrieb tragen: GPU-Kapazität, Serving-Stack, Skalierung und Zuverlässigkeit – Aufgaben, die eine kommerzielle API komplett verbirgt. Self-Hosting lohnt sich, wenn einer dieser vier Faktoren kritisch ist und die Betriebskosten im Rahmen bleiben. Die meisten Unternehmen fahren einen hybriden Ansatz: kommerzielle APIs für den allgemeinen Datenverkehr, selbst gehostete Modelle für souveräne oder hochvolumige Bereiche. Das Ziel ist nicht, das eine durch das andere zu ersetzen, sondern beides zu betreiben, ohne alles doppelt vorhalten zu müssen.
Anpassungen verdienen es, aus dieser Liste hervorgehoben zu werden, da sie oft der entscheidende Grund sind, warum sich Teams für Open-Weight-Modelle entscheiden. Eine kommerzielle API bietet Ihnen ein Modell, das jemand anderes für alle trainiert hat; ein Open-Weight-Modell können Sie an Ihre Domäne, Ihre Formate, Ihren Tonfall und Ihre speziellen Anforderungen anpassen, indem Sie es mit Daten feinabstimmen, die Sie nirgendwohin senden können oder wollen. Für eng begrenzte, repetitive Aufgaben kann ein kleineres, feinabgestimmtes Open-Modell ein viel größeres allgemeines Modell erreichen oder übertreffen – und das zu einem Bruchteil der Serving-Kosten. Damit fließt der Faktor Anpassung wieder in den Kostenfaktor ein. Der Haken ist, dass Fine-Tuning eine eigene Pipeline erfordert: Datenaufbereitung, Trainingsläufe, Evaluierung, Versionierung und schließlich das Bereitstellen des Ergebnisses wie bei jedem anderen Modell. TrueFoundry unterstützt sowohl No-Code- als auch Full-Code-Fine-Tuning direkt im Serving-Stack. So landet ein feinabgestimmtes Modell hinter demselben Gateway-Endpunkt wie alles andere, anstatt zu einem separaten Artefakt zu werden, das Sie manuell operationalisieren müssen. Der Punkt ist nicht, dass sich Fine-Tuning immer lohnt – oft ist das nicht der Fall, und ein gutes Basismodell mit starkem Prompting ist oft die bessere Wahl –, aber wenn es sich lohnt, ist der Besitz der Gewichte die Voraussetzung dafür.
Ein wichtiger Hinweis vorab: Open-Weight bedeutet nicht frei von Verpflichtungen. Bevor Sie ein Modell selbst hosten oder feinabstimmen, prüfen Sie die Lizenz, die Richtlinien zur akzeptablen Nutzung, die Bedingungen zur Weiterverbreitung, Anforderungen zur Namensnennung sowie etwaige Einschränkungen für die kommerzielle Nutzung oder regulierte Bereiche. Einige populäre Open-Weight-Modelle haben Nutzungsschwellen oder Anwendungsbeschränkungen, die bei Unternehmenseinsatz relevant werden. Betrachten Sie die Lizenzprüfung als Teil der Deployment-Checkliste und nicht als Fußnote, die erst entdeckt wird, wenn das Modell bereits in Produktion ist.
Ravis Befürchtungen waren berechtigt, denn der naive Ansatz beim Self-Hosting führt genau zu diesem zweiten Stack. Das Open-Weight-Modell gibt seine eigene API-Struktur vor, weshalb die Anwendung einen entsprechenden Codepfad benötigt. Es erfordert eine Serving-Engine, die eine eigene Betriebsebene darstellt. Es benötigt GPU-Autoscaling, das sich völlig anders verhält als die Skalierung eines zustandslosen Webdienstes. Und es braucht eine eigene Observability, da die Dashboards kommerzieller APIs hier nicht greifen. Multipliziert man das mit ein paar Modellen, erhält man eine parallele Plattform, deren einzige Aufgabe darin besteht, anders zu sein als die, die man bereits betreibt.
Die Erkenntnis, die hier Abhilfe schafft, ist, dass fast nichts von dieser Andersartigkeit die Anwendung oder die Steuerungsebene der Plattform erreichen muss. Die Serving-Engine und das GPU-Scaling sind real und unvermeidlich – sie sind die eigentliche Arbeit beim Self-Hosting. Aber die API-Struktur, das Routing, die Governance und die Observability können identisch mit dem kommerziellen Weg gestaltet werden, indem man dasselbe Gateway davor schaltet. Der Rest dieses Beitrags unterscheidet zwischen dem wesentlichen Unterschied (Serving, GPUs) und dem zufälligen Unterschied (alles, was das Gateway abfangen kann).
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet