Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
9,9
Senken Sie Ihre Infrastrukturkosten für ML-/LLM-Modelle
Workloads für maschinelles Lernen (ML) und Large Language Models (LLM) sind in der Cloud bekanntermaßen teuer im Betrieb. Das liegt daran, dass sie erhebliche Mengen an Rechenleistung, Arbeitsspeicher und Speicherplatz erfordern. Es gibt jedoch Möglichkeiten, Ihre Cloud-Kosten für ML/LLM-Workloads zu senken, ohne dabei Kompromisse bei Skalierbarkeit oder Zuverlässigkeit einzugehen.
Grundprinzipien zur Kostensenkung
Bessere Transparenz für DevOps-Engineers und Entwickler: Es ist schwierig, den Überblick über Cloud-Kosten zu behalten, insbesondere wenn mehrere Komponenten über verschiedene Clouds hinweg bereitgestellt werden. TrueFoundry bietet Transparenz bei den Cloud-Kosten auf Cluster-, Workspace- und Deployment-Ebene und versetzt DevOps-Teams und Entwickler in die Lage, Möglichkeiten zur Kosteneinsparung über den gesamten ML/LLM-Lebenszyklus hinweg zu identifizieren und zu optimieren.
Einfache Ressourcenanpassung: TrueFoundry ermöglicht es DevOps-Teams und Entwicklern, auf Basis der gewonnenen Kostentransparenz aktiv zu werden.
DevOps-Teams können Ressourcenbeschränkungen auf Projektebene festlegen und so sicherstellen, dass die Workloads jedes Teams Zugriff auf die benötigten Ressourcen haben, ohne das Budget zu überschreiten.
Entwickler können Ressourcen zudem ganz einfach und flexibel anpassen, basierend auf den gewonnenen Erkenntnissen. Darüber hinaus macht es TrueFoundry leicht, Anwendungen und IDEs in Nicht-Produktionsumgebungen auf null zu skalieren. Dadurch werden Kosten für ungenutzte Ressourcen eliminiert und Iterationszyklen zur Kostensenkung effizienter gestaltet.
Infrastrukturoptimierung zur Kostensenkung: Die Kubernetes-basierte Architektur und die Infrastrukturoptimierungen von TrueFoundry sind darauf ausgelegt, Cloud-Kosten zu senken.
Insgesamt bieten die kostensparenden Funktionen von TrueFoundry DevOps-Teams und Entwicklern die Transparenz, Kontrolle und Optimierungsmöglichkeiten, die sie benötigen, um Cloud-Kosten über den gesamten ML/LLM-Lebenszyklus hinweg zu reduzieren.
Umstellung von AMI auf Docker: Unsere Plattform hat vielen Unternehmen den Wechsel von AMI zu Docker erleichtert, wobei diese bereits Kosteneinsparungen von 30 bis 40 Prozent verzeichnen konnten.
TrueFoundry: Ihre kostenorientierte Plattform
TrueFoundry ist eine „Cost-First“-Plattform, die auf Kubernetes basiert und mit einer Architektur entwickelt wurde, die Effizienz priorisiert, Cloud-Skalierbarkeit unterstützt.und Kostensenkungen in den Mittelpunkt stellt.
Erfahren Sie, wie die einzigartige Architektur von TrueFoundry Ihnen dabei hilft, Kosten zu senken und gleichzeitig Zuverlässigkeit und Skalierbarkeit zu optimieren. Hier ist die hierarchische Struktur der Plattform:
Cluster: Verbinden Sie alle Ihre Cluster – ob AWS EKS, Azure AKS, GCP GKE oder On-Premise-Cluster – mit der Plattform. So können Sie all Ihre Cluster nahtlos an einem zentralen Ort integrieren. Diese Cluster bilden die Grundlage für die Bereitstellung einer Vielzahl von Diensten, Modellen und Jobs.
Workspaces: Innerhalb der Cluster führen wir Workspaces ein. Diese bieten einen optimierten Ansatz für Zugriffssteuerung und Isolierung, um sicherzustellen, dass jedes Projekt oder jede Umgebung über eigene dedizierte Ressourcen verfügt und vor unbefugtem Zugriff geschützt ist. Betrachten Sie sie als Gruppen von Deployments.
Deployments: Innerhalb dieser Workspaces gibt es Deployments, und wir unterstützen Sie bei der Bereitstellung verschiedenster Anwendungen. Mit TrueFoundry decken Sie mühelos jeden Aspekt Ihres ML-Entwicklungslebenszyklus ab.
Interaktive Entwicklungsumgebungen: Stellen Sie Jupyter Notebooks und VS Code für die kollaborative Experimentierarbeit bereit.
Training- und Fine-Tuning-Jobs: Trainieren Sie ML-Modelle effizient oder führen Sie ein Fine-Tuning von LLMs durch, indem Sie diese als Job bereitstellen.
Vortrainierte LLMs: Stellen Sie vortrainierte Large Language Models für spezifische Anwendungsfälle schnell über unseren Modellkatalog bereit.
Dienste und Apps: Stellen Sie eine Vielzahl von Diensten und Anwendungen bereit, darunter Modelle, Web-Apps und mehr.
Anwendungskatalog: Stellen Sie beliebte Software wie Label Studio, Redis, Qdrant usw. mit Leichtigkeit bereit.
Kosteneinsparungen auf Clusterebene
Kubernetes-basierte Infrastruktur
Kubernetes trägt zur Kostensenkung bei, indem es Bin-Packing zur Optimierung der Ressourcennutzung einsetzt, Container effizient platziert und so letztlich die Infrastrukturkosten senkt.
Erfahren Sie mehr darüber, wie TrueFoundry Kubernetes einsetzt, in unserem hierhandelt.
💡
Migration von EC2 zu Kubernetes: Viele Unternehmen sind nach dem Onboarding auf unsere Plattform erfolgreich von EC2-Instanzen auf Kubernetes umgestiegen, was durch eine verbesserte Ressourcenzuweisung zu Kosteneinsparungen geführt hat.
Flexibilität beim Wechsel zwischen Clouds: Durch die Möglichkeit, einfach zwischen verschiedenen Cloud-Anbietern zu wechseln, können Sie von den besten Preisen und Funktionen der jeweiligen Anbieter profitieren.
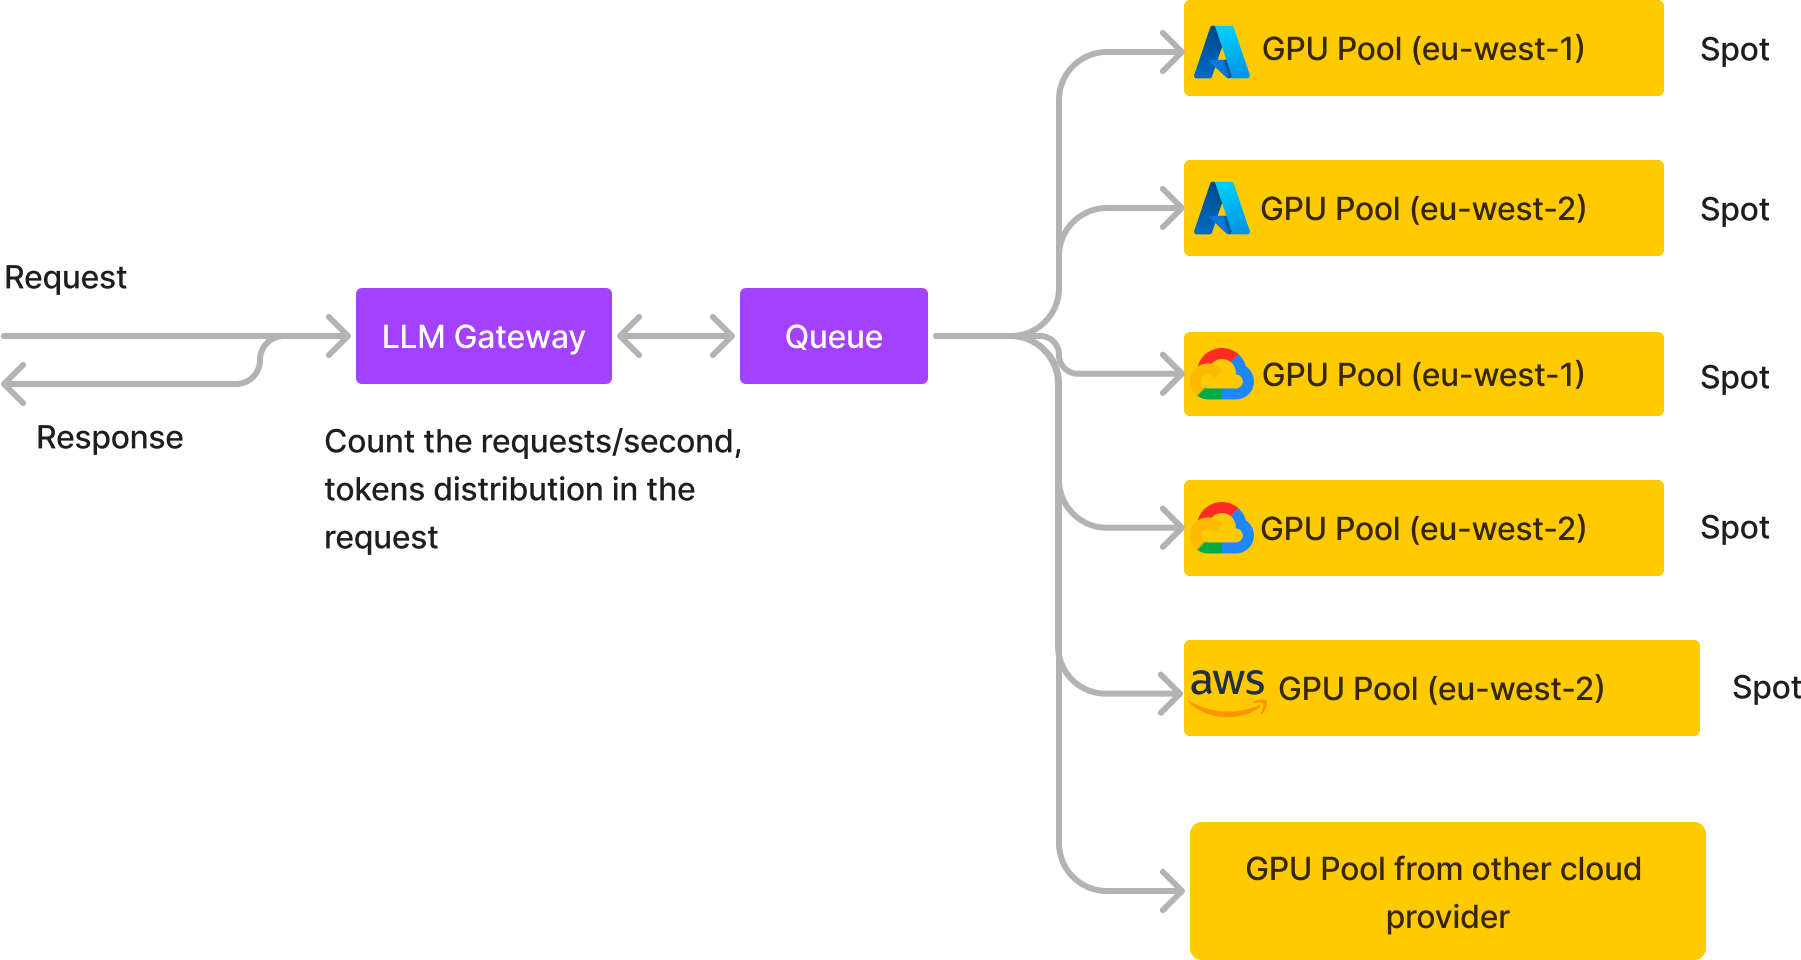
Verteilung von Workloads auf Clouds und Regionen: Durch die Verteilung Ihrer Workloads auf mehrere Cloud-Anbieter und Regionen können Sie Kosten senken, indem Sie verschiedene Preismodelle und Regionen nutzen. Zudem verbessern Sie Leistung und Zuverlässigkeit, da Sie nicht von einem einzigen Cloud-Anbieter abhängig sind.
Hohe Verfügbarkeit von Instanz-Kontingenten: Durch die Nutzung mehrerer Cloud-Anbieter erhalten Sie Zugriff auf mehr Ressourcen. Dies hilft Ihnen, Kosten zu sparen und Engpässe bei den benötigten Ressourcen zu vermeiden.
Skalierung von LLMs über mehrere Clouds und Regionen hinweg
💡
Ein mittelständischer Anbieter von KI-Chatbots mit hohem Nutzeraufkommen (über 20 RPS und mehr als 2 Millionen Anfragen pro Tag) betreibt seine gesamte Infrastruktur über unseren asynchronen Dienst auf verteilten Spot-GPU-Instanzen in fünf Clustern über verschiedene Clouds und Regionen hinweg. Dies senkt die Infrastrukturkosten um 60 % und verbessert gleichzeitig Zuverlässigkeit und Durchsatz.
Erweiterte Transparenz
Für jeden Cluster können Sie die Anzahl der laufenden Knoten einsehen. Zudem erhalten Sie Einblicke in knotenspezifische Details wie
Einsparanalyse: Sehen Sie den prozentualen Anteil der Kosteneinsparungen für jeden Knoten
Einblicke in die Ressourcenzuweisung: Sehen Sie sich die aktuelle Auslastung sowie Ressourcenanforderungen und -limits an, um fundierte Entscheidungen zu treffen.
Einblicke in Kapazitätstypen: Sehen Sie, welche Knotentypen in Ihrem Cluster ausgeführt werden, ob es sich um Spot- oder On-Demand-Knoten handelt.
Kosteneinsparungen auf Workspace-Ebene
Ressourcenlimits
TrueFoundry ermöglicht es Ihnen, mehrere Workspaces innerhalb eines Clusters zu erstellen. Diese Segmentierung hilft Ihnen dabei, Ihre Deployments für verschiedene Teams oder Umgebungen zu organisieren.
Ressourcenbeschränkungen: Passen Sie die Ressourcenbeschränkungen für jeden Workspace individuell an, einschließlich CPU, Arbeitsspeicher, Speicherplatz und sogar Instanzfamilien. So können Sie Ressourcen gezielt den spezifischen Anforderungen Ihres Projekts oder Ihrer Umgebung zuweisen.
Unterstützte Instanzfamilien: Passen Sie Ihren Workspace an spezifische Leistungsanforderungen und Ihr Budget an, indem Sie die unterstützten Instanzfamilien auswählen.
Wenn ein Projekt beispielsweise keine Hochleistungsrechner benötigt, können Sie größere Instanzen in dessen Workspace deaktivieren. Dies verhindert, dass Entwickler Ressourcen übermäßig bereitstellen, was Kosten spart.
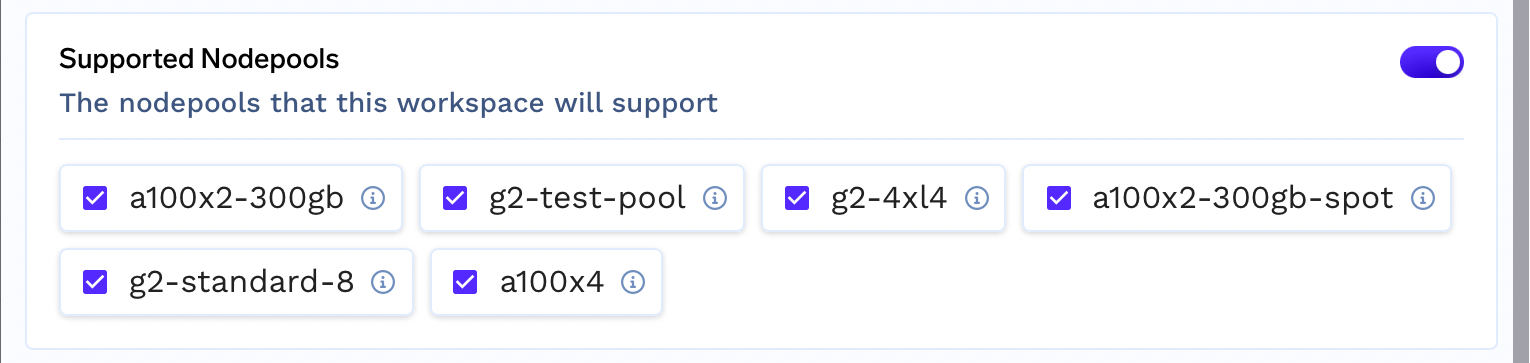
Unterstützte Node-Pools: Node-Pools sind Gruppen von Knoten, die die Rechenressourcen für Ihre Workloads bereitstellen. Sie können die Node-Pools auswählen, die am besten zu Ihren Workloads und Ihrem Budget passen.
Sie können beispielsweise einen Node-Pool mit A100-GPUs erstellen. Anschließend können Sie diesen spezifischen Node-Pool nur für Projekt-Workspaces freigeben, die Zugriff auf diese Art von GPU benötigen.
Kosten auf Workspace-Ebene nachverfolgen
Wir bieten Ihnen zudem Transparenz, um die Kosten auf Workspace-Ebene basierend auf der bisherigen Nutzung nachzuverfolgen. So können Sie erkennen, welche Projekte oder Umgebungen die meisten Ressourcen verbrauchen und wo Sie Einsparungen erzielen können.
Kosteneinsparungen auf Deployment-Ebene
Wir bieten erweiterte Funktionen auf Anwendungsebene, mit denen Sie erhebliche Kosteneinsparungen erzielen können:
Spot-Instanzen mit Fallback auf On-Demand: Anwendungen haben oft Schwierigkeiten, Kosten und Zuverlässigkeit in Einklang zu bringen. Mit TrueFoundry können Sie den Kapazitätstyp für Ihre Knoten wählen, einschließlich Spot-Instanzen mit automatischem Fallback auf On-Demand-Ressourcen. So stellen Sie sicher, dass Ihre Anwendungen auch bei einem Ausfall einer Spot-Instanz verfügbar bleiben und profitieren von einem optimalen Verhältnis zwischen Kosten und Verfügbarkeit.
Dienste pausieren: Pausieren Sie Dienste bei Nichtgebrauch, um Kosten zu sparen. Über die Seite für Bereitstellungen lassen sich Dienste ganz einfach anhalten oder wieder fortsetzen.
Ressourcenoptimierung: Stellen Sie sicher, dass Ihre Ressourcen optimal zugewiesen sind und Ihre Dienste mit der richtigen Kapazität laufen.
Ressourcenüberwachung: Überwachen Sie die Ressourcennutzung Ihres Dienstes in Echtzeit, einschließlich der CPU- und GPU-Zuweisung. Erhalten Sie Benachrichtigungen bei Über- oder Unterdimensionierung sowie Empfehlungen zur Ressourcenoptimierung.
Dynamische Ressourcenanpassung: Passen Sie Ressourcenstufen im laufenden Betrieb an, um die CPU-Leistung bei Bedarf zu reduzieren und Ihren Dienst entsprechend neu bereitzustellen.
Zeitgesteuertes Autoscaling: Planen Sie Ressourcenanpassungen zeitbasiert, um Kosten in Nicht-Produktionsumgebungen während Zeiten geringer Auslastung zu senken.
💡
Viele unserer Kunden sparen über 60 % ihrer Cloud-Kosten für Entwicklungsumgebungen, indem sie Abschaltungen außerhalb der Arbeitszeiten planen und so die Rechenlast um 128 Stunden pro Woche reduzieren.
Kosteneinsparungen bei Code-Editoren
Wir bieten spezielle Funktionen für Code-Editoren an, mit denen Sie auf Notebook- und VSCode-Ebene erhebliche Kosteneinsparungen erzielen können:
Gemeinsam genutzte Volumes: Nutzen Sie bedarfsgerechte Volumes, um große Datenmengen zwischen Notebooks und VSCode-Instanzen auszutauschen und die Zusammenarbeit zu erleichtern. Gemeinsam genutzte Volumes reduzieren Redundanzen und steigern die Effizienz, insbesondere wenn mehrere Benutzer Zugriff auf umfangreiche Daten in verschiedenen Notebooks und VSCode-Instanzen benötigen.
Adaptive Ressourcennutzung: Wechseln Sie auf derselben Maschine einfach zwischen CPU und GPU, um die Ressourcenzuweisung zu optimieren. Sie müssen GPU-Ressourcen nicht dauerhaft vorhalten, sondern nur bei Bedarf.
💡
Ein Unternehmen für generative KI im Bereich Videogenerierung, das Hunderte von Jupyter Notebooks auf Spot-Instanzen für Nicht-Produktions-Workloads betreibt, konnte seine Cloud-Kosten um etwa 50–60 % senken, indem GPUs nur bei Bedarf zugeschaltet wurden.
Manuelles Pausieren: Pausieren Sie Notebooks oder VSCode-Instanzen einfach, wenn sie nicht verwendet werden. Code und Daten bleiben erhalten, was einen nahtlosen Neustart bei Bedarf gewährleistet.
Automatisches Pausieren: Konfigurieren Sie Ihre Notebooks oder VSCode-Instanzen so, dass sie nach einer gewissen Zeit der Inaktivität automatisch pausieren, um wertvolle Ressourcen zu sparen.
💡
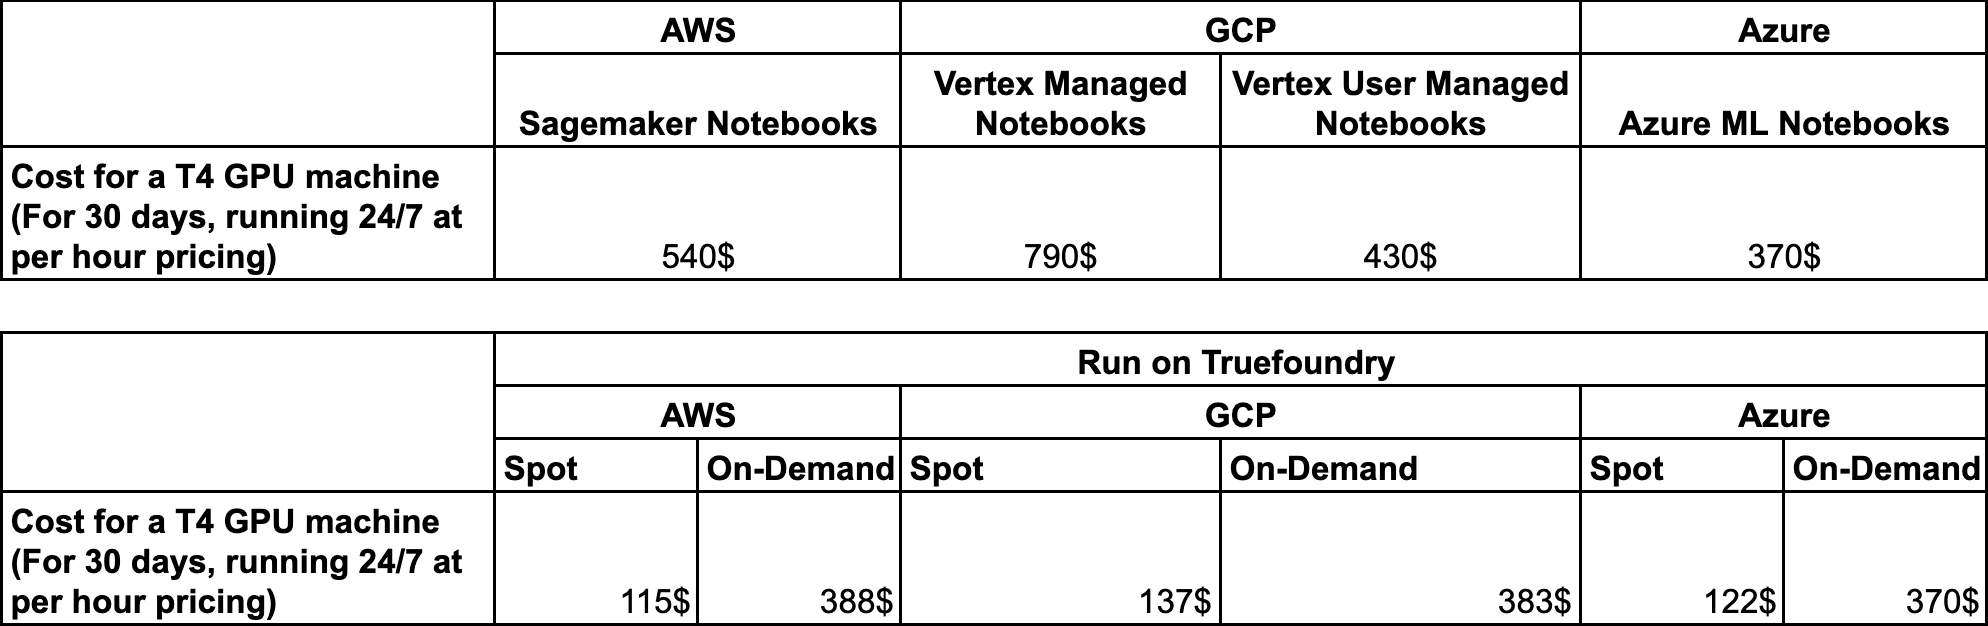
Kosten-Benchmarking Wir haben Benchmarks für AWS, GCP und Azure durchgeführt, um die Kosteneinsparungen beim Betrieb von Notebooks und VSCode auf Abruf (On-Demand) im Vergleich zur Nutzung der jeweiligen Cloud-Anbieter zu vergleichen.
Kosteneinsparungen bei der Bereitstellung und dem Fine-Tuning von Large Language Models (LLMs):
Unser Modellkatalog bietet eine praktische zentrale Anlaufstelle für die Bereitstellung und das Fine-Tuning bekannter vortrainierter LLMs. Wir haben diese Schritte unternommen, um sicherzustellen, dass die Bereitstellung und das Fine-Tuning dieser LLMs so kosteneffizient wie möglich sind:
Optimierte Konfiguration für die Modellbereitstellung: Basierend auf Benchmarks für verschiedene Modellserver und Ressourcenzuweisungen stellen wir Ihnen vorkonfigurierte Einstellungen zur Verfügung, die für optimale Latenz und Durchsatz sorgen. Dies vereinfacht den Prozess der LLM-Bereitstellung und hilft Ihnen, Ihre Deployments ressourceneffizient und kostengünstig zu gestalten.
Effiziente Konfiguration für das Fine-Tuning: Wir bieten effiziente Methoden für das Fine-Tuning, wie LoRA und Q-LoRA, die dazu beitragen, den Ressourcenverbrauch zu senken und Ihre Ziele zu geringeren Kosten zu erreichen.
Hier ist ein Blogbeitrag zum Thema Effizientes Fine-Tuning:
Skalierbare Deployments mit asynchroner Unterstützung: Stellen Sie LLMs skalierbar mit asynchroner Unterstützung bereit, um Ihre GPU-Kontingente in allen drei Clouds optimal zu nutzen und zuverlässig die GPUs zu erhalten, die Sie für das Fine-Tuning und die Bereitstellung benötigen. Diese zusätzliche Zuverlässigkeit ermöglicht Ihnen die Nutzung von Spot-Instanzen, wodurch Sie Kosten sparen.
Benchmarking Wir haben Kosten-Benchmarks durchgeführt, um die Ausgaben für die Bereitstellung von LLMs auf AWS EKS im Vergleich zu SageMaker zu vergleichen. Mehr dazu erfahren Sie im folgenden Blogbeitrag.
Zahlreiche Fortune-100-Unternehmen und mittelständische Betriebe haben durch die Nutzung unserer Plattform signifikante Einsparungen erzielt. Einige haben sogar ihre internen SageMaker- oder Cloud-Plattformen durch unser System ersetzt und dabei 30–40 % Kosten gespart.
Wir haben zudem die Leistung vieler gängiger Open-Source-LLMs in dieser Artikelserie hinsichtlich Latenz, Kosten und Anfragen pro Sekunde bewertet. Sie finden diese unter TrueFoundry-Blogs
Sie können sich auch dieses Video ansehen, um eine Live-Demo aller Funktionen zu erhalten, die wir in diesem Blog behandelt haben:
TrueFoundryist eine ML-Deployment-PaaS auf Basis von Kubernetes, die Entwickler-Workflows beschleunigt und gleichzeitig volle Flexibilität beim Testen und Bereitstellen von Modellen bietet, während sie dem Infrastruktur-Team umfassende Sicherheit und Kontrolle gewährleistet. Über unsere Plattform ermöglichen wir Machine-Learning-Teams:bereitstellen und überwachenModelle in 15 Minuten mit 100% Zuverlässigkeit, Skalierbarkeit und der Möglichkeit, innerhalb von Sekunden ein Rollback durchzuführen – so sparen sie Kosten, bringen Modelle schneller in die Produktion und erzielen echten geschäftlichen Mehrwert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last