October 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 6, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
OpenTelemetry verleiht GenAI-Systemen ein gemeinsames Telemetrie-Vokabular, ist jedoch kein fertiges, universelles Schema. Im Juni 2026 hat das Projekt seine GenAI-, anbieterspezifischen und MCP-semantischen Konventionen in ein dediziertes Repository verschoben, um eine unabhängige Iteration und Versionierung zu ermöglichen. Dieses Repository kennzeichnet die GenAI-Konventionen derzeit als Entwicklung, und mit Stand vom 21. August 2026 gibt es noch kein offizielles Release. Das Potenzial ist dennoch beträchtlich: Einheitliche Bezeichnungen für Modelloperationen, Token-Verbrauch, Agenten-Schritte, MCP-Aufrufe, Inhaltsereignisse und Evaluierungsergebnisse können den Übersetzungsaufwand zwischen Instrumentierung und Observability-Backends reduzieren. Die technische Strategie sollte auf Adoption bei gleichzeitigem Bewusstsein für die Versionierung setzen – nicht auf die Annahme, dass gen_ai.* bereits finalisiert ist.
Zwei Teams können valide OpenTelemetry-Daten senden und sich dennoch uneinig darüber sein, was ein LLM-Aufruf bedeutet. Transport-Interoperabilität und semantische Interoperabilität sind unterschiedliche Probleme. OTLP kann Telemetriedaten zwischen Systemen übertragen; semantische Konventionen machen die Felder innerhalb dieser Telemetrie konsistenter interpretierbar. Für GenAI wird das zweite Problem derzeit noch aktiv standardisiert.
Generisches APM bleibt nützlich für Durchsatz, Latenz, Fehler, Abhängigkeiten und den Status von Diensten. GenAI fügt Semantiken hinzu, die diese Signale allein nicht beschreiben.
Probabilistisches Verhalten. Die gleiche logische Anfrage kann unterschiedliche Ausgaben erzeugen, daher erfordert das Debugging oft das angefragte und bereitgestellte Modell, Generierungseinstellungen, Antwort-IDs und – sofern die Richtlinien dies zulassen – relevanten Eingabe- oder Ausgabekontext. Vollständige Inhalte sind nützliche Beweise, aber es ist nicht immer angemessen oder notwendig, diese zu speichern.
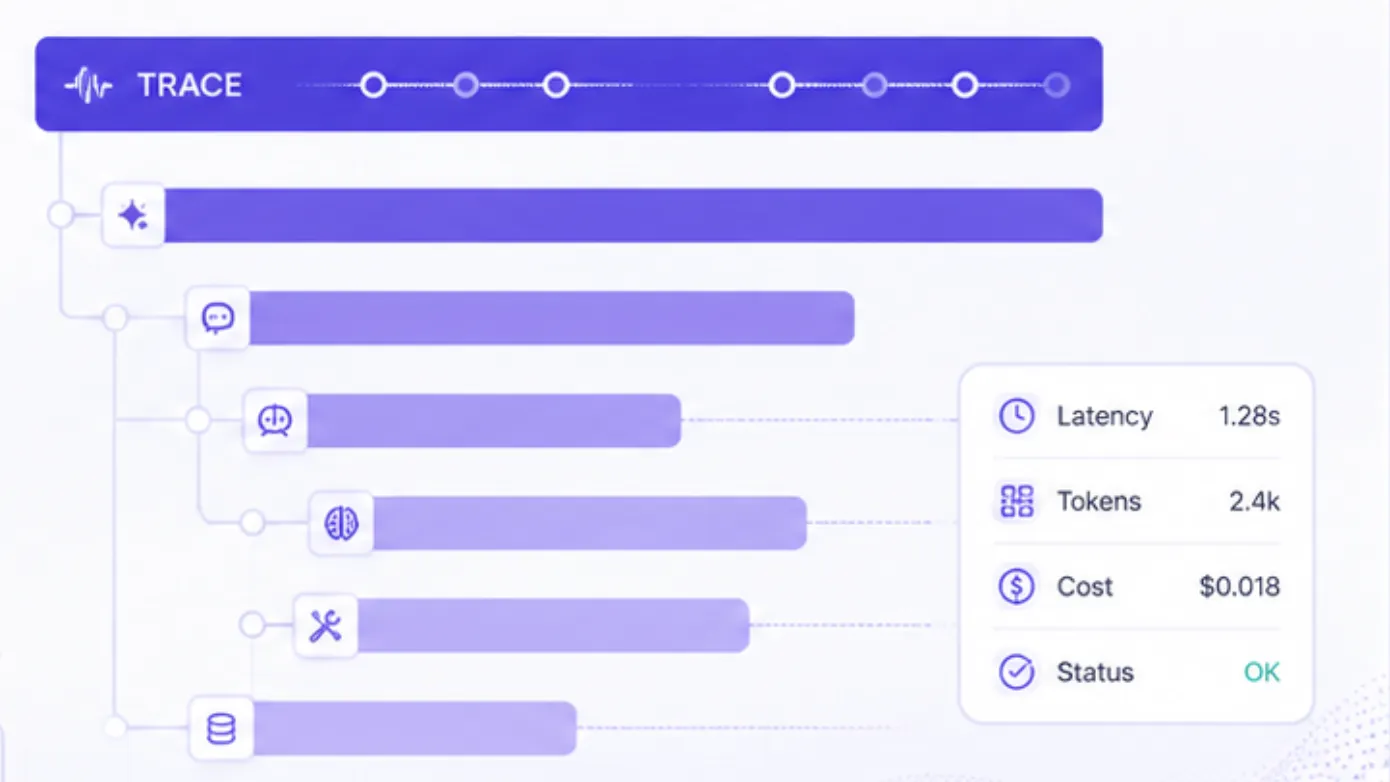
Token-Ökonomie. Die Anzahl der Anfragen ist weiterhin wichtig für Last- und Ratenbegrenzungen, reicht jedoch für Analysen zu Kosten und Modelleffizienz nicht aus. Eine geringe Anzahl an Aufrufen mit langem Kontext kann teurer sein als eine große Anzahl kurzer Aufrufe. Aktuelle GenAI-Metriken umfassen den Token-Verbrauch und die Operationsdauer sowie Messwerte für die Zeit bis zum ersten Chunk (Time-to-First-Chunk) und die Zeit pro Ausgabe-Chunk.
Agentenstruktur. Ein Modellaufruf ist nur eine Operation innerhalb vieler Agenten. Planung, Tool-Ausführung, Retrieval, Workflows und MCP-Aufrufe können das Ergebnis bestimmen. Observability benötigt daher ein Vokabular für die Ausführung, die die Inferenz umgibt, nicht nur für die API-Schnittstelle des Anbieters.
Sensibilität von Inhalten. Prompts und Ausgaben enthalten häufig Benutzer- oder Geschäftsdaten. OpenTelemetry kann beschreiben, wie diese Inhalte aufgezeichnet werden, aber ob diese erfasst, gespeichert, exportiert, geschwärzt oder eingeschränkt werden sollen, bleibt eine Entscheidung der Data Governance.
Am sinnvollsten lässt sich die aktuelle Arbeit anhand von Signalen und Vorgängen lesen, anstatt von einer einheitlichen Reifeskala auszugehen. Das dedizierte GenAI-Repository kennzeichnet die allgemeinen Konventionen als Entwicklung.
Modell- und Inferenz-Spans. Die aktuellen Konventionen definieren GenAI-Client-Vorgänge, einschließlich Inferenz, Embeddings, Abrufen, Antwortabruf, Speicheroperationen und Tool-Ausführung. Zu den allgemeinen Attributen gehören gen_ai.provider.name, gen_ai.operation.name, Identifikatoren für angeforderte und antwortende Modelle sowie die Nutzung von Eingabe-/Ausgabe-Token. Die Span-Zeitmessung liefert die Dauer des Vorgangs; dedizierte Metriken standardisieren die Token-Nutzung und latenzbezogene Messungen.
Agenten- und Framework-Spans. Die Agentenkonventionen definieren Vorgänge wie create_agent, invoke_agent, invoke_workflow, plan, sowie execute_tool. Diese Spans ermöglichen die Rekonstruktion eines instrumentierten Ausführungspfads. Sie legen die privaten Überlegungen eines Modells nicht offen und werden nicht automatisch angezeigt, es sei denn, das entsprechende Framework oder die Instrumentierung gibt sie aus.
MCP-Konventionen. MCP verfügt über eigene Entwicklungskonventionen für Client- und Server-Spans, W3C Trace Context Propagation, Transportkorrelation, tool-spezifische Attribute sowie Metriken wie mcp.client.operation.duration und mcp.server.operation.duration. Der Wert liegt in der Kontinuität über die MCP-Grenze hinweg – es ist kein Versprechen, dass bereits jede MCP-Implementierung diese Konventionen unterstützt.
Metriken und anbieterspezifische Konventionen. Das Repository definiert Metriken für Clients, Server, Workflows, Agenten und Tools und ergänzt anbieterspezifische Konventionen für Systeme wie OpenAI, Anthropic, Azure AI Inference und AWS Bedrock.
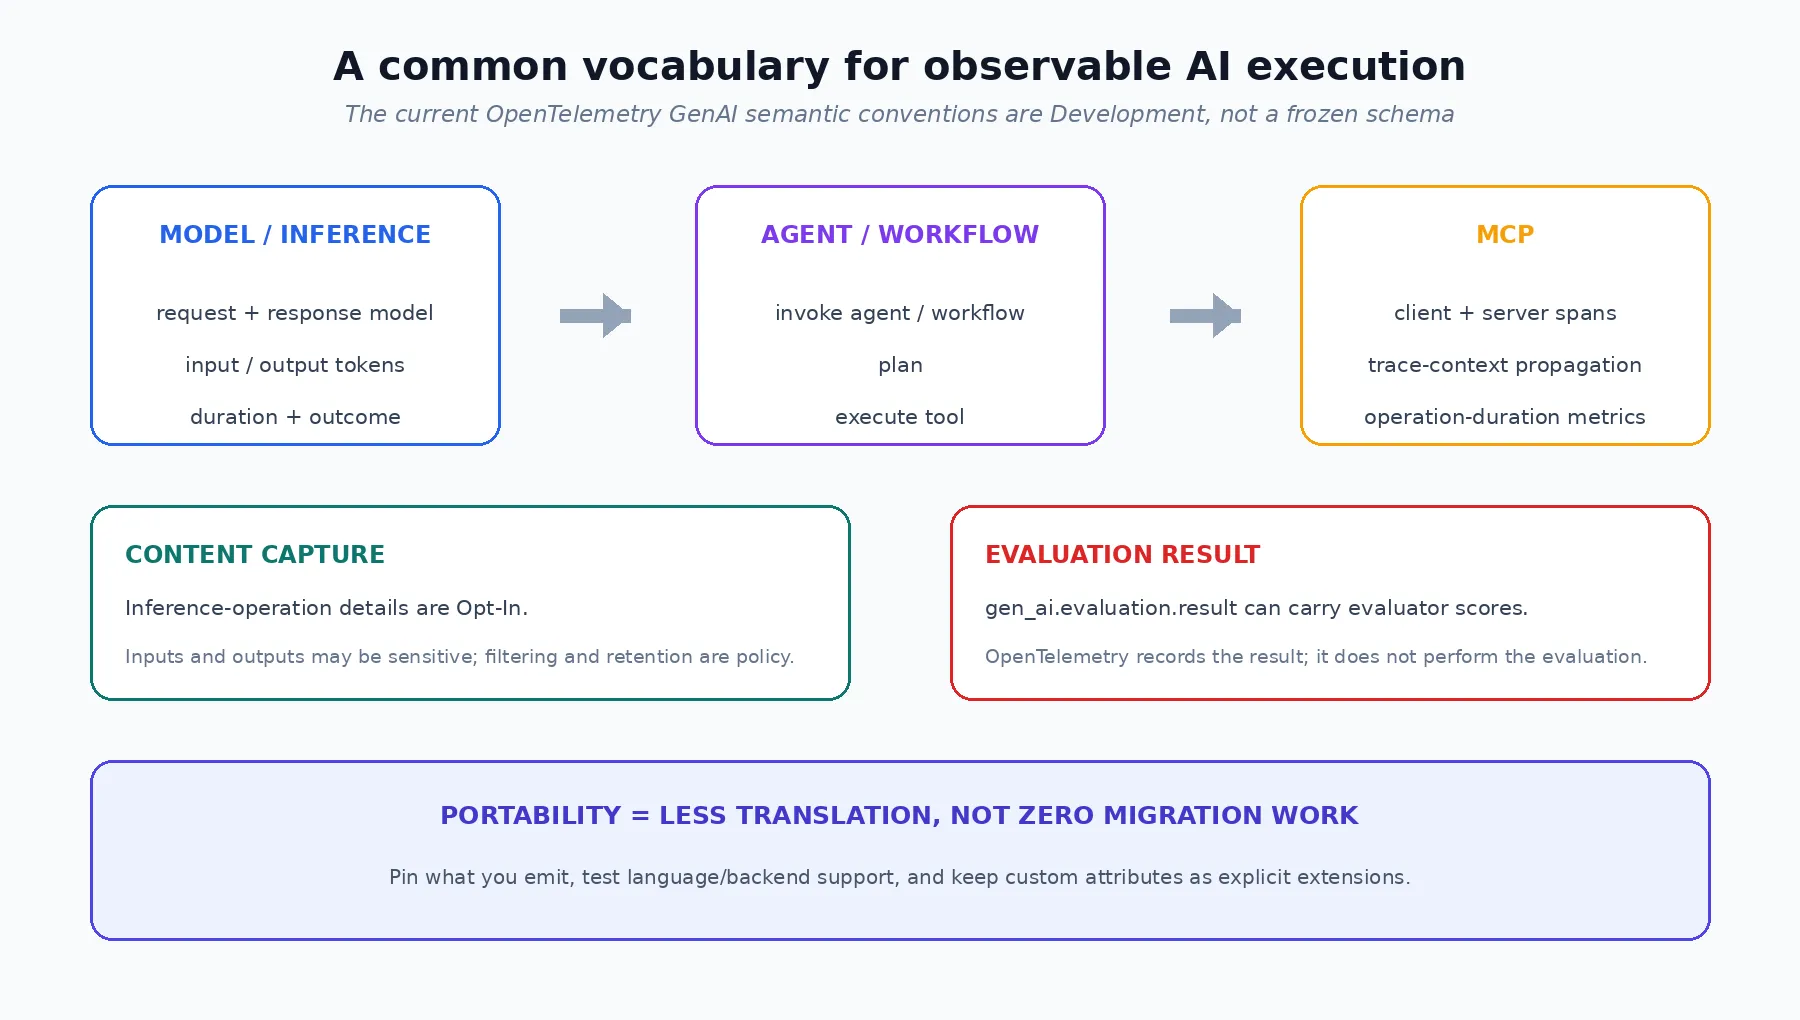
Das aktuelle Ereignis gen_ai.client.inference.operation.details kann Chatverläufe, Parameter, Eingaben und Ausgaben unabhängig vom Haupt-Trace übertragen. Die Anforderungsstufe ist explizit Opt-In, und die OpenTelemetry-Dokumentation weist darauf hin, dass die Unterstützung für Ereignisse noch nicht in jeder Sprache verfügbar ist.
Das ist eine bessere Standardeinstellung, als Prompts und Completions wie gewöhnliche Diagnosetexte zu behandeln. OpenTelemetry definiert die Struktur der Telemetriedaten; es entscheidet nicht über Aufbewahrungsfristen, regionale Speicherung, Zugriffsrichtlinien, Rechtsgrundlagen oder Anforderungen zur Schwärzung. Dies bleibt in der Verantwortung des Betreibers und des Backends.
Legen Sie für eine produktive Bereitstellung die Richtlinie fest, bevor Sie die Inhaltserfassung aktivieren: Welche Umgebungen dürfen vollständige Inhalte erfassen, was wird gefiltert oder gekürzt, wohin dürfen exportierte Telemetriedaten übertragen werden, wie lange werden sie aufbewahrt und wer darf darauf zugreifen?
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet