



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Large Language Models (LLMs) verändern grundlegend, wie Unternehmen Aufgaben automatisieren, Inhalte generieren und mit Daten interagieren. Die meisten LLM-Dienste sind heute jedoch cloud-zentriert, was Fragen bezüglich Datensicherheit, Compliance und Kontrolle aufwirft.
Für Organisationen, die mit sensiblen oder regulierten Informationen arbeiten, ist die Nutzung externer APIs oder öffentlicher Cloud-Modelle oft keine Option. Dies hat zu einem wachsenden Trend hin zu On-Premise-LLM-Deployments geführt, bei denen Unternehmen Modelle sicher in ihrer eigenen Infrastruktur betreiben.
In diesem Artikel untersuchen wir, was On-Premise-LLMs sind, warum sie wichtig sind, wie sie funktionieren und wie Plattformen wie TrueFoundry skalierbare, sichere Deployments in Enterprise-Umgebungen ermöglichen.
On-Premise-LLMs beziehen sich auf Large Language Models, die innerhalb der eigenen Infrastruktur einer Organisation bereitgestellt und betrieben werden, anstatt über externe Cloud-Dienste oder Drittanbieter-APIs. Diese Modelle können Open-Source oder proprietär sein und werden in der Regel auf internen GPU-Servern, in privaten Rechenzentren oder in isolierten Cloud-Umgebungen ausgeführt, die so konfiguriert sind, dass sie den internen Sicherheits- und Compliance-Standards entsprechen.
Im Gegensatz zu Cloud-gehosteten LLMs, die auf öffentliche Endpunkte und vom Anbieter verwaltete Infrastruktur setzen, werden On-Premise-LLMs vollständig von der Organisation kontrolliert. Dies ermöglicht eine stärkere Anpassung, Fine-Tuning und Integration in interne Systeme und Workflows. Unternehmen können wählen, welche Modelle sie verwenden möchten – wie LLaMA 2, Mistral oder Mixtral – und diese basierend auf spezifischen Geschäfts- oder Domain-Anforderungen optimieren.
Ein On-Premise-Deployment ermöglicht es Teams, das Modellverhalten maßzuschneidern, Richtlinien zur Datenresidenz durchzusetzen und sicherzustellen, dass vertrauliche Informationen ihr vertrauenswürdiges Netzwerk niemals verlassen. Es eröffnet auch Möglichkeiten für eine präzisere Performance-Abstimmung und Kostenkontrolle, insbesondere bei Anwendungen mit hohem Volumen oder geringer Latenztoleranz. Für Unternehmen, die Autonomie, Sicherheit und Einhaltung regulatorischer Vorgaben priorisieren, bieten On-Premise-LLMs eine praktische und skalierbare Alternative zu kommerziellen KI-APIs.
Ein On-Premise-LLM-Deployment gibt Ihnen die vollständige Kontrolle über Infrastruktur, Daten und Modellverhalten. Es erfordert jedoch auch sorgfältige Planung, Investitionen und laufendes Management. Nachfolgend sind die wichtigsten Aspekte aufgeführt, die Sie berücksichtigen sollten:
Sie benötigen Hochleistungshardware, um Large Language Models effizient auszuführen. Dazu gehören leistungsstarke GPUs wie NVIDIA A100 oder H100, reichlich RAM, Hochgeschwindigkeitsnetzwerke und schneller SSD-Speicher, um große Modellgewichte und Datensätze zu verarbeiten.
Sie behalten die vollständige Kontrolle über Ihre Daten, was Air-Gapped-Setups, strenge Firewall-Richtlinien und die Einhaltung von Datenschutzbestimmungen wie DSGVO und HIPAA ermöglicht. Dies macht das On-Premise-Deployment ideal für Branchen, die mit sensiblen oder regulierten Informationen umgehen.
Sie müssen ML-Pipelines für Versionierung, Containerisierung, Deployment und Monitoring implementieren. Kontinuierliches Performance-Tracking hilft dabei, die Modellgenauigkeit, Zuverlässigkeit und operative Stabilität im Laufe der Zeit zu gewährleisten.
Obwohl Sie wiederkehrende tokenbasierte API-Gebühren vermeiden, erfordert ein On-Premise-LLM-Deployment erhebliche initiale Kapitalinvestitionen in Hardware. Sie müssen auch laufende Betriebskosten wie Strom, Kühlung, Wartung und qualifiziertes Personal einkalkulieren.
Sie erhalten vollständigen Zugriff auf die Modellgewichte, was ein erweitertes Fine-Tuning mit proprietären Daten ermöglicht. Dies erlaubt eine hochgradig maßgeschneiderte Performance, die an den Workflows Ihrer Organisation ausgerichtet ist – anders als bei generischen Cloud-gehosteten Modellen.
Ihre Skalierbarkeit hängt von der verfügbaren Hardwarekapazität ab. Im Gegensatz zur automatischen Skalierung in der Cloud müssen Sie Spitzenlasten vorausplanen, Load Balancing implementieren und Systeme optimieren, um eine niedrige Latenz und einen hohen Durchsatz aufrechtzuerhalten.
Ihr internes IT- oder DevOps-Team ist für Sicherheitspatches, die Instandhaltung der Infrastruktur und Modell-Updates verantwortlich. Regelmäßige Wartung stellt die Systemzuverlässigkeit, Sicherheit und Kompatibilität mit sich entwickelnden KI-Anforderungen sicher.
Cloud-basierte KI-Dienste haben es Teams leicht gemacht, Machine-Learning-Modelle in großem Maßstab zu testen, Prototypen zu erstellen und einzusetzen. Wenn es jedoch um Produktions-Workflows in Enterprise-Umgebungen geht, bringt die ausschließliche Nutzung cloud-zentrierter LLMs einige Einschränkungen mit sich, die nicht ignoriert werden können.
Datenschutz und Kontrolle sind die gravierendsten Bedenken. Bei der Verwendung öffentlicher Cloud-APIs müssen sensible Eingabedaten über das Internet übertragen und auf externer Infrastruktur verarbeitet werden. Dies birgt Risiken bezüglich Datenlecks, unbefugtem Zugriff und Compliance-Verstößen – insbesondere in Sektoren wie Gesundheitswesen, Finanzen, Verteidigung und Rechtsberatung, in denen strenge regulatorische Standards gelten.
Vendor-Lock-in ist ein weiterer wesentlicher Nachteil. Cloud-AI-Plattformen bündeln Inference-APIs, Speicher und Fine-Tuning oft in proprietären Ökosystemen. Sobald ein Workflow um einen bestimmten Anbieter herum aufgebaut ist, wird die Migration zu einem anderen Dienst oder die Verlagerung von Workflows ins eigene Haus zeitaufwendig und kostspielig. Diese Abhängigkeit schränkt die langfristige Flexibilität und Kontrolle über Modell-Updates oder Nutzungsbedingungen ein.
Unvorhersehbare Kostenskalierung wird ebenfalls zu einer Herausforderung, wenn die Nutzung zunimmt. LLMs sind rechenintensiv, und Cloud-Preisgestaltungsmodelle, die auf Token-Anzahlen oder Anfragevolumen basieren, können zu ausufernden Betriebskosten führen – insbesondere bei Anwendungen mit hohem Durchsatz oder ständiger Interaktion.
Zusätzlich bieten Cloud-Umgebungen nur begrenzte Optionen für Deployments mit niedriger Latenz und Edge-Deployments. Anwendungen, die nahezu verzögerungsfreie Antworten oder Offline-Funktionalität erfordern, können Schwierigkeiten haben, die Performance-Ziele zu erreichen, wenn sie von externen APIs abhängig sind.
Schließlich abstrahieren Cloud-Anbieter einen Großteil der Infrastruktur, sodass Teams nur minimale Einblicke in Performance-Engpässe, Optimierungspotenziale oder Tuning-Parameter erhalten.
Für Unternehmen, die Kontrolle, Transparenz und langfristige Nachhaltigkeit fordern, sprechen diese Einschränkungen deutlich für die Einführung von On-Premise-LLM-Lösungen.
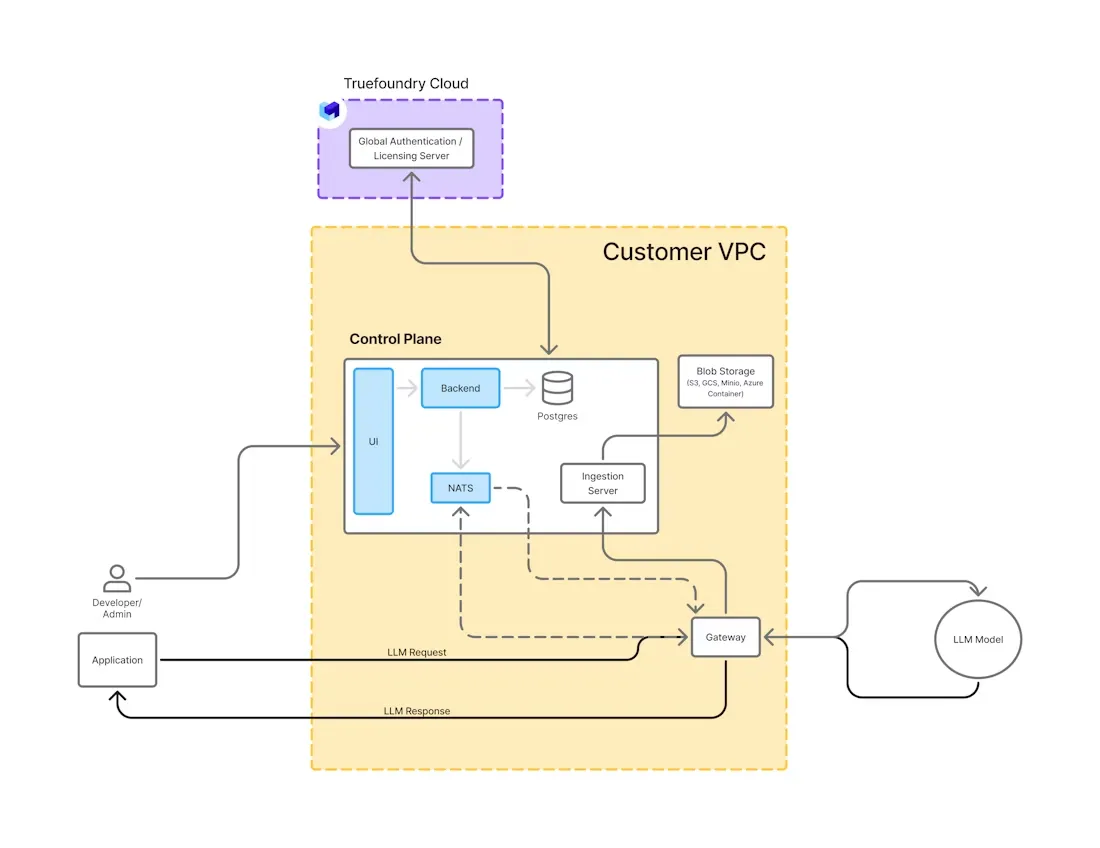
Das Deployment von LLMs On-Premise erfordert eine sorgfältig strukturierte Architektur, die Performance, Sicherheit und Wartbarkeit ausbalanciert. Nachfolgend sind die Kernkomponenten aufgeführt, die typischerweise in einem produktionsreifen Setup zu finden sind.
Compute-Infrastruktur: Hochleistungs-GPUs bilden das Fundament von On-Premise-LLMs. Unternehmen setzen je nach Modellgröße und Durchsatzanforderungen häufig NVIDIA A100, H100 oder L40 GPUs ein. Diese werden in lokalen Rechenzentren oder privaten Cloud-Clustern mit entsprechender Kühlung, Vernetzung und Speicher gehostet.
Inference Engine: Inference-Frameworks wie vLLM, TGI oder DeepSpeed-Inference übernehmen die eigentliche Modellausführung. Sie optimieren die Speicher-Nutzung, unterstützen Token-Streaming und ermöglichen das Batching mehrerer Anfragen zur Maximierung des Durchsatzes.
Modellmanagement und Speicherung: Modelle werden lokal in sicheren Artefakt-Repositories oder Volume-Mounts gespeichert. Mechanismen für Versionierung, Rollback und Zugriffskontrolle sind essenziell, um Modell-Lebenszyklen zu verwalten und Änderungen zu auditieren.
Containerisierung und Orchestrierung: Tools wie Docker und Kubernetes werden eingesetzt, um LLM-Workloads bereitzustellen, zu skalieren und zu verwalten. Kubernetes übernimmt Autoscaling, GPU-Scheduling, Load Balancing und Wiederherstellung im Fehlerfall und sorgt so für eine konsistente Performance über alle Dienste hinweg.
API-Layer und Routing: Eine REST- oder OpenAI-kompatible API-Schicht stellt die LLM-Funktionalität internen Anwendungen zur Verfügung. Sie kann Multi-Modell-Routing, Benutzerauthentifizierung und Prompt-Filterung für Sicherheit und Kontrolle beinhalten.
Observability und Monitoring: Metriken wie Latenz, GPU-Auslastung, Anfragedurchsatz und Token-Generierungsgeschwindigkeit werden mit Tools wie Prometheus, Grafana und OpenTelemetry verfolgt. Logging und Alerting sind entscheidend für die Aufrechterhaltung der Betriebszeit und das Debugging von Problemen.
Diese modulare Architektur ermöglicht es Unternehmen, skalierbare und sichere LLM-Systeme zu bauen, die auf ihre internen Richtlinien, Performance-Ziele und Compliance-Anforderungen zugeschnitten sind.
On-Premise-LLMs gewinnen in Branchen zunehmend an Bedeutung, die Datensouveränität, geringe Latenzzeiten und vollständige Kontrolle über KI-Pipelines erfordern. Hier sind einige verbreitete und wirkungsvolle Anwendungsfälle.
Krankenhäuser und Forschungslaboratorien nutzen LLMs, um Patientennotizen zusammenzufassen, Entlassungsberichte zu erstellen und bei der klinischen Dokumentation zu unterstützen. On-Premise-Deployments stellen sicher, dass Patienten-Gesundheitsdaten innerhalb der sicheren Infrastruktur des Krankenhauses verbleiben, was die HIPAA-Compliance und die institutionellen Datenrichtlinien unterstützt.
Finanzinstitute setzen LLMs für Aufgaben wie die Zusammenfassung von Ergebnisberichten, die Automatisierung von Compliance-Berichten und die Analyse von Finanzstatements ein. On-Premise-Setups verhindern, dass sensible Finanzdaten externen APIs ausgesetzt werden, während gleichzeitig die Einhaltung interner Risikorahmenwerke und regulatorischer Audits gewahrt bleibt.
Behörden nutzen LLMs zur Beantwortung von Fragen, zur Zusammenfassung als verschlusssache eingestufter Berichte und zur internen Wissensbeschaffung. Da nationale Sicherheitsdaten strikt geschützt bleiben müssen, ermöglichen On-Premise-LLMs generative KI-Anwendungen, ohne gegen Datenklassifizierungsprotokolle zu verstoßen.
Anwaltskanzleien und Rechtsabteilungen nutzen LLMs zur Analyse von Verträgen, Erstellung von Zusammenfassungen und Unterstützung bei der Rechtsrecherche. Ein On-Premise-Deployment stellt sicher, dass dem Anwaltsgeheimnis unterliegende Informationen interne Server niemals verlassen, wodurch die Vertraulichkeit gewahrt und die Anforderungen der Anwaltskammern erfüllt werden.
Unternehmen im Fertigungssektor setzen LLMs ein, um Leitfäden zur Fehlerbehebung zu generieren, Sensor-Logs zu interpretieren und Servicetechniker vor Ort zu unterstützen. Das Bereitstellen von LLMs auf lokalen Servern hilft zu vermeiden, proprietäre Maschinendaten an externe Dienste zu senden, und reduziert die Latenz für abgelegene oder offline betriebene Umgebungen.
Telekommunikationsunternehmen nutzen LLMs zum Betreiben von Chatbots, zur Priorisierung von Tickets und zur Bereitstellung automatisierter Service-Empfehlungen. Ein On-Premise-Deployment ermöglicht Echtzeit-Performance und hält Kundendaten innerhalb der internen Infrastruktur zur Einhaltung regionaler Datenschutzgesetze.
Diese Anwendungsfälle verdeutlichen, wie On-Premise-LLMs leistungsstarke Automatisierung und Intelligenz freischalten, ohne Kompromisse bei Sicherheit, Compliance oder Kontrolle einzugehen.
Das Deployment von LLMs On-Premise umfasst eine Reihe koordinierter Schritte, von der Modellauswahl bis zum Produktions-Monitoring. Ein wohldefinierter Workflow stellt sicher, dass das System skalierbar, sicher und für die Anforderungen Ihrer Organisation optimiert ist.
Der Prozess beginnt mit der Auswahl eines geeigneten Modells basierend auf Ihrem Anwendungsfall. Beliebte Open-Source-Modelle wie LLaMA 2, Mistral oder Mixtral werden für On-Premise-Deployments oft bevorzugt. Nach der Auswahl wird das Modell heruntergeladen, bei Bedarf quantisiert und auf Kompatibilität mit Ihrer Infrastruktur validiert.
Als Nächstes werden GPU-Server oder private Cloud-Ressourcen vorbereitet. Dies umfasst das Einrichten von Container-Runtimes (z. B. Docker), Orchestrierern (z. B. Kubernetes) und Speicherschichten zum Hosten von Modellgewichten und Logs. Zugriffskontrollen und Sicherheitsrichtlinien werden konfiguriert, um die Compliance-Anforderungen zu erfüllen.
Das Modell wird in eine Inference Engine wie vLLM oder TGI geladen. Diese Engines bieten die Laufzeitumgebung für Textgenerierung in Echtzeit, Batching, Streaming und Speicheroptimierung. Konfigurationsdateien definieren Batch-Größe, maximale Token-Anzahl und Nebenläufigkeitsgrenzen.
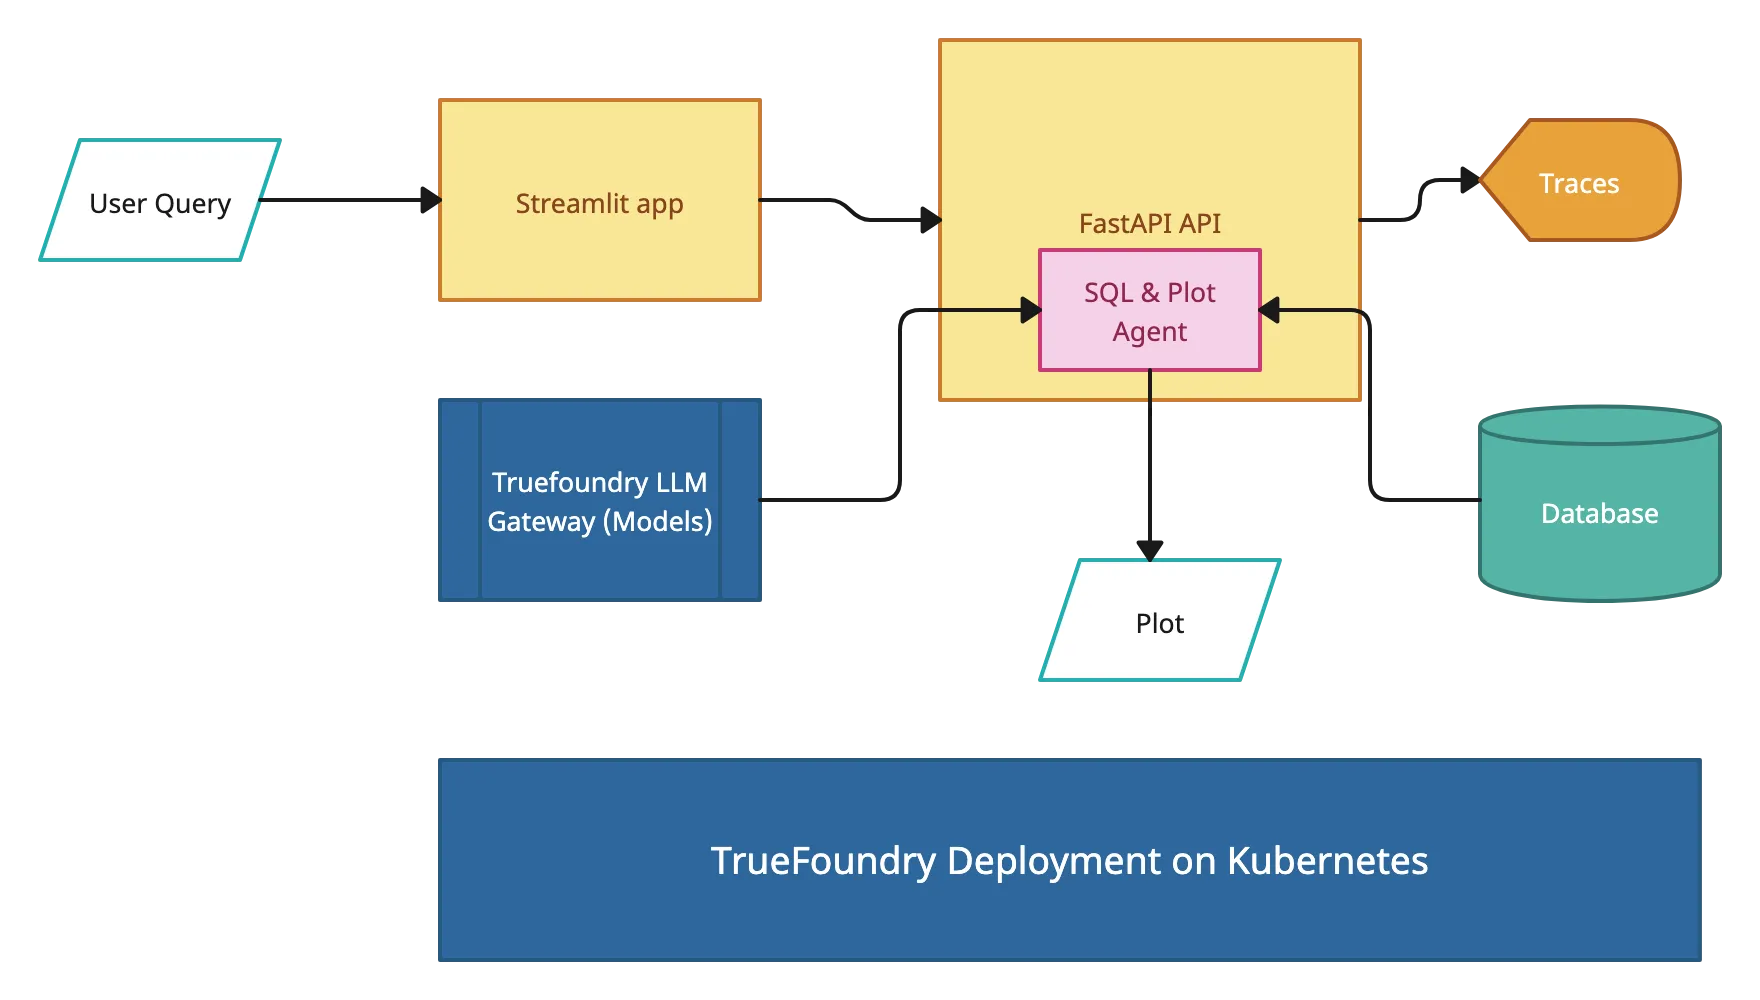
Sobald die Engine betriebsbereit ist, wird sie über eine REST- oder OpenAI-kompatible API bereitgestellt. Dies ermöglicht es internen Apps, Tools oder Benutzeroberflächen, das Modell abzufragen. Multi-Modell-Routing, Authentifizierung und Rate Limiting können auf dieser Schicht für eine bessere Kontrolle hinzugefügt werden.
Observability-Tools werden angebunden, um GPU-Nutzung, Latenz, Token-Durchsatz und Anfragefehler zu verfolgen. Basierend auf Traffic-Mustern werden Autoscaling-Richtlinien oder manuelle Skalierungsverfahren konfiguriert, um die Nachfrage ohne Ausfallzeiten zu bewältigen.
Befolgen Sie diesen Workflow, um LLMs effizient innerhalb Ihrer Infrastruktur zu starten und zu verwalten, ohne sich auf externe Plattformen zu verlassen oder sensible Daten preiszugeben.
Diese Tools und Techniken helfen Ihnen beim Deployment von On-Premise-LLMs mit hoher Performance, Sicherheit und vollständiger Datenkontrolle bei gleichzeitiger Aufrechterhaltung von Zuverlässigkeit auf Enterprise-Niveau.
Das Deployment von LLMs On-Premise gibt Organisationen die vollständige Kontrolle über ihre KI-Infrastruktur, bringt aber auch Kompromisse mit sich. Das Verständnis sowohl der Vorteile als auch der Herausforderungen ist für eine erfolgreiche Einführung essenziell.
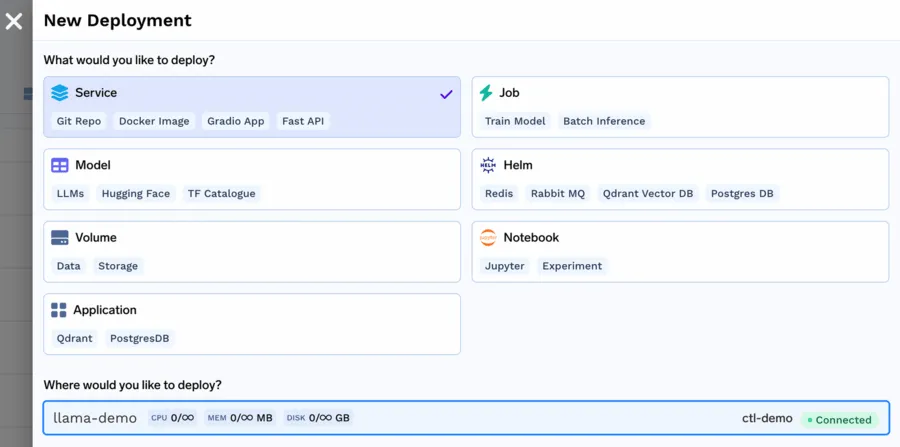
TrueFoundry vereinfacht die Bereitstellung und Verwaltung großer Sprachmodelle innerhalb einer privaten Infrastruktur und macht On-Premise GenAI für Unternehmen zugänglich, ohne dass tiefe DevOps- oder MLOps-Expertise erforderlich ist. Aufgebaut auf Kubernetes ermöglicht TrueFoundry schnelles, sicheres und skalierbares LLM-Serving durch vorintegrierte Unterstützung für hochperformante Inference Engines wie vLLM und TGI.
Die Plattform abstrahiert die Komplexität der Verwaltung von Containern, GPUs und Skalierungsrichtlinien, sodass sich Teams auf die Erstellung von Anwendungen konzentrieren können, anstatt die Infrastruktur zu warten. Mit TrueFoundry’s AI Gateway können Organisationen LLMs über OpenAI-kompatible APIs bereitstellen und gleichzeitig Rate Limiting, tokenbasierte Abrechnung und Multi-Modell-Routing anwenden – alles innerhalb ihrer sicheren Umgebung.
TrueFoundry bietet außerdem integrierte Observability, einschließlich Echtzeit-Überwachung von Token-Nutzung, Latenz und Modellperformance. Dies hilft Teams, den Durchsatz zu optimieren, Probleme zu beheben und Governance durchzusetzen.
Egal ob LLaMA 2, Mistral oder feingetunte interne Modelle bereitgestellt werden: TrueFoundry bietet Unternehmen eine produktionsreife Lösung für On-Premise GenAI – vollständig anpassbar, compliant und auf Skalierbarkeit ausgelegt.
Da Unternehmen zunehmend Large Language Models einführen, bietet das On-Premise-Deployment einen sicheren und flexiblen Weg, GenAI zu nutzen, ohne Kompromisse bei Datenschutz, Compliance oder Infrastrukturkontrolle einzugehen. Während Cloud-basierte Lösungen Komfort bieten, greifen sie in regulierten oder sensiblen Umgebungen oft zu kurz. On-Premise-LLMs geben Organisationen die vollständige Kontrolle über den Stack, eine größere Anpassungsfähigkeit und vorhersehbare Kosten, was sie ideal für langfristige KI-Strategien macht. Mit Plattformen wie TrueFoundry wird das interne Bereitstellen und Skalieren von LLMs schneller, effizienter und einfacher zu verwalten. Für Organisationen, die auf Kontrolle, Transparenz und Innovation setzen, ist On-Premise GenAI nicht nur eine Alternative, sondern ein strategischer Vorteil.
Sie deployen LLMs On-Premise, indem Sie Modelle mit Docker containerisieren, sie über Kubernetes orchestrieren und sie über optimierte Inference Engines wie vLLM oder TGI bereitstellen. Sie konfigurieren GPUs, Netzwerk und Speicher, integrieren Monitoring-Tools und implementieren MLOps-Pipelines, um Versionierung, Skalierung, Sicherheit und Performance innerhalb Ihrer privaten Infrastruktur zu verwalten.
Ein Cloud-Deployment bietet Skalierbarkeit auf Abruf, verwaltete Infrastruktur und Pay-as-you-go-Preise, während ein On-Premise-Deployment vollständige Datenkontrolle, Anpassbarkeit und Compliance bietet. Sie tauschen Cloud-Flexibilität gegen höhere Sicherheit und Souveränität On-Premise ein, müssen jedoch Hardwarekosten, Wartung, Skalierungsgrenzen und betriebliche Komplexität intern handhaben.
Sie können öffentliche Cloud-LLM-Dienste, private Cloud-Umgebungen, hybride Deployments oder verwaltete KI-Plattformen nutzen. API-basierte Modelle wie OpenAI oder gehostete Hugging Face-Endpunkte reduzieren den Infrastrukturaufwand. Hybride Setups ermöglichen es Ihnen, sensible Daten On-Premise zu halten, während Sie die Skalierbarkeit der Cloud für Spitzenlasten und Experimente nutzen.
On-Premise-LLMs erfordern hohe initiale Hardwarekosten, laufende Wartung, qualifiziertes Personal und Kapazitätsplanung. Sie sehen sich mit Skalierungsbeschränkungen, Strom- und Kühlungskosten sowie langsameren Upgrades konfrontiert. Das Verwalten von Sicherheitspatches, Modell-Updates und Systemzuverlässigkeit erhöht die betriebliche Komplexität im Vergleich zu vollständig verwalteten Cloud-basierten KI-Diensten.
TrueFoundry vereinfacht die On-Premise-LLM-Bereitstellung durch die Integration von Kubernetes-Orchestrierung, GPU-Scheduling, Model Serving, Monitoring und Sicherheitskontrollen. Sie profitieren von zentralem Management, RBAC, Observability und nahtloser Skalierung über verschiedene Umgebungen hinweg. Die vorintegrierten Inference Engines und compliance-bereiten Funktionen helfen Ihnen, produktionsreife AI sicher und effizient bereitzustellen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















