



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Unternehmen vergleichen Obot AI und LiteLLM, wenn ihr KI-Stack über direkte Modellaufrufe hinauswächst. LiteLLM ist meist die vertraute Wahl für Multi-Modell-Routing, virtuelle Schlüssel, Ausgabenverfolgung, Budgets und OpenAI-kompatiblen Zugriff. Obot AI kommt ins Spiel, wenn MCP-Server-Management, Sichtbarkeit von KI-Clients, Identitätsmanagement und Tool-Governance an Bedeutung gewinnen.
Die eigentliche Frage ist nicht, ob ein Tool das andere in jedem Fall ersetzt. LiteLLM setzt auf der Ebene des LLM-Proxys an. Obot AI beginnt näher an der MCP-Governance und dem Management des Enterprise-KI-Ökosystems. Ein Team, das LiteLLM bereits problemlos einsetzt, hat keinen Grund für einen Wechsel. Ein Team, das in unverwalteten MCP-Servern auf Entwickler-Laptops versinkt, hat keinen Grund, beim bisherigen Ansatz zu bleiben.
TrueFoundry wird relevant, wenn Teams Modell-Routing, MCP-Tools, Agenten-Workflows, Budgets, Guardrails und Audit-Logs zentral steuern müssen – meist der Punkt, an dem zwei Open-Source-Gateways wie zwei separate Compliance-Projekte wirken.
Ein nützlicher Vergleich zwischen LiteLLM und Obot AI beginnt mit der Migrationsabsicht. Manche Teams möchten einen Proxy-Server ersetzen. Andere möchten MCP-Governance für Agenten, Coding-Tools und interne KI-Clients hinzufügen. Dies sind unterschiedliche Beweggründe für eine Anschaffung.
Der Kernunterschied liegt darin, wo der Fokus des jeweiligen Projekts beginnt. Die Konfiguration von LiteLLM beschreibt primär Modelle und die Regeln, um diese zu erreichen. Der Katalog von Obot beginnt bei MCP-Servern und Richtlinien, die festlegen, wer darauf zugreifen darf. Beide Projekte haben sich inzwischen in das Gebiet des jeweils anderen ausgeweitet.
LiteLLM bietet mittlerweile eine einheitliche API für über 140 Integrationen sowie Funktionen für Budgets, Routing, Guardrails und Nutzungsverfolgung. Sein LLM-Gateway-Architektur -Anwendungsfall bleibt ein natürlicher Ausgangspunkt, um modellbasiertes Routing mit einem allgemeinen Proxy-Ansatz zu vergleichen. LiteLLM positioniert sein Produkt mittlerweile selbst als KI-Gateway, das LLM-, MCP- und Agenten-Traffic abdeckt.
Beide Gateways bieten einen kostenlosen Open-Source-Einstieg, daher liefert der reine Softwarepreis keinen vollständigen Vergleich. Die Betriebskosten umfassen auch Infrastruktur, Observability, Identitätsmanagement, Upgrades und den Gateway-Betrieb.
Die OSS-Stufe von LiteLLM deckt über 140 Anbieter, Benutzer, Teams, Budgets, Ratenbegrenzungen, Fallbacks, Anforderungsprotokollierung und Prometheus-Metriken ab. Die Enterprise-Preise skalieren nach jährlicher Gateway-Anfragekapazität, Bereitstellungsarchitektur und Support-Anforderungen. Enterprise umfasst SSO, SCIM, OIDC- oder JWT-Authentifizierung, Audit-Logs, Secret-Manager, Multi-Region-Support und Service-SLAs.
Das macht LiteLLM einfacher zu bewerten, wenn Teams ihr erwartetes Anfragevolumen bereits kennen. Die LiteLLM-Preisanalyse von TrueFoundry bietet zusätzlichen Kontext zu Infrastruktur und Enterprise-TCO.
Obot bietet ebenfalls einen kostenlosen Pfad. Das aktuelle Editionsmodell unterstützt standardmäßig bis zu 100 Benutzer und Geräte. Die Community-Version behält diese Limits bei und fügt Identitätsoptionen wie Microsoft Entra, Okta, JumpCloud und Auth0 hinzu. Die Enterprise-Version hebt diese Limits auf und bietet formellen Support.
Der Vergleich sollte daher Hosting, Datenbanken, Observability-Speicher, Schlüsselverwaltung, Compliance-Anforderungen und den technischen Aufwand einbeziehen. LiteLLM benötigt PostgreSQL für Funktionen wie virtuelle Schlüssel. Obot benötigt Infrastruktur für das Gateway und gehostete MCP-Workloads.
Nicht ganz. Obot unterstützt zwar eine sinnvolle Modellverwaltung, aber LiteLLM konzentriert sich weiterhin stärker auf das anbieterübergreifende Routing.
LiteLLM bietet eine einheitliche Schnittstelle für viele LLM-Anbieter. Anwendungen nutzen eine Gateway-Basis-URL, einen Schlüssel und einen konfigurierten Modellnamen. Das Routing kann den Datenverkehr auf Anbieter, Regionen und Anmeldedaten verteilen und dabei Fallback-Optionen sowie Kostenkontrollen anwenden.
Das LLM-Gateway von Obot verfolgt einen anderen Ansatz. Es stellt anbieterkompatible Endpunkte für OpenAI- und Anthropic-Modelle, generische Antwort-Endpunkte sowie AWS Bedrock und Azure bereit. Ein Obot-API-Schlüssel mit LLM-Proxy-Berechtigung ersetzt dabei die direkten Anmeldedaten der Anbieter.
Administratoren legen anschließend Modellzugriffsrichtlinien fest, um zu steuern, welche Modelle jeder Endbenutzer sehen und aufrufen darf. Die zurückgegebene Modellliste enthält nur die genehmigten Optionen. Das Gateway verwaltet die Upstream-Anmeldedaten zentral innerhalb von Obot, anstatt sie auf verschiedene Anwendungen zu verteilen.
Obot kann Google Vertex auch als Anbieter an anderer Stelle in der Plattform konfigurieren. Die aktuellen externen, anbieterspezifischen Gateway-Routen unterstützen Google Vertex jedoch nicht.
LiteLLM ist der bessere Ausgangspunkt, wenn anbieterübergreifendes Fallback und Request-Routing im Vordergrund stehen. Obot ist die stärkere Wahl, wenn es primär um Unternehmens-Governance in Bezug auf Benutzer, Agenten, Modelle und MCP-Systeme geht.
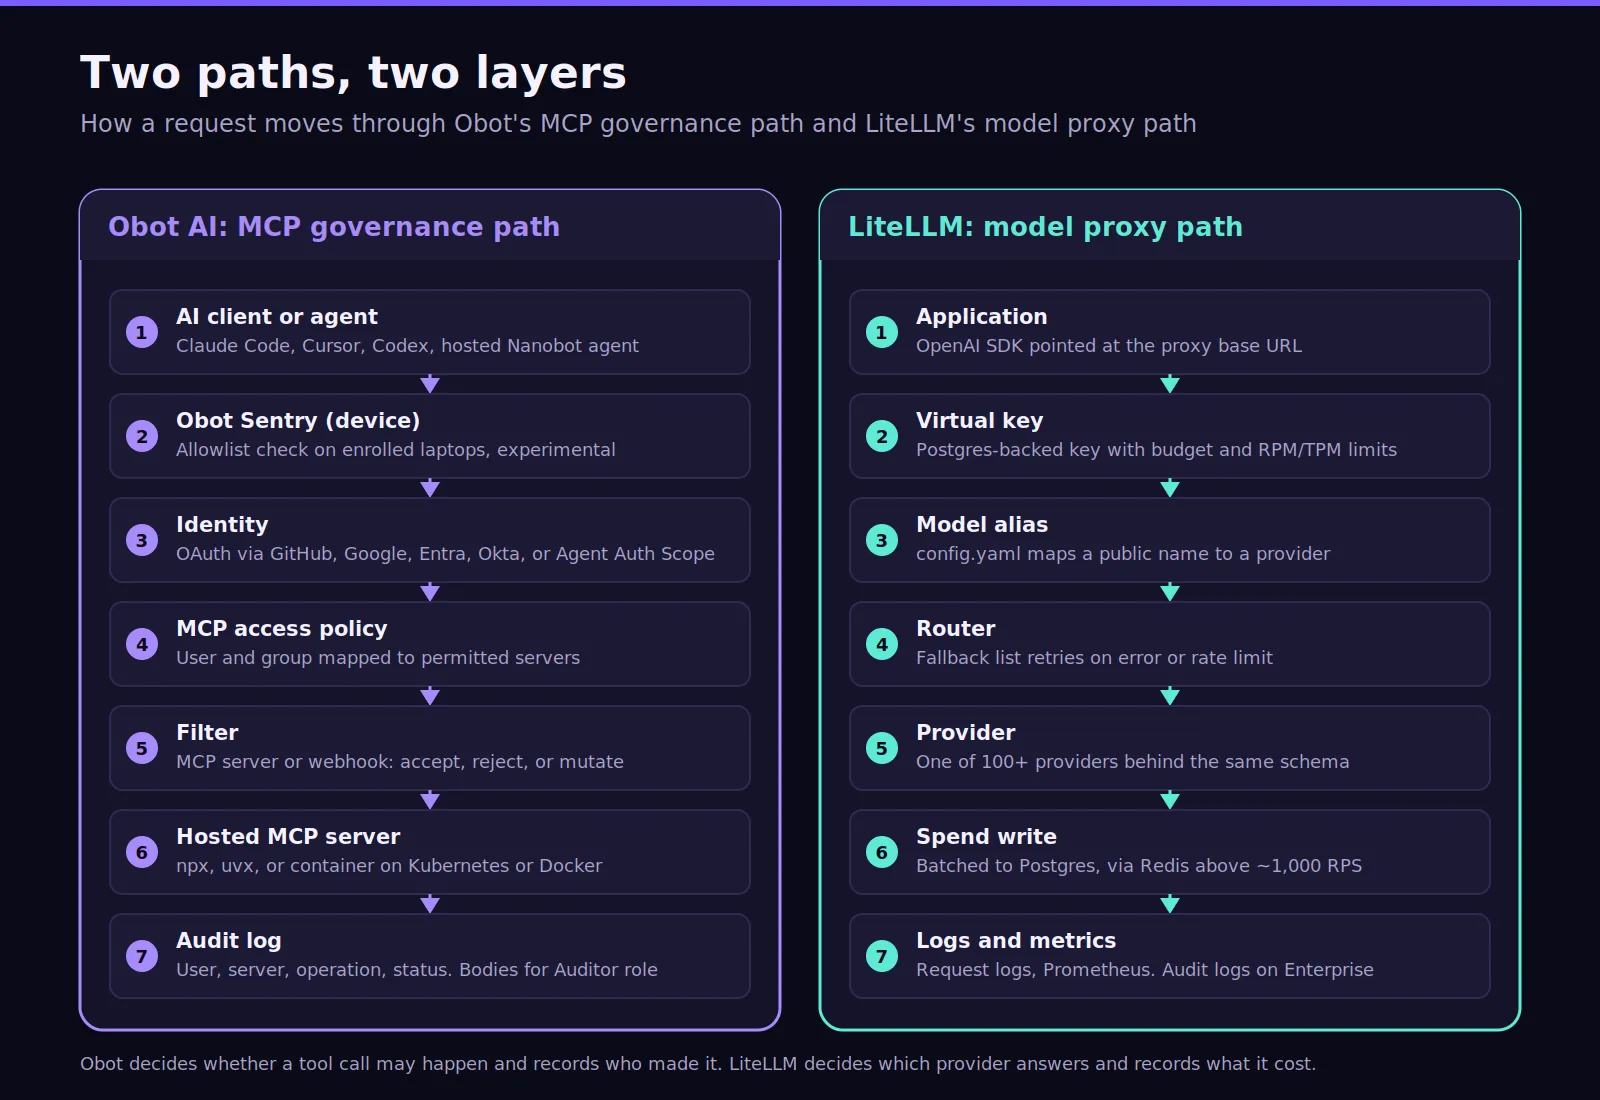
LiteLLM ist am stärksten, wenn Anwendungen primär LLM-Datenverkehr erzeugen. Die Entscheidung ändert sich, sobald ein KI-Agent beginnt, Tools aufzurufen, sensible Daten abzurufen oder systemübergreifend im Unternehmen zu agieren. Dann wird das Modell-Routing zu einer von mehreren Kontrollebenen.
LiteLLM verdient hier Anerkennung, da seine aktuellen Funktionen umfangreicher sind, als ältere Vergleiche vermuten lassen. Die MCP-Ebene bietet einen festen Endpunkt für registrierte Server. Clients authentifizieren sich über dasselbe Gateway-Anmeldemodell, während der Zugriff pro Schlüssel oder Team zugewiesen werden kann.
Das LiteLLM-Gateway trennt zudem die Client-Authentifizierung von den Upstream-OAuth-Abläufen. Dadurch bleiben die Gateway-Anmeldedaten von den serverseitigen OAuth-Anmeldedaten getrennt. Coding-Tools wie Claude Code können sowohl eine Verbindung zum LiteLLM-Modell-Routing als auch zu MCP-Endpunkten herstellen.
Obot geht bei MCP-Vorgängen noch einen Schritt weiter. Sein MCP-Gateway -Vergleichspunkt liegt in der Tiefe von Hosting und Richtlinien. Obot kann npx-, uvx-, containerisierte und Remote-MCP-Workloads ausführen und dabei Authentifizierung und Autorisierung durchsetzen.
Die Zugriffsrichtlinien von Obot ordnen genehmigte Server bestimmten Benutzern oder Identitätsanbieter-Gruppen zu. Filter können einzelne Tool-Aufrufe prüfen und Anfragen anschließend akzeptieren, ablehnen oder ändern. Benutzerdefinierte Filter können bei Bedarf Kontrollen wie die Maskierung personenbezogener Daten (PII) unterstützen.
Obot Sentry erweitert die Governance zudem auf lokale KI-Tools. Das Gerätemanagement kann Aktivitäten von Claude Code, Codex, Cursor und VS Code erfassen. Dies ermöglicht eine tiefere Integration, wenn lokale Entwickleraktivitäten zusammen mit Gateway-Ereignissen sichtbar sein müssen.
Observability ist ein weiterer praktischer Unterscheidungspunkt zwischen LiteLLM und Obot AI. Jede Plattform überwacht die Ebene, die sie primär steuert.
LiteLLM verfolgt Ausgaben, Budgets, Nutzung pro Schlüssel oder Team, Anfrageverhalten, Anbieterergebnisse und Gateway-Aktivitäten. Es kann den Token-Verbrauch verschiedenen Schlüsseln, Benutzern, Teams, Organisationen, Tools, Agenten und MCP-Workloads zuordnen.
Obot konzentriert sich stärker auf MCP-Anfragen, lokale Client-Aktivitäten, Modellaufrufe, Geräte und Plattform-Governance. Das Auditsystem korreliert Aktivitäten über MCP-Server, Modellanbieter, gehostete Workloads und Benutzergeräte hinweg. Administratoren können Aktivitäten nach Benutzer, Server, Tool, Anbieter, Modell, Client, Gerät oder Sitzung filtern.
Für Plattform-Teams ist dieser Unterschied wichtig. Modell-Observability beantwortet, welches Modell aufgerufen wurde und was es gekostet hat. MCP-Observability beantwortet, welche Identität auf welches Tool zugegriffen hat und was danach geschah.
TrueFoundrys Gateway-Observability-Analyse erläutert, wie Modelllatenz, Fehler, Ausgaben, Richtlinien und Traces auf Gateway-Ebene korreliert werden können.
Die Migration eines Proxys ist selten der schwierigste Teil. Die eigentliche Herausforderung besteht darin, Annahmen zu migrieren, die bereits tief im Anwendungscode verankert sind. Vor dem Wechsel sollten Teams folgende Punkte prüfen:
Drei Punkte erfordern besondere Aufmerksamkeit. LiteLLM-Anwendungen verwenden möglicherweise öffentliche Aliase, während Obot für unterstützte Gateway-Routen die anbieterspezifischen Namen erwartet. Das bedeutet, dass Modellkennungen bei produktiven Anwendungen zu Migrationsaufwand führen können.
LiteLLM beinhaltet zudem Fallback-Verhalten, das sich nicht direkt auf das Modellzugriffsmodell von Obot übertragen lässt. Umgebungsvariablen, die Anbietereinstellungen und Anmeldedaten enthalten, müssen möglicherweise aktualisiert werden, wenn sich die Zuständigkeiten zwischen den Gateways verschieben.
Auch die Schlüsselmodelle unterscheiden sich. LiteLLM verwendet Gateway-Anmeldedaten, die Budgets und Zugriffsberechtigungen enthalten. Obot kann über die Obot-API bereichsspezifische Anmeldedaten ausstellen, während ein Obot-Token unterstützte Client-Workflows authentifizieren kann. Diese Berechtigungsmodelle lassen sich nicht eins zu eins abbilden.
Teams behalten daher möglicherweise LiteLLM für Modelle bei, während sie Obot für MCP hinzufügen. Eine weitere Option ergibt sich, wenn agentenbasierte Workflows Richtlinien über beide Ebenen hinweg erfordern. TrueFoundrys Agent Gateway bietet Workflow-Kontingente, Traces und eine zentralisierte Identitätsverwaltung für autonome Agenten.
TrueFoundry dient als Konsolidierungsebene für Unternehmen. Das Enterprise-KI-Gateway bietet Routing, Observability, Guardrails, Budgetverwaltung, Richtliniendurchsetzung und Modell-Governance. Es kann sowohl über SaaS als auch über kundenseitig kontrollierte Bereitstellungsmodelle betrieben werden.
Die Plattform unterstützt Provider-Routing, Fallback, Ratenbegrenzung und Kostentransparenz für über 1.600 Modelle. Richtlinien können zudem als YAML-Dateien hinterlegt werden, sodass Teams die Governance über eine Versionsverwaltung prüfen können, anstatt Kontrollen unabhängig innerhalb der Anwendungen zu pflegen.
Budgetrichtlinien können die Nutzung auf Benutzer, Teams, Anwendungen, Modelle oder Umgebungen begrenzen. Dies ermöglicht eine Durchsetzung in Echtzeit, bevor kostspielige LLM-Aufrufe fortgesetzt werden.
name: budget-limiting-configtype: gateway-budget-configrules: - id: 'coding-agents-daily' when: subjects: ['team:platform'] metadata: environment: 'production' limit_to: 200 unit: cost_per_day budget_applies_per: ['user'] alerts: thresholds: [75, 90, 100] notification_target: - type: slack-bot notification_channel: 'budget-alerts-channel' channels: ['#ai-spend']Bei Überschreitung von 200 $ pro Tag antwortet das Gateway mit einem 429-Fehlercode, der `error_origin_level: rate_limit_budget` enthält, wobei die ID der verletzten Regel im Header `x-tfy-applied-rules` angegeben wird. Der Audit-Modus verfolgt dieselbe Regel, ohne sie zu blockieren – dies ist der sichere Weg, um ein Limit für ein Team einzuführen, das bisher keines hatte.
Das MCP-Gateway steuert den Tool-Zugriff über eine zentrale Registrierung, serverbasiertes RBAC, OAuth 2.0-Token-Management mit automatischer Aktualisierung sowie virtuelle MCP-Server. Letztere stellen eine kuratierte Teilmenge von Tools aus mehreren Servern als einzigen Endpunkt bereit, ohne dass eine neue Bereitstellung erforderlich ist. Guardrails werden in derselben Richtliniendatei, die auch LLM-Aufrufe steuert, an MCP-Tool-Aufrufe angehängt:
name: guardrails-controltype: gateway-guardrails-configrules: - id: github-tools-pii when: target: operator: or conditions: mcpServers: values: - github-mcp condition: in subjects: operator: and conditions: in: - team:platform llm_input_guardrails: [] llm_output_guardrails: [] mcp_tool_pre_invoke_guardrails: - pii/pii-detection mcp_tool_post_invoke_guardrails: []Die MCP-Ebene verbindet Modell-Governance mit Tool-Zugriff, anstatt Tools als bloßes Anwendungsthema zu behandeln. Föderierte Identitäten, RBAC, OAuth 2.0, Observability und Server-Registrierung unterstützen MCP-Workloads auf Unternehmensebene.
TrueFoundry ist daher eine Plattform-Option für Unternehmen, bei denen separate Proxy- und MCP-Produkte zu doppelten Richtlinien führen würden. Teams können diese Architektur auch direkt vergleichen über den TrueFoundry vs. LiteLLM Vergleich.
Wählen Sie TrueFoundry, wenn:
TrueFoundry bietet derzeit den Developer-Tarif für 0 $ monatlich, Pro für 499 $ monatlich, Pro Plus für 2.999 $ monatlich sowie individuelle Enterprise-Preise an. Enterprise unterstützt VPC- sowie Air-Gapped-Bereitstellungen für Gateway und Control-Plane
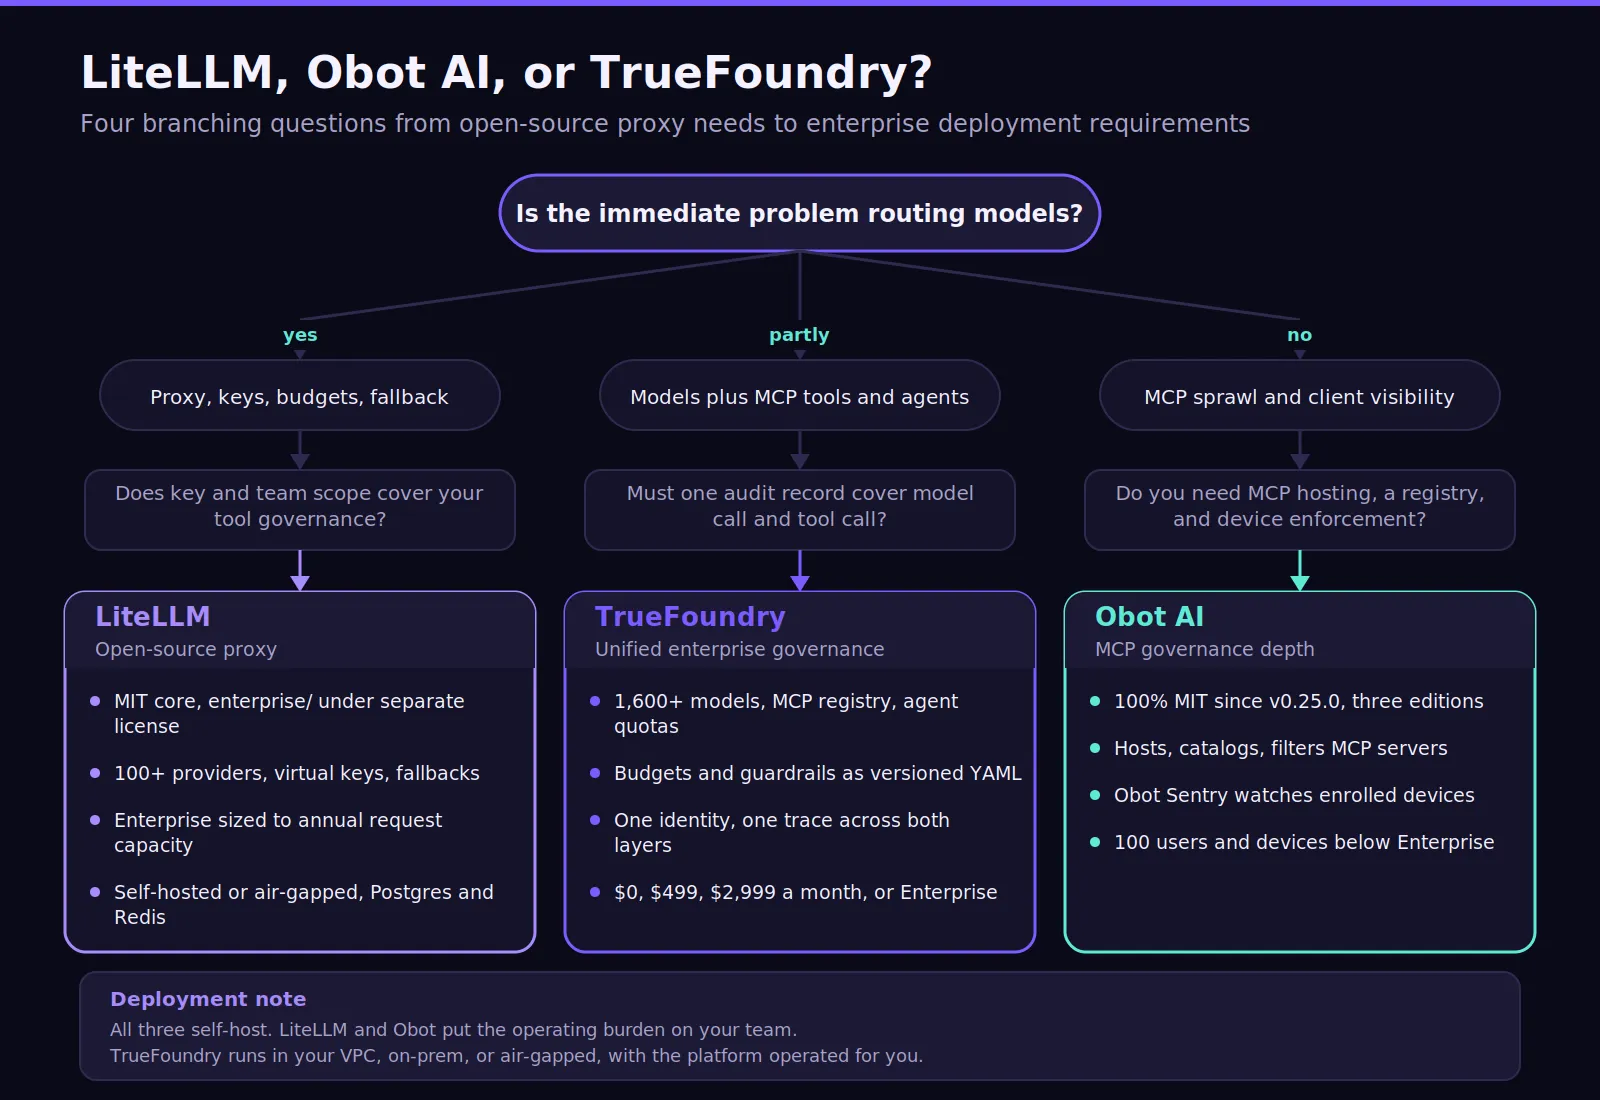
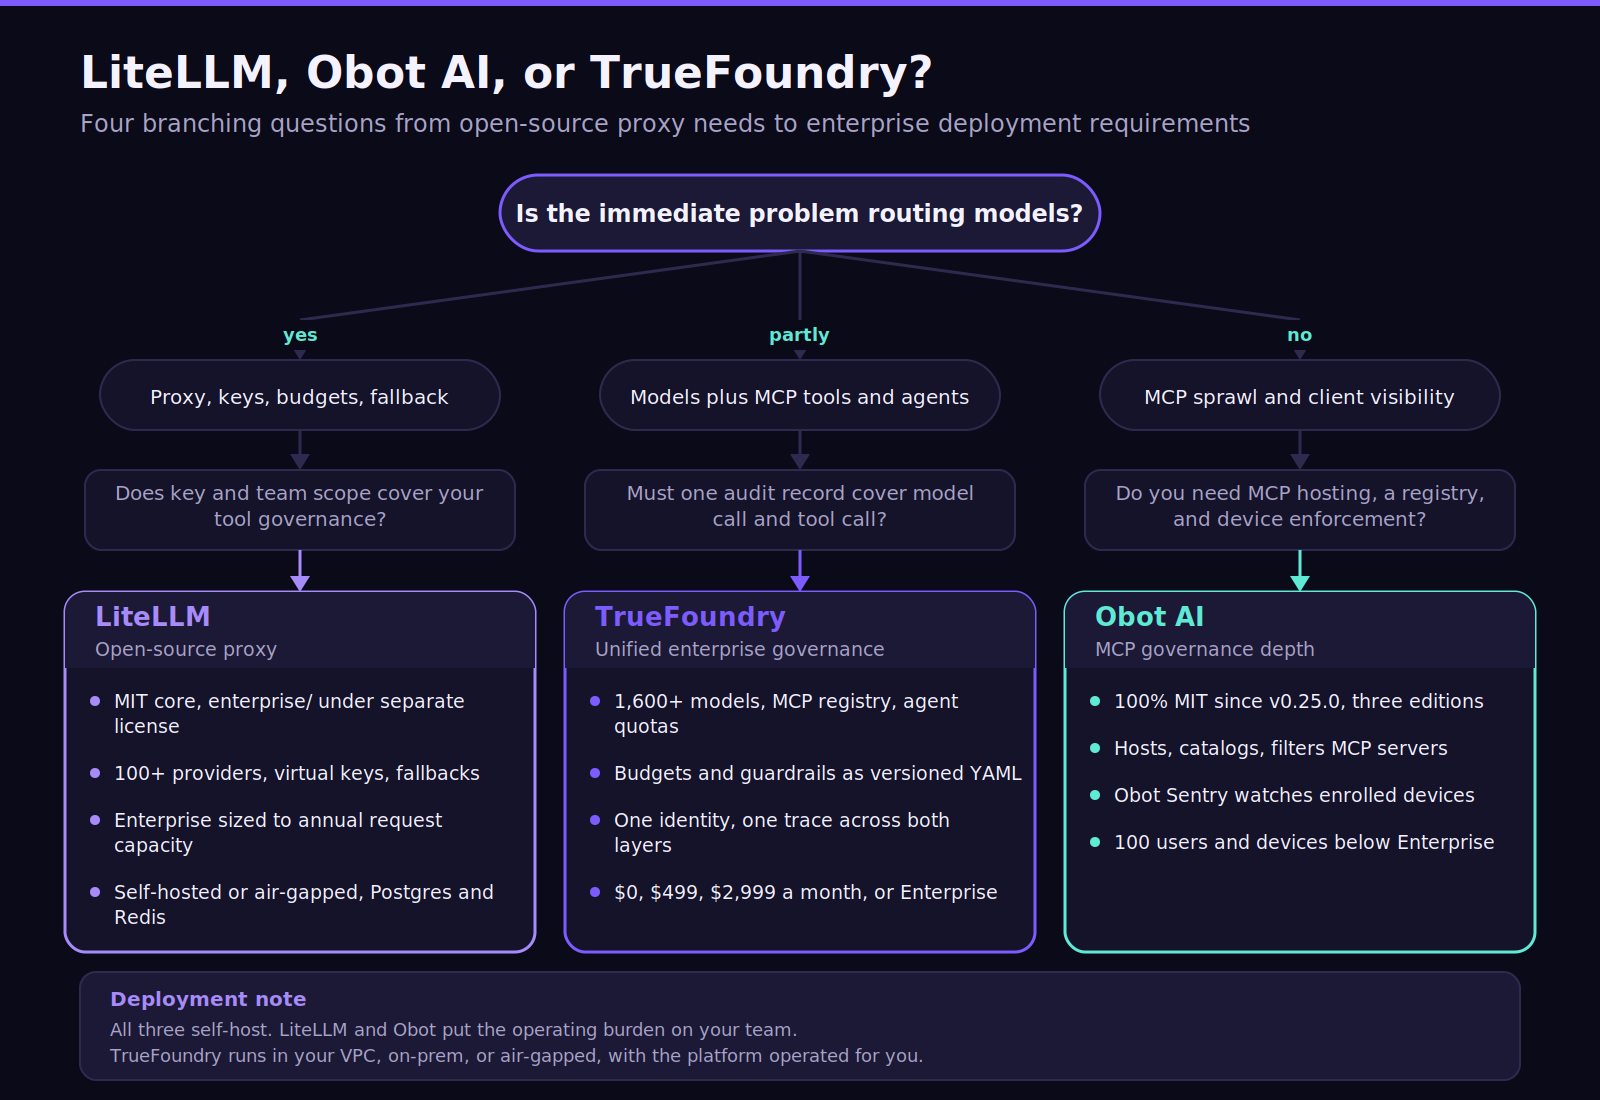
Wählen Sie LiteLLM, wenn die unmittelbaren Anforderungen Modellzugriff, Provider-Routing, Budgets, Fallbacks und Ausgabenverfolgung sind. Es bleibt ein starker Kandidat, wenn Produktions-Workloads primär ein modellbewusstes Gateway benötigen.
Wählen Sie Obot AI, wenn MCP-Governance, Sichtbarkeit von KI-Clients, Server-Hosting, Richtlinien für den Modellzugriff und identitätsbasierte Kontrollen die Entscheidung bestimmen. Es eignet sich für Teams, die mit einer unübersichtlichen MCP-Struktur und unkontrollierten Entwickler-Tool-Verbindungen zu kämpfen haben.
Entscheiden Sie sich für TrueFoundry, wenn Modelle, Tools, Agenten, Budgets, Leitplanken und Observability eine einheitliche Governance-Architektur erfordern. Dieser Ansatz bietet volle Kontrolle über mehrere KI-Ebenen hinweg, ohne dass separate Richtliniensysteme gepflegt werden müssen.
Die Entscheidung zwischen Obot AI und LiteLLM ist daher eine Wahl der Einstiegsebene. Die richtige Antwort hängt davon ab, ob Modell-Routing oder MCP-Governance die unmittelbare operative Einschränkung darstellt.
Teams, die einen anderen API-Gateway-Weg in Betracht ziehen, wie etwa Kong Gateway oder Kong AI Gateway, sollten diese Kategorie separat bewerten. Diese Plattformen setzen bei allgemeineren Anforderungen an den KI-Datenverkehr und das API-Management an.
Buchen Sie noch heute eine kostenlose Demo, um zu sehen, wie TrueFoundry die Governance von Modellen, MCPs und Agenten in Produktionsumgebungen verbindet.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















