November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Zwischen 2020 und 2023 haben Foundation-Modelle wie GPT-3 und GPT-4 bewiesen, dass Large Language Models menschenähnlichen Text generieren, Code schreiben, Dokumente zusammenfassen und komplexe Fragen beantworten können. Allerdings waren diese Modelle zustandslos und liefen in einer Sandbox; sie hatten keinen Zugriff auf interne Systeme, Datenbanken oder Apps — und besaßen keine Möglichkeit, tatsächlich Handlungen in der realen Welt auszuführen.
Sie konnten ein Modell beispielsweise fragen:
„Schreibe eine MongoDB-Abfrage, um alle Collections in der Compliance-Datenbank aufzulisten.“
Es generierte eine Ausgabe, die wie eine gültige MongoDB-Abfrage aussah — aber:
Es war reines Ratenn — ohne jede Feedbackschleife.
Um dies zu beheben, begannen Entwickler, Schichten um LLMs herum zu bauen:
Dies waren zwar clevere Behelfslösungen, aber schwer zu warten.
Frameworks wie LangChain, LlamaIndex und Semantic Kernel entstanden, um diese Workflows zu strukturieren. Diese Tools halfen zwar bei der Organisation, aber die grundlegenden Probleme blieben bestehen. Modelle halluzinierten weiterhin Felder, fielen auf Prompt-Injections herein, übersprangen Validierungen und verfügten über keinen Standardweg, um tatsächlich definierte Funktionen auszuführen. Jeder neue Anwendungsfall fühlte sich immer noch so an, als müsste das Rad neu erfunden werden.
Der echte Wendepunkt kam, als Entwickler erkannten:
„Wir brauchen keine Modelle, die Befehle erraten. Wir brauchen Modelle, die reale Funktionen aufrufen — genau so, wie Frontend-Apps Backend-APIs aufrufen.“
Mitte 2023 führte OpenAI das Function Calling ein, was es Modellen ermöglichte, strukturierte JSON-Ausgaben zurückzugeben, die direkt auf reale Funktionsaufrufe abgebildet werden konnten.
Dies definierte neu, was mit Modellintegration möglich war:
Mit Function Calling stieg der Einsatz von Tools und Agenten — Modellen, die Aktionen verketten, Workflows befolgen und mit realen Systemen interagieren konnten.
Aber…
1. Jede Implementierung war anbieterspezifisch.
2. Es gab keinen gemeinsamen Standardformat-Standard dafür, wie Tools beschrieben oder aufgerufen wurden.
Hier kommt MCP (Model Context Protocol) ins Spiel — vorgeschlagen als generelles, offenes Protokoll für die strukturierte Kommunikation zwischen Modellen und externen Tools. Anstatt Tool-APIs fest in jede LLM-App zu verdrahten, bietet MCP ein universelles Ladegerät für KI-Tool-Verbindungen — ähnlich wie OpenAPI, Anthropic etc., aber speziell für LLMs, die Tools aufrufen. Es basiert auf JSON-RPC 2.0, einer weit verbreiteten Spezifikation, die Remote Procedure Calls (RPCs) mittels JSON unterstützt.
Stellen Sie sich MCP als den API-Vertrag zwischen einem Modell und einem Tool vor. Ohne ein Standardprotokoll erforderte jede Integration individuelles Engineering — teuer, fehleranfällig und repetitiv. MCP löste dies durch die Schaffung einer universellen Sprache und vereinfachte Tool-Integrationen ein für alle Mal. Aber was genau ist MCP und wie funktioniert es in der Praxis? Tauchen wir tiefer ein.
MCP (Model Context Protocol) ist ein leichtgewichtiges Protokoll, das speziell für die strukturierte Kommunikation zwischen KI-Modellen und externen Tools entwickelt wurde.
Im Kern verwendet MCP JSON-RPC 2.0, ein bewährtes Protokoll zum Aufrufen von Remote Procedures mit strukturierten Ein- und Ausgaben — perfekt geeignet, um LLM-Ausgaben in reale Tool-Aufrufe zu verwandeln.
Warum also noch ein Protokoll erfinden?
Bestehende Optionen wie REST oder GraphQL sind für KI-zentrierte Workflows entweder zu generisch, zu ausführlich oder schlicht zu unflexibel. MCP schließt diese Lücke, indem es eine klare Struktur, minimalen Overhead und einen expliziten Fokus auf KI-Workflows bietet. Es soll Ihre APIs nicht ersetzen — es soll Modellen ermöglichen, diese sicher, wiederholbar und vorhersehbar zu nutzen.
Server stellen typischerweise Folgendes bereit:
Optional können Server auch Folgendes bereitstellen:
MCP ist transportagnostisch und unterstützt zwei Modi:
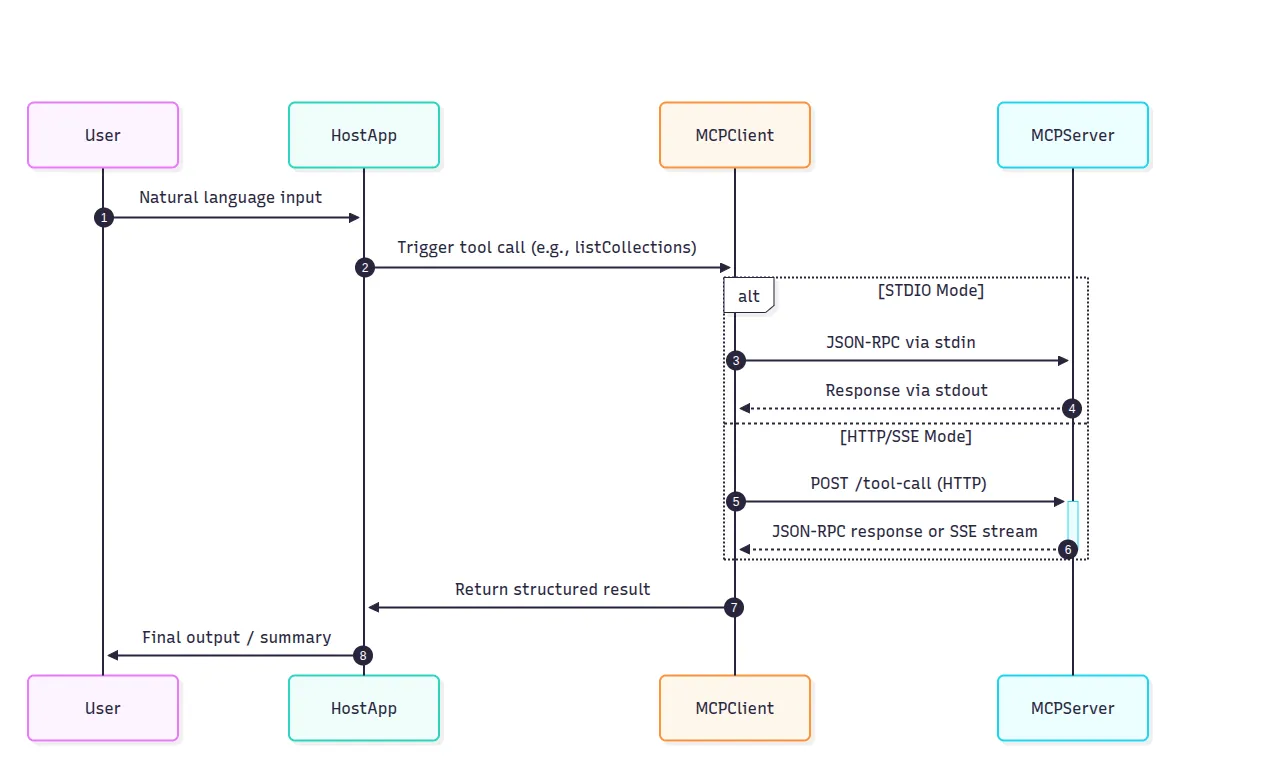
Beide Transporte folgen demselben JSON-RPC-Format, sodass Sie den Transport wechseln können, ohne Ihre Logik umzuschreiben.
Das ist also die Grundidee hinter MCP — eine minimale, saubere Möglichkeit für Modelle, Tools ohne anfällige Prompt-Basteleien aufzurufen. Keine halluzinierten Befehle. Kein manuelles Context Stuffing. Nur klare Eingaben und Ausgaben. Aber wie funktioniert das in einer realen Anwendung? Gehen wir ein Beispiel mit einem MongoDB-gestützten Compliance-Assistenten durch.
Stellen Sie sich vor, Sie bauen einen GRC-Assistenten (Governance, Risk, and Compliance).
Dieser Assistent muss:
In einem traditionellen Setup würden Sie diese Logik über REST-Aufrufe oder Python-Skripte fest verdrahten und Schemas sowie Anmeldedaten in Prompt-Templates einfügen. Jede Integration wäre individuell — und anfällig.
Mit MCP wird jedes dieser Tools — MongoDB, Slack, GitHub — zu einem erstklassigen Funktionsanbieter, der klar definierte Methoden bereitstellt wie:
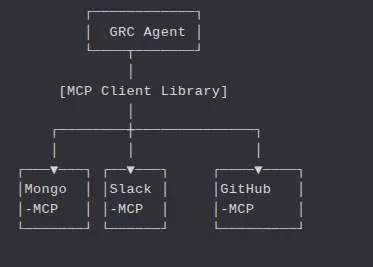
Der GRC-Agent (unsere Host-App) ruft diese Tools einfach unter Verwendung des JSON-RPC-Schemas von MCP auf.
Szenario: Erkennen und Melden von Richtlinienverstößen. Anweisung des Benutzers: „Überprüfe die Compliance-Datenbank auf heutige Richtlinienverstöße und benachrichtige das Team auf Slack.“
1. Benutzereingabe → Host-App → LLM. Die GRC-Agent (Host-App) sendet die Nachricht des Benutzers an das Modell. Das Modell ist tool-aware und antwortet mit:
2. Host-App ruft Mongo-MCP über den MCP-Client auf. Dieser Tool-Aufruf wird in eine JSON-RPC-Anfrage umgewandelt:
3. Mongo-MCP führt die Funktion aus. Mongo-MCP mappt diesen Aufruf auf:
Es führt die Funktion aus, erhält das Ergebnis und antwortet:
4. Agent verkettet den nächsten Aufruf: runAggregation. Das Modell generiert nun basierend auf den verfügbaren Collections einen Folgeaufruf:
Dies führt zu einem weiteren JSON-RPC-Aufruf an Mongo-MCP, und der Server gibt zurück:
Der Agent übergibt dieses Ergebnis mit einem Prompt wie dem folgenden an das Modell zurück:
„Fasse diese Daten zu Richtlinienverstößen in einfühlsamer, klarer Sprache zusammen.“
Das Modell antwortet:
„Heute gab es 5 Richtlinienverstöße mit hoher Schwere und 12 mit mittlerer Schwere in der Compliance-Datenbank.“
5. Modell ruft Slack-MCP auf, um das Team zu benachrichtigen. Nun setzt der Agent einen finalen strukturierten Tool-Aufruf ab:
Der Slack-MCP-Server sendet die Nachricht, und der Workflow ist abgeschlossen. All dies geschah durch strukturierte JSON-Aufrufe, nicht durch String-Manipulation oder Prompt Engineering.
Die Mongo-MCP-Demo sieht sauber aus. Das Modell hat strukturierte Tool-Aufrufe getätigt. Jede Funktion funktionierte wie erwartet. Keine Halluzinationen. Keine anfälligen String-Templates. Aber das ist ein Idealszenario („Happy Path“) — und reale Systeme müssen nicht nur funktionieren… sie müssen im großen Maßstab sicher, zuverlässig und nachvollziehbar funktionieren.
In der Produktion stößt reines MCP in einigen Schlüsselbereichen an seine Grenzen:
1. Keine Zugriffskontrolle (RBAC). Reines MCP hat keine integrierte Möglichkeit zu beschränken, wer was aufrufen darf.
In realen Unternehmen ist RBAC (rollenbasierte Zugriffskontrolle) unverzichtbar — insbesondere wenn Modelle mit sensiblen Tools verbunden sind.
2. Keine Authentifizierung oder API-Schlüssel. Reines MCP verarbeitet Folgendes nicht:
Das bedeutet, dass jeder mit Zugriff auf den MCP-Server jedes Tool aufrufen kann — und es gibt keinen Audit-Trail.
3. Keine Observability. Man kann nicht reparieren, was man nicht sieht.
Mit reinem MCP haben Sie keine Dashboards, Logs oder Traces. Sie fliegen im Blindflug.
4. Keine Guardrails. LLMs sind kreativ — manchmal zu kreativ.
Reines MCP bietet:
Ohne Guardrails kann ein einziger Prompt-Fehler zu Tausenden von Slack-Nachrichten oder versehentlichem Datenlöschen führen.
5. Keine Retries, Throttling oder Quotas in der Produktion
In der Produktion verhalten sich Tools nicht immer perfekt — sie können fehlschlagen, in Zeitüberschreitungen laufen oder langsam antworten. Ohne Schutzmaßnahmen können selbst gut konfigurierte Modelle:
Das reine MCP-Protokoll geht davon aus, dass einfach alles funktioniert — eine Traumwelt. Aber reale Infrastruktur ist komplex. Sie benötigen intelligente Retry-Logik, Caching, Rate-Limiting und Zugriffskontrolle, um im großen Maßstab den Überblick zu behalten.
Genau das bietet das TrueFoundry Gateway.
Im ersten Teil dieses Artikels haben wir gelernt, was das Model Context Protocol ist, und einen Mongo-MCP-Server genutzt, um eine veraltete GRC-Plattform zu automatisieren. Dieses kleine Beispiel ist großartig für einen Hackathon, stösst in der Realität jedoch schnell auf Hindernisse:
Das AI Gateway von TrueFoundry bündelt die fehlende Infrastruktur — eine MCP Registry, zentrale Auth, RBAC, Guardrails und umfassende Observability —, sodass Teams sicher und wiederholbar vom „Hello-World-Agenten“ in die Produktion übergehen können.
TrueFoundry positioniert eines der besten MCP Gateways als Control-Plane, die zwischen Ihren Agenten (oder der Chat-UI) und jedem registrierten MCP-Server sowie LLM-Anbieter sitzt.
Zu den wichtigsten Funktionen gehören:
Stellen Sie es sich als das API-Gateway + Service Mesh + Secret Store für die entstehende MCP-Umgebung vor. „Wie im MCP Server Authentication Guide beschrieben, übernimmt das Gateway die Speicherung von Anmeldedaten und den Token-Lebenszyklus automatisch.“
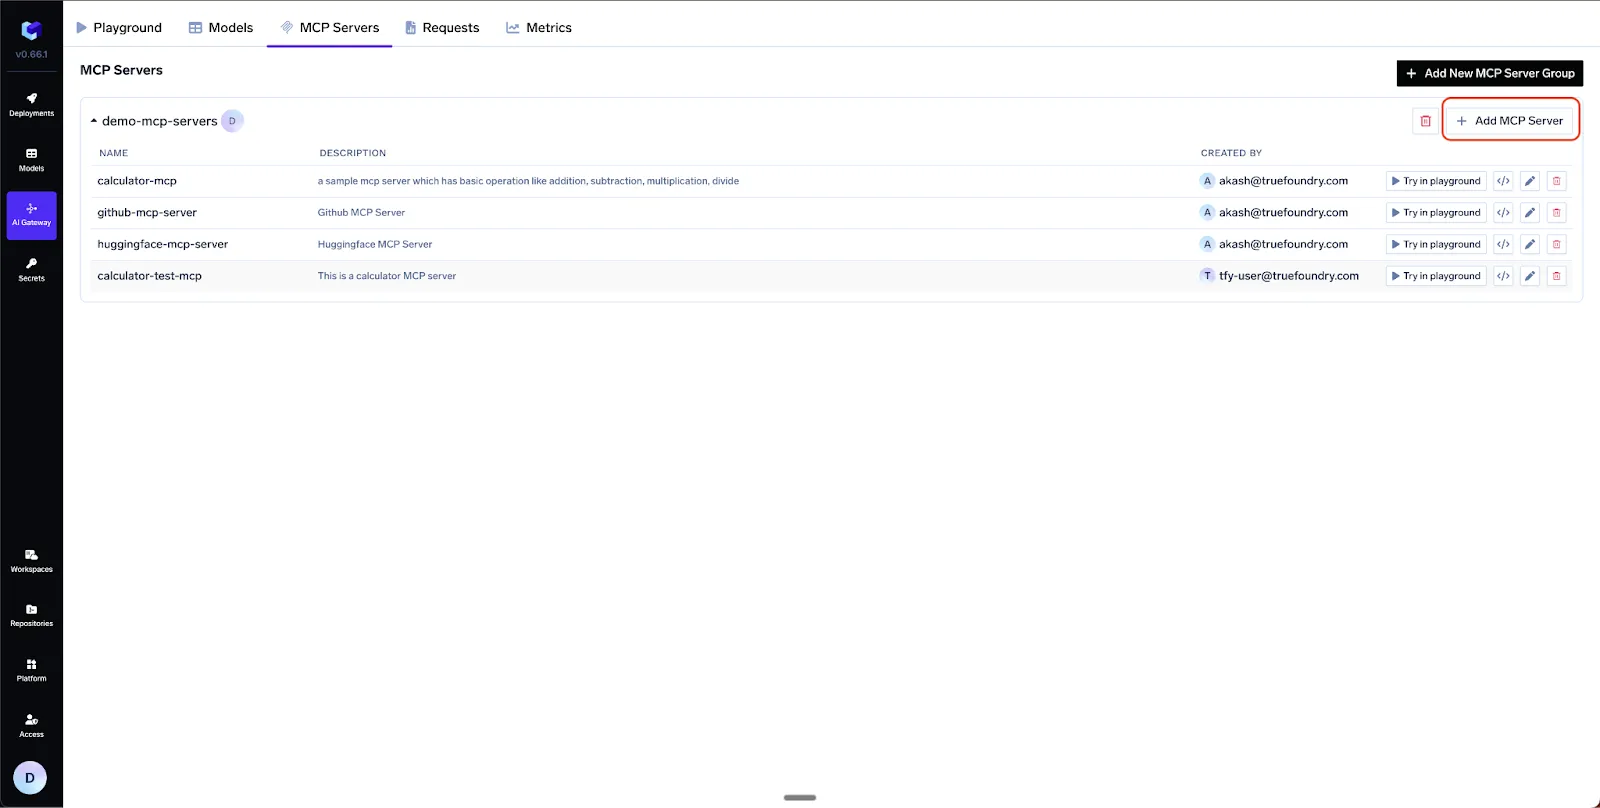
Der allererste Schritt in der Benutzeroberfläche besteht darin, eine Gruppe zu erstellen — z. B. dev-mcps oder prod-mcps. Gruppen ermöglichen es Ihnen, unterschiedliche RBAC-Regeln und Genehmigungsabläufe an verschiedene Umgebungen anzuhängen.
„Sie können der TrueFoundry MCP Server Getting Started Anleitung für detaillierte Schritte folgen.“
AI Gateway ➜ MCP Servers ➜ „Add New MCP Server Group“
Ebenso einfach können Sie hinzufügen:
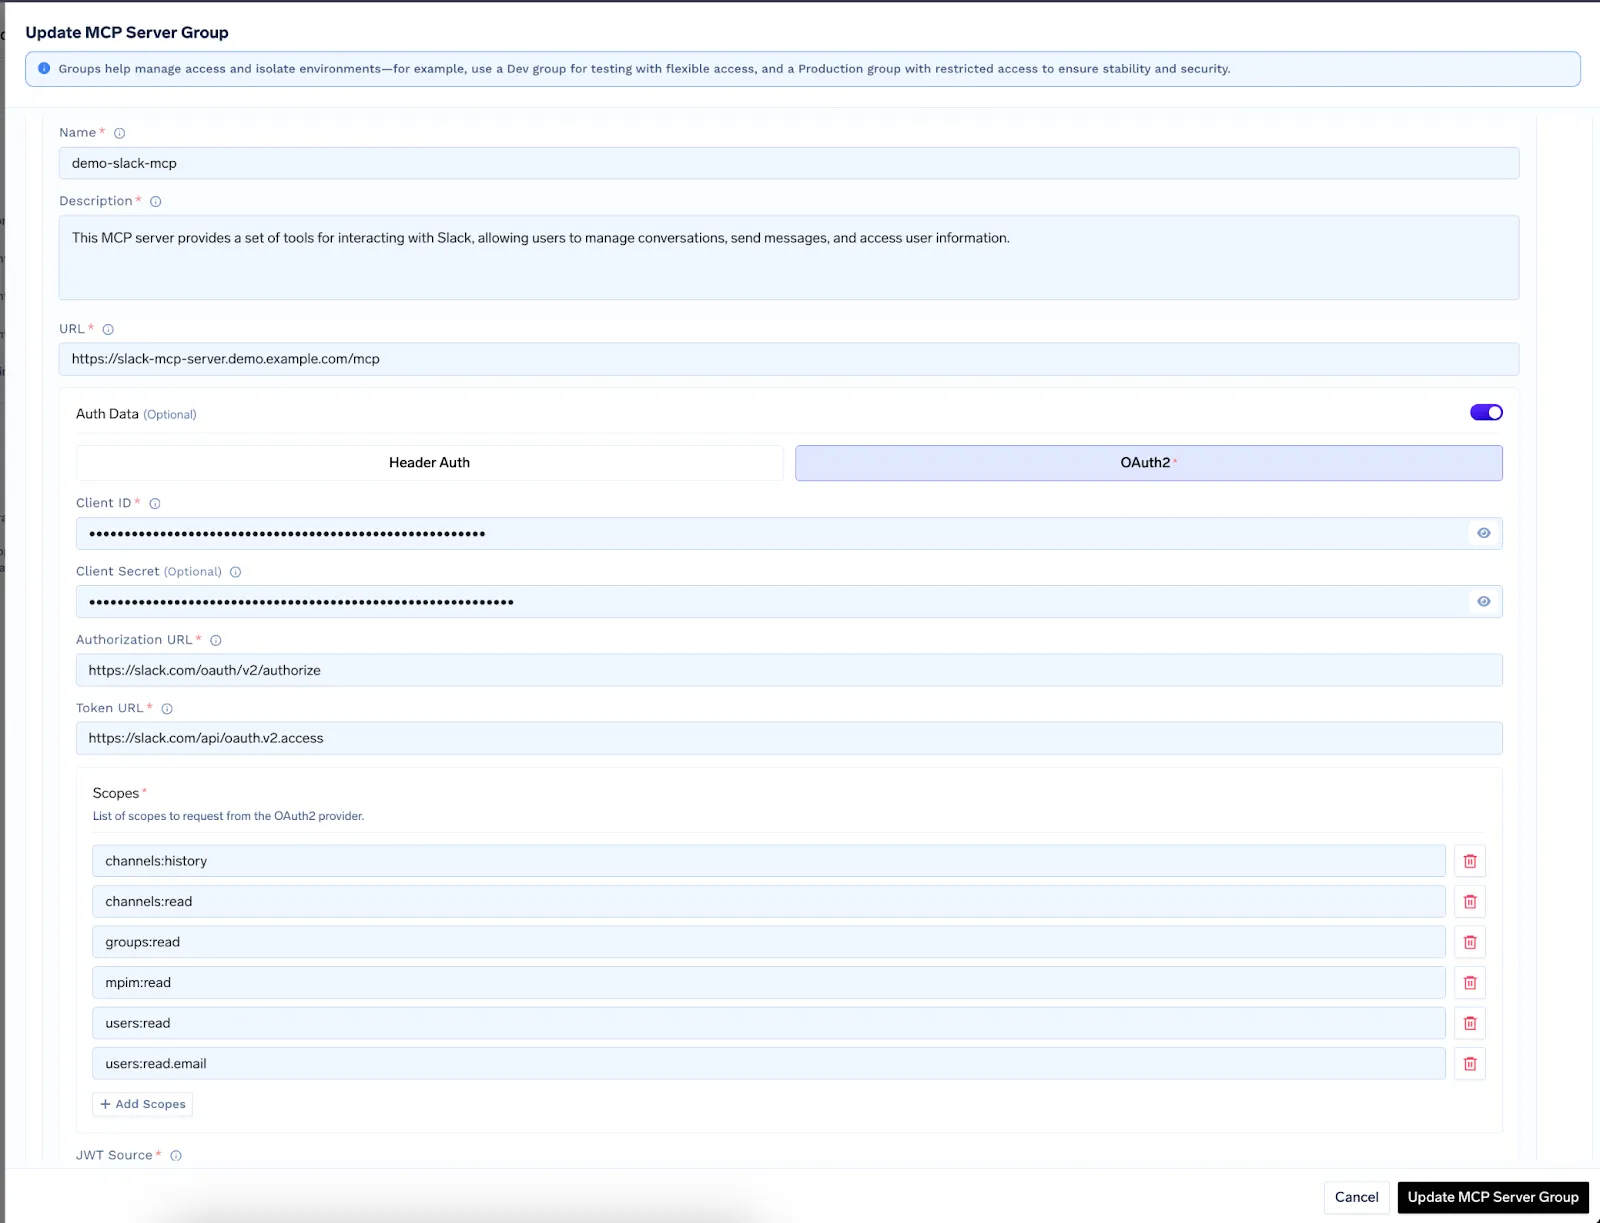
Hinter den Kulissen speichert das Gateway Anmeldedaten in seinem Secret Store und verwaltet Token-Refreshes.
TrueFoundry unterstützt drei Auth-Schemata pro MCP-Server:
„Diese Modi werden in der MCP Server Authentication Dokumentation detaillierter beschrieben.“
Sobald ein Server registriert ist, händigen Sie nicht jedem Entwickler Roh-Tokens aus. Stattdessen authentifizieren sie sich einmalig beim Gateway und erhalten:
Das Gateway prüft das aufrufende Token gegen:
Schlägt eine Prüfung fehl, wird die Anfrage abgelehnt, bevor sie Ihren Slack-Workspace erreicht.
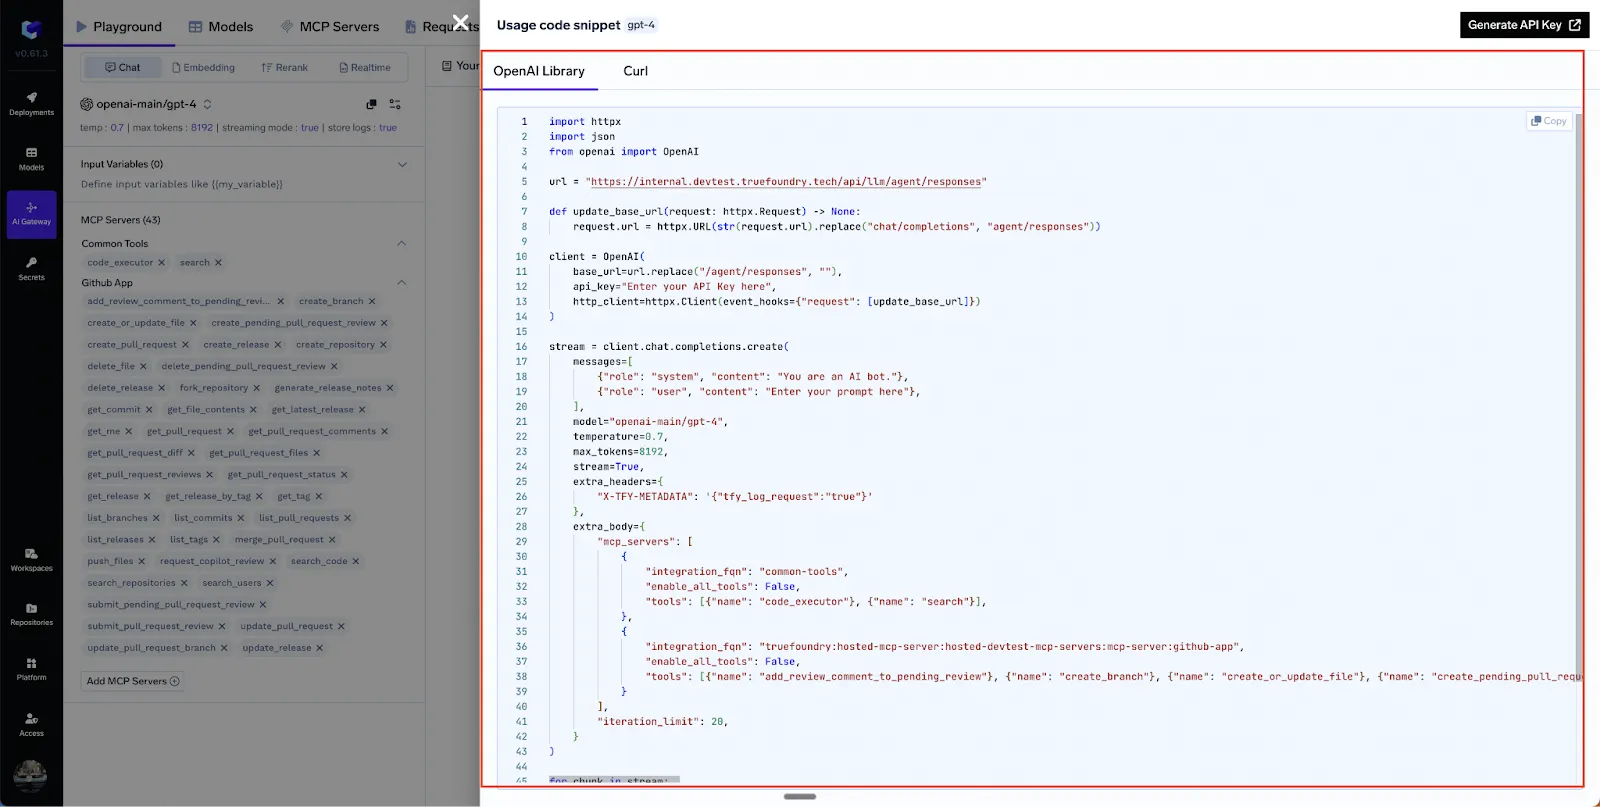
Nach dem Experimentieren in der UI können Sie auf „API Code Snippet“ klicken, um funktionierenden Python-, JS- oder cURL-Code zu generieren. Nachfolgend sehen Sie einen gekürzten JSON-Body, der drei Server verbindet (GitHub, Slack, Calculator):
POST/api/llm/agent/responses
„Ein ähnliches Beispiel finden Sie in der Anleitung Use MCP Server in Code Agent, die auch vollständige Python- und JS-Snippets enthält.“
Die Streaming-Antwort verschachtelt:
Dies ermöglicht den Bau reaktiver UIs, die jeden Schritt der Agentenschleife in Echtzeit anzeigen.
Selbst ein „Hello-World-Agent“ kann reale Kosten verursachen und Schaden anrichten. TrueFoundry bietet erstklassige Observability out-of-the-box:
Alle Metriken stehen direkt zur Verfügung; es sind keine Sidecar-Agenten oder benutzerdefinierten Exporter erforderlich.
Viele Open-Source-Server nutzen weiterhin stdio (stdin/stdout) anstelle von HTTP. TrueFoundry empfiehlt, diese mit mcp-proxy zu wrappen und als regulären Dienst bereitzustellen.
Fertige Templates existieren für Notion- und Perplexity-Server, ebenso wie K8s-Manifeste für Node- oder Python-Images. Sobald sie gehostet werden, unterscheidet sich die Registrierung nicht von jedem anderen HTTP-MCP-Endpunkt.
„Die MCP Server STDIO Anleitung von TrueFoundry behandelt diesen Proxy-Ansatz und bietet Deployment-Templates.“
Kehren wir zu unserem Legacy-GRC-Szenario zurück, erhöhen jedoch den Anspruch:
„Halte unsere Compliance-Nachweise auf dem neuesten Stand. Wenn sich eine Richtliniendatei in GitHub ändert, speichere den Diff in MongoDB, erstelle ein Jira-Ticket und poste eine Zusammenfassung in Slack.“
Da MCP lediglich JSON-RPC über HTTP oder stdio ist, kann jeder interne Dienst Tools bereitstellen. Hier ist ein kleines Beispiel:
Von diesem Moment an kann jeder Agent in Ihrem Unternehmen mit genau derselben Ergonomie wie bei Slack oder GitHub Rückschlüsse über Compliance-Controls ziehen.
„Dieses Blatt wurde aus der TrueFoundry MCP Übersicht adaptiert; diese Richtlinien helfen dabei, sichere und zuverlässige Deployments zu gewährleisten.“
MCP ermöglicht es Large Language Models (LLMs), dieselbe Sprache wie Tools zu sprechen – kümmert sich jedoch nicht um Themen wie Sicherheit, Discovery oder Governance auf Enterprise-Ebene. Hier setzt das AI Gateway von TrueFoundry an: Es bietet alles, was Teams out-of-the-box benötigen – wie ein vollständiges MCP-Registry, integrierte Authentifizierung, rollenbasierte Zugriffskontrolle (RBAC), tiefe Observability und eine leistungsstarke Agent API, um alles miteinander zu verbinden.
Ein MCP-Registry ist ein zentralisierter Katalog, der verfügbare Model Context Protocol (MCP) Server und deren spezifische Funktionen speichert und verwaltet. Er fungiert als durchsuchbares Verzeichnis für AI-Agenten und ermöglicht ihnen die dynamische Erkennung von Tools und Ressourcen. Dieses Registry stellt sicher, dass Modelle die richtigen Dienste identifizieren können, die zur Ausführung komplexer, mehrstufiger Aufgaben erforderlich sind.
Ein MCP-Registry ist ein passives Verzeichnis von Tools, während ein AI Gateway die aktive Durchsetzungsschicht ist, die den Datenverkehr verwaltet. Das Registry teilt dem System mit, welche Ressourcen existieren, während das Gateway den Zugriff steuert, die Authentifizierung verarbeitet und Sicherheitsrichtlinien wie PII-Maskierung oder Rate Limiting während der tatsächlichen Ausführung von Modellanfragen anwendet.
Ja, ein AI Gateway kann mithilfe statischer Konfigurationen ohne ein MCP-Registry funktionieren, verliert dabei jedoch die Flexibilität der dynamischen Tool-Erkennung. Ohne ein Registry müssen Entwickler jede Serververbindung manuell im Code verankern, was die Skalierung und Wartung des Systems erschwert. Die Integration eines Registrys ermöglicht es dem Gateway, sich automatisch anzupassen, wenn neue Tools zum Ökosystem hinzugefügt werden.
Das AI Gateway ruft Metadaten und Governance-Regeln aus dem MCP-Registry ab, um eingehende Anfragen in Echtzeit zu validieren. Es gleicht die im Registry definierten Benutzerberechtigungen und Sicherheitsanforderungen ab, bevor der Datenverkehr an den entsprechenden Server weitergeleitet wird. Dies stellt sicher, dass jede Interaktion den Unternehmensstandards und Datenschutzbestimmungen entspricht.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet