



September 17, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: September 11, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Diese Begriffe werden austauschbar verwendet, bis etwas schiefgeht. Sie beschreiben unterschiedliche Architekturen mit unterschiedlichen Garantien, und die Kosten ihrer Verwechslung zeigen sich in Sicherheitslücken, Audit-Fehlern und Neuaufbauten, die eigentlich nicht hätten sein müssen.
Da das Model Context Protocol zum Standard für die Verbindung von KI-Agenten mit Datenquellen und Tools wird, ist die Infrastruktur-Terminologie durcheinandergeraten. Anbieter, Blogbeiträge und interne Design-Dokumente verwenden „Proxy“, „Router“ und „Gateway“ austauschbar. Die Unterscheidung ist unscharf, wenn alles auf dem Laptop eines Entwicklers läuft, und tödlich, wenn man beginnt, Produktionsagenten auszuliefern – denn die drei Begriffe bezeichnen strukturell unterschiedliche Dinge, und der Unterschied zeigt sich erst, wenn ein Prüfer eine Frage stellt, die einer von ihnen nicht beantworten kann.
Ein Blick in die Netzwerktechnik liefert das klarste mentale Modell. Ein Proxy arbeitet auf Schicht 4 (L4) – er leitet Bytes weiter und interpretiert sie nicht. Ein Router arbeitet auf Schicht 7 (L7) bei der Fähigkeitsverteilung – er kennt das Tool, aber nicht den aufrufenden Prinzipal. Ein Gateway arbeitet auf Schicht 7 (L7) bei der Richtlinienverwaltung – es kennt das Tool, den Prinzipal, das Budget und den Audit-Trail. Jede Schicht ist deutlich leistungsfähiger, deutlich teurer im Betrieb und beantwortet deutlich mehr Fragen zu jeder Anfrage.
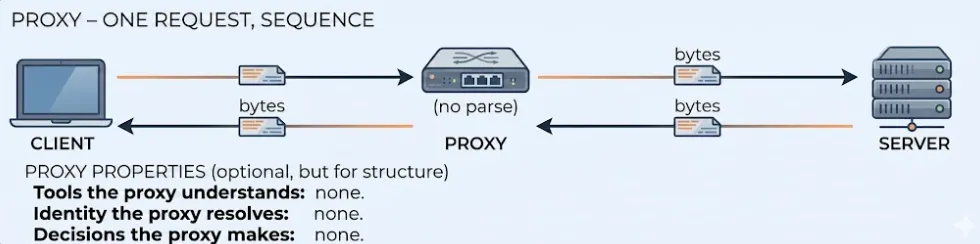
Ein Proxy ist das einfachste Element im Diagramm. Seine Aufgabe ist die Protokollvermittlung. MCP nutzt stdio stark für die lokale Ausführung; ein Proxy kann einen stdio-basierten MCP-Server umschließen und ihn über HTTP/SSE oder WebSockets zugänglich machen, damit ein Remote-Client ihn erreichen kann. Das ist die gesamte Aufgabe.
Ein Proxy interpretiert die Nutzlast überhaupt nicht. Er parst kein JSON-RPC, versteht keine Tool-Aufrufe, weiß nicht, was „Tool“ bedeutet. Er leitet Bytes weiter. Das macht ihn sub-millisekundenschnell und nahezu kostenlos im Betrieb. Ein einzelner Entwickler, der Claude Desktop mit einem MCP-Server in einem Docker-Container auf derselben Maschine verbindet – das ist ein Proxy-Anwendungsfall. Keine Governance, kein Zustand, kein Grund für beides.
Der Fehler ist, zu glauben, der Proxy würde skalieren. Das wird er nicht. Sobald Sie mehr als einen Entwickler oder mehr als einen nachgeschalteten MCP-Server haben, ist der Proxy nicht mehr tragfähig und der Router übernimmt. Ein Proxy ist kein Baustein eines Enterprise-Stacks; er ist ein persönliches Komfort-Tool, das ein Gateway intern zur Transportanpassung umschließen könnte. Ihn als mehr oder weniger als das zu behandeln – ihn zu überdimensionieren, ihn zu unterschätzen – führt zu einer Architektur, die schlecht altert.
Mit wachsenden Umgebungen wird das Hardcodieren von Server-URLs in Clients unhaltbar. Ein Router löst das Discovery-Problem: Anstatt dass der Client weiß, wo der github-mcp-server lebt, verbindet sich der Client mit dem Router und fragt, welche Tools verfügbar sind. Der Router pflegt ein Register der nachgeschalteten Server und eine Fähigkeitskarte.
Wenn das LLM `search_repositories` aufruft, inspiziert der Router die JSON-RPC-Nutzlast, identifiziert das Ziel-Tool und leitet den Aufruf an das richtige Backend weiter. Mechanisch gesehen ist er ein Aggregator mit einer Routing-Tabelle – schnell, einfach und eine saubere Abstraktion. Die meisten internen Teams greifen zu einem, sobald sie mehr als zwei MCP-Server haben, und das zu Recht.
Was der Router nicht tut, ist die Frage zu stellen, die in der Produktion am wichtigsten ist: Ist die Identität, die diesen Aufruf tätigt, tatsächlich berechtigt, dieses Tool aufzurufen? Er routet nach Fähigkeit. Er schützt nicht durch Richtlinien. Das Modell kann `delete_branch` auf Prod genauso einfach aufrufen wie `list_issues` auf einem öffentlichen Repo. Der Router wird beide gehorsam weiterleiten, und das Audit-Log, das er erstellt oder nicht erstellt, wird nur durch die Leitung geformt – nicht dadurch, wer die Leitung gehalten hat.
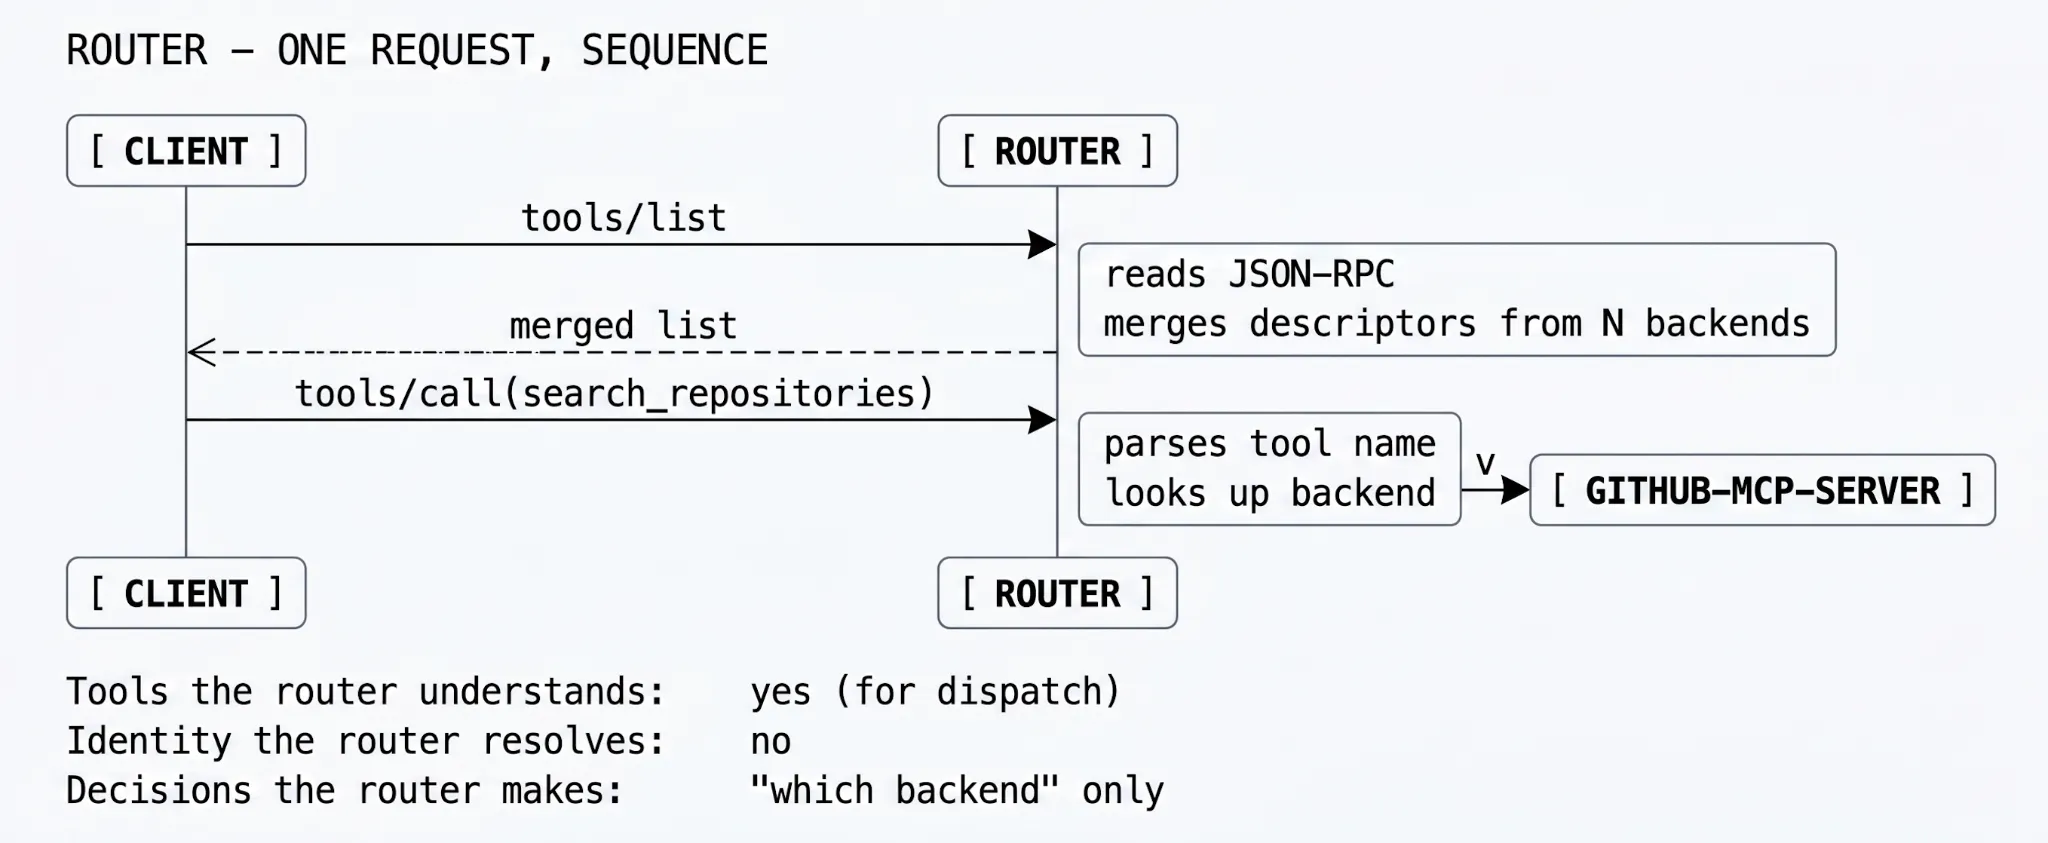
Der Router ist die richtige Schicht, wenn die Agenten intern sind, das Netzwerk vertrauenswürdig ist und die schlimmste Aktion rückgängig gemacht werden kann. Der Übergang, der Teams Schwierigkeiten bereitet, ist Router → Gateway, und er geschieht normalerweise an dem Tag, an dem jemand fragt, wer letzten Dienstag `delete_branch` auf Prod aufgerufen hat. Der Router hat keine Antwort, weil er es nie wusste.
Ein Gateway umfasst den Proxy und den Router und fügt eine L7-Steuerungsebene hinzu. Dies ist die Schicht, auf der Enterprise-KI-Operationen tatsächlich stattfinden – und die Schicht, auf der eine Sicherheitsüberprüfung beginnen wird, unabhängig davon, ob jemand sie während des Designs so genannt hat.
Ein Gateway inspiziert jedes Paket. Es integriert sich mit der Unternehmensidentität (OAuth 2.0, SAML, OIDC), um festzustellen, in wessen Namen der Agent handelt. Es erzwingt RBAC auf Tool-Ebene. Es führt die Schema-Bereinigung durch, die MCP-Poisoning abfängt. Es verfolgt die Token-Nutzung zur Budgetzuweisung. Es schreibt manipulationssichere Protokolle an externe SIEMs. Strukturell ist es der Ort, an dem die KI-Richtlinie der Organisation kodiert ist – und der einzige Ort, an dem der Agent eines ausgeschiedenen Auftragnehmers im richtigen Moment aufhört zu funktionieren.
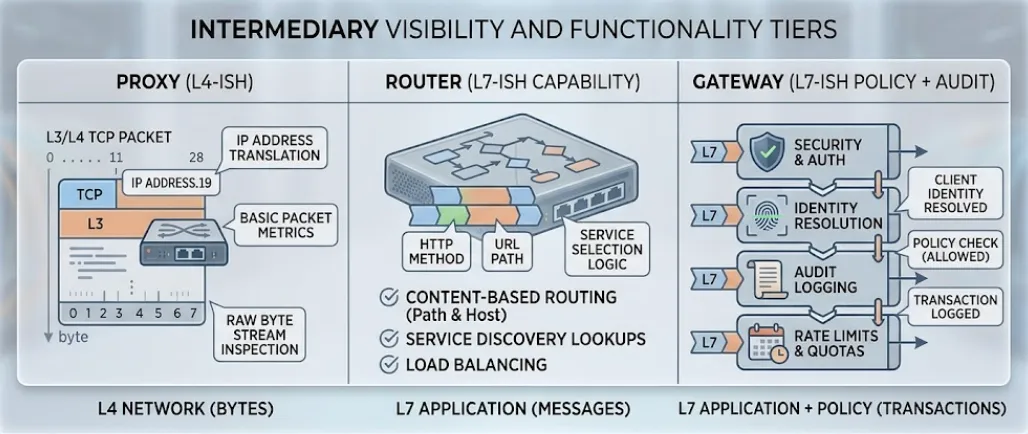
Der gleiche Vergleich in Tabellenform, für die Prüfer der Design-Dokumente, die nur überfliegen werden. Lesen Sie die Spalten; jede beantwortet eine Frage zu einer Anfrage.
Tabelle 1 — Fähigkeitsmatrix. Die rechte Spalte zeigt, wonach Ihr Prüfer fragen wird; die mittlere Spalte ist das, wonach Ihr Team zuerst greifen wird; die linke Spalte ist das, was auf Ihrem Laptop läuft.
Ein kurzer Entscheidungsbaum, geschrieben in der Reihenfolge, in der Produktionsteams die Fragen tatsächlich beantworten:
Der Übergang, der die meisten Teams trifft, ist Router → Gateway, und er geschieht immer im selben Moment: Jemand stellt eine Audit-Frage, die identitätskorrelierte Protokolle erfordert, und der Router hat keine Antwort, weil er nie wusste, wer anrief. Die günstige Lösung an diesem Punkt ist das Hinzufügen eines Gateways. Die teure Lösung ist der Neuaufbau der Agentenplattform nach einem Sicherheitsvorfall – was ein Teil der Teams stattdessen tun wird, weil die günstige Lösung bis zum Vorfall unsichtbar ist.
TrueFoundry ist als föderiertes Gateway aufgebaut. Die Steuerungsebene (wo Richtlinien erstellt, Modelle registriert und Observability angesiedelt sind) ist von der Gateway-Ebene (wo der Datenverkehr fließt) getrennt. Die Gateway-Ebene ist vollständig zustandslos – jeder Gateway-Pod abonniert die Steuerungsebene über NATS für Konfigurationsaktualisierungen, und jede von ihm durchgeführte Prüfung erfolgt im Arbeitsspeicher anhand dieses synchronisierten Zustands. Es gibt keinen Single Point of Failure zwischen dem Agenten und dem Backend. Fällt die Steuerungsebene aus, bedienen die Gateways weiterhin mit ihrer zuletzt bekannten Konfiguration; wenn die Steuerungsebene zurückkehrt, gleicht NATS ab. Als letztes Sicherheitsnetz veröffentlicht die Steuerungsebene die gesamte Konfiguration alle 10 Minuten neu – die Eventual Consistency ist auch dann gewährleistet, wenn ein zwischenzeitliches Update verpasst wurde.
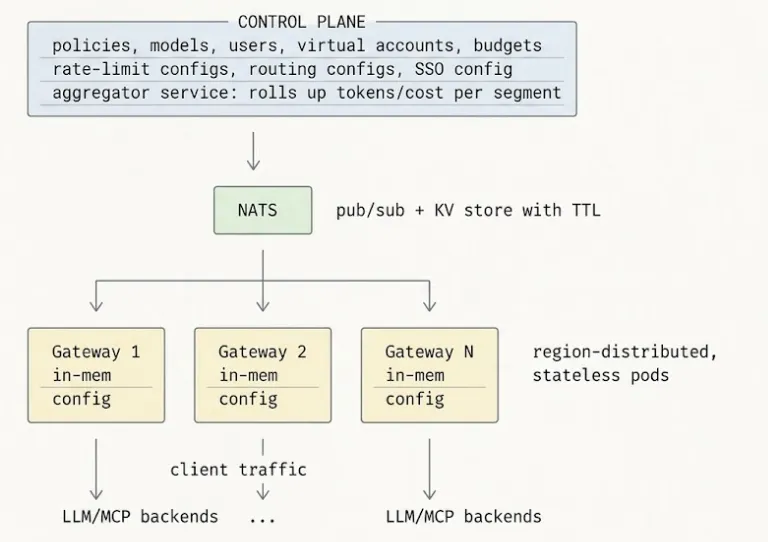
Die Datenebene basiert auf Hono – einem an die Web Fetch API angepassten und für den Edge optimierten Framework – und führt alle Ratenbegrenzungs-, Authentifizierungs- und Routing-Prüfungen im Prozessspeicher durch. Die Steuerungsebene synchronisiert die Konfiguration über NATS in einem Sub-Sekunden-Takt; der Anforderungspfad selbst tätigt niemals einen externen Aufruf, es sei denn, der Cache oder eine netzwerkbasierte Schutzmaßnahme wird ausgelöst. Die entscheidende strukturelle Eigenschaft ist die Zustandslosigkeit: Ein Gateway-Pod kann jederzeit beendet werden, ohne laufende Richtlinienentscheidungen zu verlieren, da es keine laufenden Richtlinienentscheidungen gibt – jede Entscheidung wird aus dem lokalen Speicher anhand asynchron eingetroffener Konfigurationen getroffen.
Das Merkmal, das die Architektur zusammenhält, ist die virtuelle MCP-Server-Komposition. Das Gateway führt Schemata von Dutzenden von Backend-MCP-Servern zu einer einzigen API-Oberfläche zusammen, die dynamisch pro Aufrufer skaliert wird. Ein IAM-Token eines Frontend-Entwicklers erzeugt eine andere vereinheitlichte Tool-Liste als das eines Plattform-Ingenieurs, und keiner von beiden sieht Tools, die der andere nicht verwenden darf. Aus Sicht des Modells gibt es einen MCP-Server. Aus Sicht des Plattform-Teams gibt es einen zentralen Ort zur Festlegung von Richtlinien. Aus Sicht des Prüfers hat jeder Tool-Aufruf eine Trace-ID, die die Modellentscheidung mit der Entwickleridentität verknüpft, die sie autorisiert hat.
Gleicher Client, gleiche Backends, völlig unterschiedliche Zwischenschicht. Die Zwischenschicht ist der Teil, der gut altert.
Architektur ist hauptsächlich die Praxis, zu entscheiden, wo Grenzen verlaufen, und die Kosten für eine falsche Entscheidung werden nicht zur Entwurfszeit, sondern beim nächsten Vorfall, der nächsten Prüfung, der nächsten Migration bezahlt. Die Unterscheidung zwischen Proxy/Router/Gateway ist kein Vokabelproblem. Es ist eine Frage, ob Ihre Plattform einen Kontrollpunkt an der Nahtstelle hat, wo die Unternehmensidentität auf die Agentenschleife trifft, oder ob sie eine Routing-Tabelle hat, wo ein Kontrollpunkt sein sollte.
Die meisten Teams entdecken diesen Unterschied auf die harte Tour. Manche entdecken ihn während einer Postmortem-Analyse; manche während einer Compliance-Prüfung; manche, wenn der Agent eines ausgeschiedenen Auftragnehmers eine Woche länger funktioniert, als er sollte. Der Moment der Entdeckung ist in allen drei Fällen derselbe. Die Kosten der Entdeckung variieren jedoch.
Ja, und die meisten Teams tun dies. Der Migrationspfad ist sauber: Das Gateway spricht dasselbe MCP-Wire-Protokoll, sodass bestehende Clients weiterhin funktionieren. Was sich ändert, ist die URL, auf die sie zeigen, und der Auth-Header, den sie mitsenden. Planen Sie die Migration in zwei Phasen – stellen Sie das Gateway zuerst im Audit-Modus bereit (Protokollierung, keine Erzwingung) und überprüfen Sie, ob die Protokolle den Erwartungen entsprechen; schalten Sie dann die Erzwingung pro Server ein, beginnend mit den MCP-Servern mit dem geringsten Risiko und endend mit der Produktionsdatenbank.
Gateways leiten den Traffic auf unbestimmte Zeit mit der zuletzt abgerufenen Konfiguration weiter. Sie abonnieren NATS für Live-Updates, und als Backup versuchen sie erneut, die Konfiguration per HTTP vom Backend-Dienst der Steuerungsebene abzurufen. Wenn sowohl NATS als auch das Backend ausgefallen sind, laufen bestehende Gateway-Pods mit der zuletzt bekannten Konfiguration weiter; neue Pods, die während des Ausfalls versuchen zu starten, werden ihre Readiness-Probe nicht bestehen und keinen Traffic empfangen. Es wird empfohlen, mehrere Gateway-Replikate zu betreiben – die Wahrscheinlichkeit, dass alle während eines Ausfalls der Steuerungsebene neu starten, ist das Risiko, dem man entgegenwirken muss, und es ist gering.
Hono basiert auf der Web Fetch API und ist für Edge-Runtimes (Cloudflare Workers, Deno, Bun, Node) konzipiert. Es ist klein, schnell und läuft identisch über verschiedene Runtimes hinweg – was wichtig ist, da das Gateway über SaaS, On-Premise Kubernetes und Air-Gapped Squid-Proxy-Umgebungen portabel sein muss. Express hat eine zu große Oberfläche; Fastify ist in Ordnung, aber an Node-Spezifika gebunden. Die relevante Eigenschaft ist ein konsistent niedriger Overhead bei hoher Parallelität, den Hono zuverlässig liefert.
Sie wird pro Aufrufer festgelegt. Das Gateway bewertet die IAM- und ABAC-Attribute des Principals anhand des Policy-Bundles jedes Mal, wenn es eine tools/list bereitstellt, und gibt eine gefilterte Vereinigung von Tool-Deskriptoren aus. Zwei Entwickler, die sich im Abstand von Sekunden anmelden, können unterschiedliche Tool-Listen vom selben Gateway-Endpunkt erhalten. Das Modell weiß nie, dass es mehrere Backends gibt, und es weiß nie, dass es Tools gibt, die sein aktueller Aufrufer nicht erreichen kann. So erhalten Sie auch saubere Multi-Tenant-Bereitstellungen – dasselbe Gateway bedient verschiedene Mandanten mit unterschiedlichen Welten.
Drei Mechanismen. Konfigurations-Payloads sind idempotent – die Steuerungsebene veröffentlicht bei jeder Änderung den gesamten aktuellen Zustand an NATS, sodass der zweimalige Empfang derselben Nachricht keine Auswirkung hat. NATS bietet eine At-Least-Once-Zustellung, sodass das Gateway jedes Update mindestens einmal sehen wird. Und als zusätzliche Sicherheitsmaßnahme veröffentlicht die Steuerungsebene die vollständige Konfiguration alle 10 Minuten erneut – selbst wenn ein zwischenzeitliches Update verpasst wurde, konvergiert das Gateway spätestens innerhalb von 10 Minuten in den korrekten Zustand. Drift ist konstruktionsbedingt begrenzt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















