



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Large Language Models entwickeln sich rasch zu einer zentralen Schicht von Unternehmenssoftware. Was als cloudbasierte Experimente mit gehosteten APIs begann, entwickelt sich nun zu produktionsreifen Systemen, die in interne Werkzeuge, kundenorientierte Anwendungen und automatisierte Arbeitsabläufe eingebettet sind.
Im Zuge dieses Wandels sehen sich viele Unternehmen mit einer harten Realität konfrontiert: Nicht alle KI-Workloads können in der Public Cloud ausgeführt werden.
Sensible Unternehmensdaten, proprietäres geistiges Eigentum, regulierte Workloads, latenzkritische Anwendungen und Compliance-Verpflichtungen veranlassen Teams dazu, LLMs in einer On-Premise- oder privaten Infrastruktur bereitzustellen. Allerdings löst das reine Self-Hosting von Modellen das größere betriebliche Problem nicht. Da immer mehr Teams, Anwendungen und Modelle hinzukommen, benötigen Unternehmen eine einheitliche Möglichkeit, den Zugriff zu steuern, Richtlinien durchzusetzen, die Nutzung zu überwachen und die Kosten in ihrem gesamten LLM-Ökosystem zu verwalten.
Hier wird eine On-Premise-LLM-Gateway-Infrastruktur grundlegend.
Anstatt jeder Anwendung die direkte Integration mit einzelnen Modellen zu erlauben, führt ein LLM Gateway eine zentralisierte Steuerungsschicht ein, die regelt, wie auf Modelle zugegriffen und wie sie genutzt werden. In On-Premise-Umgebungen wird dieses Gateway zum Rückgrat, das es Unternehmen ermöglicht, die LLM-Einführung sicher, konform und effizient zu skalieren, ohne Transparenz oder Kontrolle einzubüßen.
Ein LLM Gateway ist eine zentralisierte Zugriffs- und Governance-Schicht, die zwischen Anwendungen und Sprachmodellen sitzt. Anstatt dass Anwendungen Modelle direkt aufrufen, fließen alle LLM-Anfragen durch das Gateway, das Sicherheit, Routing, Observability und Richtlinienkontrollen an einem zentralen Ort durchsetzt.
In einem On-Premise-Setup laufen sowohl das Gateway als auch die Modelle vollständig innerhalb der Infrastruktur der Organisation – wie beispielsweise in einem Rechenzentrum, einer Private Cloud (VPC) oder einer Air-Gapped-Umgebung. Dadurch wird sichergestellt, dass Prompts, Antworten, Embeddings und Metadaten kontrollierte Grenzen niemals verlassen.
Auf hoher Ebene bietet ein On-Premise-LLM-Gateway:
Durch die Abstraktion des Modellzugriffs hinter einer standardisierten API entkoppelt das Gateway die Anwendungsentwicklung von der Modellinfrastruktur. Teams können Modelle wechseln, feineingestellte Versionen einführen oder neue Governance-Regeln durchsetzen, ohne den Anwendungscode zu ändern.
In On-Premise-Umgebungen, in denen die Infrastruktur begrenzt ist, die Compliance-Anforderungen streng sind und die betriebliche Komplexität hoch ist, macht diese zentralisierte Gateway-Schicht die großflächige LLM-Einführung überhaupt erst praktikabel. Sie verwandelt selbst gehostete Modelle von isolierten Bereitstellungen in eine verwaltete, produktionsreife KI-Plattform.
Wichtige Metriken zur Evaluierung eines Gateways
| Kriterium | Was sollten Sie evaluieren? | Priorität | TrueFoundry |
|---|---|---|---|
| Latenz | Fügt <10ms p95-Overhead für Time-to-First-Token hinzu? | Must-Have | ✅ Unterstützt |
| Datenresidenz | Behält Logs innerhalb Ihrer Region (EU/US)? | Abhängig vom Anwendungsfall | ✅ Unterstützt |
| Latenzbasiertes Routing | Leitet basierend auf Echtzeit-Latenz/Ausfällen automatisch um? | Must-Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-Have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-Have | ✅ Unterstützt |

Die Ausführung von LLMs On-Premise ist selten nur eine Infrastrukturentscheidung. Sie wird meist von nicht verhandelbaren Unternehmensanforderungen rund um Datenkontrolle, Sicherheit und Governance angetrieben. Ein LLM Gateway macht diese Bereitstellungen in großem Maßstab erst praktikabel.
Unternehmen verarbeiten häufig sensible Eingaben wie interne Dokumente, Kundendaten, Quellcode oder vertrauliche Informationen. In regulierten Umgebungen ist selbst das vorübergehende Verlassen kontrollierter Infrastrukturen durch Prompt-Daten inakzeptabel.
Ein On-Premise-LLM-Gateway stellt sicher, dass:
Dies ist besonders kritisch für Organisationen, die unter strengen Auflagen zur Datenlokalisierung oder -souveränität agieren.
Direkte Anwendung-zu-Modell-Integrationen schaffen fragmentierte Sicherheitsgrenzen. Jeder Dienst verwaltet am Ende seine eigenen Anmeldedaten, Berechtigungen und Zugriffslogiken, was die Durchsetzung einheitlicher Sicherheitsstandards erschwert.
Ein LLM Gateway zentralisiert:
Durch die Weiterleitung des gesamten Datenverkehrs über eine einzige Steuerungsschicht reduzieren Unternehmen ihre Angriffsfläche erheblich und gewinnen Vertrauen in die Art und Weise, wie auf Modelle zugegriffen wird.
Regulatorische Rahmenbedingungen verlangen von Organisationen zunehmend Antworten auf Fragen wie:
Ein On-Premise-LLM-Gateway bietet standardmäßig integrierte Audit-Trails. Jede Anfrage kann protokolliert, gemessen und nachverfolgt werden, ohne darauf angewiesen zu sein, dass einzelne Anwendungsteams die Compliance-Logik korrekt implementieren.
Dies ist unerlässlich für Umgebungen, die GDPR, ITAR, HIPAA oder internen Governance-Standards unterliegen.
On-Premise-GPU-Ressourcen sind begrenzt und teuer. Ohne zentrale Kontrollen können Teams die Inferenzkapazität leicht überbeanspruchen oder uneffiziente Workloads bereitstellen.
Ein LLM Gateway ermöglicht:
Dies ermöglicht es Unternehmen, LLM-Inferenz als verwaltete Ressource und nicht als unkontrollierten Kostenfaktor zu behandeln.
Ein On-Premise-LLM-Gateway ist kein einzelner Dienst. Es ist ein mehrschichtiger Infrastruktur-Stack, der darauf ausgelegt ist, zu steuern, wie in Unternehmensumgebungen auf Modelle zugegriffen, wie sie verwaltet und betrieben werden.
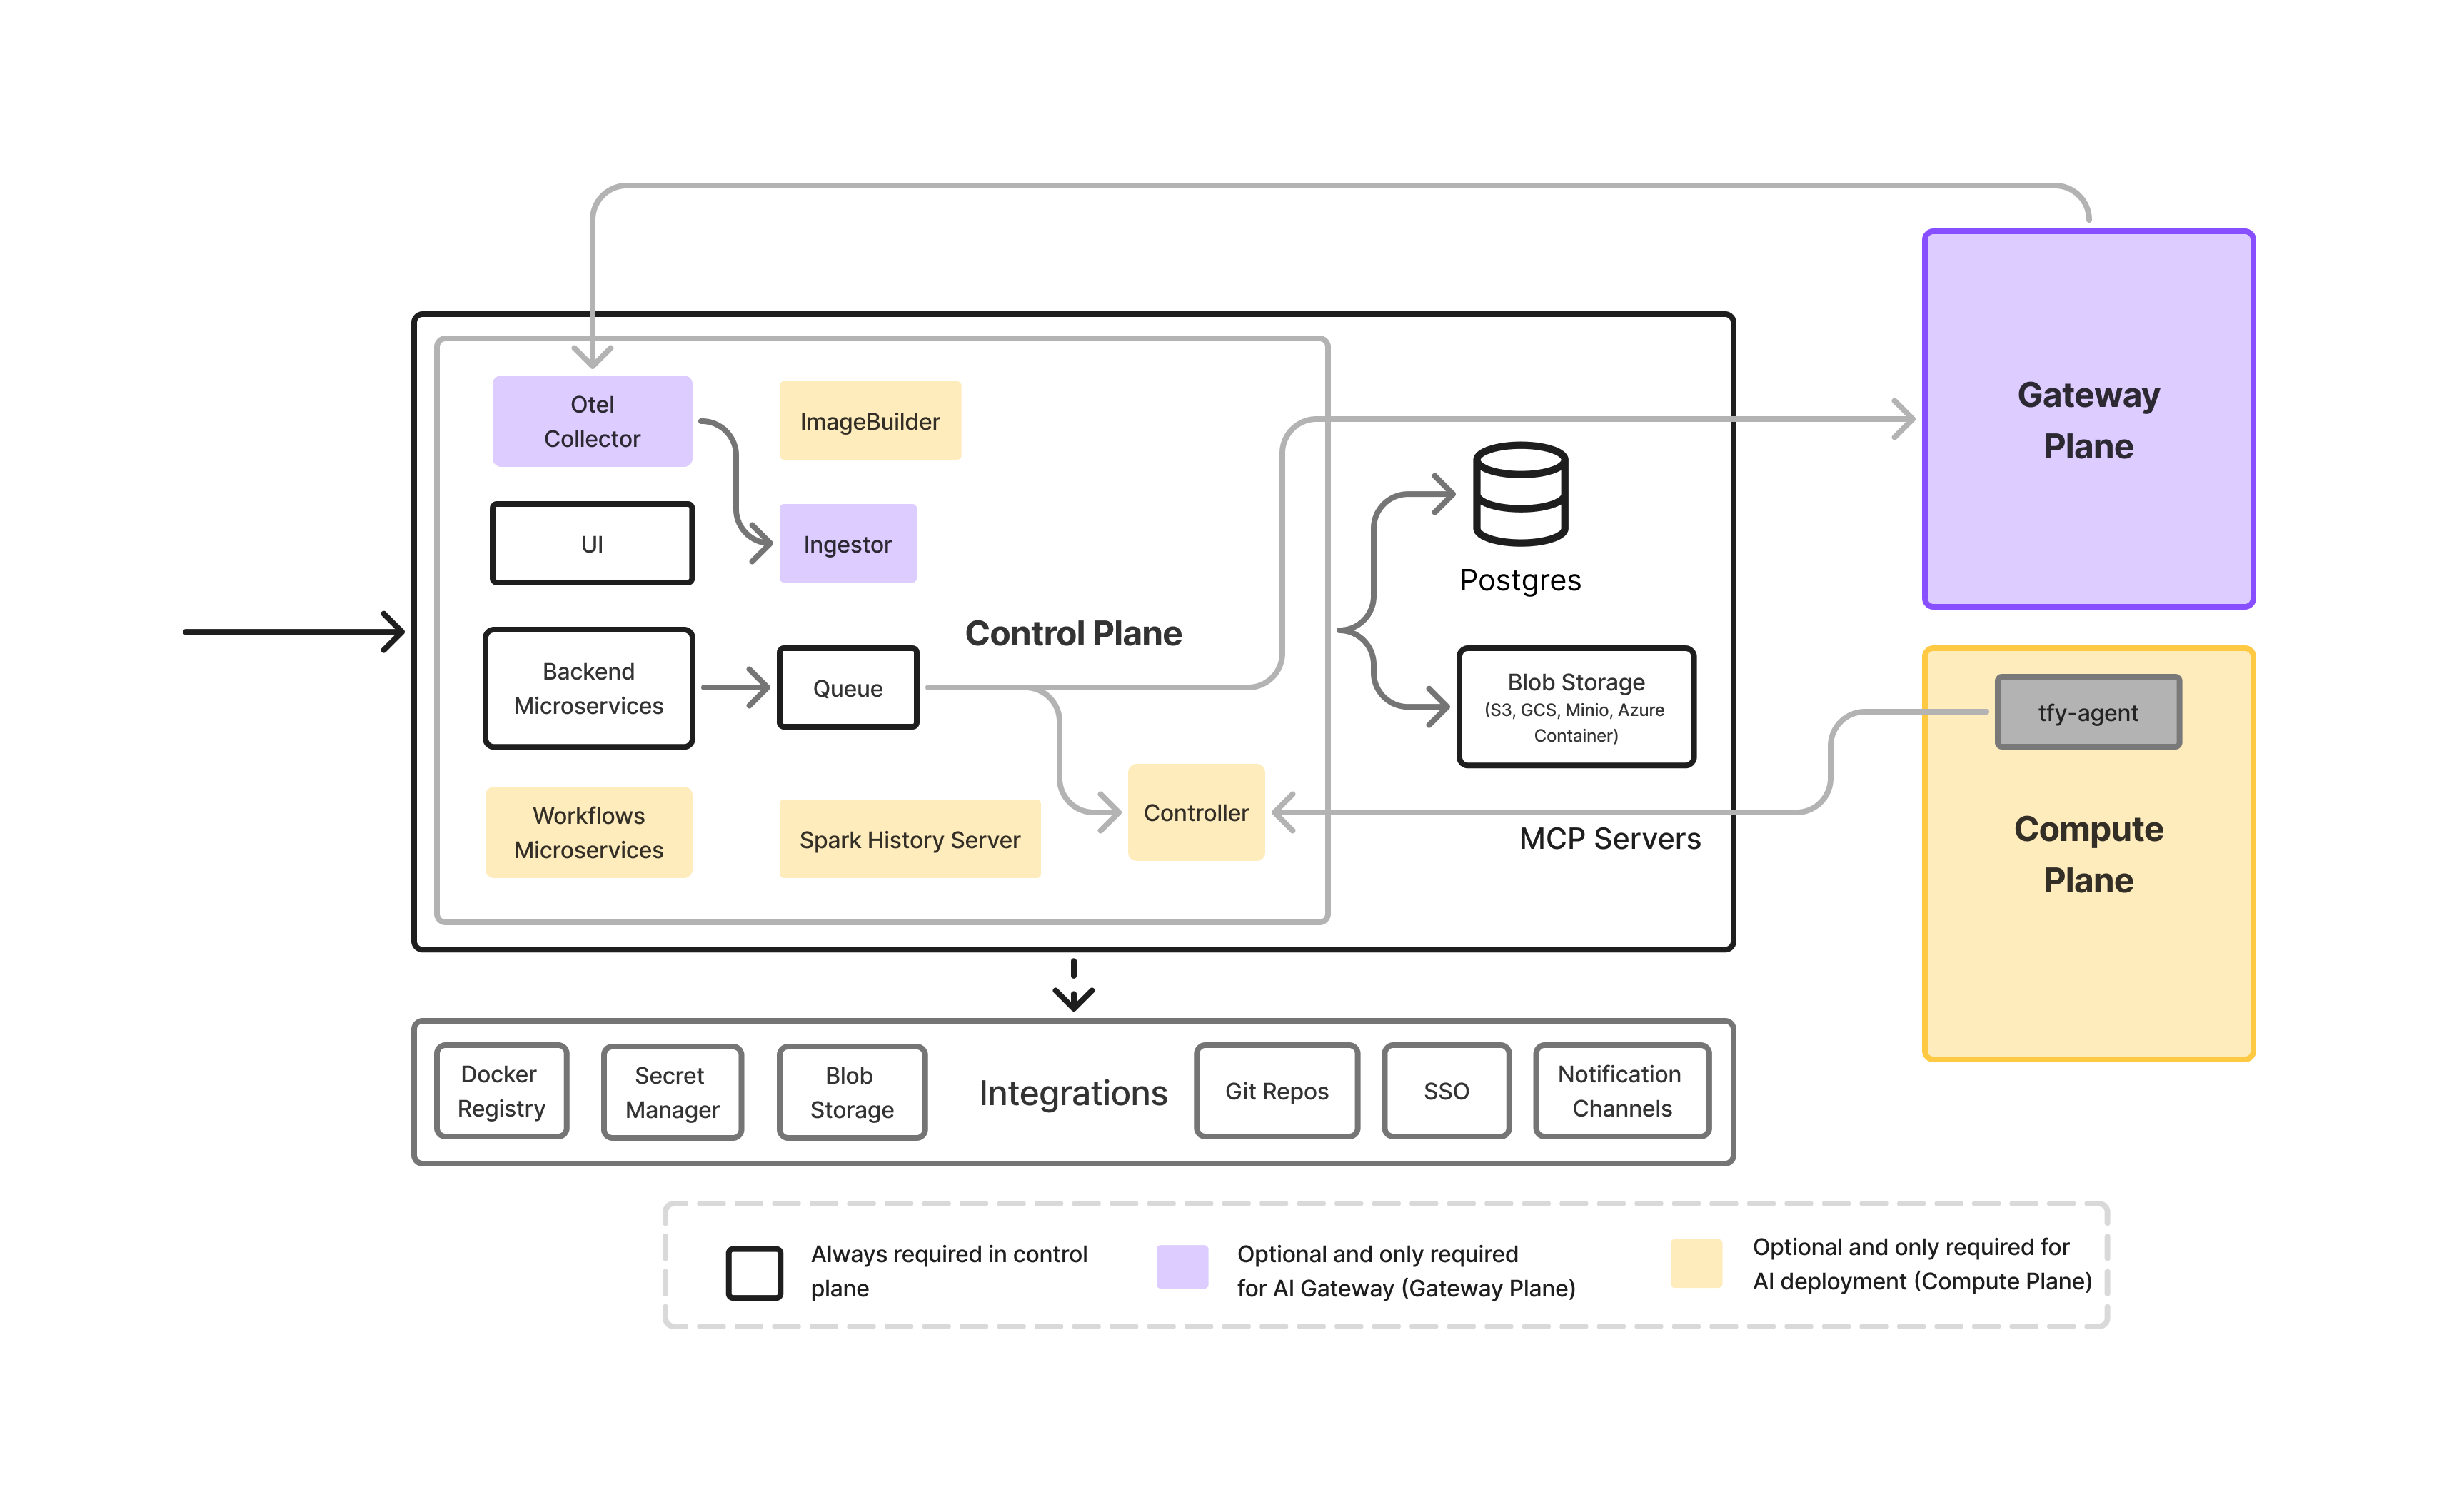
Dies ist der Haupteingang für den gesamten LLM-Datenverkehr.
Sie übernimmt Authentifizierung, Autorisierung, Anfragevalidierung und Routing-Entscheidungen. Durch die zentrale Durchsetzung von Richtlinien nimmt die Control Plane den Anwendungsteams die Notwendigkeit ab, Sicherheits- oder Governance-Logik in ihren Code einzubetten.
Diese Schicht ist für das Model Serving verantwortlich. Sie hostet die tatsächlichen LLMs, die On-Premise laufen, und stellt sie für GPU-beschleunigte Inferenz mit geringer Latenz bereit, einschließlich:
Das Gateway abstrahiert diese Modelle hinter einer einheitlichen API, sodass Teams Modelle ändern oder aktualisieren können, ohne Auswirkungen auf die Anwendungen zu haben.
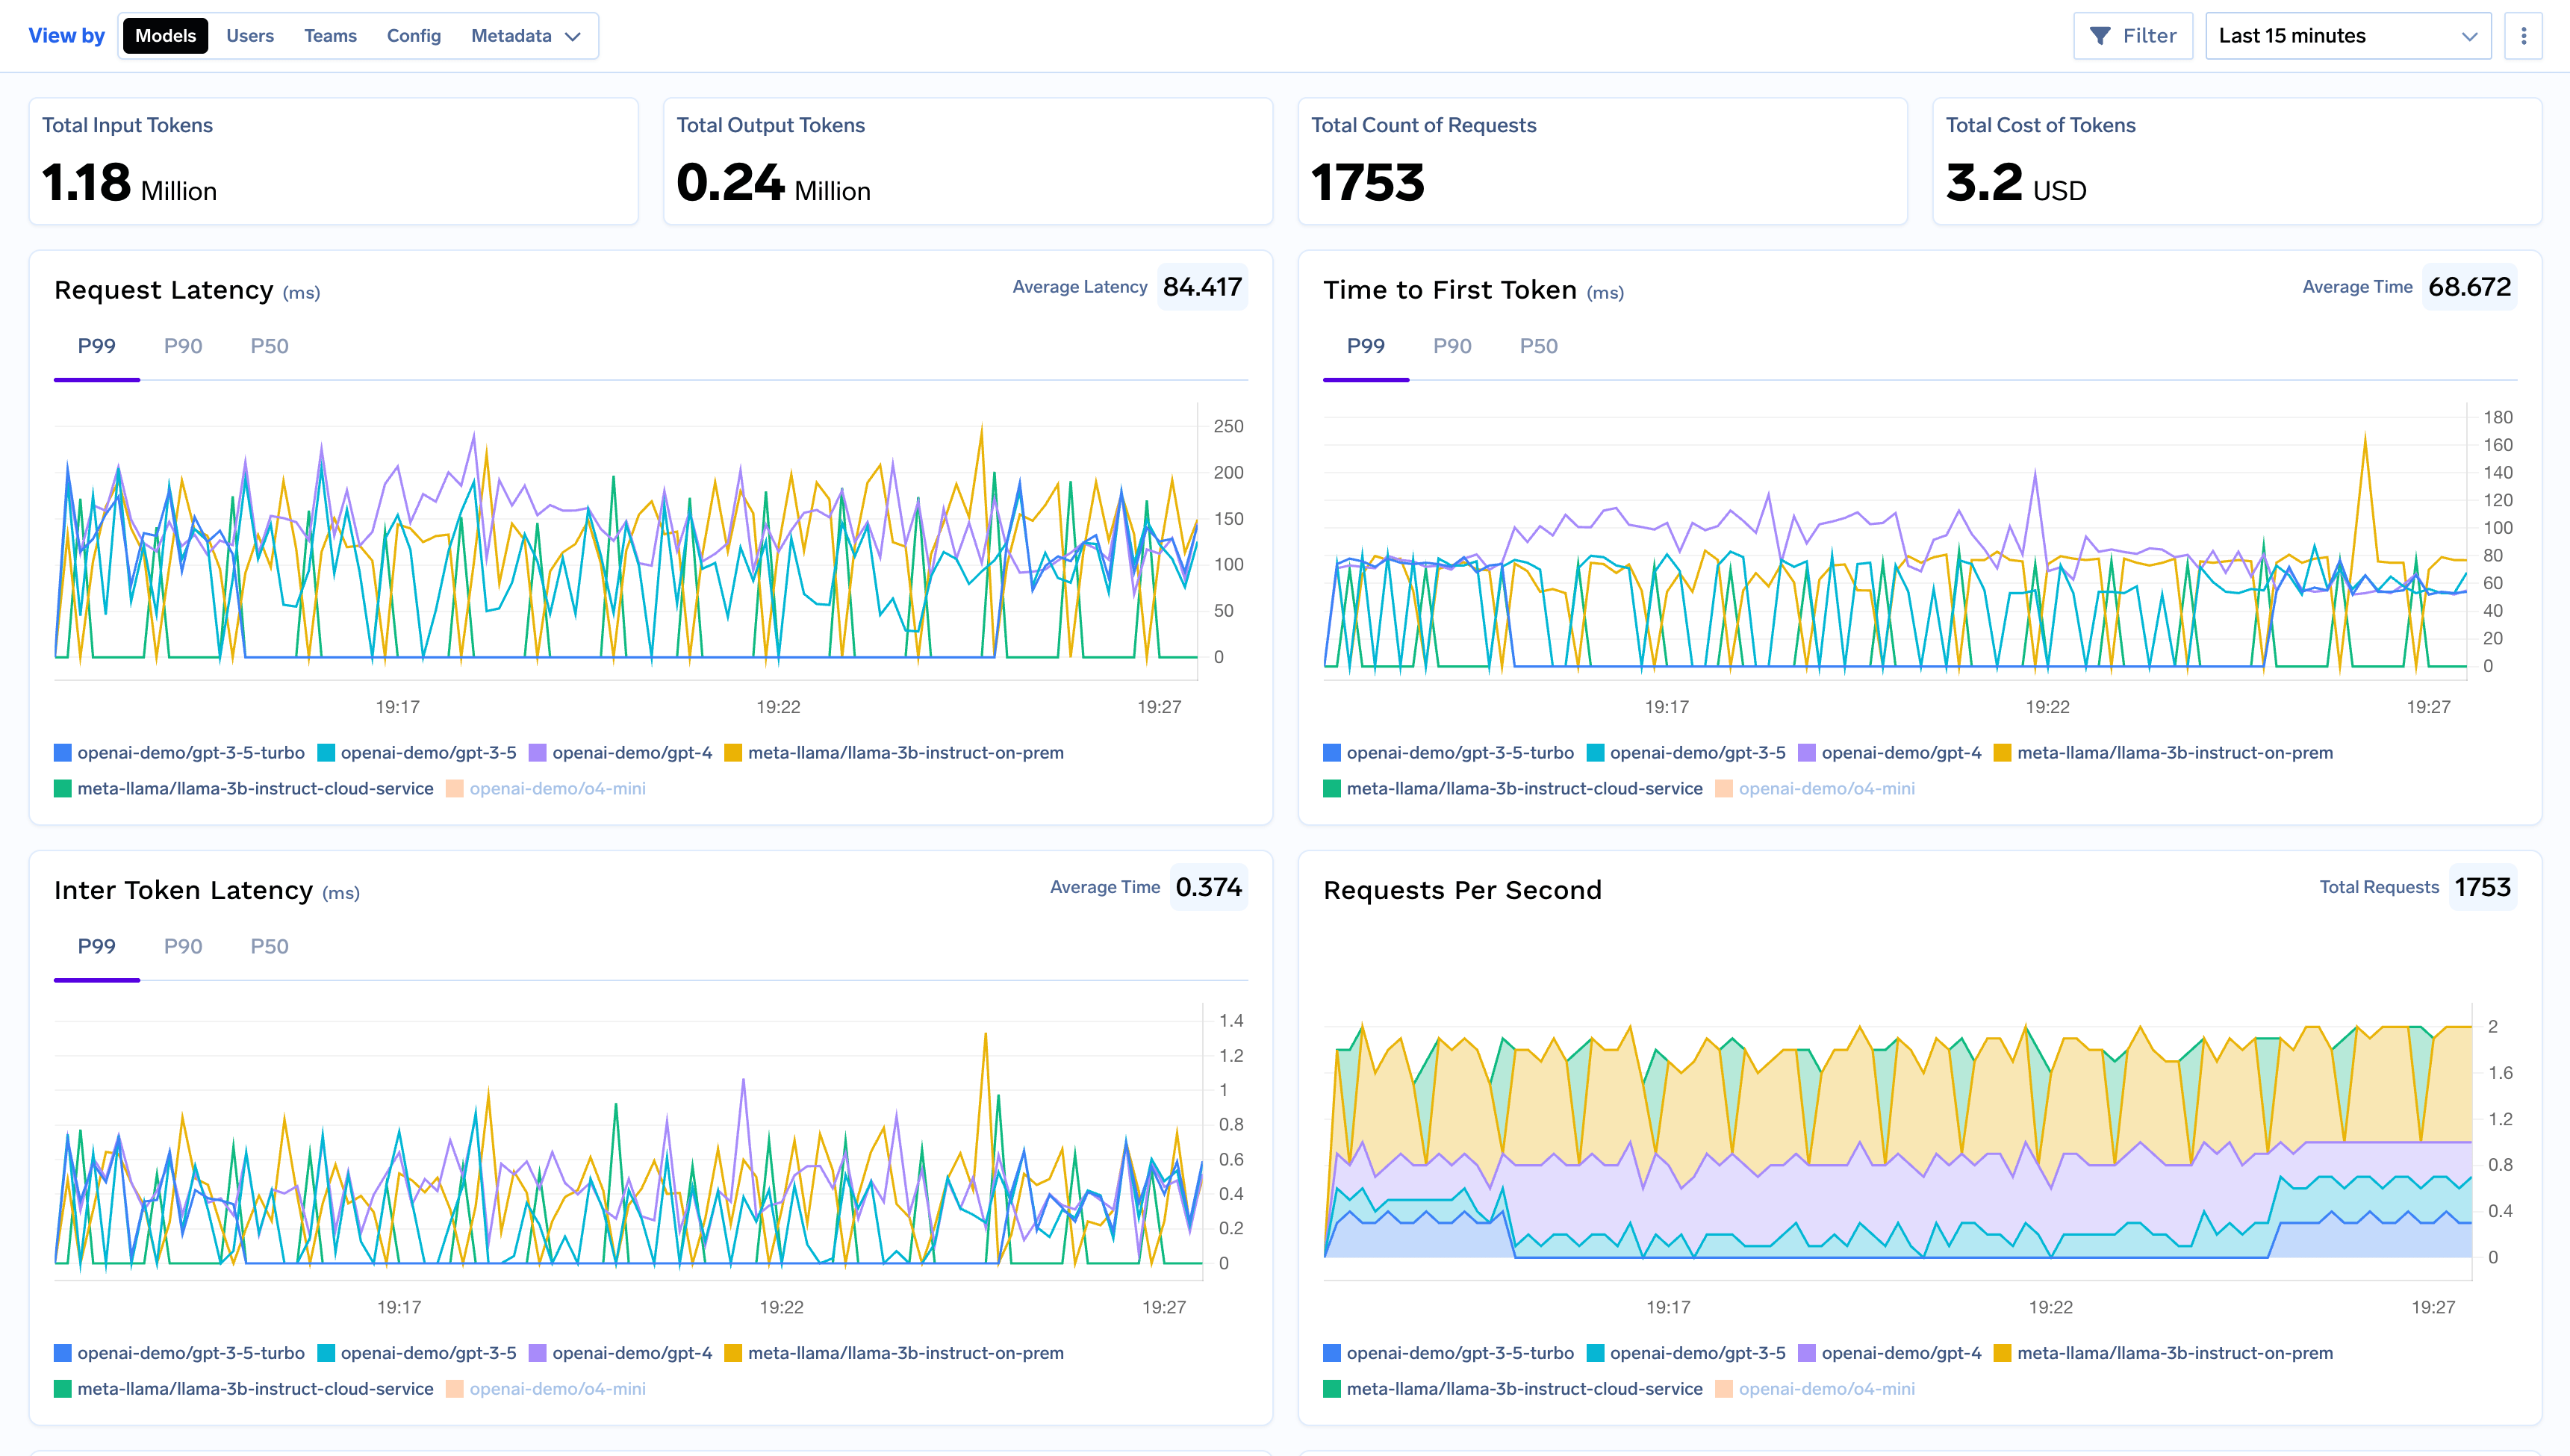
Transparenz ist in On-Premise-Umgebungen mit begrenzten Ressourcen entscheidend.
Das Gateway bietet:
Dies ermöglicht es Teams zu verstehen, wie Modelle genutzt werden, und Leistungs- oder Kostenprobleme frühzeitig zu erkennen.
Governance-Regeln werden einmal definiert und überall durchgesetzt.
Dies umfasst:
Zentralisierte Governance verhindert ein Abweichen der Richtlinien (Policy Drift) über Teams und Anwendungen hinweg.
Das Gateway und die Modell-Dienste laufen in der Regel auf Kubernetes-basierter Infrastruktur mit GPU-Unterstützung. Diese Schicht bietet:
Sie stellt sicher, dass das Gateway als Teil des breiteren On-Premise-KI-Stacks zuverlässig arbeitet.
In einem On-Premise-Setup fungiert das LLM Gateway als zentrale Steuerungsschicht zwischen Anwendungen und selbst gehosteten Modellen. Alle Anfragen passieren diese Schicht, was eine konsistente Sicherheit, Governance und Observability gewährleistet.
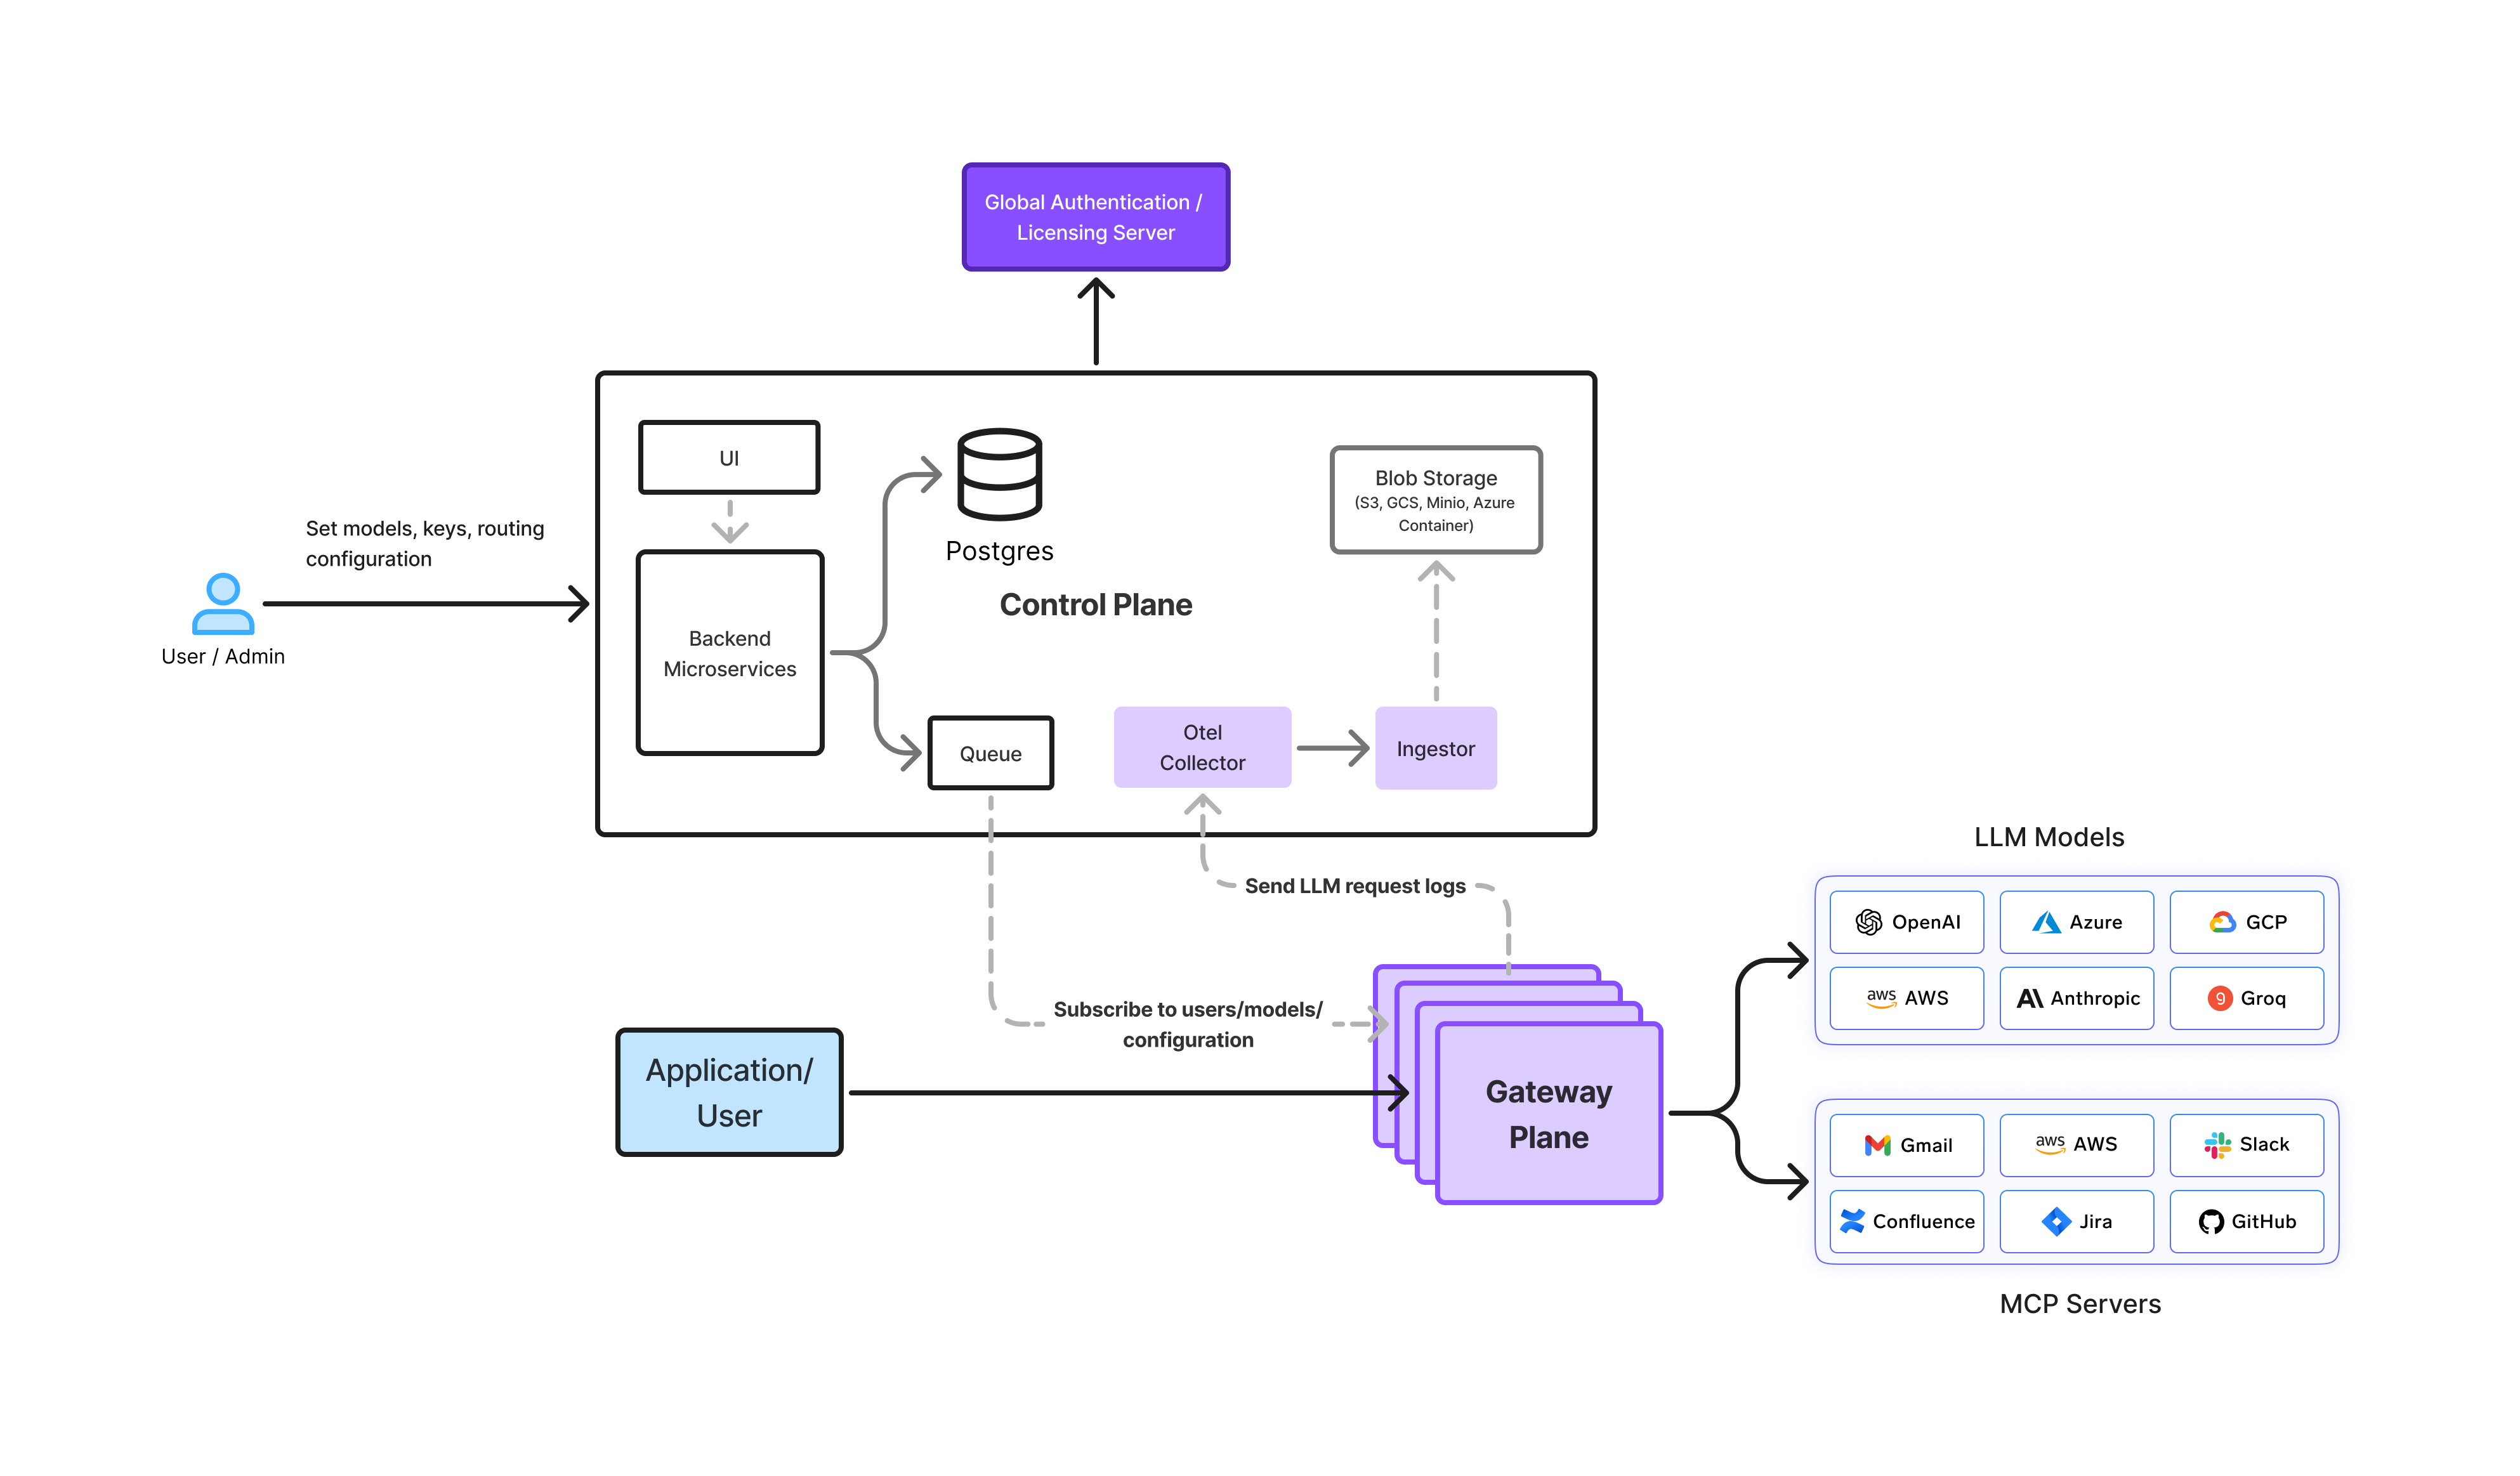
Unternehmen stellen On-Premise-LLM-Gateways je nach Sicherheits-, Compliance- und Konnektivitätsanforderungen auf unterschiedliche Weise bereit. Die Gateway-Architektur bleibt dabei dieselbe, nur das Bereitstellungsmodell ändert sich.
In hochregulierten Umgebungen arbeitet die Infrastruktur ohne externen Netzwerkzugriff.
In diesen Setups bietet das LLM Gateway vollständige Kontrolle bei gleichzeitiger Einhaltung strenger Isolationsanforderungen.
Viele Unternehmen stellen LLM-Gateways innerhalb ihrer eigenen Cloud-Accounts oder privaten Netzwerke bereit.
Dieses Modell ist typisch für regulierte SaaS- und Finanzdienstleistungsunternehmen.
Einige Organisationen teilen Workloads basierend auf der Sensibilität auf.
Das Gateway gewährleistet konsistente Richtlinien, selbst wenn mehrere Ausführungsumgebungen beteiligt sind.
Während On-Premise-LLM-Gateways Kontrolle und Compliance bieten, bringen sie auch betriebliche Herausforderungen mit sich, die Unternehmen einplanen müssen.
Die Verwaltung GPU-gestützter Inferenz-Workloads On-Premise erfordert eine sorgfältige Kapazitätsplanung. Ohne Automatisierung kann die Skalierung von Modellen oder die Bewältigung von Lastspitzen betrieblich aufwendig werden.
On-Premise-Umgebungen verfügen über begrenzte Rechenkapazität. Schlechtes Routing oder fehlende Anfragekontrollen können zu Latenzproblemen oder unzureichend ausgelasteten GPUs führen. Ein zentralisiertes Traffic-Management ist essenziell, um Leistung und Effizienz auszubalancieren.
Wenn mehrere Teams LLMs einführen, können Governance-Regeln leicht abweichen, wenn sie auf Anwendungsebene durchgesetzt werden. Die Aufrechterhaltung konsistenter Zugriffskontrollen und Nutzungsrichtlinien über verschiedene Umgebungen hinweg ist ohne ein zentrales Gateway schwierig.
Unternehmen müssen klare Aufzeichnungen über die LLM-Nutzung führen, ohne den Speicher zu überlasten oder die Leistung zu beeinträchtigen. Die richtige Balance zwischen Observability und Overhead zu finden, ist eine häufige Herausforderung.
Unternehmen, die mit On-Premise-LLM-Bereitstellungen erfolgreich sind, behandeln das Gateway als Kerninfrastruktur und nicht nur als API-Proxy.
Alle Anwendungen und Agenten sollten ausschließlich über das Gateway auf Modelle zugreifen. Dies eliminiert Schatten-Integrationen und stellt eine einheitliche Sicherheit und Governance sicher.
Anwendungen sollten niemals von spezifischen Modell-Endpunkten abhängen. Die Abstraktion von Modellen hinter dem Gateway ermöglicht es Teams, Modelle ohne Codeänderungen auszutauschen, zu aktualisieren oder feinabstimmen.
Zugriffskontrollen, Rate Limits und Nutzungsregeln sollten auf der Gateway-Schicht liegen – nicht in der Anwendungslogik. Dies verhindert ein Abweichen der Richtlinien über Teams und Umgebungen hinweg.
Dev, Staging und Produktion sollten auf Infrastruktur- und Richtlinienebene isoliert sein. Dies reduziert Risiken und macht das Experimentieren sicherer.
Erfassen Sie genügend Telemetriedaten für Auditierbarkeit und Optimierung, während Sie sensible Prompt-Daten bei Bedarf maskieren oder begrenzen. Observability sollte Kontrolle ermöglichen und keine neuen Risiken schaffen.
Die Befolgung dieser Praktiken stellt sicher, dass On-Premise-LLM-Gateways sicher, skalierbar und verwaltbar bleiben, wenn die Nutzung zunimmt.
Da Unternehmen über die Experimentierphase hinausgehen und Large Language Models in Kernsysteme einbetten, wird Kontrolle ebenso wichtig wie Leistungsfähigkeit. On-Premise-Bereitstellungen decken Anforderungen an Datenresidenz, Sicherheit und Compliance ab, aber ohne eine zentralisierte Zugriffsschicht werden sie schnell fragmentiert und schwer zu verwalten.
Eine On-Premise-LLM-Gateway-Infrastruktur bietet diese fehlende Steuerungsschicht. Sie standardisiert die Interaktion von Anwendungen mit Modellen, setzt konsistente Richtlinien durch und liefert die Transparenz, die für den verantwortungsvollen Betrieb von LLMs in großem Maßstab erforderlich ist.
Die Auswahl des besten LLM-Gateways für On-Premise-Bereitstellungen erfordert die Abwägung von Governance, Leistung und betrieblicher Einfachheit, anstatt sich nur auf das Anfrage-Routing zu konzentrieren.
Anstatt selbst gehostete Modelle als isolierte Dienste zu behandeln, verwandeln Organisationen, die einen Gateway-First-Ansatz verfolgen, LLMs in eine verwaltete Unternehmensinfrastruktur – sicher, beobachtbar und bereit für langfristiges Wachstum.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















