August 27, 2025
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
In der letzten Ausgabe haben wir uns mit dem Workflow eines Data Scientists beschäftigt und gezeigt, wo genau Kubernetes als nützliche Basis für den Aufbau einer entsprechenden Plattform dienen kann.
In dieser Ausgabe gehen wir ein einfaches Beispiel durch, um praktische Erfahrungen damit zu sammeln.
Bevor wir beginnen, benötigen wir eine Spielwiese für die Demo. Dazu richten wir einen Kubernetes-Cluster auf dem lokalen Rechner ein. Obwohl ein Cluster für Fehlertoleranz und hohe Verfügbarkeit mehrere Knoten enthalten sollte, werden wir dieses Verhalten mit dem großartigen Tool kind (kubernetes-in-docker) nachbilden.
Am Ende dieses Abschnitts werden wir mehrere Container ausführen haben, wobei jeder Container als separater Cluster-Knoten fungiert.
Folgen Sie den Anweisungen hier
Testen Sie die Installation durch Ausführen von
$ kind --version
kind version 0.14.0
Jetzt starten wir einen lokalen Cluster mit kind. Wir werden eine Control Plane und zwei Worker-Knoten erstellen. Es ist möglich, mehrere von beiden zu haben.
<aside> 💡 Kubernetes kann mehrere Control-Plane- und Worker-Knoten haben. Alle zentralisierten Cluster-Management-Komponenten befinden sich auf den Control-Plane-Knoten, während die Benutzer-Workloads auf den Worker-Knoten laufen. Lesen Sie hier mehr darüber.
</aside>
Erstellen Sie zunächst eine kind-Konfiguration in einer Datei namens kind-config.yaml. Sie finden sie hier. Dies definiert die Struktur unseres Clusters –
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
nodes:
- role: control-plane
- role: worker
- role: worker
Hier haben wir drei Knoten definiert, wobei einer die Rolle der Control Plane übernimmt und die anderen beiden als Worker-Knoten dienen.
Starten Sie einen Cluster mit dieser Konfiguration. Dies kann etwas Zeit in Anspruch nehmen. Stellen Sie sicher, dass der Docker-Daemon auf Ihrem System läuft, bevor Sie dies ausführen –
$ kind create cluster --config kind-config.yaml
...
Thanks for using kind! 😊
kubectl ausführen, um sicherzustellen, dass unser Cluster einsatzbereit ist –$ kubectl cluster-info
Kubernetes control plane is running at <https://127.0.0.1:63122>
CoreDNS is running at <https://127.0.0.1:63122/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy>
...
Das bestätigt uns, dass der Cluster tatsächlich läuft. Wir können auch die einzelnen Container sehen, die als Knoten fungieren, indem wir docker ps ausführen.
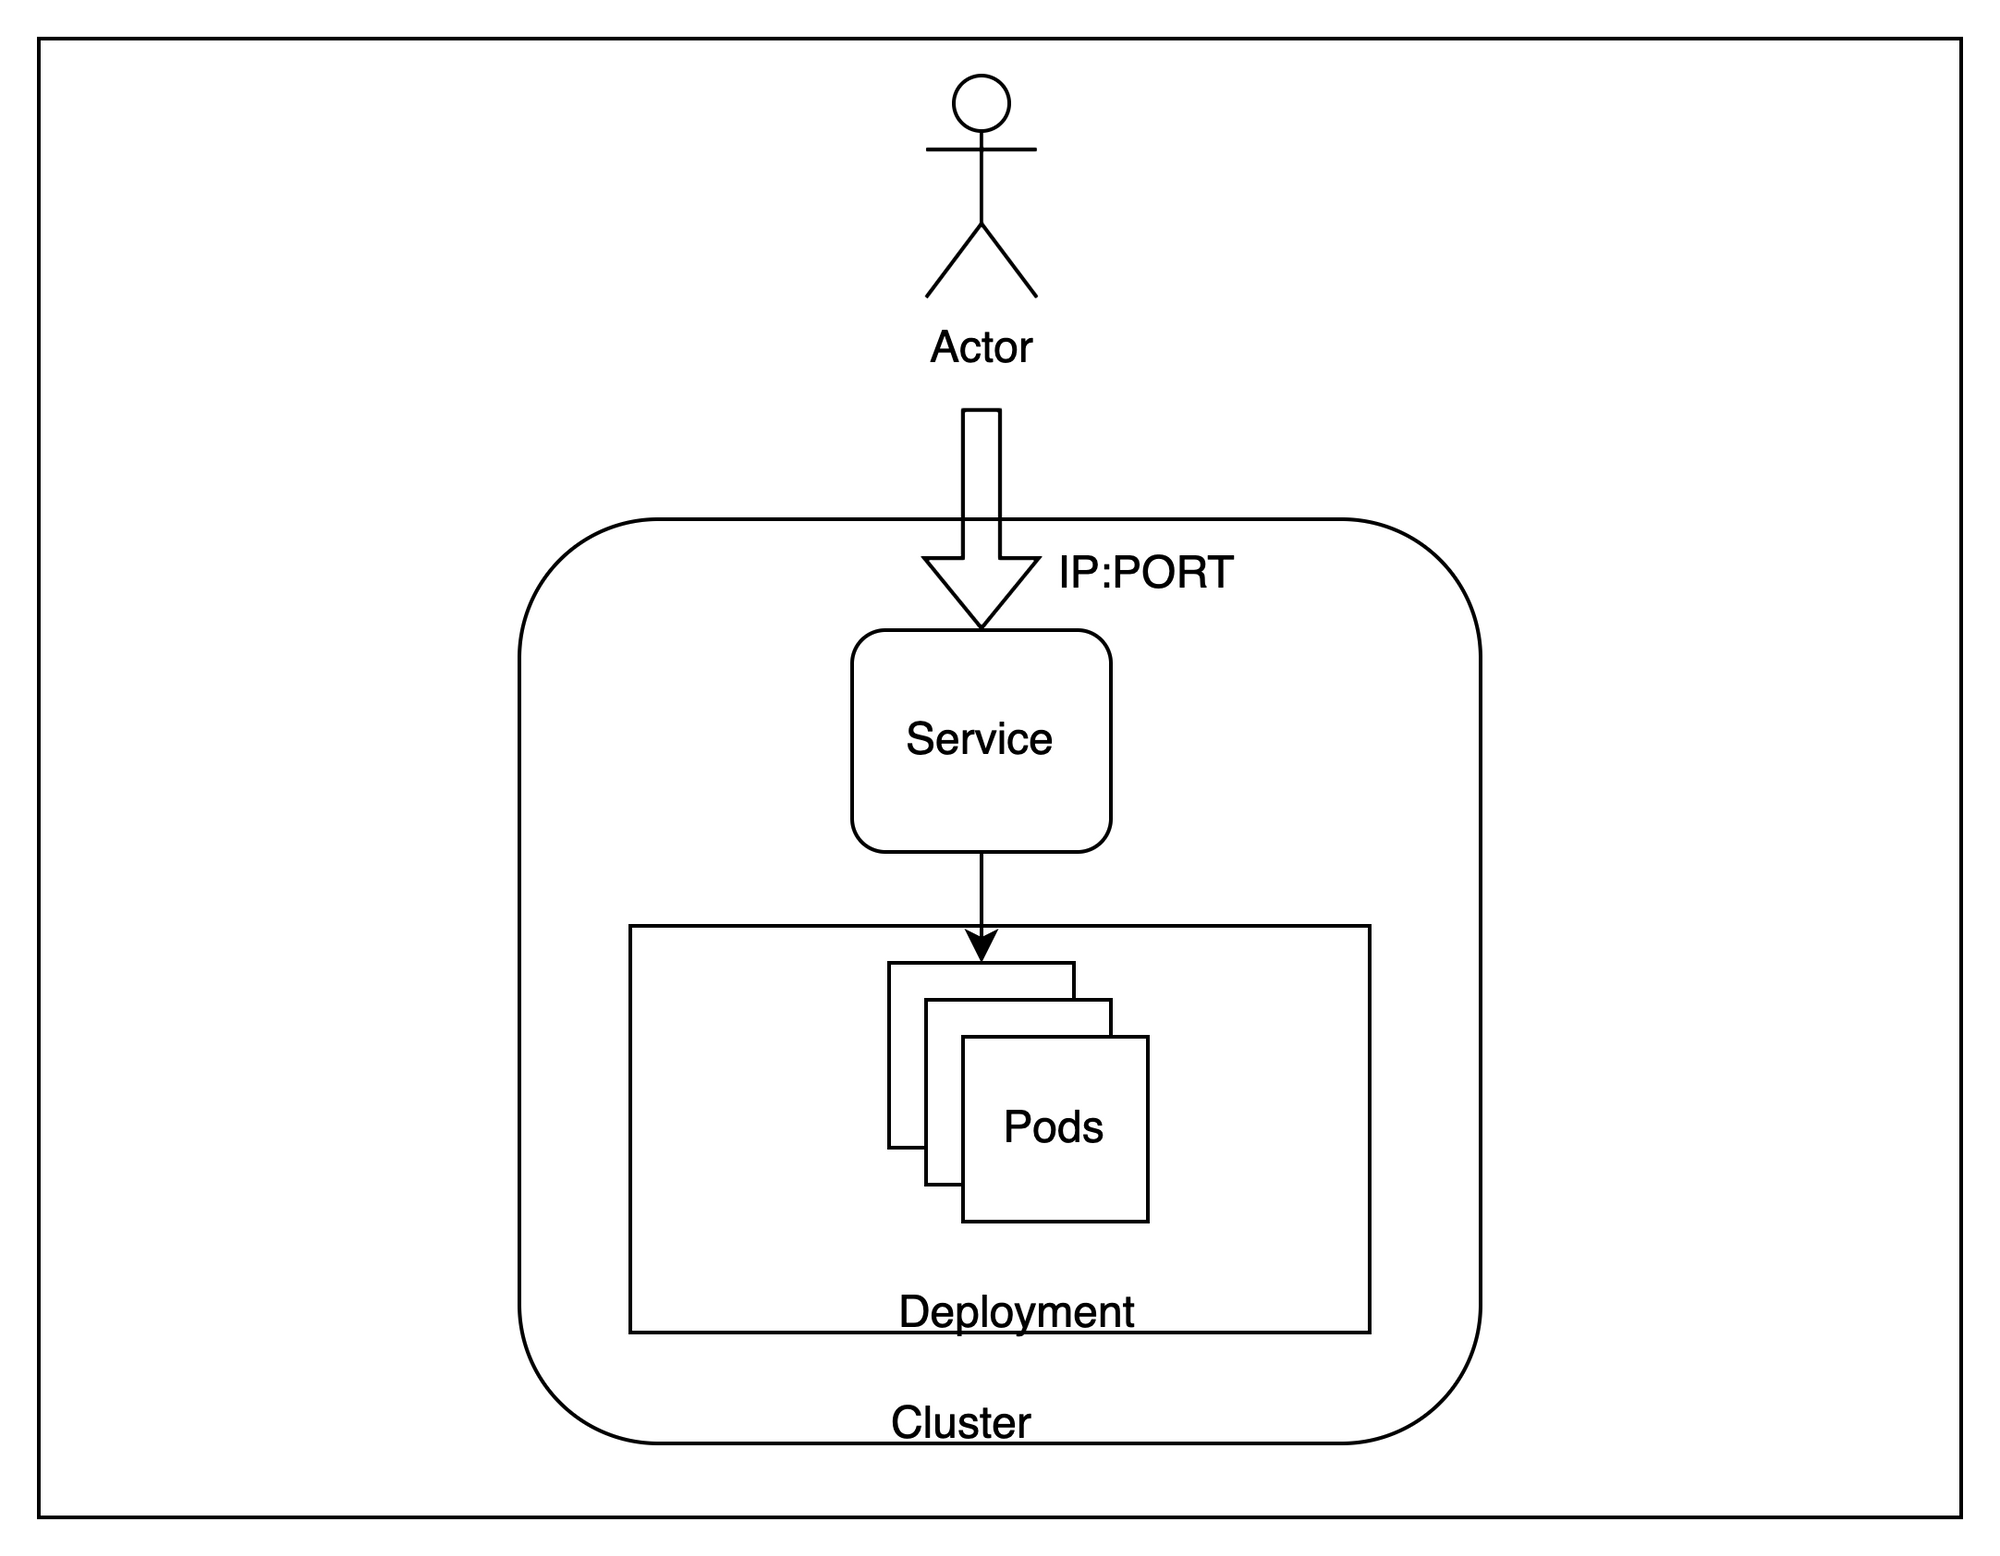
Da unser Cluster nun läuft, werfen wir einen Blick auf die allgemeine Architektur dessen, was wir bereitstellen möchten.
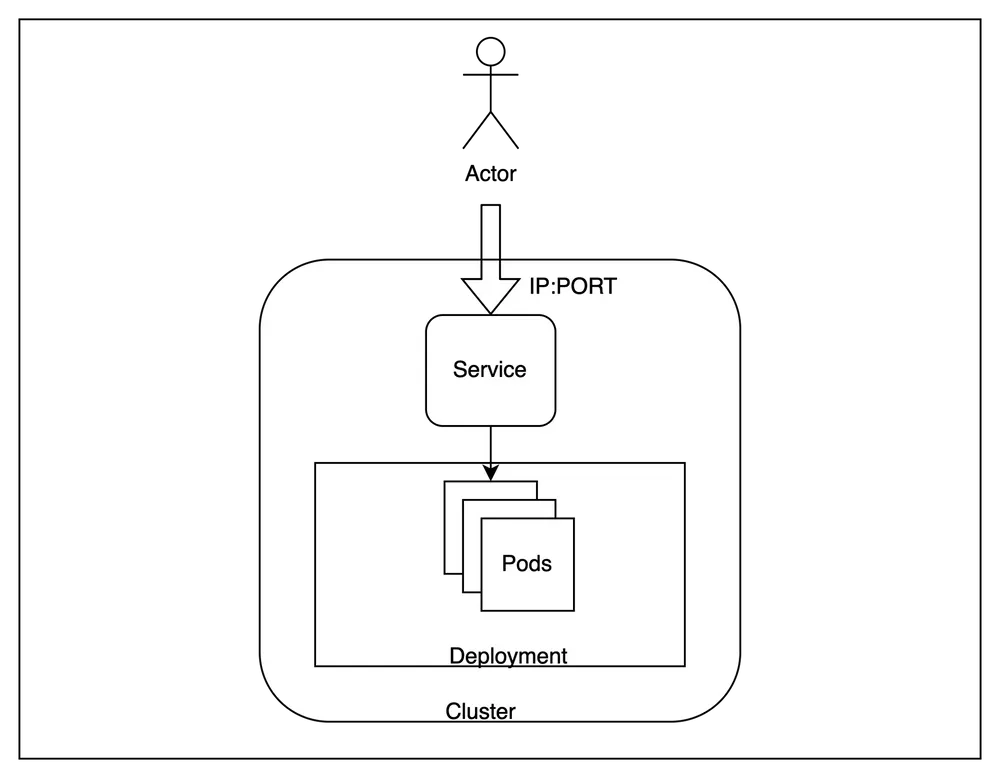
Im Allgemeinen werden wir mehrere Replikate unserer Anwendung innerhalb des Clusters hosten und versuchen, von außen darauf zuzugreifen, wobei die Anfragen über die verschiedenen Instanzen hinweg lastverteilt werden.
Um dies zu erreichen, gibt es einige Kubernetes-spezifische Begriffe, die wir kennen müssen –
Pod – Pods sind die kleinsten bereitstellbaren Recheneinheiten, die Sie in Kubernetes erstellen und verwalten können. In unserem Fall läuft eine Instanz der Anwendung in einem unabhängigen Pod. Dies sind ephemere Ressourcen, und die Control Plane kann sie bei Bedarf über Knoten hinweg verschieben.Deployment – Ein Deployment ist nützlich, wenn wir mehr als ein Replikat für eine Anwendung haben möchten. Kubernetes versucht immer, die Anzahl der Replikate auf dem Wert zu halten, der in einem Deployment angegeben ist. Wir werden drei identische Replikate für unsere Anwendung erstellen.Service – Ein Service ist nützlich für die Lastverteilung über eine Gruppe von Pods, die im Cluster laufen. Da Pods im Wesentlichen ephemeral sind und jederzeit ersetzt werden können, bietet ein Service eine stabile Schnittstelle für den Zugriff auf die dahinter liegenden Pods. Wir werden einen Service verwenden, um unsere Anwendung zu testen.Diese drei Ressourcen ermöglichen es uns, einen skalierbaren Endpunkt für die Bereitstellung unserer Anwendung zu hosten.
Nachdem der Cluster einsatzbereit ist, können wir nun eine Anwendung bereitstellen und testen. Wir werden eine Anwendung mit dem beliebten Iris-Klassifizierungs-Datensatz erstellen.
Das Repository ist verfügbar unter https://github.com/shubham-rai-tf/iris-classifier-kubernetes. Es enthält bereits den Code zum Erstellen und Bereitstellen von Vorhersagen am /iris/classify_iris-Endpunkt unter Verwendung von fastapi.
Wir müssen diesen Code in einem Docker-Image verpacken, um ihn für kubernetes vorzubereiten. Eine Dockerfile ist im Repository dafür bereitgestellt – hier.
Diese Dockerfile gibt das Image an, das wir benötigen, um einen Container zu erstellen, der die Vorhersage-Endpunkte auf einem uvicorn-Server an Port 5000 hostet. Weitere Details zur Syntax finden Sie hier.
Führen Sie diesen Befehl aus, um ein lokales Image zu bauen –
$ docker build . -t iris-classifier:poc
...
$ docker image ls
REPOSITORY       TAG  IMAGE ID      CREATED         SIZE
iris-classifier  poc  549913d5b1f9  12 seconds ago  737MB
Wir können sehen, dass das Image erfolgreich mit dem Namen iris-classifier und dem Tag poc erstellt wurde. Wir werden dieses Image nun in den Cluster laden, um es innerhalb des Clusters zu verwenden.
<aside> 💡 Dieser Schritt ist nur erforderlich, weil wir keine Image Registry haben, aus der das neu gebaute Image gezogen werden kann. In der Produktion sollte das Image in einer privaten Registry wie Dockerhub oder AWS ECR gehostet und dann direkt in den Cluster gezogen werden.
</aside>
Führen Sie diesen Befehl aus, um das lokal gebaute Image in den Cluster zu laden –
$ kind load docker-image iris-classifier:poc
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-worker2", loading...
Image: "iris-classifier:poc" with ID "sha256:549913d5b1f9456a4beedc73e04c3c0ad70da8691a8745a6b56a4f483c4f0862" not yet present on node "kind-control-plane", loading...
...
Sie können überprüfen, ob die Images geladen wurden, indem Sie die Images in einem der drei Container auflisten –
$ docker exec -it kind-worker crictl images
IMAGE                                TAG    IMAGE ID         SIZE
docker.io/library/iris-classifier    poc    549913d5b1f94    753MB
Kubernetes ist im Wesentlichen ein deklaratives System. Das bedeutet, wir beschreiben die Konturen dessen, was wir tun möchten, und die Komponenten der Control Plane führen das System kontinuierlich darauf hin, diesen Zustand zu erreichen.
Um die zuvor besprochene Architektur zu implementieren, beschreiben wir unsere Absicht in Form einer yaml-Datei, die als Absichtserklärung dient. In der Kubernetes-Sprache werden diese als manifests bezeichnet.
Alle Kubernetes-Manifeste enthalten die folgenden Felder –
apiVersion – Mehrere Ressourcen werden in denselben API-Versionen gruppiert. Dies bietet eine standardisierte Möglichkeit, eine Ressource über Kubernetes-Versionen hinweg als veraltet zu markieren oder zu fördern.kind – Identifiziert den genauen Objekttyp, der erstellt werden sollmetadata – Enthält Felder, die als Metadaten für das erstellte Objekt dienen. Die Felder apiVersion, kind und metadata.name identifizieren zusammen eine eindeutige Ressource innerhalb eines namespacespec – Dieses Feld enthält die Spezifikation für das zu erstellende Objekt. Jede Kind definiert ihre eigene Struktur für dieses Feld mit ihrer eigenen Implementierung.Wir werden die Manifeste verwenden, die im Repository in Dateien innerhalb des Verzeichnisses manifests hier vorhanden sind.
Es definiert zwei Kubernetes-Ressourcen, Deployment und Service, in deployment.yaml bzw. service.yaml. Gehen wir beide Abschnitte durch.
apiVersion: apps/v1
kind: Deployment
spec:
	# number of replicas
  replicas: 3
  template:
    spec:
      containers:
			# name of the image
      - image: iris-classifier:poc
        name: iris-classifier
Das Deployment-Manifest in deployment.yaml definiert hauptsächlich die Pod-Spezifikation, die wir bezüglich des Image-Namens und der Anzahl der Replikate bereitstellen möchten. Sobald wir dies anwenden, wird Kubernetes kontinuierlich Schritte unternehmen, um die Anzahl der Replikate auf dem hier angegebenen Wert zu halten.
apiVersion: v1
kind: Service
spec:
	# Type of the service
  type: ClusterIP
  ports:
	# Port where the service will be accessible
  - port: 8080
		# Port on the container where the traffic is to be forwarded
    targetPort: 5000
    protocol: TCP
  selector:
    app: iris-classifier
Das Service-Manifest in service.yaml definiert, wie die Lastverteilung über die vom Deployment erstellten Replikate erfolgen soll. Hier haben wir definiert, wie der Port am Service dem Port an den Containern zugewiesen werden soll. Da unsere Anwendung an Port 5000 läuft, ist der targetPort auf 5000 eingestellt. Der Service ist an Port 8080 exponiert. TCP-Datenverkehr, der an 8080 gesendet wird, wird über Port 5000 auf den Containern lastverteilt.
Führen Sie den folgenden Befehl aus, um die Manifeste auf Kubernetes anzuwenden –
$ kubectl apply -f manifests/
deployment.apps/iris-classifier created
service/iris-classifier created
Beide Ressourcen wurden erfolgreich im Cluster erstellt. Wir können dies durch Ausführen der folgenden Befehle überprüfen –
$ kubectl get service iris-classifier
NAME              TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)    AGE
iris-classifier   ClusterIP   10.96.107.238   <none>        8080/TCP   37m
$ kubectl get deployment iris-classifier
NAME              READY   UP-TO-DATE   AVAILABLE   AGE
iris-classifier   3/3     3            3           38m
$ kubectl get pods
NAME                               READY   STATUS    RESTARTS   AGE
iris-classifier-5d97498ff9-77wqw   1/1     Running   0          39m
iris-classifier-5d97498ff9-8twjm   1/1     Running   0          39m
iris-classifier-5d97498ff9-znrz8   1/1     Running   0          39m
Wie wir sehen können, ist der Service an Port 8080 exponiert, und es wurden drei Pods wie von uns angegeben erstellt.
Ändern Sie deployment.yaml so, dass 2 Replikate anstelle von 3 vorhanden sind, und wenden Sie es erneut an. Kubernetes wird eines der Replikate löschen, um der Spezifikation zu entsprechen.
Nachdem die Ressourcen im Cluster erstellt wurden, können wir unsere Bereitstellung überprüfen, indem wir das Modell über den Service-Endpunkt aufrufen. Da wir ein lokales Setup verwenden, müssen wir ein port-forward des Service auf einen Port der lokalen Maschine durchführen.
<aside> 💡 In einem Cloud-Provider-Setup wird dieser Service an einen externen Load Balancer gebunden, auf den bei Bedarf über das Internet zugegriffen werden kann.
</aside>
Führen Sie den folgenden Befehl aus, um Port-Forwarding für den Service durchzuführen –
$ kubectl port-forward services/iris-classifier 8080
Forwarding from 127.0.0.1:8080 -> 5000
Forwarding from [::1]:8080 -> 5000
Wir können dies überprüfen, indem wir den /healthcheck-Endpunkt des Modells aufrufen –
$ curl '<http://localhost:8080/healthcheck>'
"Iris classifier is ready!"
Um eine Testvorhersage durchzuführen, senden wir eine Beispielsowie eine Eingabe, um eine Vorhersage zu erhalten –
$ curl '<http://localhost:8080/iris/classify_iris>' -X POST \\
	-H 'Content-Type: application/json' \\
	-d '{"sepal_length": 2, "sepal_width": 4, "petal_length": 2, "petal_width": 4}'
{"class":"setosa","probability":0.99}
Wir erhalten eine Vorhersage der Klasse setosa mit einer Wahrscheinlichkeit von 99 %. Durch das Ausführen mehrerer dieser Vorhersagen können wir überprüfen, ob die Anfragen tatsächlich im Round-Robin-Verfahren an verschiedene Pods weitergeleitet werden.
Lassen Sie uns zuerst alle Kubernetes-Ressourcen entfernen, die wir installiert haben –
$ kubectl delete -f manifests/
Dadurch werden alle Kubernetes-Ressourcen bereinigt, die wir in den vorherigen Abschnitten erstellt haben. Nun können wir auch den Cluster herunterfahren –
$ kind delete cluster
Deleting cluster "kind" ...
In dieser Ausgabe haben wir behandelt, wie man ein Modell als aufrufbaren Service in Kubernetes hostet. Obwohl dies ein einfaches Beispiel war, bei dem wir lokal ein Docker-Image gebaut und auf einem Cluster auf derselben Maschine ausgeführt haben, funktioniert ein typisches Produktions-Setup nach ähnlichen Prinzipien. Bereits mit diesen zwei Ressourcen lässt sich viel erreichen.
In den folgenden Ausgaben werden wir weitere fortgeschrittene Funktionen wie Mandantenfähigkeit und Zugriffskontrolle erkunden, die für den regulären Betrieb unerlässlich werden.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet