



October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Da sich die Einsatzmöglichkeiten für Machine Learning in den letzten Jahren stark erweitert haben, ist auch die Notwendigkeit gewachsen, die Prozesse rund um das Training, die Bereitstellung und die Überwachung dieser Modelle zu skalieren. Viele dieser Herausforderungen ähneln denen, die für allgemeine Software-Anwendungsfälle bereits „gelöst“ wurden. Kubernetes ist eine solche Open-Source-Software, die das Cloud-Native-Ökosystem um sich herum konsolidiert hat, indem sie als zugrundeliegende Plattform dient.
Daher ist es unerlässlich zu untersuchen, ob es sinnvoll ist, Kubernetes für Machine-Learning-Anwendungsfälle zu nutzen. Beginnen wir zunächst mit Kubernetes selbst und der Frage, was daran so interessant ist.
Quelle: Kubernetes
💡 Kubernetes ist eine Open-Source-Container-Orchestrierungs-Engine zur Automatisierung der Bereitstellung, Skalierung und Verwaltung von containerisierten Anwendungen.
Einfacher ausgedrückt bietet Kubernetes eine einfache und standardisierte Möglichkeit, Workloads auszuführen und zu betreiben, die dynamisch über mehrere Maschinen hinweg skaliert werden müssen.
Gehen wir einige der beliebtesten Funktionen durch -
Dies sind nur einige der Funktionen, die standardmäßig verfügbar sind. Eine große Anzahl von Anwendungsfällen wird tatsächlich durch Tools gelöst, die mit Kubernetes als zugrundeliegender Schicht gebaut wurden. Auf spezifische Tools werden wir in einer folgenden Ausgabe näher eingehen.
Nachdem wir verstanden haben, was Kubernetes ist und welche Hauptfunktionen es in einem Softwareentwicklungsszenario bietet, wollen wir uns nun den spezifischen Problemen widmen, die es im Workflow eines Data Scientists lösen kann.
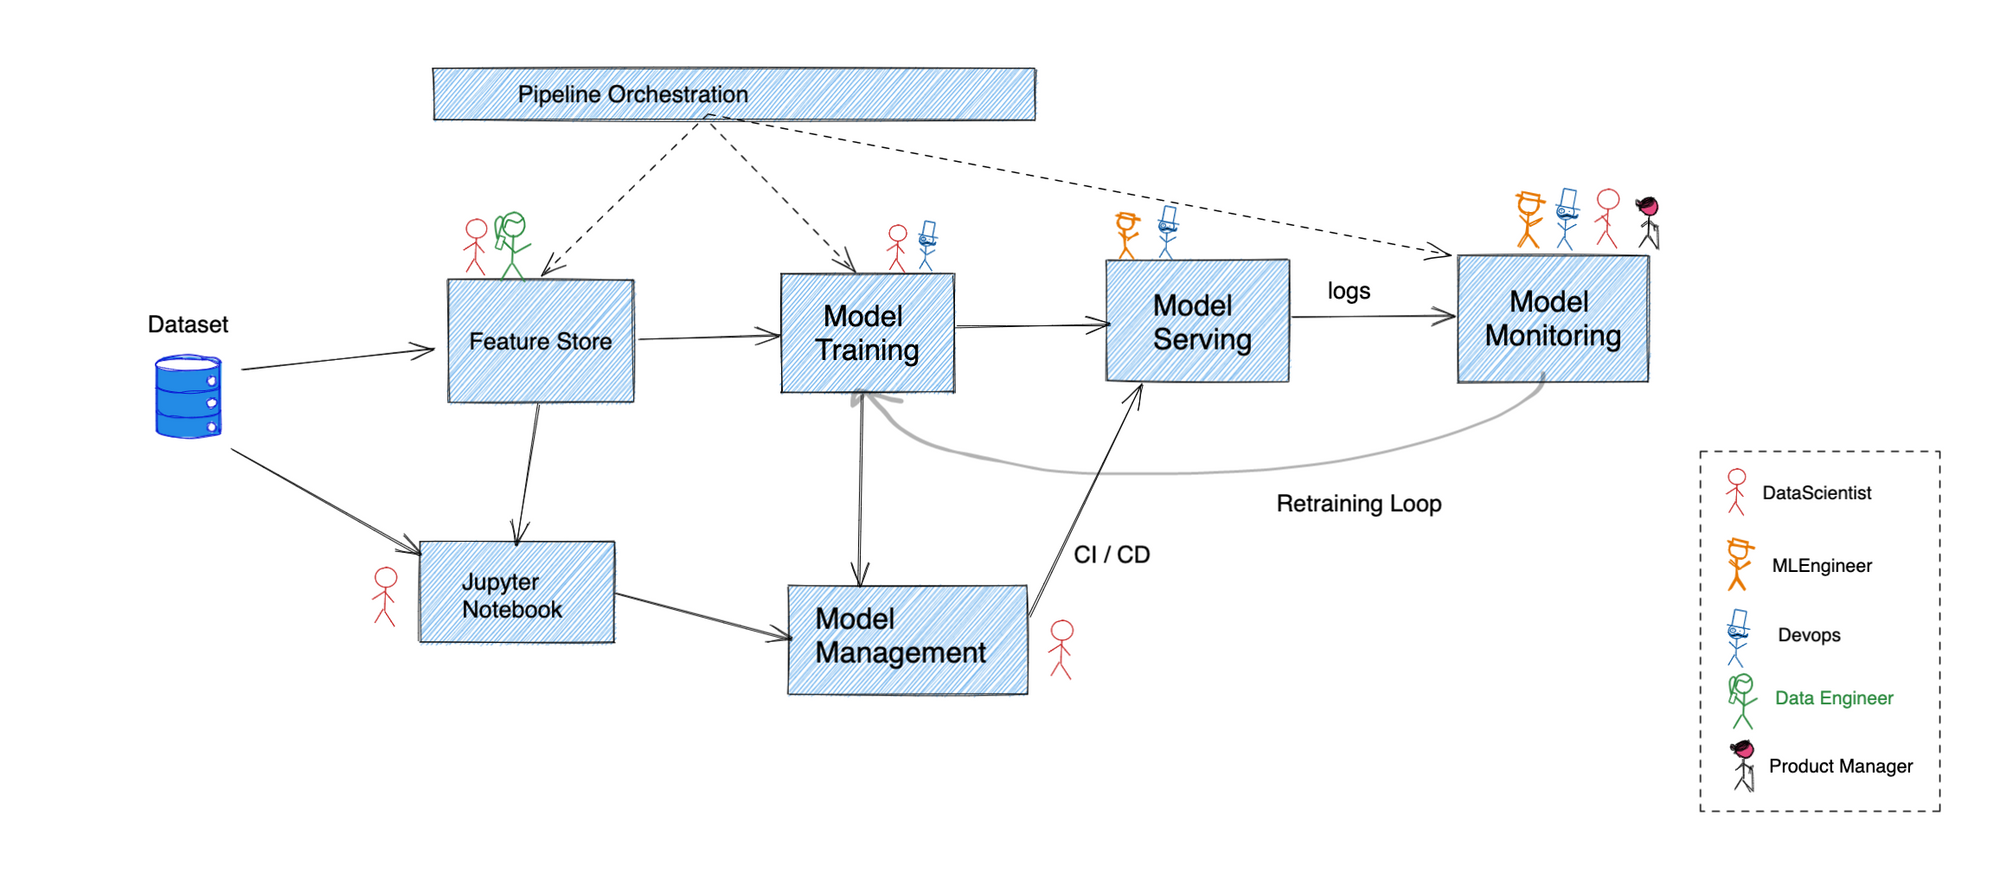
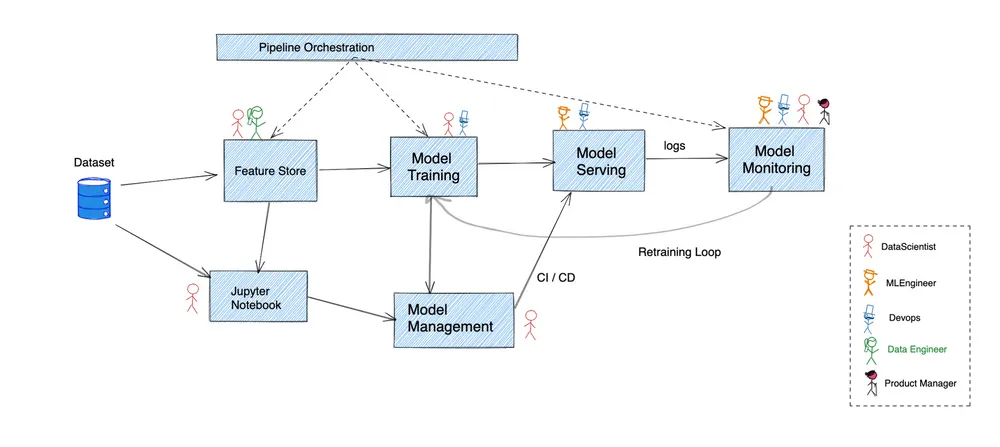
Die obige Abbildung gibt einen groben Überblick darüber, wie eine typische Data-Science-Pipeline abläuft. Viele Unternehmen haben sich dafür entschieden, eine Vielzahl maßgeschneiderter Lösungen mit überschneidenden Funktionen zu nutzen, um alles miteinander zu verknüpfen.
Wir werden jeden dieser Schritte durchgehen, um zu verstehen, wo Kubernetes ins Bild passt -
Bevor Rohdaten nutzbringend verwendet werden können, müssen sie zunächst in bereinigte Eingaben für die Modelltraining-Pipeline umgewandelt werden. Hier kommen Feature Stores ins Spiel, indem sie die Transformation, Speicherung und Bereitstellung der Feature-Daten übernehmen.
Kubernetes unterstützt das Deployment von zustandsbehafteten Workloads (Stateful Workloads) und lässt sich sehr gut mit Cloud-Anbietern integrieren, um nahtlos Persistenz zu bieten.
Die meiste Modellentwicklung beginnt damit, dass ein ML-Engineer Code in einem Jupyter Notebook schreibt – und für viele ist das fast schon alles, was benötigt wird. Es bietet eine REPL-Schnittstelle zur Ausführung von Python-Code. Dies beginnt meist lokal auf persönlichen Laptops, es ist jedoch besser, einen zentralen Pool von gehosteten Jupyter Notebooks zu betreiben, der von mehreren Personen genutzt werden kann.
Das deklarative Modell von Kubernetes zusammen mit der Unterstützung für persistente Speichersysteme macht es trivial, einen Pool von Notebooks zu hosten und Zugriffssteuerungen für einzelne Notebooks einzurichten, um eine effektive Zusammenarbeit zu gewährleisten.
Jeder in einem Notebook geschriebene Algorithmus muss mit Trainingsdaten gefüttert werden, um ein Modell-Artefakt als Ergebnis zu erhalten. Dies kann bei kleineren Anwendungsfällen im Notebook selbst erfolgen, erfordert jedoch bei größeren Datensätzen eine wesentlich leistungsfähigere Pipeline. In der Regel wird hier auch die Validierung gegen Testdatensätze durchgeführt, bevor das Artefakt für Inferenzen in der Produktion verwendet wird.
Es gibt mehrere Lösungen zur Orchestrierung einer DAG-Pipeline auf Kubernetes. Airflow bietet native Unterstützung für Kubernetes, während Kubeflow vollständig auf Kubernetes aufgebaut wurde. Alle großen Überwachungslösungen bieten eine erstklassige Integration mit Kubernetes, was für den Betrieb von produktionsreifen Pipelines essenziell ist.
Phase kümmert sich um die Speicherung und Versionierung des Datensatzes sowie des Modells. Dies stellt sicher, dass jedes Modell-Artefakt so lange wie nötig reproduzierbar bleibt. Hier lässt sich eine Parallele zur Code-Verwaltung mit Git ziehen.
Obwohl der zugrundeliegende Datenspeicher für solche Verwaltungssysteme auf Kubernetes selbst gehostet werden kann, ist es in vielen Fällen besser, eine verwaltete Lösung eines Cloud-Anbieters zu nutzen. In solchen Fällen integrieren die meisten Cloud-Anbieter ihre eigenen IAM-Systeme nahtlos mit denen von Kubernetes, was den sicheren Zugriff auf Daten von außerhalb des Clusters ermöglicht, ohne Zugangsdaten speichern zu müssen.
Schließlich wird das Modell-Artefakt so vorbereitet, dass ein Produktionssystem darauf basierend Inferenzen durchführen kann. Dies beinhaltet in der Regel das Verpacken eines Modells in ein API-Framework und das Ermöglichen für andere Services, das Modell aufzurufen, um Inferenzen zu generieren. Hier kommen Bedenken ähnlich wie im Software Engineering wie Authn/Authz, Skalierbarkeit, Zuverlässigkeit etc. ins Spiel.
Hier glänzt Kubernetes. Die meisten Funktionen, über die wir im vorherigen Abschnitt gesprochen haben, werden in dieser Phase kritisch.
Wie bei jedem Produktionssystem ist die kontinuierliche Überwachung des aktuell bereitgestellten Modells unerlässlich, um sicherzustellen, dass sich Ihr System wie erwartet verhält. Die zu überwachenden Metriken können von der tatsächlichen Genauigkeit der Vorhersagen bis hin zur Latenz und dem Durchsatz reichen, den das System unterstützen kann.
Viele Überwachungslösungen sind eng mit Kubernetes integriert. Das Erkennen eines Ziels zum tatsächlichen Erfassen von Metriken, das Durchführen von Berechnungen darauf und das Speichern für die spätere Verwendung können ohne externe Abhängigkeiten durchgeführt werden.
Die gesamte Landschaft rund um Kubernetes ist explodiert und es gibt bereits eine Vielzahl von Tools. Es gibt jedoch einige Fallstricke, die jedes Unternehmen berücksichtigen sollte, bevor es Kubernetes auf breiter Front einführt. Darauf und wie diese gemildert werden können, werden wir in der nächsten Ausgabe eingehen.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet






















