November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Als Moonshot AI Kimi K2 als Open Source veröffentlichte, horchte die AI-Community auf. Als sie mit Kimi K2 Thinking nachlegten, einem Modell, das über Hunderte von Tool-Aufrufen hinweg mit bemerkenswerter Kohärenz schlussfolgern konnte, begannen Praktiker, dem Modell ernsthafte Aufmerksamkeit zu schenken. Jetzt, mit Kimi K2.6, ist Moonshot noch einen Schritt weiter gegangen: ein hochmodernes Open-Source-Modell, das an der absoluten Spitze der Coding- und Long-Horizon-Agentic-Benchmarks steht und mit den besten Closed-Source-Angeboten der Welt konkurriert.
Dieser Beitrag ist ein Deep Dive in das, was K2.6 so bemerkenswert macht, was die Benchmark-Zahlen tatsächlich für reale Arbeitslasten bedeuten und wie Sie es ohne ein sechswöchiges Bereitstellungsprojekt in Betrieb nehmen können.
Kimi K2.6 ist das multimodale Modell der nächsten Generation von Moonshot AI, das auf Hugging Face und über die Kimi API verfügbar ist. Wie seine Vorgänger basiert es auf einer Mixture-of-Experts (MoE)-Architektur mit einem Kontextfenster von 262.144 Tokens. Aber K2.6 ist mehr als eine inkrementelle Verbesserung — es repräsentiert einen bedeutenden Designwechsel hin zu drei Dingen, die die vorherige Generation uneinheitlich verarbeitete: Long-Horizon-Coding, code-getriebenes Design und Agenten-Schwarm-Koordination.
Hier ist eine kurze Veranschaulichung dessen, was "Long-Horizon" in der Praxis bedeutet. In einer Benchmark-Demo hat K2.6 selbstständig ein Qwen3.5-0.8B-Modell lokal auf einem Mac bereitgestellt, Inference in Zig (einer Nischen-Systemprogrammiersprache) implementiert und über mehr als 4.000 Tool-Aufrufe und über 12 Stunden kontinuierlicher Ausführung den Durchsatz von ~15 auf ~193 Tokens pro Sekunde verbessert (etwa 20 % schneller als LM Studio). Das ist kein Chatbot, der eine Frage beantwortet; das ist eine AI, die über einen längeren Zeitraum hinweg als Senior Performance Engineer agiert.
In einer separaten Demonstration überarbeitete K2.6 eine 8 Jahre alte Open-Source-Finanz-Matching-Engine in einer 13-stündigen Sitzung und nahm über 1.000 gezielte Codeänderungen vor, um eine mittlere Durchsatzverbesserung von 185 % und einen Spitzendurchsatzgewinn von 133 % zu erzielen — ohne jegliche menschliche Anleitung nach der anfänglichen Aufgabenspezifikation.
Zahlen sind wichtig, aber der Kontext ist wichtiger. So schneidet K2.6 bei den Benchmarks ab, die für produktive Agenten-Systeme am wichtigsten sind:
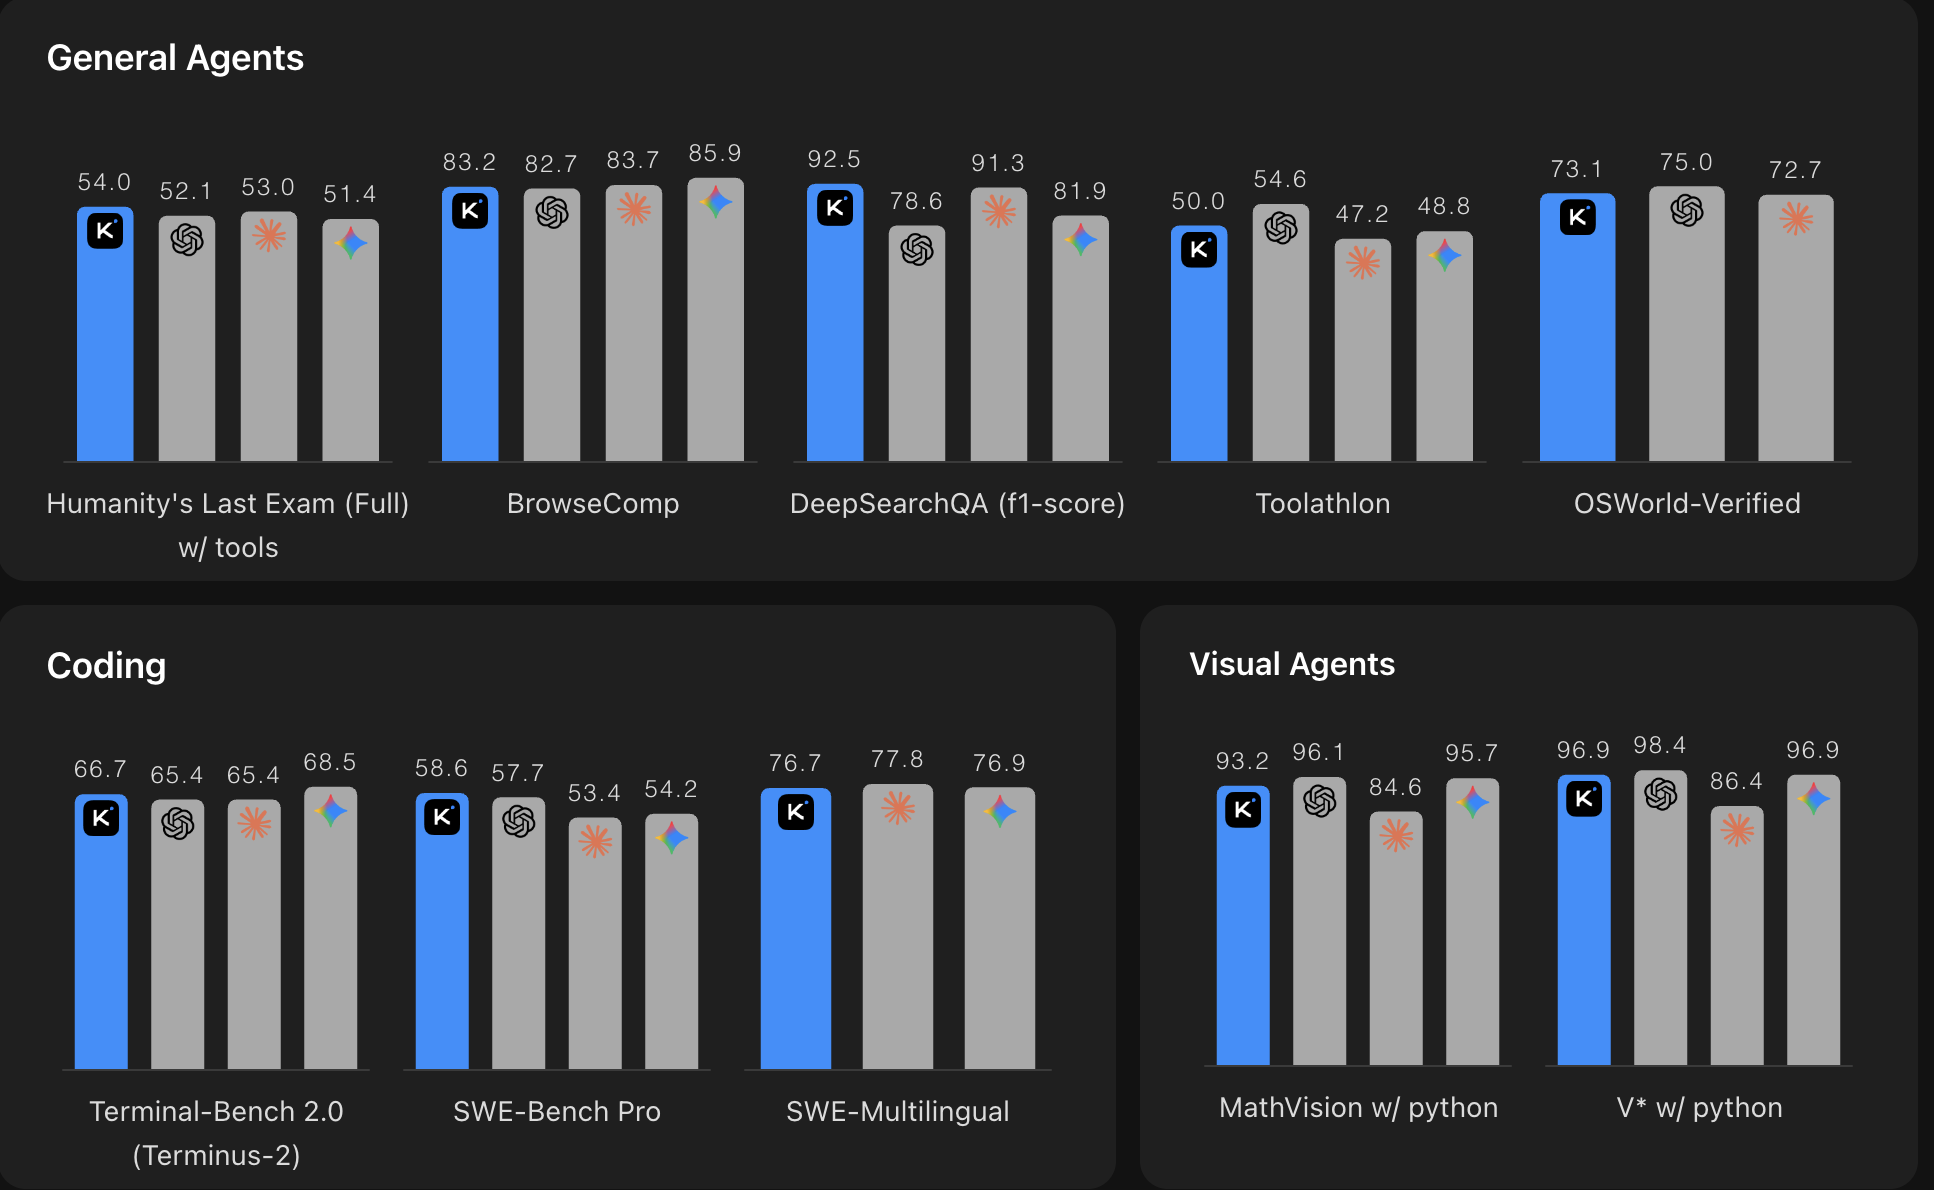
*Quelle: Moonshot AI Kimi K2.6 Benchmark-Vergleich. Höher ist besser. Das Diagramm vergleicht Kimi K2.6 mit führenden Closed-Source-Modellen über allgemeine Agenten-, Coding- und visuelle Agenten-Benchmarks hinweg.*
K2.6 ist konkurrenzfähig mit den allerbesten Closed-Source-Modellen, einschließlich Claude Opus 4.6 und GPT-5.4, in nahezu jeder Dimension, die für agentisches Codieren und Long-Horizon-Aufgaben von Bedeutung ist. Und das als Open-Weight-Modell für $0,74 / $3,50 pro Million Input-/Output-Tokens, was einen Bruchteil der Kosten vergleichbarer proprietärer Alternativen darstellt.
Der Sprung gegenüber Kimi K2.5 ist ebenfalls erheblich: eine Verbesserung von fast 80 % bei Toolathlon, ~8 Prozentpunkte bei BrowseComp und SWE-Bench Pro. Das sind keine marginalen Zugewinne.
Enterprise-Partner, die frühzeitigen Zugriff hatten, berichten von ähnlich überzeugenden Ergebnissen: Der CTO von Augmentcode hob die "chirurgische Präzision in großen Codebasen" von K2.6 hervor; Vercel verzeichnete eine Verbesserung von über 50 % bei ihrem Next.js-Benchmark im Vergleich zu K2.5; und CodeBuddy maß eine Verbesserung der Genauigkeit der Codegenerierung um 12 % bei einer Erfolgsquote von 96,6 % bei Tool-Aufrufen.
Die meisten LLMs eignen sich gut für One-Shot-Codegenerierung. K2.6 ist für Aufgaben gebaut, die Stunden dauern: dateiübergreifendes Refactoring, sprachenübergreifende Optimierungen, Verbesserungen von Build-Pipelines und iterative Debugging-Schleifen, bei denen das Modell Compiler-Ausgaben lesen, seine Hypothese anpassen und es erneut versuchen muss.
Das Modell zeigt eine starke Generalisierung über Python, Rust, Go und sogar seltene Sprachen wie Zig hinweg. Dies ist bemerkenswert, da es darauf hindeutet, dass das Modell Programmierkonzepte tief genug verinnerlicht hat, um sie zu übertragen, anstatt nur Muster aus Trainingsdaten auswendig zu lernen.
K2.6 kann einen einzigen Prompt in natürlicher Sprache in ein vollständiges, produktionsreifes Frontend verwandeln — nicht nur ein statisches Mockup, sondern eines mit interaktiven Elementen, Scroll-Animationen und datenbankgestützter Authentifizierung. Auf Moonshots internem Kimi Design Bench übertrifft K2.6 Google AI Studio bei visuellen Eingabeaufgaben, dem Aufbau von Landingpages, der Entwicklung von Full-Stack-Anwendungen und der allgemeinen kreativen Programmierung.
Für Teams, die AI-gestützte Entwicklungs-Workflows aufbauen, bedeutet dies effektiv ein einziges Modell, das den gesamten Stack abdeckt: Architektur, Logik, UI und Deployment-Scaffolding.
K2.6 führt eine wesentliche architektonische Erweiterung des Agenten-Schwarm-Systems ein, das erstmals in K2.5 vorgestellt wurde. Der Schwarm skaliert jetzt auf 300 Sub-Agenten, die gleichzeitig über 4.000 koordinierte Schritte ausführen, verglichen mit 100 Agenten und 1.500 Schritten in K2.5. Das ist nicht nur eine Skalierungsverbesserung; es ist eine qualitative Veränderung der Arten von Aufgaben, die durchführbar werden.
Eine Aufgabe, die zuvor von einem Menschen orchestriert werden musste (z. B. "analysieren Sie 100 Halbleiterunternehmen, erstellen Sie fünf quantitative Anlagestrategien und erstellen Sie eine Präsentation im McKinsey-Stil"), kann jetzt als eine einzige Anweisung an K2.6 übergeben und als vollständiges Ergebnis geliefert werden.
Hier stoppt das Gespräch gewöhnlich: Ein Team liest die Benchmark-Zahlen, ist begeistert und verbringt dann die nächsten drei Wochen damit, herauszufinden, wie das Modell tatsächlich zuverlässig bereitgestellt werden kann.
K2.6 ist ein großes MoE-Modell. Sein Kontextfenster von 262K bedeutet, dass die Speicheranforderungen erheblich sind. Agentic-Workloads erzeugen per Definition stark schwankende Verkehrsmuster: stundenlang ruhig, und dann plötzlich Hunderte von parallelen Sub-Agenten, die alle gleichzeitig Anfragen stellen. Naive Deployment-Strategien brechen unter dieser Last zusammen.
Das ist das Infrastrukturproblem, für dessen Lösung das TrueFoundry AI Gateway entwickelt wurde.
Anstatt Ihren eigenen GPU-Cluster bereitzustellen, einen benutzerdefinierten Load Balancer zu bauen und Inference-Parameter manuell abzustimmen, ermöglicht TrueFoundry Ihnen, Ihre Anwendung auf einen einzigen Endpunkt auszurichten — und kümmert sich um den Rest. Das Gateway leitet Anfragen intelligent über Anbieter hinweg weiter, verwaltet die Nebenläufigkeit für Lastspitzen-Workloads (wie ein Schwarm, der 300 simultane Sub-Agenten abfeuert) und bietet Ihnen die Observability-Tools — Traces, Latenz-Histogramme, Token-Nutzung nach Team —, die Sie sonst selbst bauen müssten.
In unseren internen Tests mit Kimi K2 Thinking verarbeitete das Gateway von TrueFoundry 350+ RPS auf vCPU mit ~10ms Overhead. Bei Agenten-Workloads, bei denen eine einzelne vom Benutzer initiierte Aufgabe in Dutzende oder Hunderte von API-Aufrufen aufgefächert werden kann, ist dieser Spielraum entscheidend.
Es gibt auch eine praktische organisatorische Dimension. Enterprise-Teams, die K2.6 ausführen, bestehen typischerweise aus mehreren Teams — Data Science, Product Engineering, Platform —, die alle mit demselben Modell experimentieren möchten. Das Gateway bietet eine einzige Control Plane für Rate Limiting, Kostenzuweisung und Zugriffsrichtlinien, ohne dass jedes Team ein eigenes API-Schlüssel-Management benötigt.
Der schnellste Weg, K2.6 in einer verwalteten, produktionsreifen Umgebung auszuführen:
1. Über das TrueFoundry AI Gateway (API)
Wenn Sie bereits das OpenAI SDK oder einen anderen OpenAI-kompatiblen Client verwenden, können Sie mit einer einzigen Änderung des Modell-Strings zu K2.6 wechseln:
Das Gateway übernimmt die Anbieterauswahl, das Fallback-Routing und das Rate Limiting transparent.
2. Für Agentic-Workloads
Die Tool-Calling-Schnittstelle von K2.6 folgt dem Standard-Schema für OpenAI Function Calling. Für Long-Horizon-Aufgaben sollten Sie:
- `max_tokens` großzügig festlegen (das Modell kann ein großes Generierungsbudget produktiv nutzen)
- Streaming aktivieren, um inkrementelle Ausgaben von langen Tool-Ketten zu erhalten
- Das Tracing-Dashboard von TrueFoundry verwenden, um zu visualisieren, welche Tool-Aufrufe Zeit in Anspruch nehmen und wo Kontext verbraucht wird
3. Für Agenten-Schwarm-Orchestrierung
Wenn Sie Multi-Agenten-Systeme bauen, bietet das Gateway von TrueFoundry Metadaten auf Anfrageebene — Sie können die Anfragen jedes Sub-Agenten mit einer übergeordneten Aufgaben-ID taggen und dann den vollständigen Ausführungs-Trace nachträglich rekonstruieren. Dies ist unschätzbar wertvoll für das Debugging von Schwarmverhalten und das Verständnis dafür, wo Parallelität hilft (oder schadet).
Engineering-Teams, die Agentic-Coding-Tools bauen: K2.6 ist das erste Open-Source-Modell, das bei SWE-Bench Pro ernsthaft mit GPT-5.4 und Claude Opus konkurriert. Wenn Sie auf ein Open-Weight-Modell gewartet haben, das produktionsreife Codebasis-Aufgaben bewältigen kann, ist dies das Richtige.
ML-Plattform-Teams, die den Modellzugriff verwalten: Ein Unternehmen, das K2.6 zusammen mit anderen Frontier-Modellen evaluiert, profitiert davon, alles über ein einziges Gateway auszuführen. Der Modellkatalog-Ansatz von TrueFoundry ermöglicht es Ihnen, K2.6 im Vergleich zu Claude oder GPT-5.4 bei Ihren tatsächlichen Workloads A/B-zutesten, wobei Kosten und Latenz nebeneinander nachverfolgt werden.
Teams mit Data-Residency-Anforderungen: Die Open-Weight-Natur von K2.6 bedeutet, dass es auf einer von Ihnen kontrollierten Infrastruktur bereitgestellt werden kann. Die Deployment-Plattform von TrueFoundry übernimmt die Orchestrierung, sodass Sie eine Enterprise-Modell-Governance erhalten, ohne dass ein proprietärer Anbieter in Ihrem Inference-Pfad sitzt.
Jeder, der es leid ist, geschlossene Modellpreise zu zahlen: Bei $0,74 / $3,50 pro Million Tokens und einer Benchmark-Leistung, die bei den meisten Agenten-Aufgaben mit proprietären Alternativen mithält oder diese übertrifft, ist das Kosten-Leistungs-Argument für K2.6 schwer zu ignorieren.
Kimi K2.6 ist ein echtes Frontier-Modell. Nicht nur "gut für Open Source" — sondern bei den Benchmarks, die für reale Engineering-Arbeiten wichtig sind, wirklich konkurrenzfähig mit den besten Modellen der Welt. Seine Long-Horizon-Zuverlässigkeit, die Agenten-Schwarm-Architektur und die wettbewerbsfähige Preisgestaltung machen es zum überzeugendsten Open-Weight-Modell, das heute für produktive Agenten-Systeme verfügbar ist.
Die praktische Frage ist nicht, ob K2.6 den Einsatz wert ist. Das ist es. Die Frage ist, wie schnell und zuverlässig Sie es in die Produktion bringen können. TrueFoundry AI Gateway beantwortet diese Frage — damit Ihr Team seine Zeit damit verbringt, mit dem Modell zu bauen, anstatt die Infrastruktur darum herum aufzubauen.
Testen Sie es jetzt: Greifen Sie über das [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway) auf Kimi K2.6 zu oder [buchen Sie eine Demo](https://www.truefoundry.com/book-demo), um zu sehen, wie es in den Workflow Ihres Teams passt.
*Alle zitierten Benchmark-Zahlen stammen aus dem offiziellen technischen Blog von Kimi K2.6 und verifizierten Evaluierungen Dritter auf OpenRouter. Infrastruktur-Performance-Zahlen stammen aus internen Tests von TrueFoundry.*
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet