



October 28, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
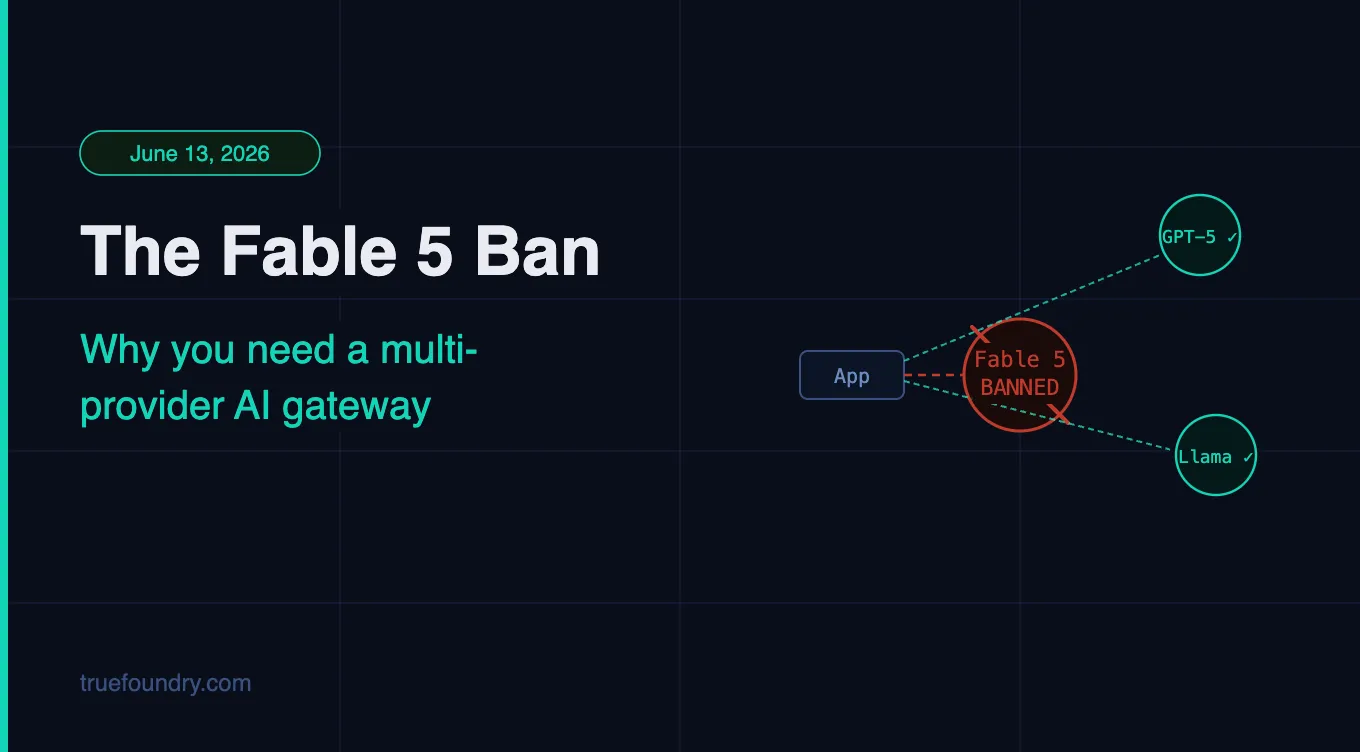
Am Freitag, den 13. Juni 2026, deaktivierte Anthropic abrupt den Zugriff auf Fable 5 und Mythos 5 – seine beiden leistungsfähigsten Modelle – für alle Kunden weltweit. Die Ursache war weder ein Ausfall noch ein freiwilliger Sicherheits-Rollback des Unternehmens. Es handelte sich um eine Exportkontrollrichtlinie des US-Handelsministeriums, die eine routinemäßige API-Abhängigkeit über Nacht in einen Single Point of Failure verwandelte. Für jeden, der auf einen einzigen Anbieter setzt, ist dies das bisher deutlichste Argument für den Einsatz eines Multi-Provider-KI-Gateways vor Ihren Modellen.
Dieser Beitrag erläutert, was tatsächlich passiert ist, warum es sich um ein strukturelles Risiko und nicht um einen Einzelfall handelt und welche Resilienz-Architektur dafür sorgt, dass das Verschwinden eines Modells keine Auswirkungen auf Ihren Betrieb hat.
Der Zeitplan ist kurz und ungewöhnlich prägnant. Anthropic veröffentlichte Fable 5, sein bisher leistungsfähigstes Modell, und erhielt etwa vier Tage später eine Notfallanweisung des US-Handelsministeriums. Unter Berufung auf nationale Sicherheitsinteressen ordnete die Regierung an, dass Anthropic den Zugriff auf Fable 5 und das zugrunde liegende Mythos 5-Modell für alle ausländischen Staatsangehörigen aussetzen muss – unabhängig davon, ob sie sich außerhalb der USA oder auf US-Boden befinden, einschließlich der nicht-amerikanischen Mitarbeiter von Anthropic selbst. Laut Anthropic war der Auslöser die Erkenntnis der Regierung, dass es eine Methode gab, die Sicherheitsvorkehrungen von Fable 5 zu umgehen oder zu „jailbreaken“.
Da Anthropic die Nationalität jedes Nutzers, der eine Anfrage stellt, nicht in Echtzeit zuverlässig überprüfen konnte, war eine selektive Einhaltung nicht möglich. Also wurde das System vollständig abgeschaltet: Beide Modelle wurden für alle Kunden – einschließlich der US-Bürger – für Hunderte Millionen Nutzer deaktiviert. Wie mehrere Medien berichteten, ist dies anscheinend das erste Mal, dass ein führendes KI-Unternehmen ein öffentlich bereitgestelltes, kommerziell verfügbares Modell aufgrund einer direkten Intervention der US-Regierung vom Netz genommen hat.
Das Detail, das für Engineering-Teams von Bedeutung ist, wird oft übersehen: Es gab kein sanftes Auslaufen, keine sechsmonatige Ankündigungsfrist und kein „Migrieren Sie bis zum dritten Quartal auf die nächste Version“. Der Zugriff war von jetzt auf gleich verschwunden. Wenn Ihr Code davon ausging, dass diese Modelle die nächste Anfrage beantworten würden, ist diese Annahme sofort gescheitert.
Es wäre einfach, dies als eine Geschichte über ein einzelnes Unternehmen oder ein einzelnes Modell zu sehen. Das ist es aber nicht. Das Verbot von Fable 5 / Mythos 5 ist ein konkreter Beweis für ein Risiko, das für jeden Anbieter von Spitzenmodellen gilt: Wenn Sie von einem einzigen Modell hinter der API eines einzigen Anbieters abhängen, akzeptieren Sie mehrere Fehlerquellen, auf die Sie keinen Einfluss haben.
Drei davon sollten explizit genannt werden. Die erste ist regulatorischer und geopolitischer Natur – Exportkontrollen, Sanktionen, regionale Lizenzierungen und Datenresidenzregeln können dazu führen, dass ein Modell für Sie nicht mehr erreichbar ist, ohne dass dies etwas mit Ihrer eigenen Verfügbarkeit oder Ihren Ausgaben zu tun hat. Die zweite ist die gewöhnliche betriebliche Art – Anbieterausfälle, Kapazitätsdrosselungen und Änderungen der Ratenbegrenzungen, die genau zu Ihren Spitzenzeiten auftreten. Die dritte ist der Modelllebenszyklus – veraltete Funktionen und erzwungene Versionsmigrationen nach dem Zeitplan des Anbieters, nicht nach Ihrem eigenen. Das Fable-Verbot ist das drastischste Beispiel für die erste Kategorie, aber alle drei führen zum gleichen Ergebnis: Ein Modell, auf das Sie sich verlassen haben, antwortet nicht mehr, und Sie haben keinen Plan B.
Genau das meinen Leute mit KI-Anbieterbindung in der Praxis. Es geht nicht nur um Preisdruck. Es geht darum, wie viel von Ihrem Produkt nicht mehr funktioniert, wenn ein Anbieter aus irgendeinem Grund den Dienst verweigert.
Das Ausmaß des Fable-Verbots hing fast ausschließlich von einer architektonischen Entscheidung ab: ob das Modell direkt oder über eine Abstraktionsschicht aufgerufen wurde.
Teams, die das SDK eines einzelnen Anbieters direkt in ihre Anwendung integriert hatten – mit fest im Code hinterlegten Modellnamen, Basis-URLs und Authentifizierungsdaten –, hatten keine Möglichkeit, die nächste Anfrage umzuleiten, als der Zugriff wegfiel. Der Ausfall war nicht nur eine Beeinträchtigung, sondern ein Totalausfall. Der Wechsel zu einem anderen Modell erforderte eine Codeänderung, einen Review, ein Deployment und ein Release-Fenster – alles unter dem Druck eines Vorfalls, während das Produkt offline war.
Teams, die ihren Datenverkehr über ein Gateway leiteten, erlebten dieselbe Nachricht völlig anders. Dass das Modell ausfiel, war für sie lediglich ein Routing-Ereignis, kein Ausfall: Anfragen wurden automatisch an eine konfigurierte Alternative weitergeleitet, und die Lösung war ein Konfigurations-Update statt eines Notfall-Deployments. Derselbe externe Schock, aber ein völlig anderer Freitag.
Ein Multi-Provider-KI-Gateway ist eine Abstraktionsschicht, die zwischen Ihrer Anwendung und jedem Modell, das Sie nutzen könnten, liegt. Anstatt jeden Anbieter separat zu integrieren, kommuniziert Ihr Code mit einem einzigen Endpunkt, und das Gateway steuert, welches Modell die jeweilige Anfrage tatsächlich bearbeitet. Wenn Sie tiefer in die Architektur eintauchen möchten, finden Sie in unserem Erklärartikel zu was ein LLM-Gateway ist die Grundlagen; hier konzentrieren wir uns auf die vier Funktionen, die durch das Fable-Verbot unverzichtbar geworden sind.
Eine einheitliche API für viele Modelle. Mit einer einzigen OpenAI-kompatiblen API für über 1.000 Modelle ist der Wechsel des Anbieters nur eine Frage der Änderung des Modellnamens in der Anfrage – gleiche URL, gleiche Zugangsdaten. Die Integrationsarbeit, um einen Backup-Anbieter hinzuzufügen, ist bereits erledigt, bevor Sie ihn überhaupt benötigen. Nur so ist ein Backup im Ernstfall wirklich hilfreich.
Automatisches Fallback und Failover. Sie definieren eine Kette – primäres Modell, dann Fallbacks – und wenn das primäre Modell Fehler zurückgibt oder nicht verfügbar ist, versucht das Gateway automatisch, die Anfrage über die nächste Option abzuwickeln, ohne dass Ihre Anwendung davon etwas merkt. Genau dieser Mechanismus verwandelt ein „unser Modell wurde gesperrt“ in eine transparente Umleitung.
Lastverteilung und Routing. Über das Failover hinaus kann das Gateway den Datenverkehr basierend auf Latenz, Kosten oder Verfügbarkeit auf verschiedene Anbieter und Regionen verteilen. Unsere Artikel zu LLM-Lastverteilung und was ein LLM-Router ist Wir gehen noch tiefer ins Detail, aber der Punkt zur Ausfallsicherheit ist simpel: Da der Datenverkehr bereits verteilt ist, führt der Ausfall eines Ziels lediglich zu einer Kapazitätsminderung, anstatt das System komplett lahmzulegen.
Ein Open-Weight- und selbstgehostetes Sicherheitsnetz. Ein Gateway ermöglicht es Ihnen, Open-Weight- oder selbstgehostete Modelle im selben Routing-Pool wie kommerzielle APIs zu führen. So ist ein souveräner, vollständig kontrollierter Fallback nur einen Konfigurationseintrag entfernt. Wir haben genau dieses Muster in Open-Weight-Routing in großem Maßstab – Routing zwischen einem Open-Weight-Modell und einem Spitzenmodell über ein einziges Gateway. Wenn der Fehlerfall darin besteht, dass ein Drittanbieter den Zugriff entzieht, ist ein selbst gehostetes Modell der Sicherheitsanker, den keine externe Anweisung abschalten kann.
Here's The Evaluation Framework for Proposal Template
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Unified API & Routing | |||
| Unified OpenAI-compatible endpoint | Is the gateway API compatible with OpenAI's /v1/chat/completions and /v1/responses formats, allowing consistent access across different models through a standardized interface? | Must have | ✅ Supported: OpenAI-compatible endpoint across all providers. |
| Provider and model coverage | Does it support leading providers like OpenAI, Azure OpenAI, Amazon Bedrock, Anthropic, Gemini, Groq, plus self-hosted models? | Must have | ✅ Supported: 1000+ LLMs across hosted and self-hosted providers. |
| Model onboarding speed | How quickly can new models (OpenAI-compatible and non-standard APIs) be added without code changes? | Must have | ✅ Supported: config-driven onboarding within minutes. |
| Multimodal support | Does the gateway support text, vision, audio, image generation, and embeddings through a single interface? | Depends on use case | ✅ Supported: chat, embeddings, images, audio, rerank, and realtime APIs. |
| Routing, load balancing, fallback | Can requests be routed by model, provider, latency, priority, weight, region, and failure state with automatic retries? | Must have | ✅ Supported: load balancing, fallbacks, weighted and latency-based routing. |
| Model switching without code change | Is model switching supported via headers or config without changing client code? | Must have | ✅ Supported: header-based and config-based model switching. |
Die oben genannten Funktionen lassen sich in eine Handvoll Muster übersetzen, die man eher als Standard und nicht als bloße Option betrachten sollte.
Beginnen Sie mit Primär-zu-Fallback-Ketten für jede Produktionsroute, bei der der Fallback ein anderer Anbieterist, nicht nur ein anderes Modell desselben Anbieters – ein Fallback beim selben Anbieter bietet keinen Schutz gegen einen anbieterweiten Ausfall wie diesen. Integrieren Sie Multi-Region-Routing , damit eine regional begrenzte Einschränkung nicht Ihren einzigen Pfad blockiert. Halten Sie ein Open-Weight-Modell bereit im Routing-Pool als anbieterunabhängige Mindestverfügbarkeit. Und für regulierte oder sensible Workloads betreiben Sie ein On-Premise- oder Air-Gapped-Deployment als ultimativen souveränen Fallback – unser Leitfaden für Air-Gapped-KI und unsere Sicht auf die On-Premise-KI-Plattform erfahren Sie, wie Teams in regulierten Branchen Modelle so absichern, dass sie nicht aus der Ferne deaktiviert werden können.
Keines dieser Muster erfordert die Vorhersage des nächsten Ereignisses im Fable-Stil. Sie erfordern lediglich die Akzeptanz, dass irgendein Anbieter zu irgendeinem Zeitpunkt auf einem Zeitplan, den Sie nicht bestimmen, nicht mehr verfügbar sein wird.
Wir haben das TrueFoundry AI Gateway genau für diese Art von Problemen entwickelt – damit KI-Anwendungen auch dann weiterlaufen, wenn ein einzelnes Modell oder ein Anbieter ausfällt.
Sie nutzen eine einzige OpenAI-kompatible API, die über 1.000 LLMs ansteuert. Das Hinzufügen oder Wechseln von Anbietern bedeutet also lediglich die Änderung eines Modellnamens, nicht das Umschreiben einer Integration. Automatische Fallback-Ketten ermöglichen es Ihnen, primäre und sekundäre Modelle über verschiedene Anbieter hinweg zu definieren; das Gateway leitet bei einem Ausfall automatisch um, ohne dass Änderungen an Ihrem Anwendungscode erforderlich sind. Lastverteilung und Routing verteilen den Datenverkehr nach Kosten, Latenz oder Verfügbarkeit auf Anbieter und Regionen, sodass der Ausfall eines einzelnen Ziels lediglich die Kapazität verringert, anstatt einen kompletten Systemausfall zu verursachen. Und da das Gateway Open-Weight- und selbst gehostete Modelle als gleichwertige Routing-Ziele behandelt, können Sie eine anbieterunabhängige Absicherung beibehalten – einschließlich vollständig lokaler oder Air-Gapped-Bereitstellungen – im selben Pool wie die kommerziellen APIs.
Dies geschieht, ohne zum Flaschenhals zu werden: Das Gateway fügt lediglich etwa 3–4 ms Overhead hinzu und bewältigt über 350 RPS auf einer einzigen vCPU, sodass es problemlos im kritischen Pfad eingesetzt werden kann. Es läuft in Ihrer eigenen VPC, On-Premise, Air-Gapped, hybrid oder über verschiedene Clouds hinweg, mit integriertem RBAC, SSO und Audit-Logging – genau das macht das Konzept der souveränen Ausfallsicherheit für regulierte Teams zu einer realen Lösung statt zu einer theoretischen Überlegung.
Es geht nicht darum, dass irgendein Gateway die Exportrichtlinie hätte verhindern können. Das konnte niemand. Es geht darum, dass das Gateway bestimmt, ob diese Richtlinie zu einem Vorfall oder lediglich zu einer Randnotiz wird.
Das Verbot von Fable 5 und Mythos 5 ist das erste Mal, dass ein Spitzenmodell durch eine behördliche Anordnung offline genommen wurde, aber es wird nicht das letzte Mal sein, dass ein Modell zu einem Zeitpunkt nicht mehr verfügbar ist, den Sie nicht kontrollieren – sei es durch Regulierung, einen Ausfall oder eine Einstellung des Dienstes. Ein Multi-Provider-KI-Gateway entscheidet darüber, was Sie das kostet: Mit einer einzigen API für viele Modelle, automatischem Fallback und einer Open-Weight- oder selbst gehosteten Absicherung ist ein verschwundenes Modell lediglich ein Routing-Ereignis und kein Produktstillstand.
Erfahren Sie, wie das TrueFoundry AI Gateway Ihre Anwendungen mit automatischem Failover über 1.000+ Modelle hinweg am Laufen hält →
F: Was ist ein Multi-Provider-KI-Gateway? A: Ein Multi-Provider-KI-Gateway ist eine Abstraktionsschicht zwischen Ihrer Anwendung und den verwendeten KI-Modellen. Anstatt jeden Anbieter einzeln zu integrieren, ruft Ihr Code einen einzigen Endpunkt auf, und das Gateway entscheidet, welches Modell die Anfrage bearbeitet. Dies ermöglicht automatisches Fallback, Lastverteilung und den Wechsel zwischen Anbietern ohne Codeänderungen. Es ist die Schicht, die es Ihnen erlaubt, die Wahl des Modells als Konfiguration und nicht als fest codierte Abhängigkeit zu behandeln.
F: Wurden Fable 5 und Mythos 5 dauerhaft gesperrt? A: Die Modelle wurden aufgrund einer US-Exportkontrollrichtlinie deaktiviert, die den Zugriff durch ausländische Staatsangehörige untersagt. Da die Nationalität nicht pro Anfrage überprüft werden konnte, hat Anthropic sie für alle Nutzer deaktiviert. Die Situation unterliegt einer laufenden behördlichen Anordnung und ist keine normale Produktentscheidung. Eine zukünftige Verfügbarkeit hängt daher von dieser Richtlinie ab – prüfen Sie die offizielle Stellungnahme von Anthropic auf den aktuellen Status, bevor Sie von einem Zugriff ausgehen.
F: Hätte ein KI-Gateway den Ausfall von Fable 5 für meine App verhindern können? A: Ein Gateway kann eine behördliche Anordnung nicht rückgängig machen, aber es verändert die Auswirkungen grundlegend. Mit einer über verschiedene Anbieter konfigurierten Fallback-Kette werden Anfragen, die an Fable 5 gegangen wären, automatisch auf ein verfügbares Modell umgeleitet. So wird aus einem Totalausfall ein transparenter Wechsel, den Sie durch eine Konfigurationsänderung statt durch ein Notfall-Deployment lösen.
F: Kann ich TrueFoundry in meiner eigenen VPC oder On-Premise bereitstellen? A: Ja. TrueFoundry läuft in Ihrer VPC, On-Premise, in isolierten Umgebungen (Air-Gapped), hybrid oder über mehrere Clouds hinweg, wobei keine Daten Ihren Bereich verlassen. Genau das macht ein selbst gehostetes Modell zu einem echten souveränen Fallback – eines, das kein externer Anbieter oder keine Richtlinie aus der Ferne abschalten kann.
F: Wie viele LLMs unterstützt TrueFoundry? A: Über 1.000 LLMs über eine einzige OpenAI-kompatible API. Sie wechseln die Modelle, indem Sie einfach den Modellnamen in der Anfrage ändern – gleiche URL, gleiche Anmeldedaten. Das macht das Hinzufügen eines Backup-Anbieters zu einem Konfigurationsschritt statt zu einem komplexen Engineering-Projekt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet
















