



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
KI-Systeme sind keine passiven Werkzeuge mehr. Sie agieren zunehmend agentisch – sie arbeiten autonom über Workflows, APIs und sensiblen Unternehmensdaten hinweg. In traditionellen Systemen wurde die Datenresidenz dadurch definiert, wo Daten gespeichert wurden. Sobald sich Datenbanken und Speicher in genehmigten Regionen befanden, galt die Compliance als gelöst.
Agentische KI bricht dieses Modell auf. Jede Interaktion erzeugt neue Datenflächen – Prompts, Agentenspeicher, Protokolle, Traces und transiente Inferenzdaten, die zur Laufzeit verarbeitet und beobachtet werden, oft über Regionen hinweg, selbst wenn nichts dauerhaft gespeichert wird.
Infolgedessen ist die Datenresidenz kein bloßes Abhaken einer Compliance-Checkliste mehr. Sie ist ein zentrales Infrastrukturthema, das mittlerweile auf Vorstandsebene diskutiert wird. Die Frage, die Unternehmen beantworten müssen, ist einfach: Wohin bewegen sich KI-generierte Daten zur Laufzeit und wer steuert diese Pfade?
In TrueFoundry wird die Datenresidenz am AI Gateway durchgesetzt, wo Inferenz, Agenten und Tools zusammenlaufen. Residenz wird als Systemeigenschaft behandelt, die unter normalem Betrieb, bei Ausfällen und unter Skalierung durchgesetzt wird. Dieser Blog erklärt, wie die Datenresidenz im TrueFoundry AI Gateway definiert, durchgesetzt und überprüft wird.
Datenresidenz war einfacher, als Anwendungen vorhersehbare Datenpfade hatten. Anfragen flossen von Benutzern zu Diensten zu Datenbanken, gewöhnlich innerhalb einer einzelnen Region, und die Compliance-Kontrollen waren weitgehend statisch.
KI-Systeme durchbrechen dieses Modell zur Laufzeit.
In modernen KI-Architekturen ist die Datenbewegung dynamisch und entscheidungsgetrieben, nicht starr. Eine einzelne Benutzeranfrage kann mehrere Ausführungspfade auslösen, die alle vom AI Gateway orchestriert werden. Genau hier wird die Datenresidenz anfällig.
Zur Laufzeit kann ein AI Gateway:
Jede dieser Entscheidungen kann zu einer impliziten Datenbewegung führen, oft ohne dass die Anwendung davon weiß.
Die häufigsten Fehler bei der Datenresidenz in KI-Systemen treten auf:
Entscheidend ist, dass diese Fehler selbst dann auftreten, wenn:
Diese Fehler haben alle eines gemeinsam: Sie treten zur Laufzeit auf, getrieben durch Routing, Wiederholungsversuche, Agentenausführung und Protokollierungsverhalten.
Das AI Gateway ist die einzige Schicht, die:
Aus diesem Grund kann die Datenresidenz in KI-Systemen nicht allein durch die Bereitstellungskonfiguration garantiert werden. Sie muss am AI Gateway durchgesetzt werden, wo Ausführungspfade in Echtzeit entschieden werden.
In Plattformen wie TrueFoundry wird Residenz als harte Laufzeiteinschränkung behandelt, nicht als unverbindliche Präferenz. Das stellt sicher, dass kein Ausführungspfad, einschließlich Ausfallszenarien, regionale Grenzen verletzen kann.
Agentische KI-Systeme nutzen Daten nicht nur, sie erzeugen kontinuierlich neue Datenflächen zur Laufzeit. Diese Flächen existierten in traditionellen Anwendungen nicht und verändern grundlegend, was die Datenresidenz berücksichtigen muss.
In KI-Systemen beschränkt sich die Datenresidenz nicht mehr auf ruhende Daten (Data at Rest). Sie erstreckt sich auf jedes Datenstück, das während der Inferenz und Agentenausführung erstellt, verarbeitet oder beobachtet wird – selbst wenn diese Daten nur kurzzeitig existieren.
Die wichtigsten dieser neuen Datenverbindlichkeiten sind oft die am wenigsten sichtbaren.
Inferenzanfragen transportieren Prompts und Antworten durch das AI Gateway, die häufig proprietäre Logik, Kundendaten oder sensiblen internen Kontext enthalten. Im Gegensatz zu traditionellen APIs sind diese Daten freiformatig und unbereinigt, was sie besonders risikoreich macht.
Agentische Workflows führen dauerhaften Kontext und Speicher (Memory) über Interaktionen hinweg ein. Wenn dieser Status außerhalb genehmigter Regionen verarbeitet oder wiedergegeben wird, ist die Residenz verletzt – selbst wenn einzelne Inferenzaufrufe konform erscheinen.
KI-Systeme erzeugen auch Protokolle, Traces, Embeddings und Ausführungsmetadaten, die sensible Informationen kodieren können. Wenn Observability-Pipelines diese Daten über Regionen hinweg exportieren, kommt es stillschweigend zu Verstößen.
Wichtig ist: Daten müssen nicht gespeichert werden, um nicht-konform zu sein. Transiente Inferenzdaten, die nur für Millisekunden im Arbeitsspeicher verarbeitet werden, unterliegen weiterhin den Residenzanforderungen, wenn sie eine zuständigkeitsbezogene Grenze überschreiten.
Traditionelle Residenzkontrollen wurden für statische Systeme entwickelt, nicht für dynamisches Routing, Wiederholungsversuche, Failover und agentengetriebene Ausführung. In KI-Systemen muss die Residenz zur Laufzeit durchgesetzt werden, wo diese Datenpfade entstehen.
In Plattformen wie TrueFoundry erfolgt diese Durchsetzung am AI Gateway, wo Prompts, Agentenkontext, Wiederholungsversuche und Telemetrie zusammenlaufen. Das macht die Residenz zu einer Systemeigenschaft statt zu einer bloßen Annahme.
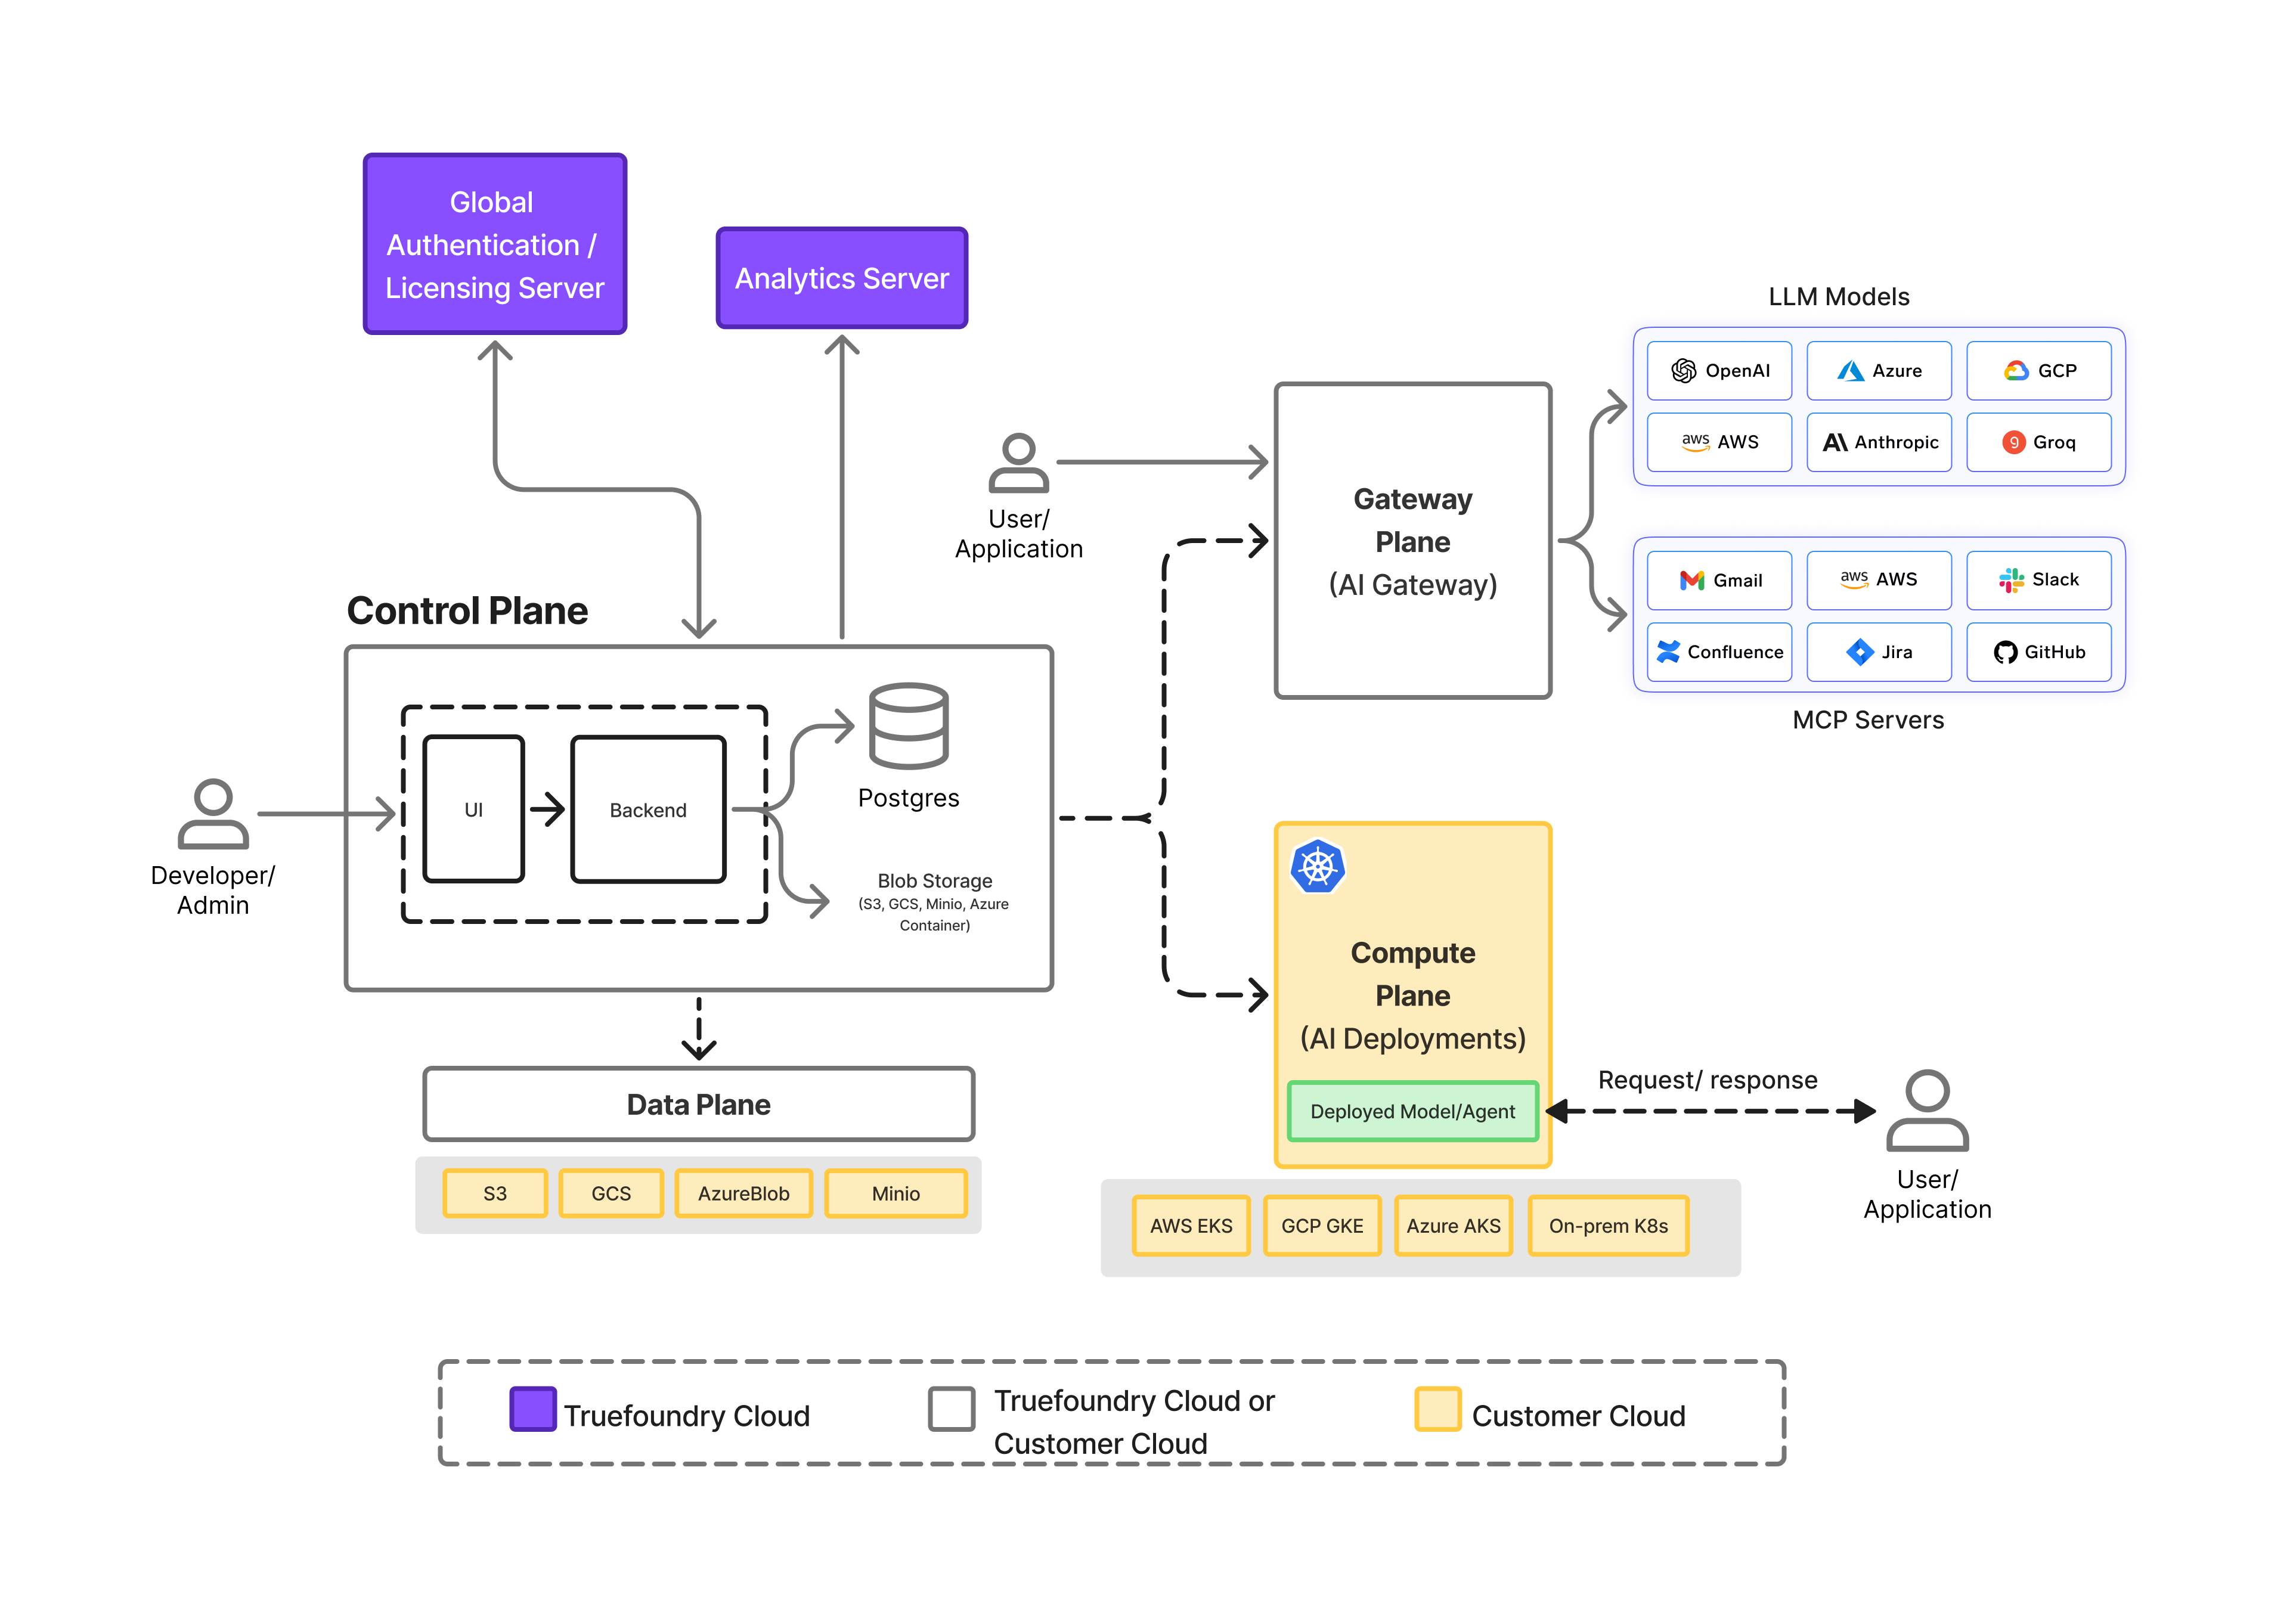
Die Durchsetzung der Datenresidenz in KI-Systemen erfordert mehr als eine regionale Bereitstellung. Sie erfordert eine klare Trennung der Verantwortlichkeiten über den gesamten KI-Stack hinweg, sodass Ausführungs-, Steuerungs- und Datenpfade unabhängig voneinander verwaltet werden können.
TrueFoundry ist um eine Split-Plane-Architektur herum konzipiert, die dies ermöglicht.
Auf hoher Ebene besteht die Plattform aus drei unterschiedlichen Ebenen:
Diese Trennung ist grundlegend dafür, wie die Datenresidenz zur Laufzeit zuverlässig durchgesetzt wird.
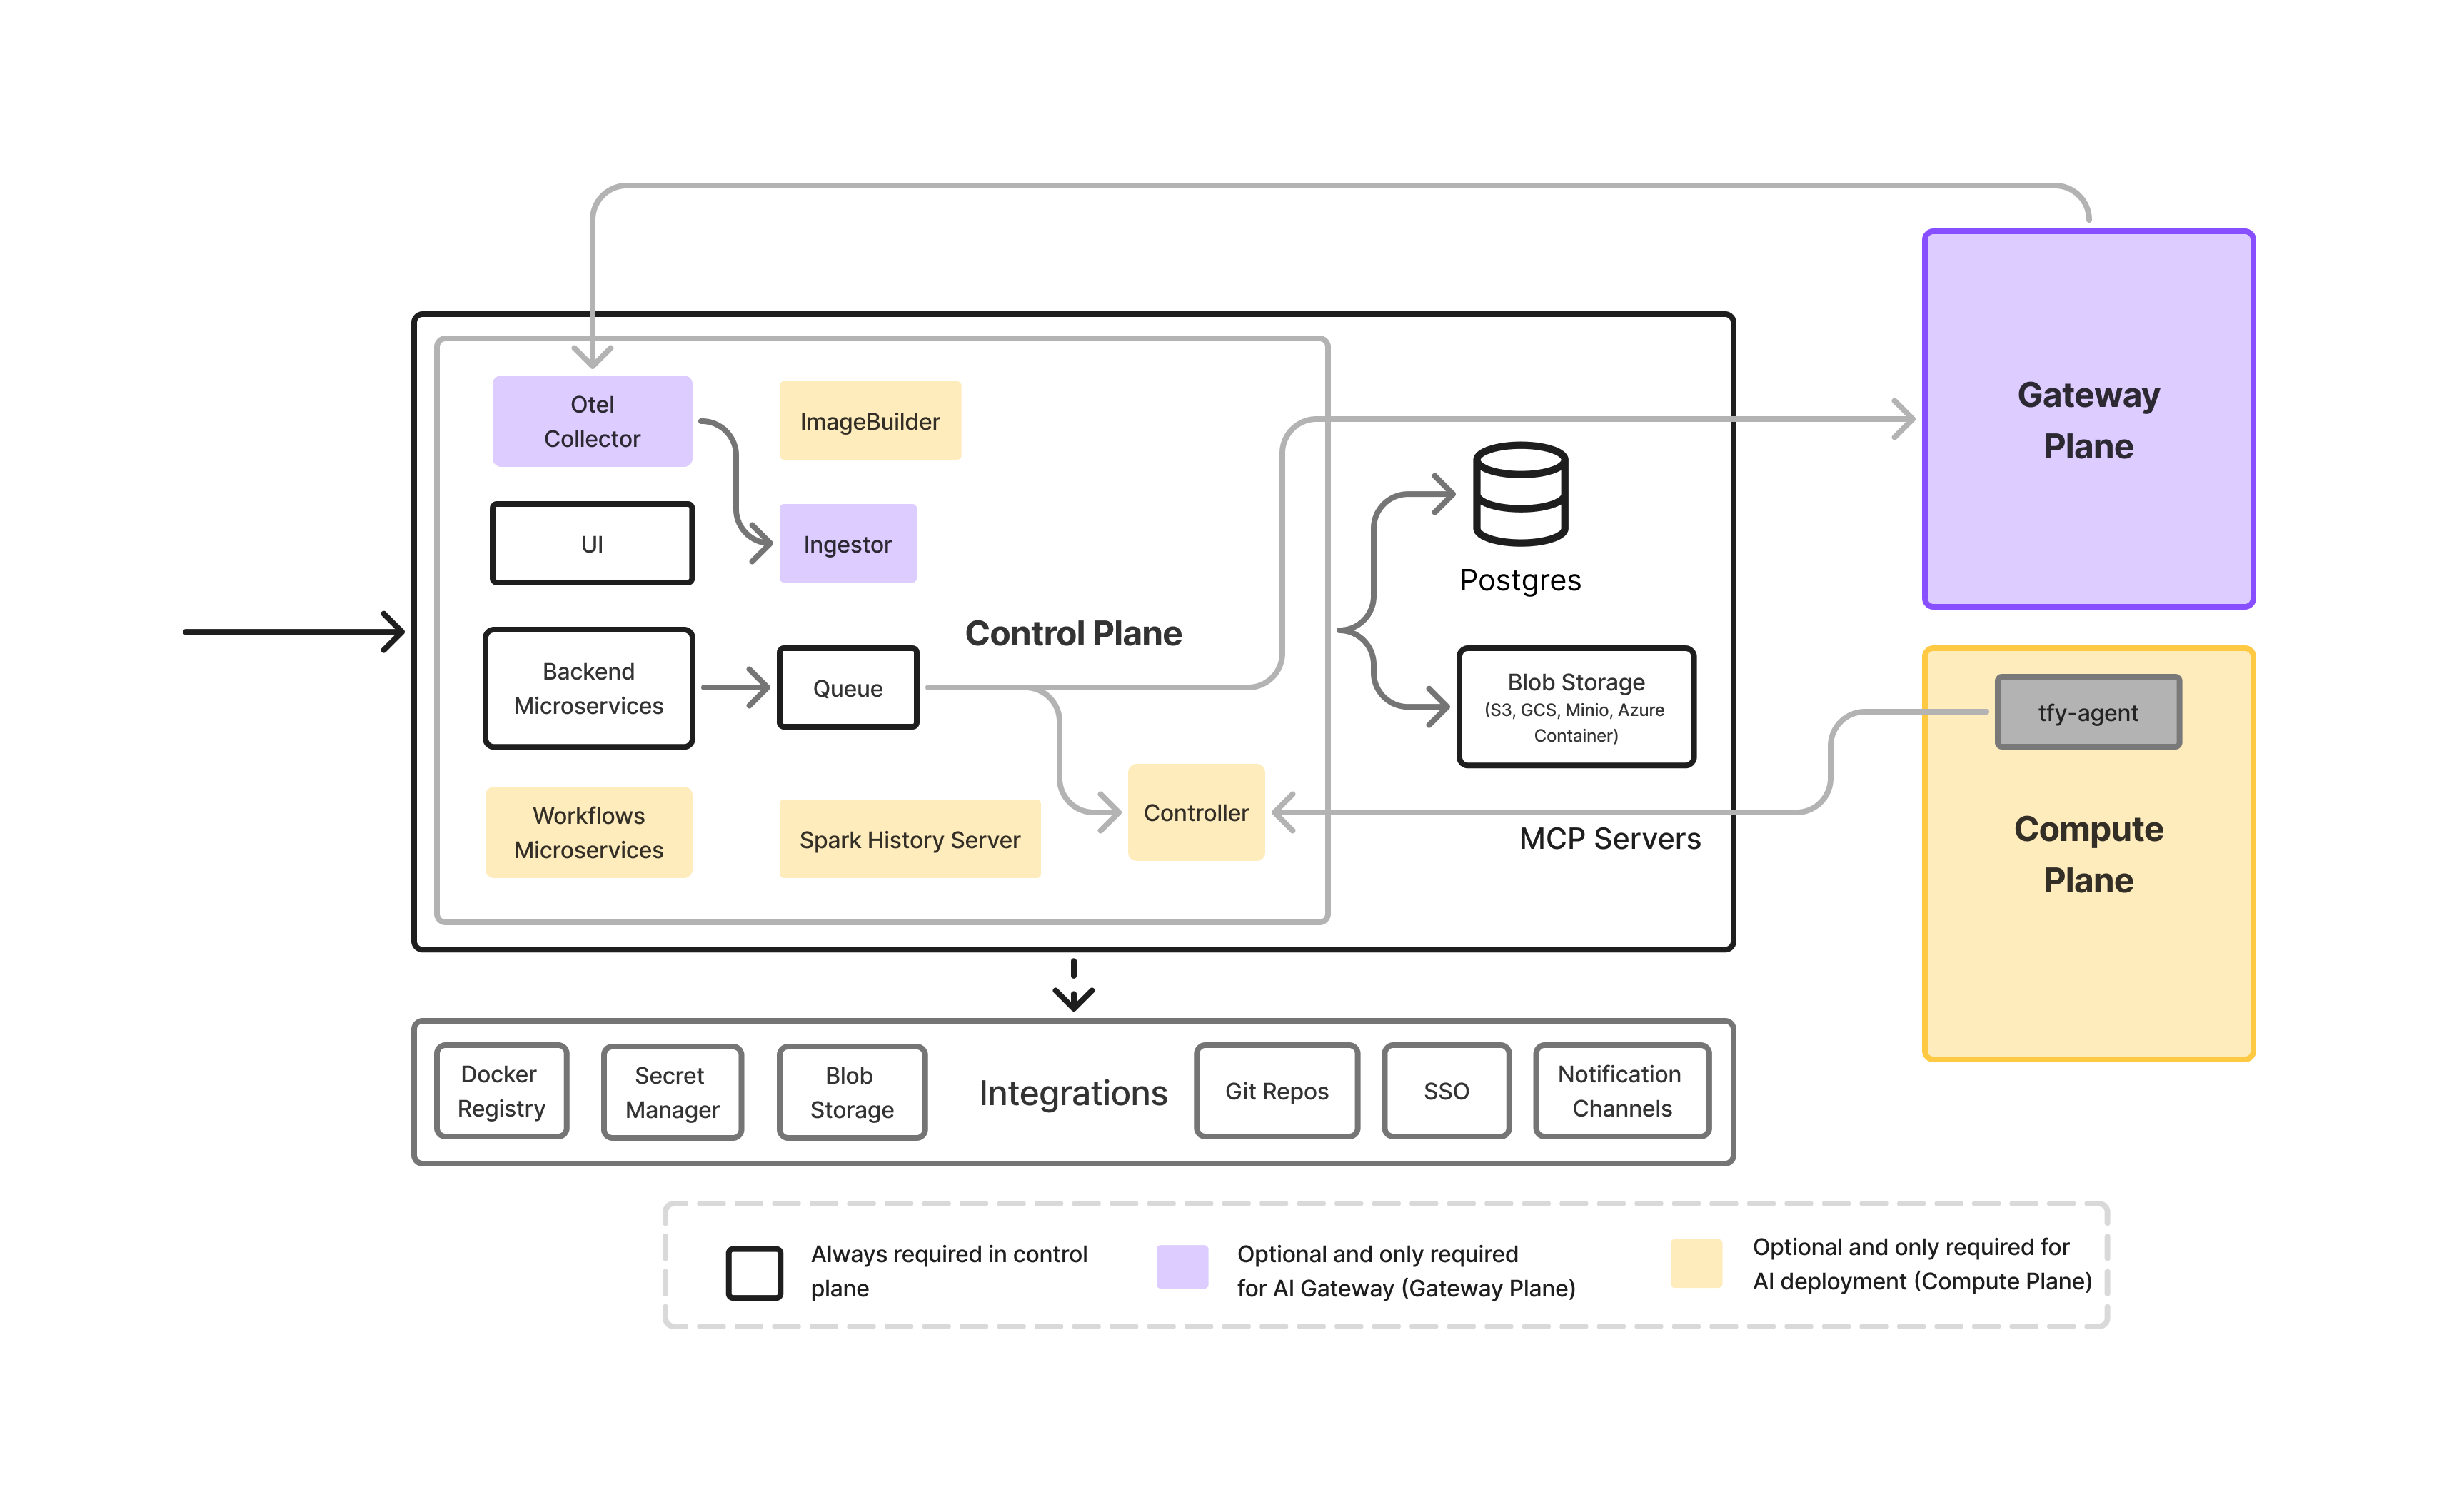
Die Control Plane ist die Orchestrierungsschicht der TrueFoundry-Plattform. Sie ist verantwortlich für:
Wichtig ist: Die Control Plane verarbeitet keinen Inferenzverkehr und führt keine Workloads aus. Sie definiert, was passieren soll, nicht, wohin die Daten zur Laufzeit fließen.
Für Unternehmen mit strengen Compliance-Anforderungen unterstützt TrueFoundry sowohl:
Dies ermöglicht es Organisationen, das passende Gleichgewicht zwischen betrieblicher Einfachheit und Souveränitätsanforderungen zu wählen, ohne die Funktionsweise der nachgelagerten Residenzdurchsetzung zu ändern.
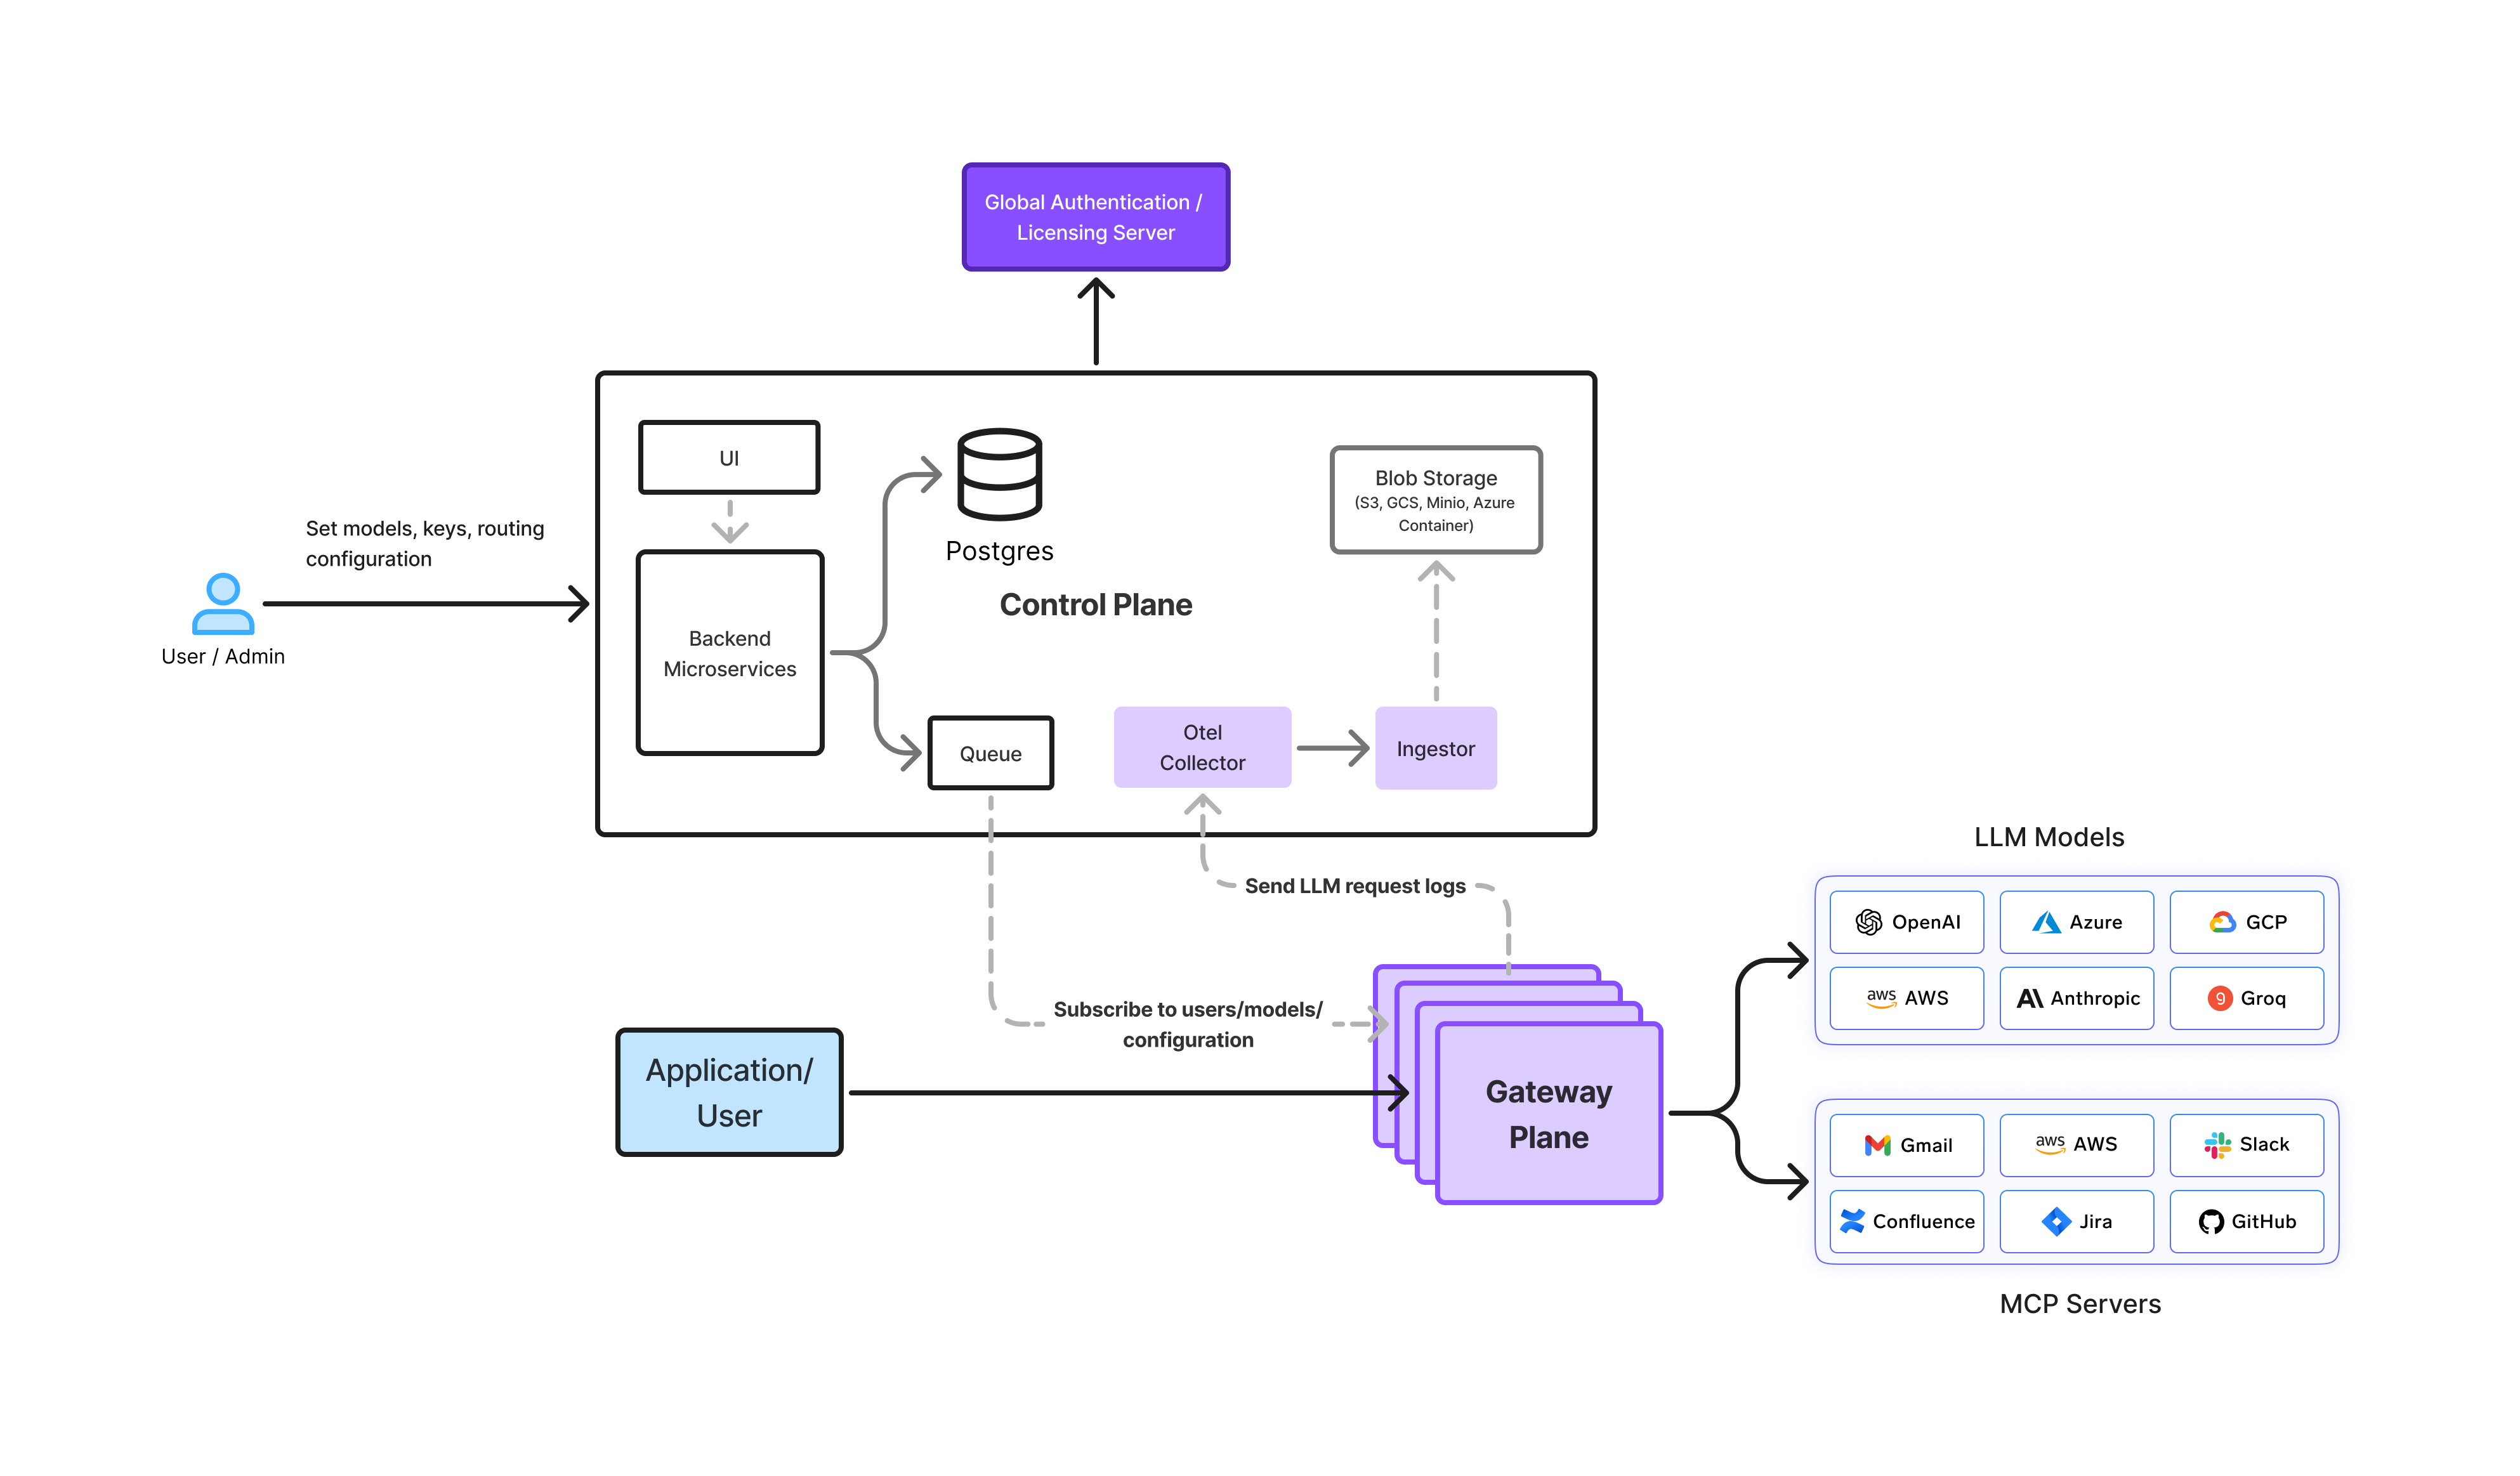
Die Gateway Plane ist der Ort, an dem die Datenresidenz aktiv durchgesetzt wird.
Die AI Gateways von TrueFoundry sitzen zwischen Anwendungen und allen Modellanbietern und agieren als:
Jede Inferenzanfrage, jeder Wiederholungsversuch, jedes Failover, jeder Agentenaufruf und jedes Observability-Ereignis passiert das Gateway. Dadurch hat es die volle Sichtbarkeit über:
Aus diesem Grund ist die Gateway Plane die einzige Schicht, die in der Lage ist, Datenresidenz als harte Einschränkung durchzusetzen.
Wenn eine Anfrage innerhalb der konfigurierten Residenzgrenzen nicht erfüllt werden kann, bricht das Gateway die Anfrage sicher ab (Fail-Closed), anstatt sie stillschweigend in eine nicht-konforme Region zu routen.
Das ist der Hauptunterschied zwischen Laufzeitdurchsetzung und unverbindlicher Konfiguration.
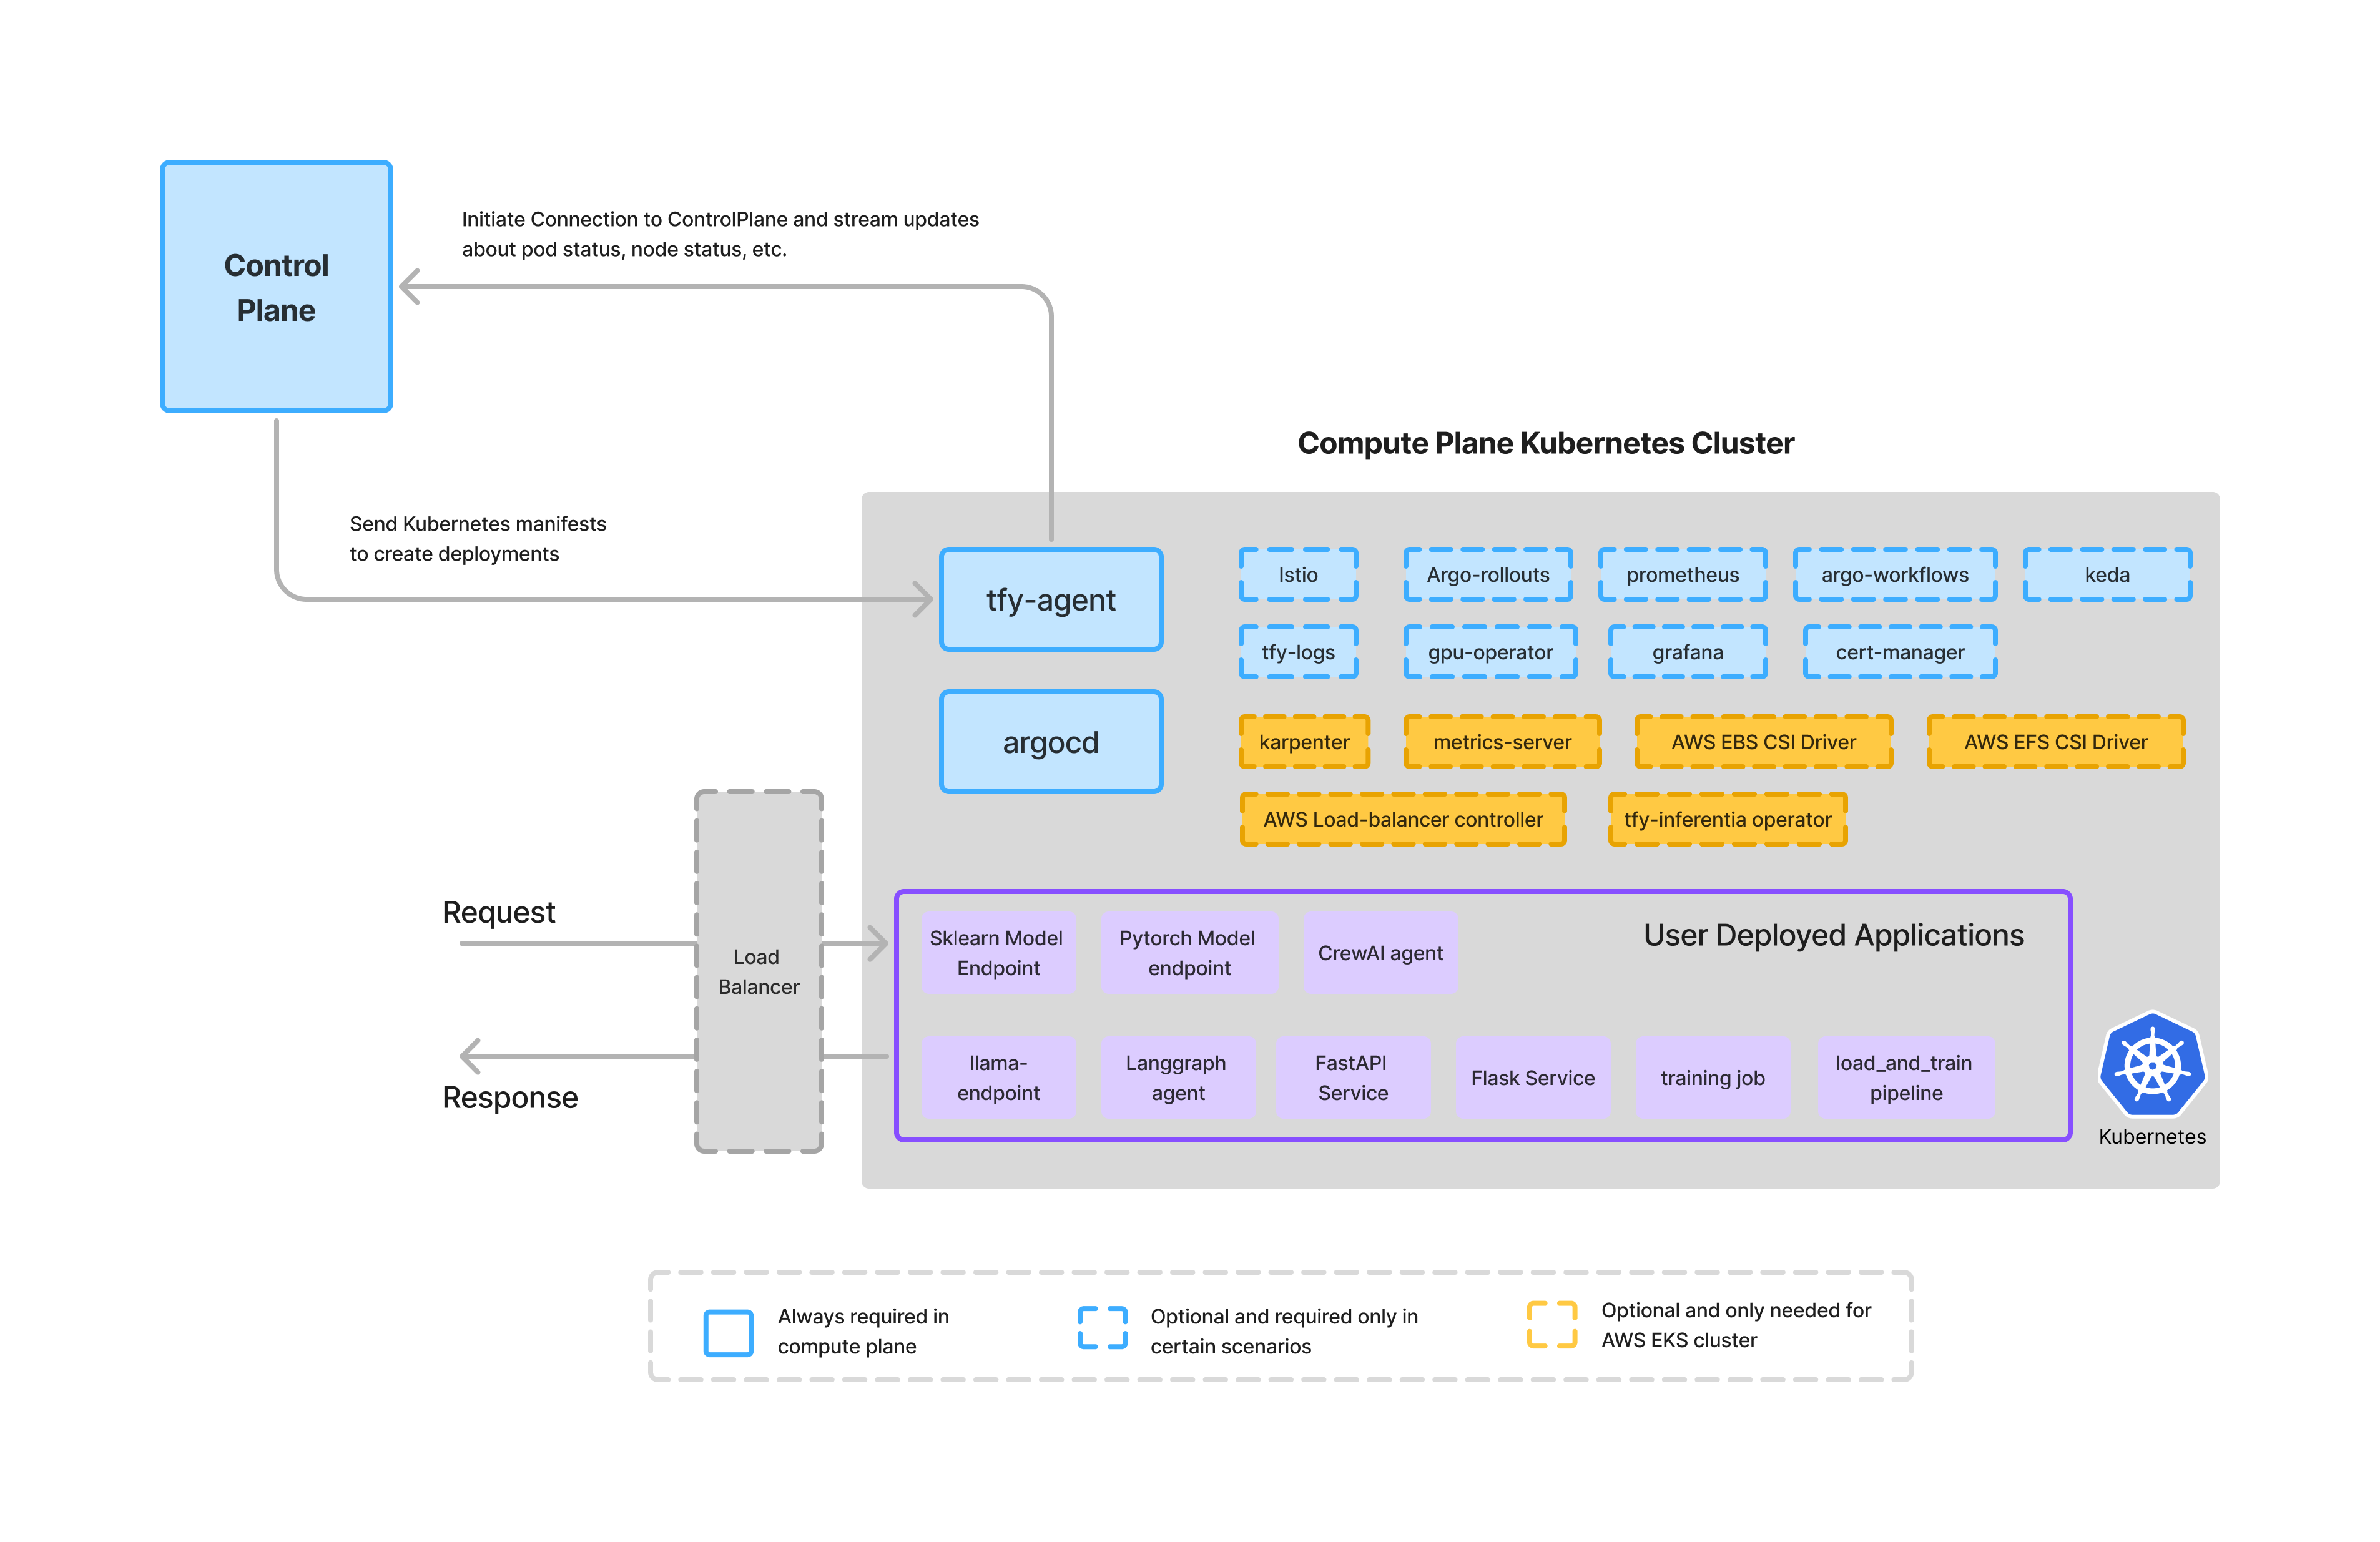
Auf der Compute Plane laufen Anwendungen, Agenten und Workloads tatsächlich.
In TrueFoundry gilt für die Compute Plane:
Dieses Design stellt sicher, dass:
TrueFoundry führt Kunden-Workloads nicht auf geteilter Compute-Infrastruktur aus. Stattdessen integriert es sich in die bestehenden Cluster des Kunden oder hilft bei der Bereitstellung neuer Cluster, wodurch die Ausführung fest innerhalb der Vertrauensgrenze der Organisation bleibt.
Diese Trennung der Ebenen ermöglicht es TrueFoundry, Datenresidenz ohne Kompromisse durchzusetzen:
Da die Durchsetzung am Gateway erfolgt – wo Routing, Wiederholungsversuche, Agenten und Protokolle zusammenlaufen –, gilt die Datenresidenz selbst bei:
Dies ermöglicht es, dass Datenresidenz zu einer Systemeigenschaft wird und nicht zu einer bloßen Annahme, die an Bereitstellungsdiagramme gebunden ist.
Datenresidenz in KI-Systemen ist kein einzelner Schalter – sie muss über Ausführung, Routing und Speicher hinweg durchgesetzt werden. In TrueFoundry wird dies durch drei sich ergänzende Durchsetzungsmodi erreicht, die gemeinsam den gesamten Lebenszyklus von KI-Daten abdecken.
Jeder Modus adressiert eine andere Klasse von Residenzrisiken und kann unabhängig oder in Kombination verwendet werden, je nach den Anforderungen des Unternehmens.
Für Organisationen mit den strengsten Residenz- und Compliance-Anforderungen ermöglicht TrueFoundry ein Bereitstellungsmodell, bei dem Daten die Umgebung des Kunden niemals verlassen.
In diesem Modus gilt:
Dies gilt sowohl für:
Indem sichergestellt wird, dass Ausführungs- und Datenpfade vollständig innerhalb der vom Kunden kontrollierten Infrastruktur verbleiben, bietet dieser Modus die stärkstmöglichen Residenzgarantien und vereinfacht regulatorische Audits.
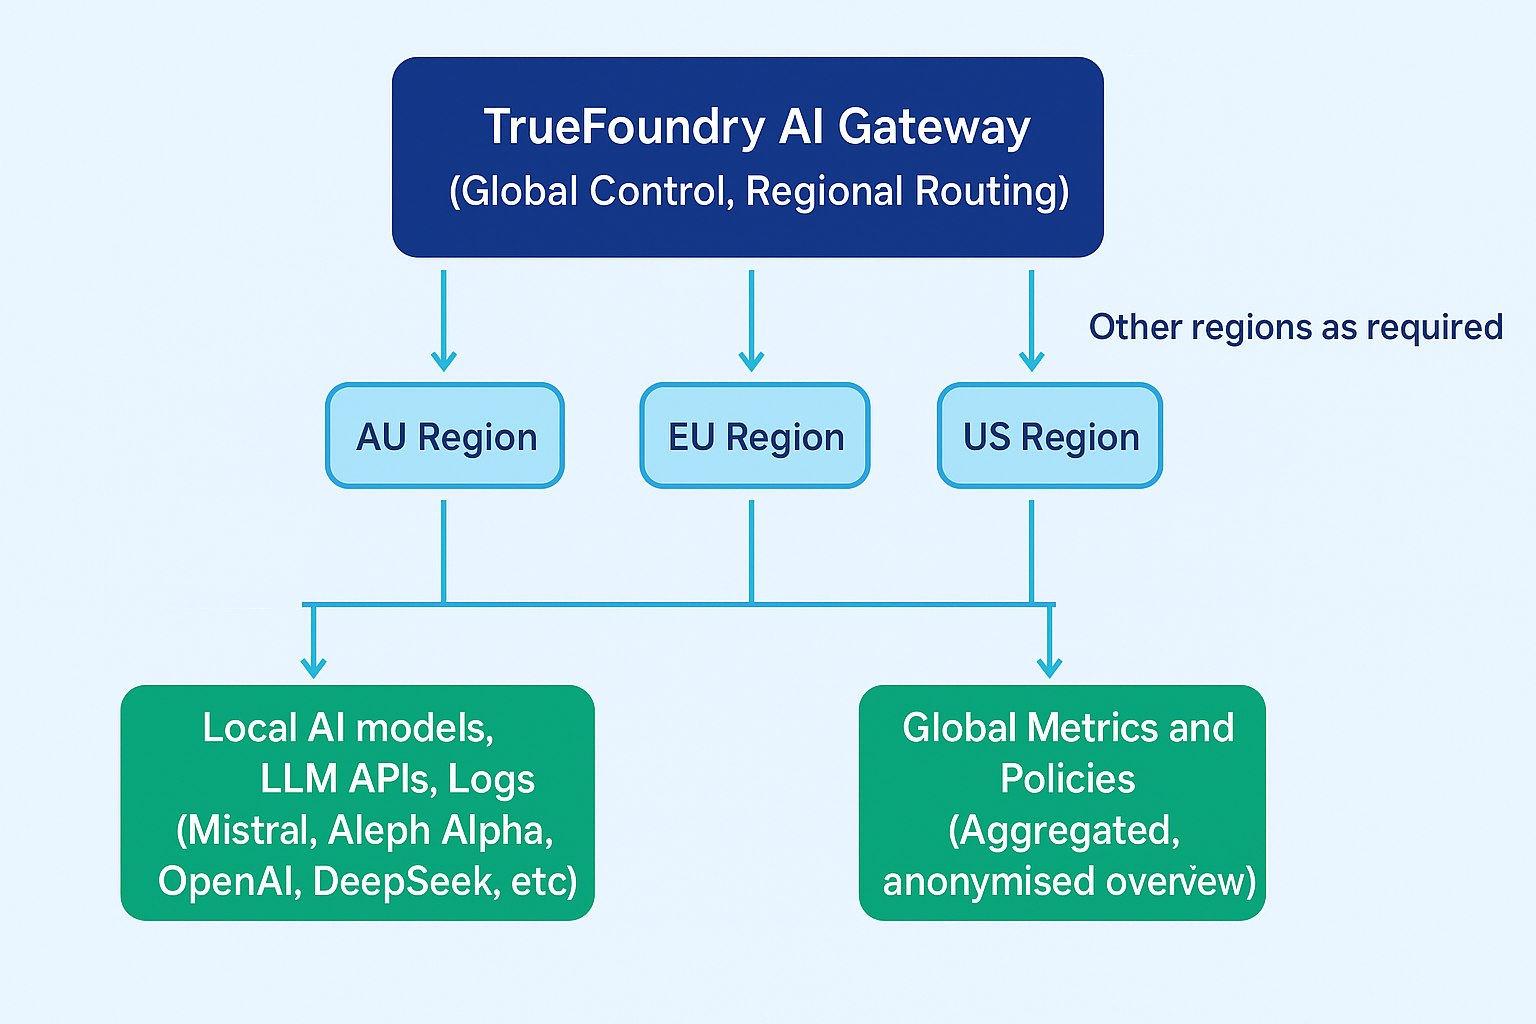
Viele Unternehmen müssen global agieren und gleichzeitig sicherstellen, dass Daten für eine bestimmte Geografie niemals zuständigkeitsbezogene Grenzen überschreiten.
TrueFoundry setzt dies durch regionsspezifische AI-Gateway-Bereitstellungen durch:
Anwendungen wählen explizit aus, welcher regionale Gateway-Endpunkt verwendet werden soll. Das macht die Datenresidenz:
Wenn für eine Anfrage kein ressourcen- und residenzkonformer Ausführungspfad existiert, bricht das Gateway die Anfrage sicher ab (Fail-Closed), anstatt sie in eine andere Region zu routen. Dies stellt sicher, dass Verfügbarkeitsmechanismen niemals die Compliance-Absicht außer Kraft setzen.
Inferenz und Ausführung sind nur ein Teil der Datenresidenz. Protokolle, Traces, Prompts und Telemetrie enthalten oft ebenso sensible Informationen und müssen denselben Residenzregeln folgen.
TrueFoundry ermöglicht es Unternehmen, die Residenz auf der Speicherschicht durchzusetzen, indem:
Dies macht es möglich:
Da diese Speicherentscheidungen direkt in das AI Gateway und die SDK-Konfiguration integriert sind, folgen Observability-Daten denselben Residenzgarantien wie der Inferenzverkehr.
Jeder Durchsetzungsmodus löst ein anderes Problem:
Zusammen stellen sie sicher, dass die Datenresidenz durchgesetzt wird:
Dieser vielschichtige Ansatz ermöglicht es TrueFoundry, Datenresidenz von einer unverbindlichen Konfiguration in eine überprüfbare, zur Laufzeit durchgesetzte Systemeigenschaft zu verwandeln.
In TrueFoundry wird die Datenresidenz durch mehrere, explizite Schichten innerhalb des AI Gateway durchgesetzt, von denen jede eine andere Klasse von Laufzeitrisiken abdeckt.
Diese Schichten arbeiten zusammen, um sicherzustellen, dass die Residenzgarantien unter realen Bedingungen bestehen bleiben.
In KI-Systemen gelten Garantien zur Datenresidenz nur dann, wenn sie zur Laufzeit über jeden Ausführungspfad hinweg durchgesetzt werden – nicht nur während des Normalbetriebs. In TrueFoundry ist das AI Gateway der Durchsetzungspunkt, an dem Routing-Entscheidungen, Wiederholungsversuche, Agentenausführung und Observability zusammenlaufen.
Die folgenden Mechanismen erklären, wie die Datenresidenz determiniert im TrueFoundry AI Gateway durchgesetzt wird.
Modelle in TrueFoundry werden mit expliziter Regionsaffinität registriert. Das AI Gateway wertet Residenzbeschränkungen vor dem Routing jeder Anfrage aus und wählt nur Modell-Endpunkte aus, die für die zulässige Region des Workloads berechtigt sind.
Dies verhindert:
Da Residenz als harte Routing-Einschränkung und nicht als Präferenz behandelt wird, werden nicht-konforme Modelle niemals in Betracht gezogen – selbst wenn sie verfügbar oder schneller sind.
Wiederholungsversuche und Failover-Pfade sind die häufigste Quelle für stillschweigende Verstöße gegen die Datenresidenz in KI-Systemen.
Das AI Gateway von TrueFoundry setzt Folgendes durch:
Dies stellt sicher, dass Verfügbarkeitsmechanismen niemals die Compliance-Absicht außer Kraft setzen. Wenn kein konformer Pfad verfügbar ist, schlägt das System explizit fehl, anstatt Daten über Regionen hinweg zu routen.
Bei agentischen Workloads muss die Datenresidenz über die Modellinferenz und nachgelagerte Tool-Aufrufe hinweg konsistent bleiben.
TrueFoundry setzt Folgendes durch:
Dies eliminiert ein häufiges Fehlermuster, bei dem die Inferenz zwar konform bleibt, Agenten aber Daten indirekt über Tools oder MCP-Server lecken lassen, die in anderen Regionen bereitgestellt sind.
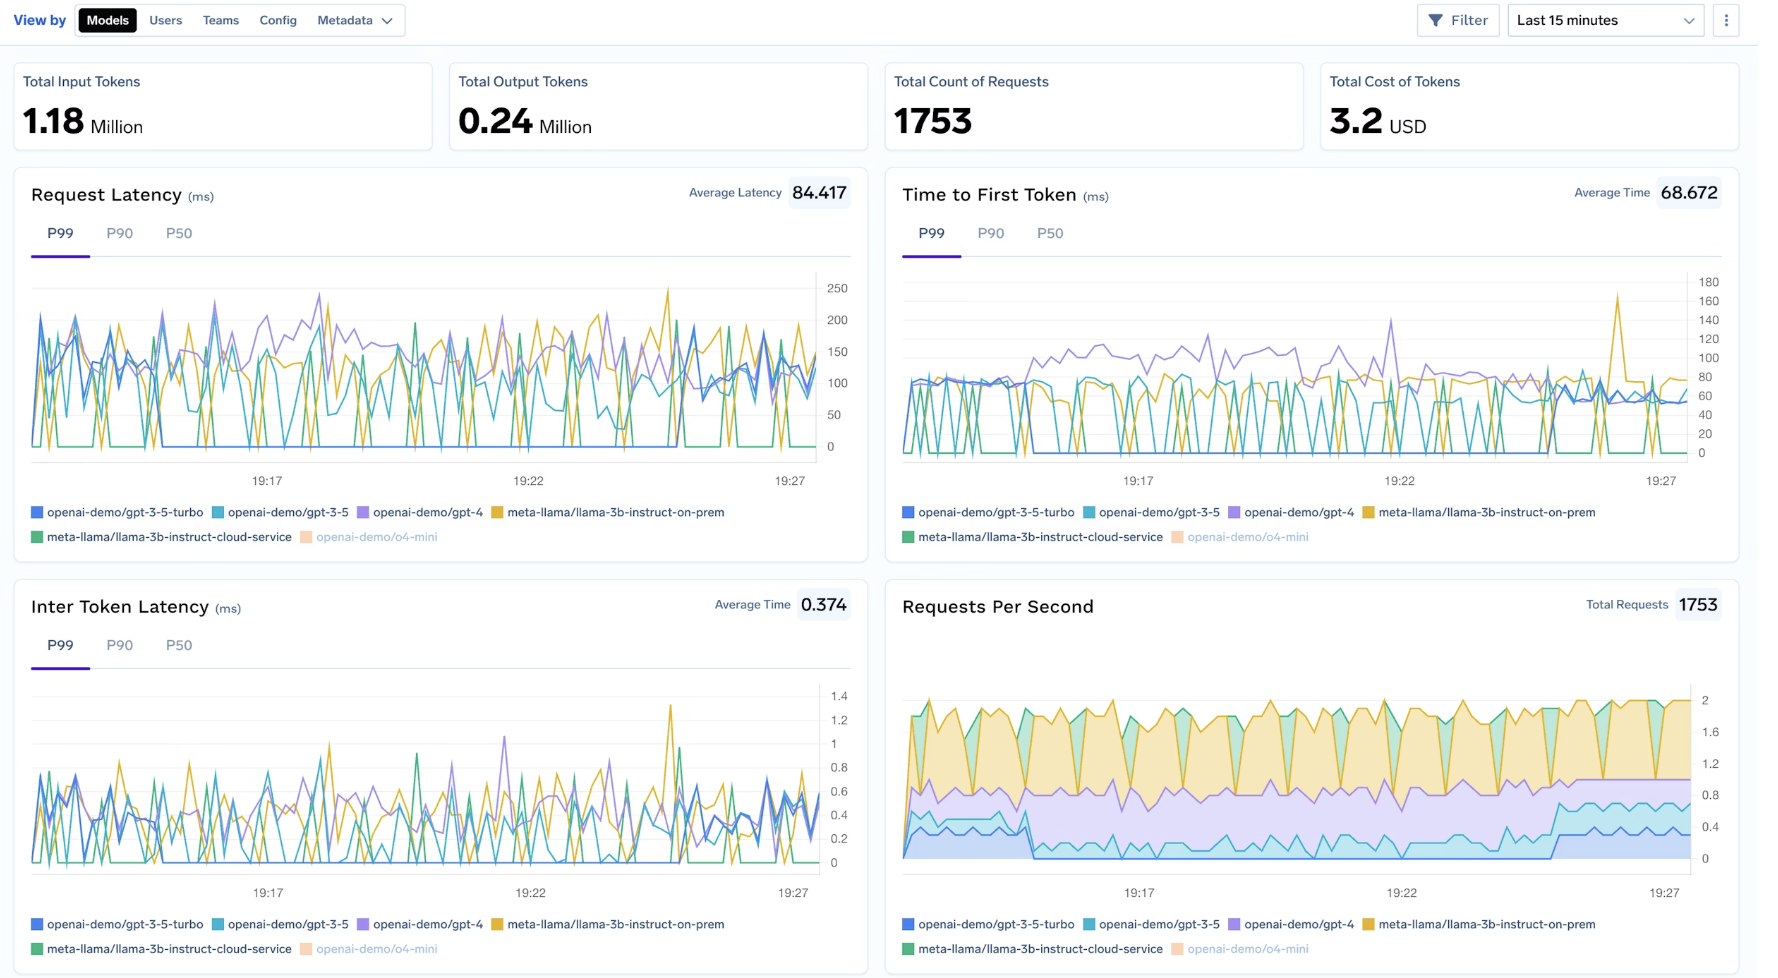
Observability-Pipelines werden bei Konzepten zur Datenresidenz häufig übersehen, obwohl sie oft hochsensible Daten enthalten.
Das AI Gateway von TrueFoundry stellt sicher, dass:
Dies schließt eine der hartnäckigsten Residenzlücken in KI-Systemen, bei denen die Inferenz konform ist, die Protokolle und Traces jedoch nicht.
Diese Durchsetzungsmechanismen gelten einheitlich für:
Da die Durchsetzung vor der Ausführung erfolgt, wird die Datenresidenz zu einer überprüfbaren Systemeigenschaft und nicht zu einer unverbindlichen Konfiguration, die an die Platzierung der Infrastruktur gebunden ist.
Die meisten Verstöße gegen die Datenresidenz in KI-Systemen werden nicht durch offensichtliche Fehlkonfigurationen verursacht. Sie entstehen aus Grenzfällen und Ausnahme-Pfaden, die selten getestet werden, bis etwas schiefgeht.
Nachfolgend finden Sie die häufigsten Ausfallszenarien, mit denen Unternehmen konfrontiert sind, und wie das TrueFoundry AI Gateway entwickelt wurde, um diese zu verhindern.
Was in vielen Systemen passiert
Ein regionaler Modell-Endpunkt wird宿unverfügbar. Das AI Gateway versucht es automatisch erneut oder führt ein Failover auf den nächsten verfügbaren Endpunkt durch – oft in einer anderen Region.
Aus Sicht der Verfügbarkeit sieht das wie ein Erfolg aus.
Aus Sicht der Compliance ist es ein stillschweigender Verstoß.
Wie TrueFoundry dies verhindert
Dies stellt sicher, dass Verfügbarkeitsmechanismen niemals die Residenzrichtlinie außer Kraft setzen.
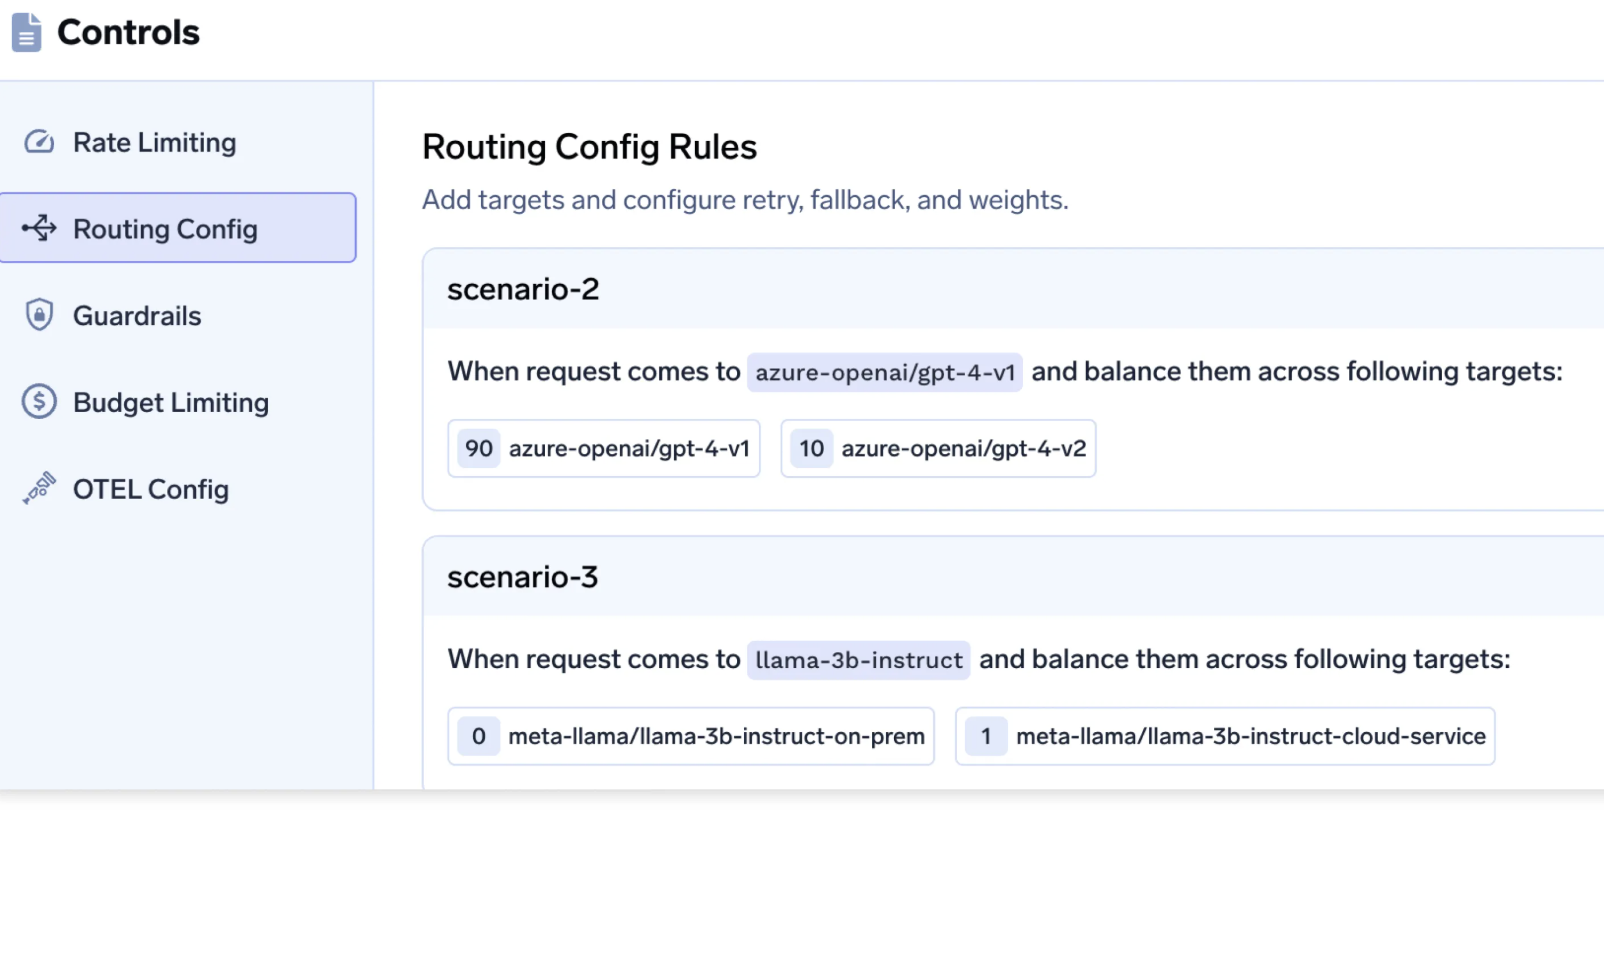
Was in vielen Systemen passiert
Einige Modelle werden in der Region bereitgestellt, während andere (oft Backups oder neuere Modelle) global gehostet werden. Routing-Richtlinien wählen unbeabsichtigt nicht-residente Modelle aus.
Wie TrueFoundry dies verhindert
Dies macht Residenzgarantien widerstandsfähig gegenüber Modellwechseln und Experimenten.
Was in vielen Systemen passiert
Die Inferenz läuft lokal, aber Agenten rufen Tools oder MCP-Server auf, die in anderen Regionen bereitgestellt sind, was zu indirekten Datenbewegungen führt.
Wie TrueFoundry dies verhindert
Dadurch bleibt die Residenz über die Inferenz und die nachgelagerte Ausführung hinweg konsistent.
Was in vielen Systemen passiert
Prompts, Antworten und Traces werden an zentrale Protokollierungs- oder Überwachungsdienste außerhalb der Region exportiert – oft standardmäßig.
Wie TrueFoundry dies verhindert
Dies schließt eine der am häufigsten übersehenen Compliance-Lücken in KI-Systemen.
Residenzgarantien sind nur dann sinnvoll, wenn sie überprüft und nachgewiesen werden können. TrueFoundry ermöglicht es Unternehmen, die Datenresidenz durch Sichtbarkeit und Prüfbarkeit zur Laufzeit zu validieren, anstatt durch nachträgliche Annahmen.
Das AI Gateway bietet Einblick in:
Dies ermöglicht es Teams zu bestätigen, dass jeder Ausführungspfad konform geblieben ist.
Für Compliance- und Sicherheitsprüfungen stellt TrueFoundry bereit:
Dies ermöglicht es, die Residency bei Audits zu beweisen, anstatt sich allein auf Architekturdiagramme zu verlassen.
Ein entscheidender Vorteil der Durchsetzung auf Gateway-Ebene ist die Testbarkeit.
Unternehmen können:
Dadurch wird Residency von einer statischen Anforderung zu einer kontinuierlich verifizierbaren Systemeigenschaft.
In modernen AI-Systemen kann Data Residency nicht durch Deployment-Entscheidungen allein gewährleistet werden. Dynamisches Routing, Retries, Agent-Workflows und Observability-Pipelines führen alle Ausführungspfade ein, über die Daten stillschweigend regionale Grenzen überschreiten können.
Das AI Gateway ist die einzige Schicht mit ausreichend Kontext, um dies zu verhindern. Es sieht jeden Inference-Request, jeden Retry, jede Agent-Aktion und jeden Trace, der vom System gesendet wird. Wenn Residency hier nicht durchgesetzt wird, kann sie nirgendwo sonst konsistent durchgesetzt werden.
In TrueFoundry wird Data Residency als eine Laufzeit-Systemeigenschaft behandelt. Ausführungspfade sind konzeptionell eingeschränkt, Ausnahmefälle reagieren Fail-Closed, und die Durchsetzung ist beobachtbar und auditierbar. Dies macht Residency-Garantien nicht nur im Normalbetrieb belastbar, sondern auch bei Ausfällen, Skalierung und Änderungen.
Für Unternehmen, die AI in regulierten oder multi-regionalen Umgebungen einsetzen, ist dieser Unterschied entscheidend. Data Residency ist kein einfaches Häkchen mehr – es ist ein architekturelles Versprechen. Und das AI Gateway ist der Ort, an dem dieses Versprechen Realität wird.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















