Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.
9,9
Kostenaspekte bei der Nutzung eines AI Gateway: Enterprise AI-Ausgaben optimieren
Die Verwaltung der Kosten für die Nutzung großer Sprachmodelle (LLM) ist zu einem betriebskritischen Anliegen für Unternehmen geworden, die AI in großem Maßstab einsetzen. Im Gegensatz zu traditioneller Software nutzen LLM-basierte Dienste häufig ein token-basiertes Preismodell – Anbieter rechnen pro Input-/Output-Token ab –, was die Budgetierung schwer vorhersehbar oder steuerbar macht. Mehrere Faktoren tragen zu dieser Komplexität bei:
Unterschiedliche Modellpreise: Jeder LLM-Anbieter (OpenAI, Anthropic, Cohere usw.) oder jede Modellgröße hat ihren eigenen Tarif pro Token, wobei größere Modelle (z. B. der GPT-4-Klasse) pro Token deutlich mehr kosten als kleinere.
Unvorhersehbare Nutzungsmuster: Der Token-Verbrauch kann je nach Benutzer, Funktion oder Workflow drastisch variieren – eine Funktion könnte stillschweigend 10-mal mehr Token verbrauchen als eine andere, und die Nutzung kann durch Benutzerverhalten unerwartet in die Höhe schnellen.
Dynamische Prompt-Pipelines: Fortschrittliche Anwendungsfälle wie Retrieval-Augmented Generation (RAG), Tool-nutzende Agenten oder mehrstufige Ketten können unbeabsichtigt die Prompt-Größe und Antwortlänge vergrößern, was die erforderlichen Token (und Kosten) pro Anfrage vervielfacht.
Das Ergebnis ist, dass Teams ohne angemessene Transparenz und Kontrollen oft erst dann merken, wie schnell sich die Kosten anhäufen, wenn die Rechnung eintrifft. Es ist nicht ungewöhnlich, dass die Ausgaben unerwartet explodieren, was Projektbudgets gefährdet und Skalierungsbemühungen behindert. Ein aktueller Gartner-Bericht warnt ebenfalls davor, dass ein Mangel an Kostentransparenz und Governance schnell zu Budgetüberschreitungen bei AI-Initiativen führen kann. Kurz gesagt: Wenn Unternehmen LLMs in Produkte integrieren, ist die Kontrolle der Nutzungskosten genauso kritisch wie die Modellgenauigkeit oder die Betriebszeit. Token-basierte Preisgestaltung bringt Unsicherheit mit sich, die den ROI ruinieren kann, sofern sie nicht aktiv gemanagt wird.
Hier kommt das Konzept eines AI Gateway ins Spiel. Ein AI Gateway etabliert sich als eine Schlüsselkomponente, um die Kontrolle über die LLM-Nutzung und die Ausgaben zurückzugewinnen. Bevor wir uns mit Kostentreibern und Lösungen befassen, definieren wir, was ein AI Gateway ist und wie es die Kosten beeinflusst.
Was ist ein AI Gateway? (Und wie beeinflusst es die Kosten?)
Ein AI Gateway ist eine spezialisierte Middleware-Schicht, die alle Interaktionen zwischen Ihren Anwendungen und mehreren AI-Modellen oder -Anbietern verwaltet. Stellen Sie es sich wie ein API-Gateway vor, das speziell für AI-Workloads entwickelt wurde — eines, das modellspezifische Nuancen wie token-basierte Abrechnung, Inferenz-Latenz und dynamisches Routing versteht. Es bietet einen einheitlichen Endpunkt für alle AI-Anfragen und leitet den Datenverkehr basierend auf Richtlinien für Kosten, Leistung oder Verfügbarkeit intelligent an das richtige Modell-Backend weiter.
Hinzufügen eines Gateways bringt zwar geringfügigen Overhead mit sich – wie Hosting-Kosten und Konfigurationsaufwand –, diese werden jedoch durch die Kontrolle und Transparenz, die es bietet, bei Weitem aufgewogen. Durch das Routing jeder Anfrage über eine einzige Schicht können Unternehmen die Nutzung überwachen, Budgets durchsetzen und Echtzeit-Entscheidungen darüber treffen, welches Modell den besten Kosten-Leistungs-Kompromiss bietet. Gartner beschreibt AI Gateways als „intelligente Verkehrsregler“, die Unternehmen dabei helfen, die Modellnutzung über Anwendungen hinweg zu bewerten und zu optimieren.
TrueFoundrys AI Gateway fungiert als diese Control Plane, die den Zugriff über Modelle und Anbieter hinweg vereinheitlicht und gleichzeitig Enterprise-Richtlinien wie Zugriffskontrolle, Kosten-Governance, Caching und Observability durchsetzt. Es verwandelt den AI-Verbrauch von einer unvorhersehbaren Ausgabe in ein verwaltetes, messbares und optimierbares System.
Wichtige Kostentreiber bei der LLM-Nutzung
Beim Einsatz großer Sprachmodelle in der Produktion bestimmen mehrere Schlüsselfaktoren die Gesamtkosten des Betriebs. Das Verständnis dieser Treiber ist der erste Schritt zur Verwaltung und Reduzierung LLM-bezogener Kosten:
Modellauswahl und -größe: Die Wahl des Modells hat einen überproportionalen Einfluss auf die Kosten. Größere, fortschrittlichere Modelle (mit höherer Parameteranzahl oder mehr Fähigkeiten) haben in der Regel viel höhere Kosten pro Token. Beispielsweise können GPT-4 oder andere „Reasoning“-Modelle eine Größenordnung mehr pro Token kosten als kleinere Modelle. Die Verwendung eines Spitzenmodells für jede einzelne Anfrage – einschließlich trivialer Abfragen – treibt die Kosten unnötig in die Höhe.
Token-Nutzung (Prompt- und Antwortlänge): Die Anzahl der in Prompts gesendeten Token zuzüglich der in Antworten generierten Token treibt die Abrechnung direkt an. Lange Gespräche oder Dokumente, extrem lange Kontextfenster oder unoptimierte Prompts, die irrelevante Informationen enthalten, lassen die Token-Zahl steigen. Funktionen wie die Aufforderung an das Modell, ausführlich zu antworten oder umfangreiche Erklärungen zu liefern, können die Nutzung exponentiell steigern. Effektives Prompt Engineering, um Prompts kurz und Ausgaben fokussiert zu halten, kann die Kosten erheblich senken. Jedes Token zählt, wenn Sie Bruchteile eines Cents pro Token Millionen Mal bezahlen.
Verkehrsvolumen und -muster: Wie oft und wie weit verbreitet AI-Funktionen genutzt werden, wirkt sich offensichtlich auf die Kosten aus – aber es ist nicht nur das Gesamtvolumen, sondern das Muster. Spitze, unvorhersehbare Zugriffe können in Spitzenzeiten Kosten verursachen, die das Monatsbudget sprengen. Die Variabilität zwischen Benutzern oder Funktionen bedeutet, dass einige wenige Power-User oder ein internes Tool heimlich den Großteil der Token verbrauchen könnten. Plötzliche Nutzungsspitzen (z. B. eine neue Funktion, die viral geht) können zu ungeplanten Rechnungen führen, wenn sie nicht gedrosselt werden. Die Skalierung der Nutzung ohne Skalierung der Kostenüberwachung ist ein Rezept für Überschreitungen.
Multi-Modell-Nutzung und Anbieterauswahl: Viele Teams nutzen einen Mix aus Modellen – zum Beispiel ein Open-Source-Modell für einige Aufgaben und eine proprietäre API für andere oder verschiedene Anbieter für verschiedene Sprachen. Jedes Modell / jeder Anbieter kann unterschiedliche Preiseinheiten haben (einige berechnen pro 1000 Token, andere pro Anfrage usw.) und möglicherweise zusätzliche Gebühren erheben. Wenn ein Team außerdem „zur Sicherheit“ immer standardmäßig das teuerste Modell wählt, verpasst es Einsparmöglichkeiten. Die Auswahl des richtigen Modells für jede Aufgabe ist ein wesentlicher Kostenhebel: Eine einfache Abfrage benötigt kein teures 175B-Parameter-Modell, wenn es ein kleineres (und günstigeres) Modell auch täte. Umgekehrt können einige komplexe Aufgaben die Kosten eines überlegenen Modells rechtfertigen. Die Strategie (oder deren Fehlen) beim Routing des Datenverkehrs zu Modellen ist ein großer Kostentreiber.
Infrastruktur und Overhead: Es fallen auch Kosten an, die über die Gebühren pro Token hinausgehen. Wenn Sie Open-Source-LLMs selbst hosten, um API-Kosten zu vermeiden, zahlen Sie in Form von Infrastruktur – GPU-Server, Speicher, Wartung und MLOps-Aufwand. Wie eine Analyse prägnant auf den Punkt brachte: „Open-Source-LLMs sind nicht kostenlos – sie verlagern die Rechnung lediglich von der Lizenzierung auf Engineering, Infrastruktur, Wartung und strategisches Risiko.“ Selbst bei der Nutzung von Cloud-APIs benötigen Sie möglicherweise zusätzliche Infrastruktur zur Bearbeitung von Anfragen (z. B. den Betrieb eines internen Dienstes oder Gateways, Vektordatenbanken für RAG usw.), was Cloud-Compute-Kosten verursacht. Integrations-Overhead und Engineering-Zeit sind „versteckte“ Kosten, die schleichend steigen können.
Lizenz- oder Abonnementsgebühren: Einige Modelle und Dienste bringen feste Gebühren zusätzlich zur Nutzung mit sich. Beispielsweise erfordern bestimmte Enterprise AI-APIs ein monatliches Abonnement oder eine Mindestabnahme. Selbst Open-Source-Modelle können Lizenzbeschränkungen aufweisen, die Unternehmen zu kostenpflichtigen Optionen drängen. Wenn Sie eine proprietäre Modellbereitstellungsplattform nutzen, können Lizenzkosten anfallen. Diese Gebühren müssen in die Gesamtkosten des Betriebs (TCO) für die Nutzung eines bestimmten Modells einbezogen werden – manchmal kann ein „pro Token günstigeres“ Modell eine teure Lizenz erfordern, was die Einsparungen zunichtemacht.
Integrations- und Ineffizienzkosten: Schließlich kann die Art und Weise, wie Sie AI in Ihre Systeme integrieren, zu Kostenineffizienzen führen. Redundante Aufrufe, fehlendes Caching oder schlechtes Lastmanagement können Token verschwenden. Frühe Anwender in Unternehmen stellten fest, dass die Verwendung eines Standard-API-Gateways oder einer Ad-hoc-Integration zu erheblichen Kostenüberschreitungen führte – in einigen Fällen 300 % über den ursprünglichen Prognosen –, weil die Tools AI-spezifische Optimierungen wie das Caching ähnlicher Prompts oder den Lastausgleich über Modelle hinweg nicht berücksichtigten. Der Aufbau und die Wartung einer eigenen Infrastruktur für Multi-Modell-Zugriff und -Überwachung verursachen Kosten. Wenn jedes Team unabhängig AI-APIs aufruft, verpassen Sie Skaleneffekte und zentrale Aufsicht, was oft zu höheren Gesamtausgaben führt als nötig (zum Beispiel, wenn mehrere Teams dasselbe Modell mit derselben Anfrage aufrufen und doppelt bezahlen).
Das Verständnis dieser Kostentreiber verdeutlicht, warum es nicht ausreicht, Teams einfach Zugriff auf eine LLM API zu gewähren – ungesteuerte Nutzung über viele Apps und Benutzer hinweg führt fast zwangsläufig zu Überraschungen. Je betriebskritischer und weitverbreiteter die AI-Nutzung ist, desto größer ist der Bedarf an Governance. Hier beweisen AI Gateways ihren Wert: Sie setzen direkt an diesen Kostentreibern an und bieten Mechanismen, um die Kosten einzudämmen, ohne Leistung oder Zuverlässigkeit zu opfern.
LLM-Kosten mit einem AI Gateway verwalten und reduzieren
Ein AI Gateway bietet eine Reihe von Tools und intelligenten Strategien, um die oben genannten Kostentreiber anzugehen. Es dient als zentrale Kosten-Governance-Schicht für die gesamte AI-Nutzung. Laut Gartner können AI Gateways das Risiko „ausufernder AI-Kosten aufgrund schlechter Governance“ mindern, indem sie als Kontrollpunkt zwischen AI-Konsumenten und -Anbietern agieren. Das AI Gateway von TrueFoundry enthält beispielsweise zahlreiche Funktionen zur Überwachung und Optimierung der Kosten. Lassen Sie uns tief in die Frage eintauchen, wie ein AI Gateway hilft, LLM-Kosten zu verwalten und zu reduzieren:
Einheitliche Kostentransparenz: Alle Anfragen werden über das Gateway geroutet, das detaillierte Nutzungsmetriken für jeden Aufruf protokolliert – verwendetes Modell, verbrauchte Token, Latenz, Zuordnung zu Benutzern/Teams usw. Dies bietet eine granulare Echtzeit-Transparenz darüber, wohin Ihre Token-Dollars fließen. Führungskräfte können endlich präzise beantworten, „welche Anwendungen oder Use Cases den Großteil unserer OpenAI-Rechnung verursachen“. Diese anwendungsübergreifende Transparenz ist nahezu unmöglich zu erreichen, wenn Teams Modelle direkt aufrufen. Mit einem Gateway erhalten Sie ein Dashboard als Single Source of Truth für AI-Nutzung und -Ausgaben. Eine solche Transparenz ermöglicht Chargeback-/Showback-Abrechnungen (Kostenzuweisung an Abteilungen), was wiederum die Verantwortlichkeit fördert.
Budgetdurchsetzung & Guardrails: Transparenz allein reicht nicht aus – das Gateway setzt auch Richtlinien durch, um eine ausufernde Nutzung zu verhindern. Sie können Rate Limits und Quoten definieren (z. B. nicht mehr als N Token oder X $ Ausgaben pro Tag für einen bestimmten Benutzer oder eine Funktion), und das Gateway wird darüber hinausgehende Anfragen ablehnen oder drosseln. Dies stellt sicher, dass ein fehlerhaftes Skript oder eine unerwartete Nutzungsspitze nicht das Budget sprengt. Sie können auch Budget-Alerts oder automatische Abschaltregeln einrichten: Wenn die monatliche Nutzung eines Teams einen Schwellenwert überschreitet, kann das Gateway Benachrichtigungen senden oder weitere Aufrufe vorübergehend blockieren, bis sie genehmigt werden, was überraschende Rechnungen verhindert. Darüber hinaus ermöglichen Gateways Zugriffskontrollen und Modellbeschränkungen – zum Beispiel können Sie festlegen, dass teure Modelle wie GPT-4 nur von bestimmten kritischen Workflows verwendet werden dürfen, während weniger kritische Nutzungen auf günstigere Modelle beschränkt sind. Eine weitere Form von Guardrails ist das Prompt-Filtering: das Blockieren von Prompts, die extrem lange Ausgaben oder anderweitig kostspielige Anfragen auslösen würden. Durch die zentrale Anwendung dieser Governance-Regeln schaffen Unternehmen harte Grenzen für ihr Kostenrisiko.
Wichtige Metriken zur Bewertung eines Gateways
Kriterium
Was sollten Sie bewerten?
Priorität
TrueFoundry
Latenz
Fügt <10ms p95 Overhead für Time-to-First-Token hinzu?
Must Have
✅ Unterstützt
Datenresidenz
Hält Logs innerhalb Ihrer Region (EU/US)?
Abhängig vom Use Case
✅ Unterstützt
Latenzbasiertes Routing
Routet automatisch basierend auf Echtzeit-Latenz/Ausfällen um?
Must Have
✅ Unterstützt
Schlüsselrotation & Widerruf
Schlüssel ohne Ausfallzeit rotieren oder widerrufen?
Must Have
✅ Unterstützt
Schlüsselrotation & Widerruf
Schlüssel ohne Ausfallzeit rotieren oder widerrufen?
Must Have
✅ Unterstützt
Schlüsselrotation & Widerruf
Schlüssel ohne Ausfallzeit rotieren oder widerrufen?
Must Have
✅ Unterstützt
Schlüsselrotation & Widerruf
Schlüssel ohne Ausfallzeit rotieren oder widerrufen?
Must Have
✅ Unterstützt
Schlüsselrotation & Widerruf
Schlüssel ohne Ausfallzeit rotieren oder widerrufen?
Must Have
✅ Unterstützt
Bewerten Sie ein AI Gateway?
Ein praktischer Leitfaden für Plattform- & Infra-Teams
Intelligentes Modell-Routing: Der vielleicht größte Kostensparer ist die Fähigkeit des Gateways, jede Anfrage dynamisch an das optimale Modell oder den optimalen Anbieter zu routen, basierend auf dem Kontext. Anstelle von Einheitslösungen kann das Gateway Faktoren wie die Komplexität der Abfrage, die erforderliche Genauigkeit, Latenz und Kosten bewerten und dann das Modell auswählen (oder sogar automatisch wechseln), das die Anforderungen zum niedrigsten Preis am besten erfüllt. Beispielsweise könnte eine einfache Faktenfrage von einem kleineren, günstigeren Modell ohne spürbaren Qualitätsunterschied beantwortet werden, während eine komplexe Aufgabe an ein leistungsfähigeres Modell gesendet wird. Diese Art der Modellauswahl in Echtzeit senkt die Kosten drastisch, indem Overkill vermieden wird. Das AI Gateway von TrueFoundry setzt dies über intelligente Routing-Regeln und Load Balancing um: Sie können es so konfigurieren, dass Abfragen standardmäßig aus Geschwindigkeits- und Kostengründen an ein Open-Source-Modell wie Mistral gehen, aber wenn der Prompt komplex erscheint oder das Vertrauen des kleineren Modells gering ist, routet das Gateway diese Anfrage an ein größeres Modell wie GPT-4. Über Hunderte von Tausenden von Anfragen hinweg kann dieses adaptive Routing massive Einsparungen erzielen und gleichzeitig die Gesamtqualität aufrechterhalten. Es überwindet die falsche Dichotomie, sich entweder für ein Hochleistungs- oder ein kostengünstiges Modell entscheiden zu müssen – Sie können beides haben, indem Sie jedes dort einsetzen, wo es Sinn macht.
Antwort-Caching: Eine weitere Kostenoptimierung ist das Caching wiederholter oder häufiger AI-Antworten. Wenn mehrere Benutzer dieselbe Frage stellen oder Ihr System wiederholt identische Abfragen durchführt, kann ein AI Gateway eine gecachte Antwort zurückgeben, anstatt das Modell erneut aufzurufen, wodurch diese Token vollständig eingespart werden. Selbst das Caching von Teilergebnissen (wie teuren Zwischenschritten) kann helfen. Dies ist besonders nützlich für Backend-Aufgaben oder Apps, bei denen derselbe Prompt häufig verwendet wird. Caching reduziert nicht nur die Kosten, sondern verbessert auch die Latenz für diese Abfragen. Das Gateway von TrueFoundry unterstützt sowohl einfaches Caching als auch fortschrittlicheres semantisches Caching – bei dem semantisch ähnliche Prompts als Cache-Hits behandelt werden können. (Semantisches Caching muss vorsichtig verwendet werden, da subtile Unterschiede in Prompts die Antwort verändern könnten, aber in den richtigen Szenarien kann es die Cache-Hit-Raten steigern und die Kosten senken.) Studien haben gezeigt, dass semantische Caching-Mechanismen die LLM-API-Kosten in Enterprise-Use-Cases um bis zu 70 % senken können. In der Praxis bietet selbst ein einfacherer Cache für identische Anfragen ein erhebliches Kostenpolster für hochfrequente Apps.
Observability & Anomalieerkennung: Da das Gateway alle Anfragen überwacht, kann es auch anomale Nutzungsmuster erkennen, die auf einen Fehler oder Missbrauch hinweisen könnten. Wenn diese Stunde beispielsweise die 5-fache Token-Nutzung im Vergleich zur letzten aufweist oder eine Anwendung plötzlich anfängt, das Modell mit großen Prompts zu spamen, hebt das Gateway (und seine integrierten Dashboards) diese Anomalie hervor. Eine frühzeitige Erkennung bedeutet, dass Sie eingreifen können, bevor das Budget aufgebraucht ist. Die Observability zahlt auch auf die Zuverlässigkeit ein: Sie verfolgt Fehlerraten und Latenzen und hilft so, kostenbedingte Verlangsamungen von Modellproblemen zu unterscheiden. Einige Gateways, wie das von TrueFoundry, lassen sich in Tools wie OpenTelemetry integrieren, sodass Sie LLM-Nutzungsmetriken mit Ihrem gesamten Monitoring-Stack zusammenführen können. Diese ganzheitliche Observability stellt sicher, dass Sie Kosten- und Leistungsziele einhalten. Sie ermöglicht auch interne Chargebacks – da die Nutzung zentral protokolliert wird, können Sie Teams für ihren Anteil an der AI-Rechnung verantwortlich machen, was ihnen einen Anreiz gibt, effizient zu sein.
Wie ein AI Gateway LLM-Kosten verwaltet und reduziert, indem es einheitliche Transparenz, Budgetdurchsetzung, intelligentes Modell-Routing, Caching und Observability in einer Kontrollschicht kombiniert.
Alle diese Funktionen greifen ineinander, um Kostendisziplin ohne ständige manuelle Aufsicht durchzusetzen. Durch die Verwendung eines AI Gateways wird das Kostenmanagement proaktiv und automatisiert: Sie haben Kosten-Limits eingerichtet, um Ausgabenüberhänge zu vermeiden, Sie verfügen über Echtzeit-Einblicke zur Anpassung von Nutzungsmustern und Sie nutzen automatisierte Optimierungen (Routing, Caching), die Ineffizienzen direkt im Betrieb beseitigen. Es verwandelt ein potenziell undurchsichtiges, ausuferndes Kostenstelle-Risiko in einen gesteuerten Dienst.
Das AI Gateway von TrueFoundry veranschaulicht diese Kostenkontrollen in der Praxis. Es bietet integrierte Kostentracking-Dashboards, Budgetrichtlinien-Konfiguration, Multi-Modell-Routing-Regeln und Caching-Mechanismen, die alle über eine unternehmensfreundliche Benutzeroberfläche konfiguriert werden können. Das Ergebnis ist, dass Unternehmen mehr AI-Anwendungsfälle realisieren können, ohne Angst vor unvorhersehbaren Rechnungen haben zu müssen. Natürlich bringt der Einsatz eines solchen Gateways einige Überlegungen zu Leistung und Architektur mit sich, die wir als Nächstes besprechen.
Balance zwischen Kosten, Genauigkeit, Latenz und Komplexität
Jede Strategie zur aggressiven Eindämmung von Kosten muss gegen andere technische und geschäftliche Anforderungen abgewogen werden. Kompromisse sind unvermeidbar. Im Kontext von LLM-Bereitstellungen sind die wichtigsten zu balancierenden Dimensionen Kosten, Genauigkeit (oder Ergebnisqualität), Latenz (Antwortgeschwindigkeit) und architektonische Komplexität. Ein AI Gateway hilft bei der Verwaltung dieser Kompromisse, aber das Verständnis dieser Zusammenhänge ist wichtig, um die richtigen Richtlinien festzulegen:
Kosten vs. Genauigkeit: Höherwertige Modelle bedeuten in der Regel höhere Kosten, aber nicht jede Aufgabe erfordert Reasoning auf GPT-4-Niveau. Ein kleineres 7B-Modell kann „Was ist die Hauptstadt von Frankreich?“ ebenso genau beantworten wie ein Spitzenmodell, eine komplexe rechtliche Frage jedoch nicht. Der Schlüssel liegt in der Nutzung der Routing-Intelligenz des Gateways, um zu entscheiden, wann Premium-Genauigkeit den Preis wert ist. Leiten Sie alltägliche Aufgaben an kleinere Modelle weiter und reservieren Sie High-End-Modelle für komplexes Reasoning. Im Laufe der Zeit helfen Analysen dabei, diese Schwellenwerte zu verfeinern und das Gleichgewicht zwischen akzeptabler Genauigkeit und erheblichen Kosteneinsparungen zu finden.
Kosten vs. Latenz: Günstigere Modelle liefern oft auch schnellere Antworten, insbesondere wenn sie lokal gehostet werden. Naives Multi-Modell-Routing kann jedoch Latenz verursachen, wenn das System erst ein Modell versucht und dann auf ein anderes zurückfällt. Das Gateway von TrueFoundry mildert dies durch latenzbasiertes und lastbewusstes Routing ab und stellt sicher, dass Anfragen ohne unnötige Hops zum schnellsten tragfähigen Modell fließen. Seine Architektur fügt nur wenige Millisekunden Overhead hinzu (~3–4 ms pro Anfrage) — vernachlässigbar im Vergleich zu Modell-Inferenzzeiten, sodass Teams an Effizienz gewinnen, ohne das Benutzererlebnis zu beeinträchtigen.
Kosten vs. architektonische Komplexität: Das Hinzufügen eines AI Gateways führt eine zusätzliche Infrastrukturschicht ein, bietet aber auch Transparenz, Guardrails und Zuverlässigkeit, die Einzelmodell-Setups fehlen. Für kleine Teams oder Prototypen können direkte Modellaufrufe ausreichen. Doch mit skalierender Nutzung werden zentralisiertes Routing, Caching und Kosten-Governance unerlässlich.
Letztendlich ist der Ausgleich dieser Faktoren ein fortlaufender Prozess. Die beste Praxis besteht darin, die Auswirkungen Ihrer Kostensparmaßnahmen auf die Modell-Ausgabequalität und das Benutzererlebnis kontinuierlich zu überwachen (wobei die Observability des Gateways hilft) und die Regler (Routing-Regeln, Cache-Einstellungen usw.) entsprechend anzupassen. Das Schöne am AI Gateway-Ansatz ist, dass Sie diese Regler haben – Sie sind nicht an eine universelle Einheitslösung für die Modellnutzung gebunden. Sie können die Ausgaben in bestimmten Bereichen hoch- oder herunterfahren, während Sie das bewahren, was für Ihre Anwendung am wichtigsten ist, sei es die Antwortzeit oder die Antwortgenauigkeit.
Best Practices zur LLM-Kostenoptimierung mit einem Gateway
Um den größten Nutzen aus einem AI Gateway zu ziehen, sollten Unternehmen die Technologie mit fundierten Nutzungsstrategien kombinieren. Hier sind einige praktische Best Practices zur Optimierung von LLM-Kosten bei gleichzeitiger Aufrechterhaltung der Leistung:
1. Prompts und Ausgaben optimieren. Kürzen Sie unnötige Token und halten Sie Prompts fokussiert. Zu lange oder ausführliche Anweisungen verschwenden Token. Strukturierte Formate – wie Aufzählungspunkte oder JSON-Schemas – halten Antworten präzise und vorhersehbar. Überprüfen und kürzen Sie häufige Kontext-Prompts, die jedem Aufruf vorangestellt werden. Diese „kostenlose“ Optimierung senkt die Ausgaben direkt.
2. Hybrides Modell-Routing nutzen. Wählen Sie eine gestaffelte Modellstrategie: Routen Sie einfache oder risikoarme Abfragen an kleinere, günstigere Modelle und komplexe an Premium-Modelle. Viele Teams folgen einem 90/10-Muster – 90 % des Datenverkehrs gehen an schnelle, kostengünstige Modelle; 10 % an hochwertige Modelle für kritische Aufgaben. Das Gateway von TrueFoundry automatisiert dies durch regelbasiertes oder ML-basiertes Routing und stellt sicher, dass Sie nie für Kapazitäten bezahlen, die Sie nicht benötigen.
3. Aufrufe stapeln und parallelisieren. Wenn Sie pro Token oder pro Aufruf bezahlen, minimieren Sie den Overhead, indem Sie mehrere Prompts in einer Anfrage bündeln. TrueFoundrys Batch-Inference-API ermöglicht es Ihnen, verwandte Aufgaben zu gruppieren — ideal für periodische Jobs wie das Zusammenfassen großer Dokumentensätze. In einigen Fällen können parallele Anfragen sowohl an günstige als auch an teure Modelle gesendet werden, wobei die teurere storniert wird, wenn die erste ein zufriedenstellendes Ergebnis liefert.
4. Cachen Sie hochfrequente Abfragen. Ergebnisse wiederverwenden statt neu berechnen. Das Gateway unterstützt sowohl Exact-Match- als auch semantisches Caching, bei dem ähnliche Prompts frühere Antworten wiederverwenden können. Selbst bescheidene Cache-Hit-Raten können erhebliche Token-Ausgaben einsparen und gleichzeitig die Latenz verbessern — ein großer Gewinn für sich wiederholende Workflows oder häufige Abfragen.
5. Modelle feintunen oder spezialisieren. Für sich wiederholende, domänenspezifische Aufgaben kann das Fine-Tuning eines kleineren Modells oder die Integration von RAG (Retrieval-Augmented Generation) Prompts verkürzen und Token reduzieren. Die Plattform von TrueFoundry unterstützt Fine-Tuning und Custom Deployment und hilft Teams dabei, Präzision und Effizienz in großem Maßstab auszubalancieren.
6. Nutzen Sie Open-Source- oder selbstgehostete Modelle. Bei hohen Volumina kann es günstiger sein, Open-Weight-Modelle auf dedizierten GPUs zu hosten, anstatt pro API-Aufruf zu bezahlen. Das Gateway ermöglicht eine nahtlose hybride Bereitstellung — die Weiterleitung eines Teils des Datenverkehrs an selbstgehostete Modelle bei gleichzeitiger Beibehaltung einheitlicher Logging- und Policy-Steuerungen. Dieses hybride Setup kann erhebliche Kosteneinsparungen bringen und gleichzeitig die Flexibilität wahren.
Zusätzlich zu diesen Praktiken sollten Sie immer
überschauen und iterieren
. Nutzen Sie die Daten aus dem Gateway, um zu sehen, welche Strategien die größte Wirkung zeigen (z. B. Cache-Hit-Raten, durch Routing eingesparte Token usw.), und passen Sie sie entsprechend an. Kostenoptimierung ist keine einmalige Aktion nach dem Motto „Set and Forget“, aber das Gateway gibt Ihnen die Werkzeuge an die Hand, um sie zu einer fortlaufenden, steuerbaren Aufgabe statt zu einer überraschenden Feuerwehraktion zu machen.
TrueFoundrys Ansatz für Kostenerfassung und Governance
Während die Kostenoptimierung eine universelle Herausforderung bei LLM-Deployments darstellt, verwandelt das AI Gateway von TrueFoundry diese in einen strukturierten, messbaren und kontinuierlichen Prozess. Anstatt sich auf manuelle Budgetierung oder verstreute Kostenberichte zu verlassen, bettet TrueFoundry Governance direkt in die Infrastrukturschicht ein — und stellt so sicher, dass jede AI-Interaktion in Echtzeit protokolliert, bepreist und zugeordnet wird. Diese einheitliche Infrastruktur ermöglicht eine strukturierte LLM-Kostenverfolgungslösung, mit der Unternehmen ihre Ausgaben auf Modell-, Team- und Workflow-Ebene mit vollständiger Transparenz überwachen können.
Jede Anfrage, die TrueFoundrys Gateway passiert, wird automatisch getaggt und bepreist. Das System kombiniert Input/Output-Token-Zahlen mit modellspezifischen Preisdaten — ob aus öffentlichen APIs oder unternehmensweit ausgehandelten Tarifen —, um die genauen Kosten pro Inference zu berechnen. Teams können diese Metriken nach Modell, Team, Umgebung oder Benutzer filtern, was eine präzise Einsicht darüber gibt, wer oder was die Ausgaben treibt. Dies macht es einfach, Kosten zuzuweisen, interne Chargebacks durchzuführen oder den ROI für AI-Features zu rechtfertigen.
2. Konfigurierbare Modellpreise und Budgets
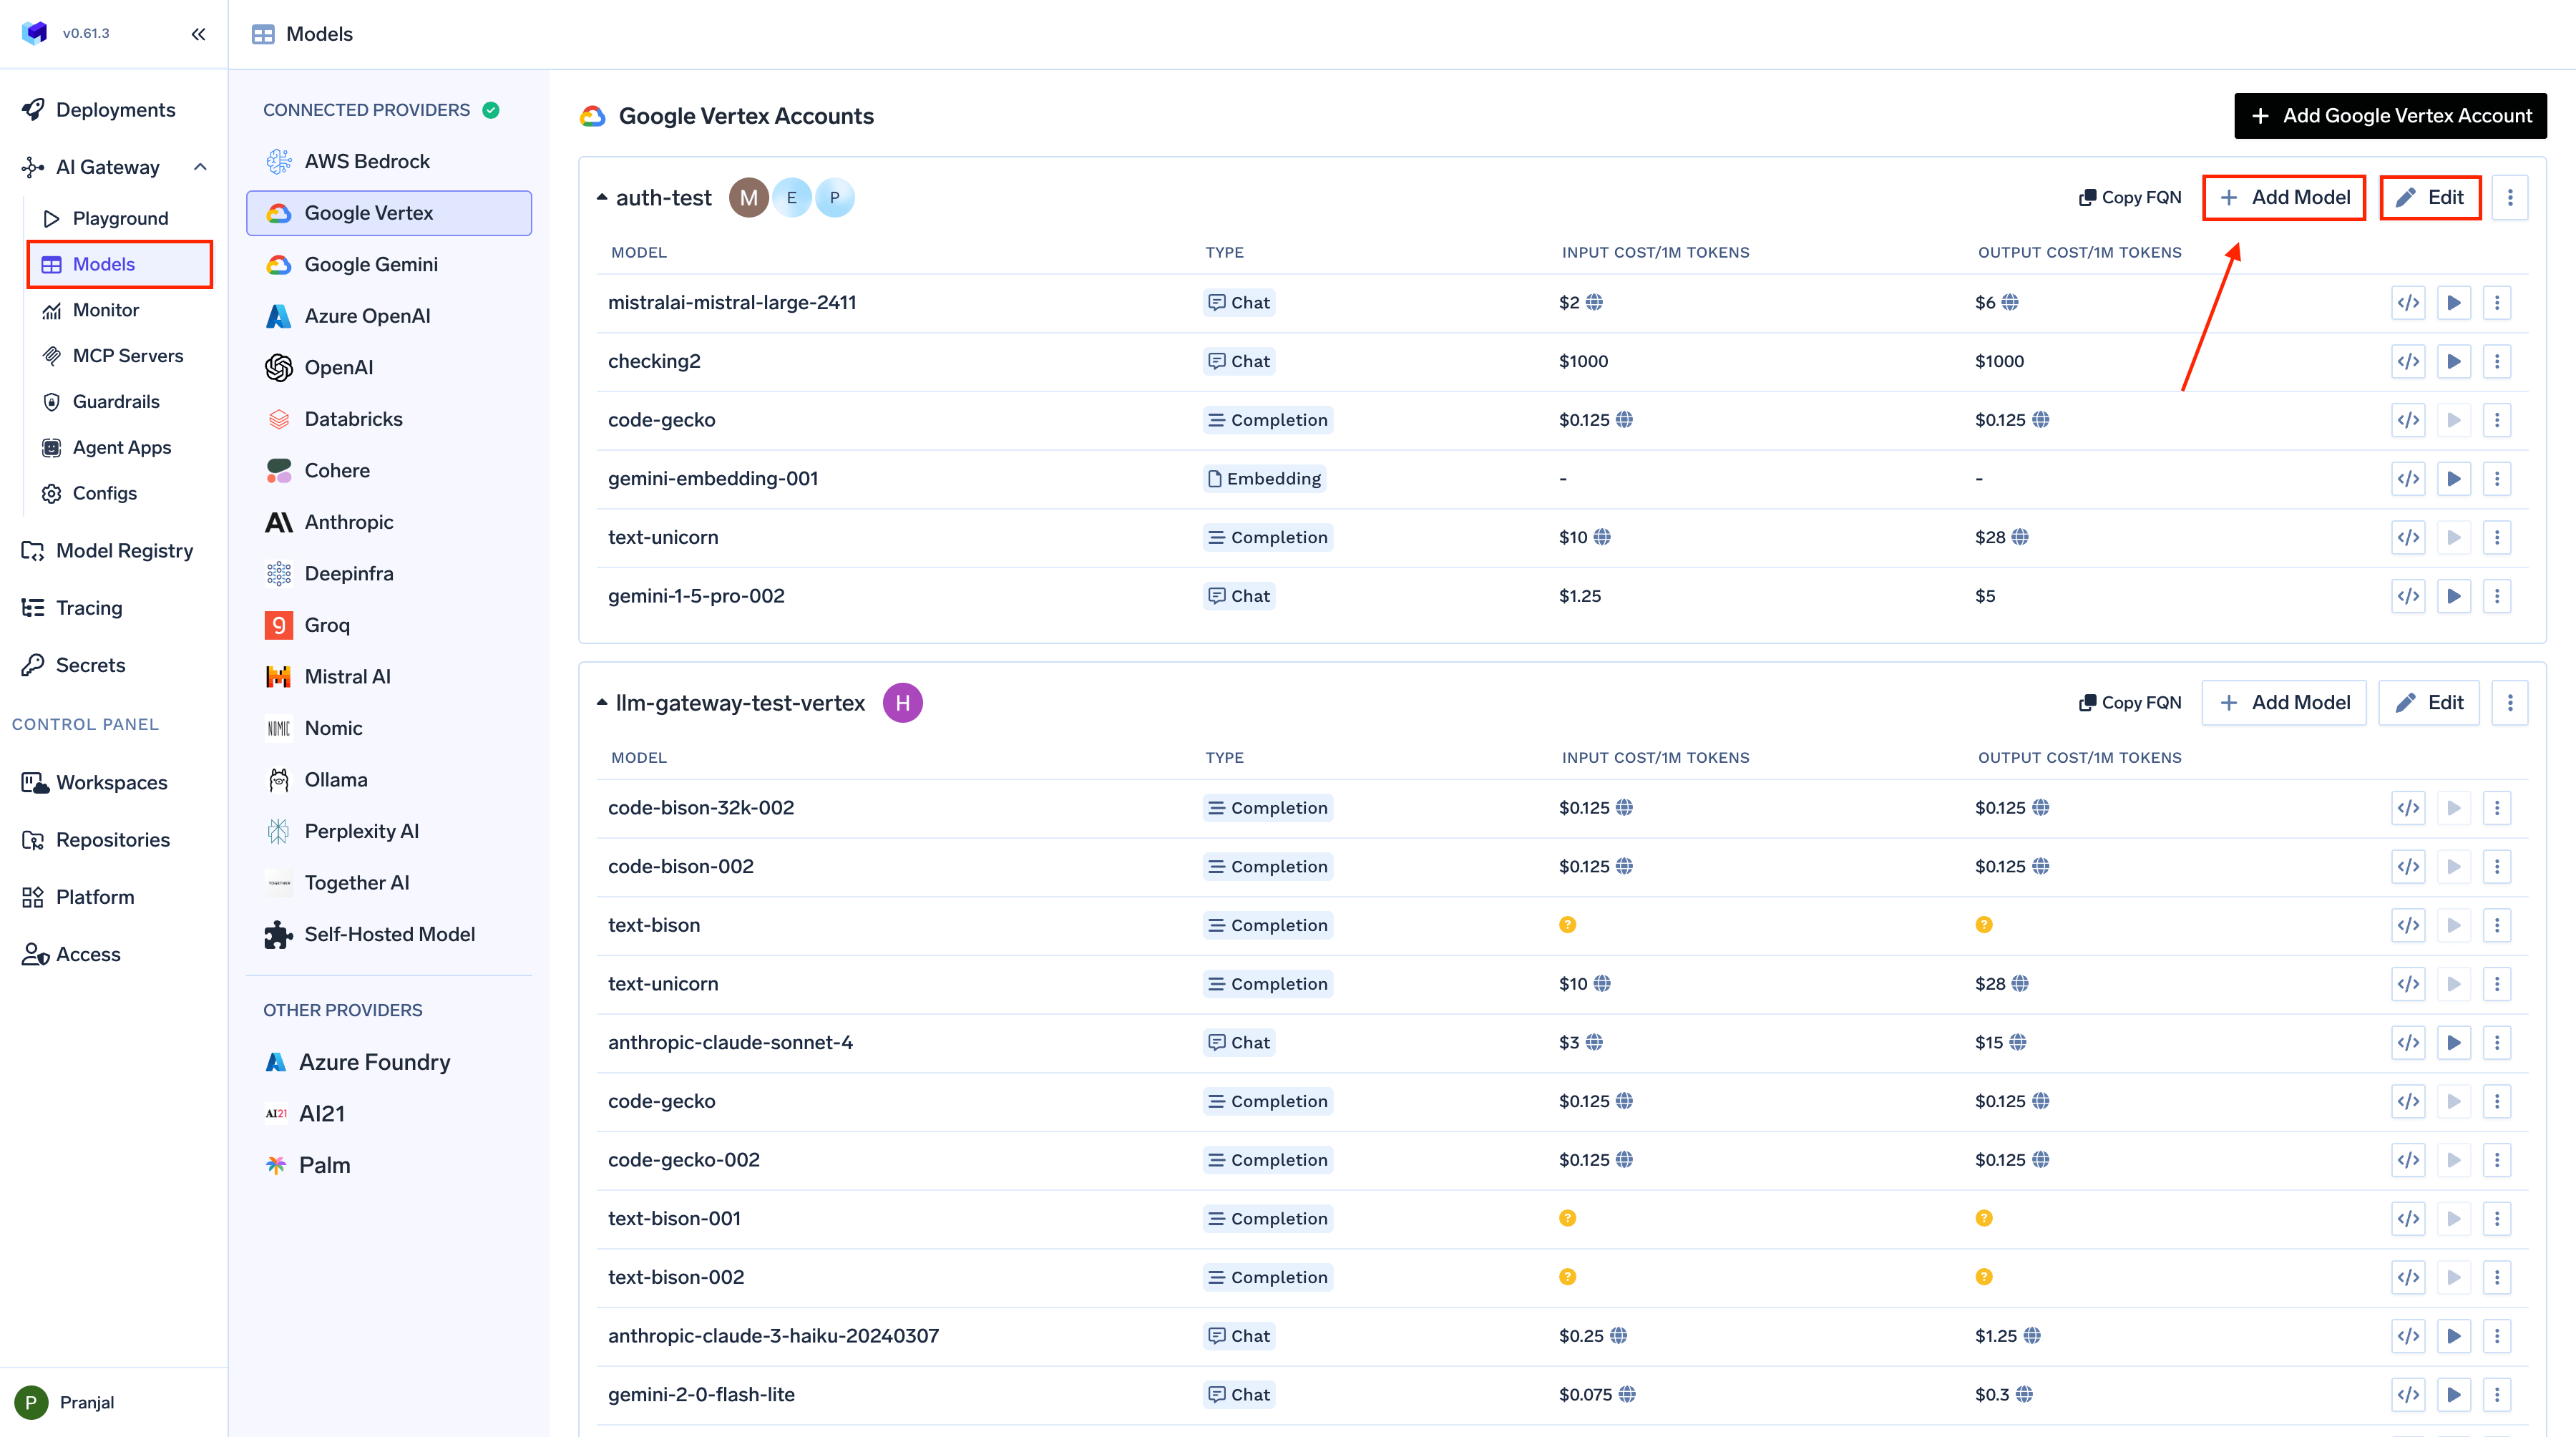
TrueFoundry ermöglicht es Unternehmen, benutzerdefinierte Preise pro Modell zu definieren und so die interne Verfolgung mit tatsächlichen Anbieterverträgen oder selbstgehosteten Compute-Kosten abzugleichen. Administratoren können auch Budgetschwellenwerte oder Quoten für jede App oder Umgebung erstellen. Wenn die Ausgaben ein festgelegtes Limit überschreiten, kann das Gateway automatisierte Benachrichtigungen auslösen oder sogar eine vorübergehende Drosselung erzwingen, was eine Kosteneindämmung ohne manuelles Eingreifen gewährleistet.
3. Integrierte Observability
TrueFoundry exportiert Kosten- und Nutzungsdaten an Prometheus und OpenTelemetry und fügt sich nahtlos in bestehende Monitoring-Pipelines ein. Dadurch können Metriken zu AI-Kosten, Latenz und Zuverlässigkeit in denselben Dashboards erscheinen, die für die Infrastruktur- und Anwendungsüberwachung genutzt werden. Das Ergebnis ist ein Single Pane of Glass, über das Engineering-, Finanz- und Produktteams eine einheitliche Sicht auf Leistung und Ausgaben teilen.
4. Governance by Design
Da jeder Aufruf Metadaten-Tagging (Team, Projekt und Umgebung) enthält, können Organisationen eine strukturierte Verantwortlichkeit über Abteilungen hinweg implementieren. In Kombination mit rollenbasierter Zugriffskontrolle (RBAC) und Berechtigungen auf Modellebene wird sichergestellt, dass kostenintensive oder risikoreiche Modelle nur für autorisierte Teams zugänglich sind. Diese Guardrails machen Compliance, Budgetdisziplin und Transparenz automatisch — nicht manuell.
Wann ein AI Gateway möglicherweise nicht gerechtfertigt ist
AI Gateways bieten bei Skalierung einen enormen Mehrwert, aber nicht jede Organisation benötigt sofort eines. Für kleine Teams oder Projekte in der Frühphase, die ein einzelnes Modell und ein geringes Anfragevolumen nutzen, kann die Bereitstellung eines vollständigen Gateways unnötigen Overhead bedeuten. Ein Prototyp, der ein einzelnes OpenAI-Modell mit ein paar Tausend Token pro Tag aufruft, lässt sich problemlos mit direkten API-Aufrufen und grundlegendem Monitoring verwalten.
Branchenempfehlungen legen nahe, dass bei begrenzter Nutzung (Zehntausende von Token pro Monat) und minimalen Compliance- oder Zuverlässigkeitsanforderungen ein leichtgewichtiger Proxy oder eine manuelle Verfolgung ausreichen kann. Der wahre Vorteil des Gateways zeigt sich, wenn Workflows skalieren oder sich über verschiedene Modelle und Anbieter hinweg diversifizieren. Wenn Ihre Organisation noch mit LLMs experimentiert oder über eine minimale Infrastruktur verfügt, konzentrieren Sie sich zuerst auf die Iteration, planen Sie aber im Voraus. Das Gateway von TrueFoundry lässt sich beispielsweise effizient herunterskalieren und bietet frühzeitige Transparenz und Governance ohne aufwendiges Setup. Kurz gesagt, bewerten Sie Ihre AI-Reife und -Skalierung: Für Anwendungsfälle mit einem einzigen Modell und geringem Volumen ist ein Gateway möglicherweise noch zu früh; mit zunehmender Nutzung wird es schnell unverzichtbar für Kostenkontrolle, Zuverlässigkeit und langfristige Governance.
Fazit
Die Kontrolle der LLM-Kosten in Unternehmensumgebungen ist komplex, aber AI Gateways wurden genau dafür entwickelt. Anstatt die Kosten dem Zufall zu überlassen, bettet ein Gateway wie das von TrueFoundry die Kostengovernance direkt in Ihre AI-Architektur ein. Durch zentralisiertes Tracking, Budgetierungs-Guardrails, intelligentes Routing und Caching wird die Kostenkontrolle zu einer integrierten Funktion statt zu einem nachträglichen Einfall.
Unternehmen, die AI Gateways einsetzen, berichten von 40–60 % geringeren Inference-Kosten sowie einer höheren Zuverlässigkeit und Sicherheit. Das Gateway von TrueFoundry bietet insbesondere Accountability by Design — indem es Teams feingranulare Transparenz, Kostenzuordnung und Chargebacks ermöglicht — sowie Risikoreduzierung bei Skalierung durch automatisierte Limits und Fail-Safes. Zudem bietet es vollständige Transparenz über Nutzungsmuster, sodass kein Kosten- oder Latenzproblem unbemerkt bleibt.
Durch die Vereinheitlichung von Policies über Regionen und Teams hinweg gewährleistet das Gateway eine konsistente Governance und Compliance — entscheidend für Branchen, die mit sensiblen Daten arbeiten. Das Ergebnis: AI-Projekte bewegen sich mit vorhersagbaren Ausgaben und operationaler Sicherheit vom Experimentieren in die Produktion.
Kurz gesagt: AI Gateways machen die LLM-Nutzung nachhaltig. Eine Token-basierte Preisgestaltung mag unvorhersehbar sein, aber mit der zentralen Control Plane von TrueFoundry können Unternehmen ihre Ausgaben optimieren, Guardrails durchsetzen und veranwortungsvoll skalieren. So koexistieren Innovation und finanzielle Disziplin — und machen AI zu einer steuerbaren, effizienten und enterprise-ready Funktion.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.
Auf Geschwindigkeit ausgelegt: ~ 10 ms Latenz, auch unter Last