October 5, 2023
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.




Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Es ist keineswegs falsch zu behaupten, dass jedes Unternehmen mit seinem Wachstum mehr Traffic bewältigen, mehr Daten verarbeiten und mehr Kunden unterstützen muss. Oft müssen sie ihre Infrastruktur skalieren, um mit den steigenden Anforderungen Schritt zu halten. Das gilt auch, wenn Ihr Unternehmen Saisonalitäten unterliegt. Stellen Sie sich eine E-Commerce-Website vor, die über die Feiertage wie am Black Friday oder Cyber Monday sehr viel Traffic verzeichnet. Der Traffic der Website kann in diesen Stoßzeiten dramatisch ansteigen. Die Website kann Probleme mit verzögerten Ladezeiten bekommen und Nutzer verärgern, wenn sie die erhöhte Nachfrage nicht bewältigen kann. Infolgedessen kann das Unternehmen Umsatzeinbußen und einen Reputationsverlust erleiden.
Eine Möglichkeit, diesem Problem zu begegnen, besteht darin, die Anzahl der Server in der Infrastruktur manuell zu erhöhen, um den gestiegenen Traffic zu bewältigen. Das manuelle Up- und Downscaling kann jedoch zeitaufwendig, fehleranfällig und schwer zu verwalten sein. Hier kommt Cluster Autoscaling ins Spiel. Cluster Autoscaling passt die Anzahl der Server in der Infrastruktur automatisch an bestimmte Bedingungen an, wie etwa CPU-Auslastung, Speicherbelegung oder eingehende Anfragen. Das bedeutet, dass die Infrastruktur je nach aktueller Nachfrage ohne manuelles Eingreifen nach oben oder unten skaliert werden kann.
Dieser Blogbeitrag untersucht, was Cluster Autoscaling ist, warum es benötigt wird und wie es bei verschiedenen Cloud-Providern implementiert werden kann.
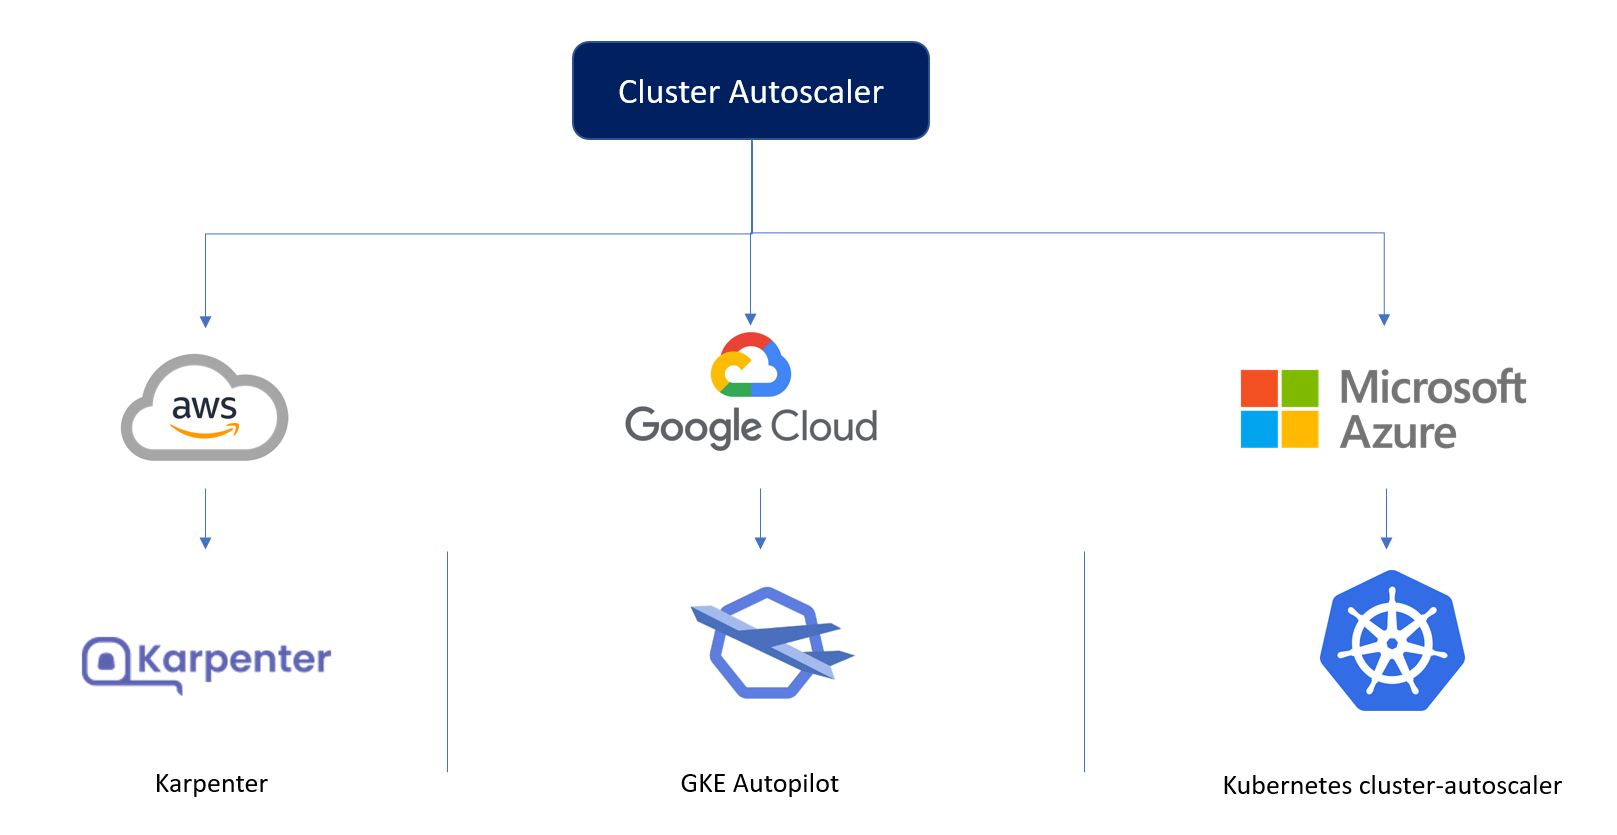
Damit unser Cluster auf allen großen Cloud-Providern korrekt funktioniert, müssen wir die Art und Weise anpassen, wie wir die Cluster-Knoten skalieren.
💡
Auf AWS nutzen wir Karpenter, das mit minimaler Konfiguration den günstigsten und effizientesten Node für die eingehenden Pod-Anfragen auswählen kann.
💡
Auf GCP verlassen wir uns auf GKE Autopilot, das uns einen verwalteten Cluster bietet, der je nach Anfragen nach oben und unten skalieren kann.
💡
Auf Azure gibt es keine Ad-hoc-Lösungen, und wir verwenden den Kubernetes cluster-autoscaler, der weniger optimiert ist als Karpenter und mehr Konfiguration erfordert als Autopilot.
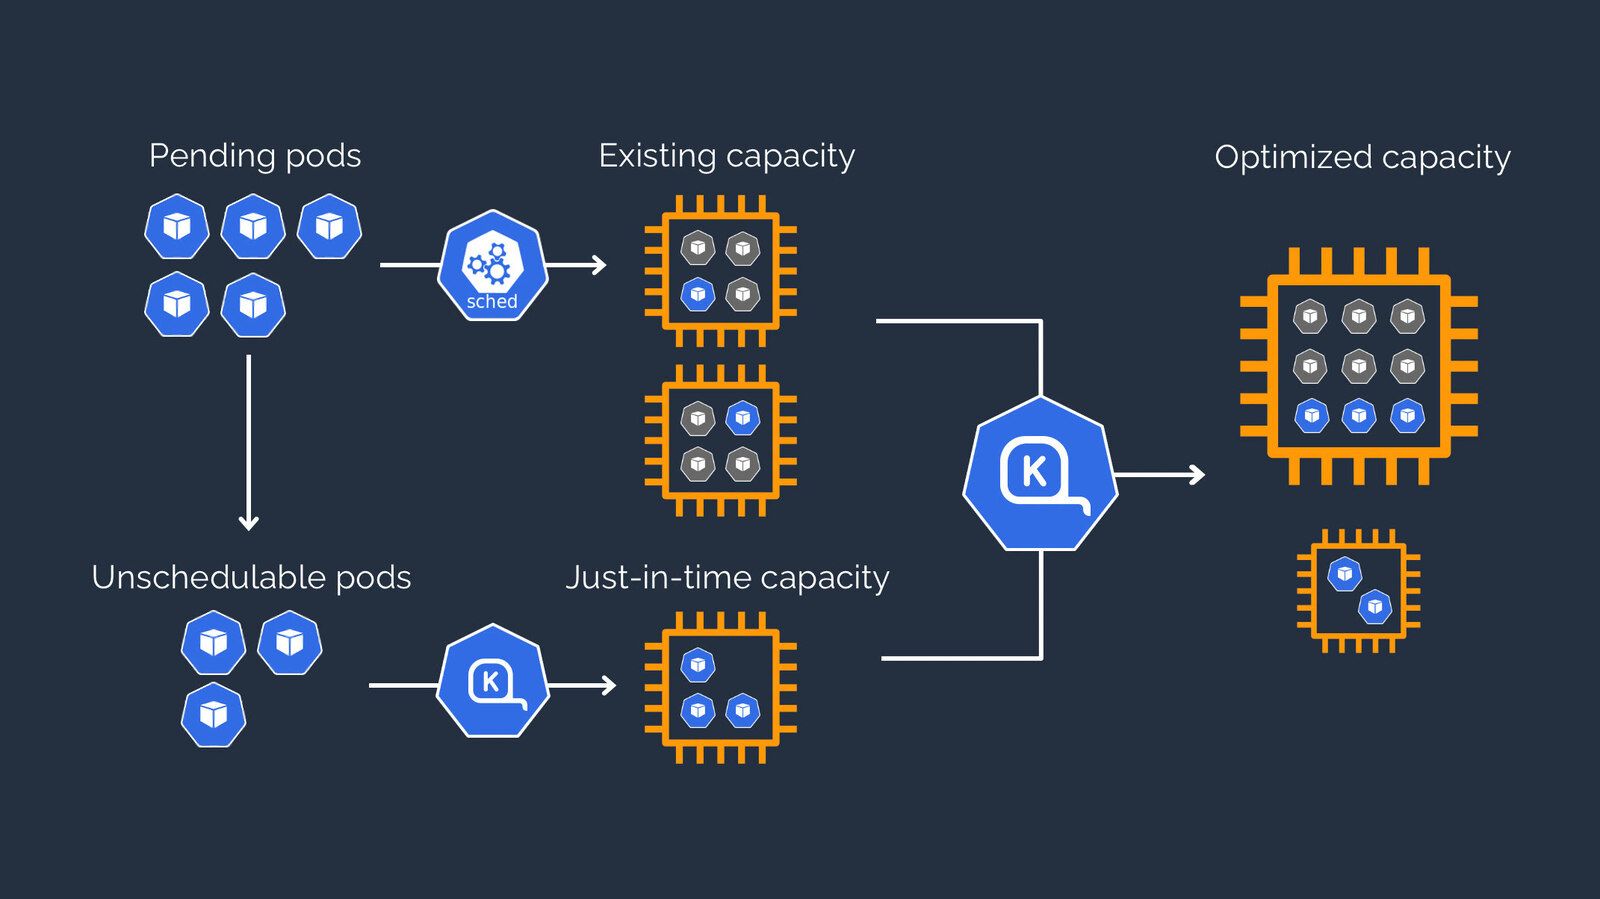
Karpenter beobachtet die kumulierten Ressourcenanfragen von nicht terminierten Pods und trifft Entscheidungen zum Starten und Beenden von Nodes, um Scheduling-Latenzen und Infrastrukturkosten zu minimieren.
Aber leider funktioniert Karpenter nur auf AWS.
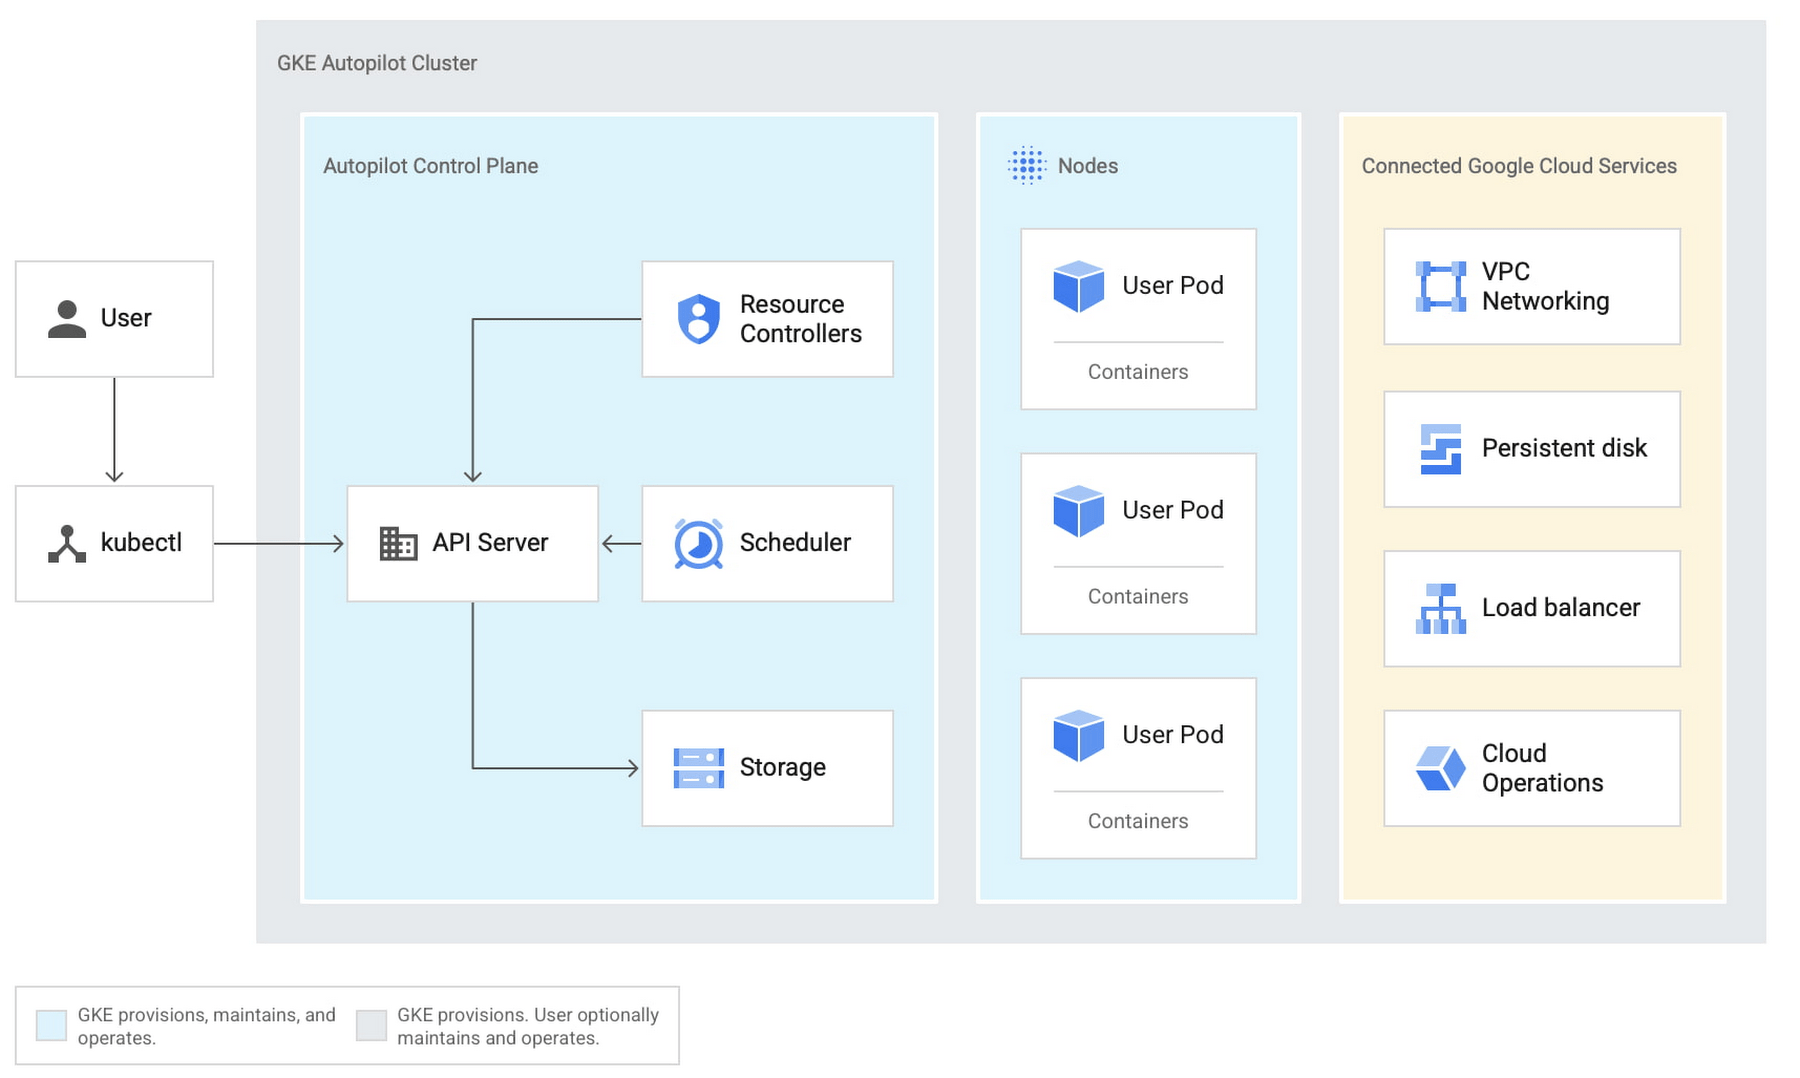
Autopilot ist ein verwalteter Dienst, der Machine-Learning-Algorithmen verwendet, um die optimale Anzahl von Nodes für den Cluster auf der Grundlage des aktuellen Workloads zu ermitteln. Er bietet auch Funktionen wie automatische Upgrades und Patches, was die Verwaltung sicherer Cluster erleichtert und gleichzeitig Cloud-Skalierbarkeit unterstützt.
Neben dem Autoscaling bietet Cluster Autopilot auch weitere Vorteile wie eine verbesserte Ressourcenauslastung und Kosteneinsparungen durch die Vermeidung von Over-Provisioning von Ressourcen. Es bietet auch einen hands-off Ansatz für das Cluster-Management, da alle Autoscaling-Operationen vom Dienst übernommen werden.
Auf der Azure-Cloud gibt es kein verwaltetes Angebot wie GKE Autopilot oder einen maßgeschneiderten Autoscaling-Ansatz wie Karpenter; daher verlassen wir uns auf den cluster-autoscaler.
Der Kubernetes Cluster Autoscaler ist ein Open-Source-Tool, das die automatische Skalierung von Kubernetes-Clustern ermöglicht. Er läuft als Pod innerhalb des Clusters und überwacht die Ressourcenauslastung des Clusters, wobei er die Anzahl der erforderlichen Nodes anpasst, um den Anforderungen der darin laufenden Anwendungen gerecht zu werden. Dies hilft bei der Optimierung der Ressourcenauslastung und der Reduzierung von Kosten, indem Over-Provisioning von Ressourcen bei geringer Nachfrage vermieden wird. Der Cluster Autoscaler erfordert die manuelle Konfiguration von Node Groups und -Typen.
Dieser Blog behandelt Details zum Kubernetes Autoscaling.
TrueFoundry ist eine ML Deployment PaaS über Kubernetes, um Entwickler-Workflows zu beschleunigen und ihnen gleichzeitig volle Flexibilität beim Testen und Bereitstellen von Modellen zu bieten, bei voller Sicherheit und Kontrolle für das Infra-Team. Über unsere Plattform ermöglichen wir es Machine-Learning-Teams, Modelle in 15 Minuten mit 100 % Zuverlässigkeit, Skalierbarkeit und der Möglichkeit zum Rollback in Sekunden zu deployen und zu überwachen – so können sie Kosten sparen und Modelle schneller in Produktion bringen, was eine echte Wertschöpfung für das Unternehmen ermöglicht.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet