


October 19, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Published: October 10, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Mit der Skalierung von KI-Anwendungen wird die Optimierung der LLM-Inferenz genauso wichtig wie die Wahl des richtigen Modells. Teams müssen Latenzzeiten reduzieren, die Zuverlässigkeit verbessern, Kosten verwalten und den Datenverkehr nahtlos über mehrere Anbieter hinweg steuern – und das bei voller Transparenz und Kontrolle über jede Anfrage.
Hier kommen KI-Gateways ins Spiel. Als intelligente Ebene zwischen Ihren Anwendungen und LLM-Anbietern optimieren sie die Inferenz durch Funktionen wie intelligentes Routing, automatische Wiederholungsversuche, Caching, Ratenbegrenzung und Observability. So können Teams schnellere und zuverlässigere KI-Anwendungen entwickeln.
In diesem Leitfaden vergleichen wir die besten KI-Gateways zur Optimierung der LLM-Inferenz im Jahr 2026. Wir bewerten deren Leistung, Routing-Fähigkeiten, Bereitstellungsoptionen und Unternehmensfunktionen, um Ihnen bei der Auswahl der richtigen Lösung zu helfen.
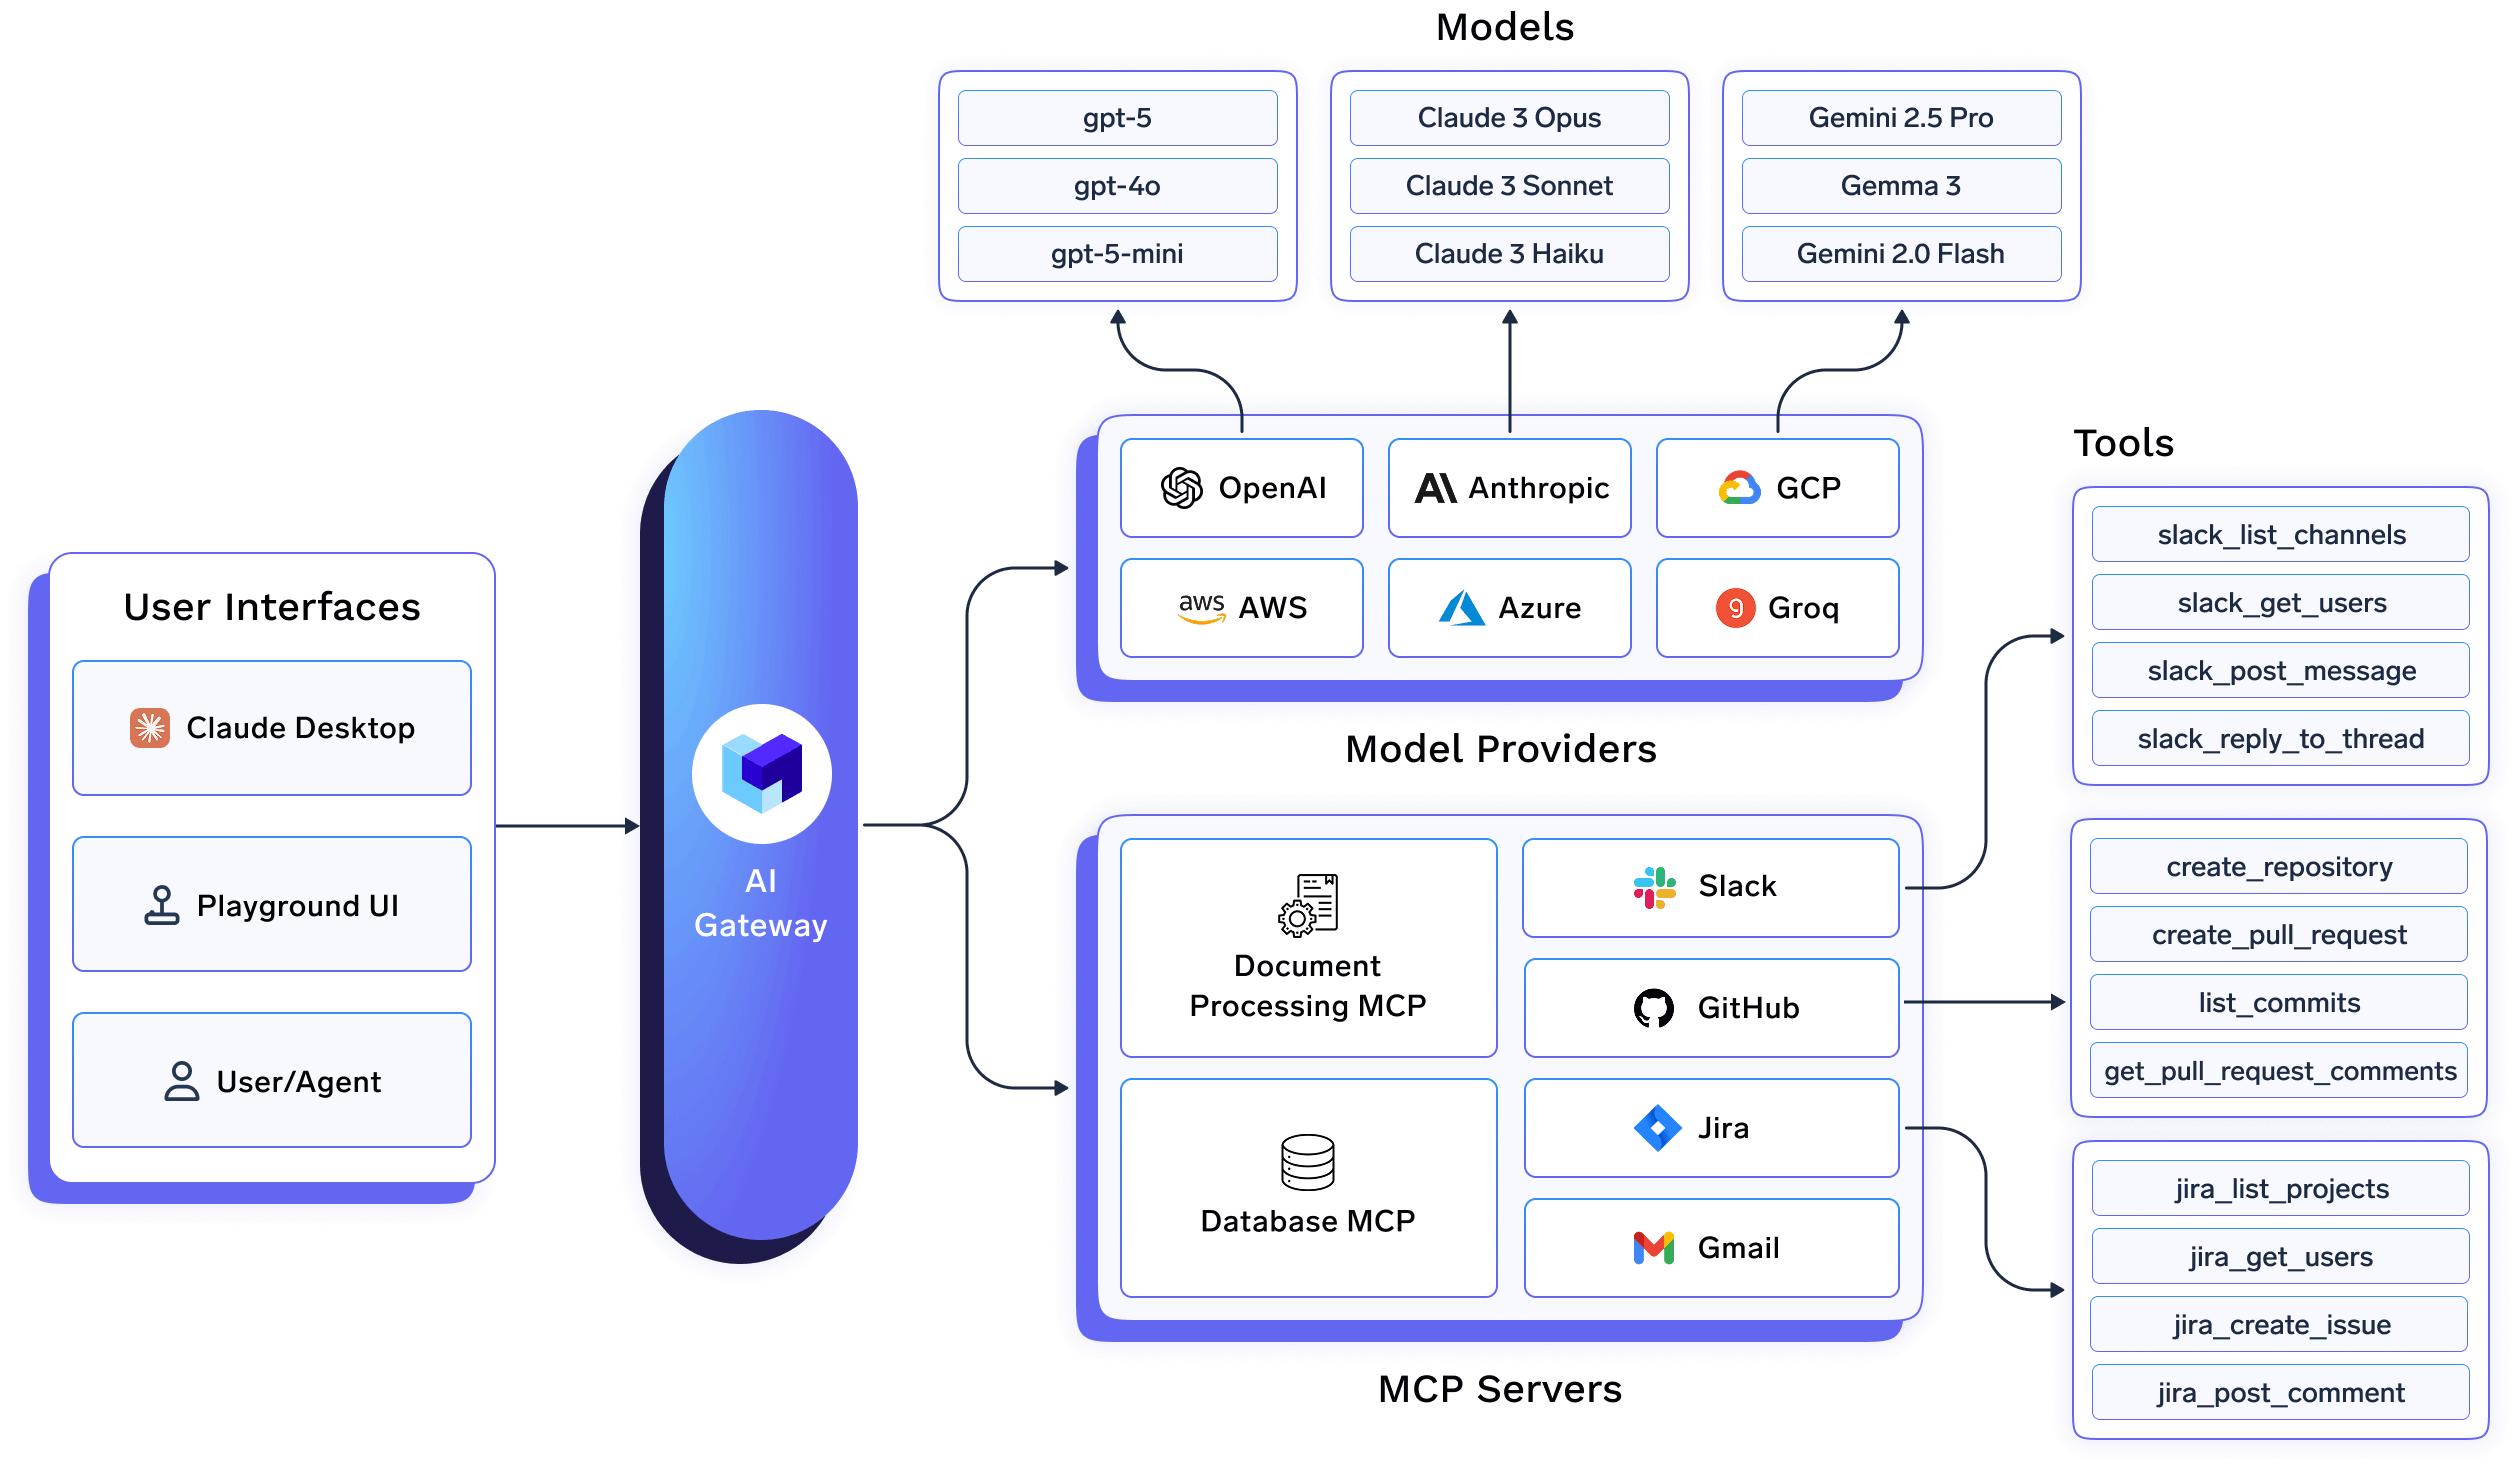
TrueFoundry KI-Gatewayist eine Proxy-Ebene, die zwischen Ihren Anwendungen und den LLM-Anbietern (sowie MCP-Servern) fungiert. Sie bietet eine einheitliche API sowie die dazugehörige Observability und Governance, anstatt jede Anwendung direkt mit jedem Anbieter zu verknüpfen. Die Version dieser Ebene von TrueFoundry unterstützt Caching auf zwei Ebenen: Prompt-Caching (auf Anbieter-Ebene, durchgereicht an das zugrunde liegende Modell) und auf Gateway-Ebene semantisches Caching , das Anfragen über die Kosinus-Ähnlichkeit von Embeddings abgleicht, anstatt auf exakte Übereinstimmungen angewiesen zu sein. So können semantisch ähnliche Prompts aus dem Cache geladen werden, selbst wenn die Formulierung abweicht. Diese semantische Ebene unterscheidet echte Inferenz-Optimierung von einem einfachen Key-Value-Cache und eliminiert den Modellaufruf vollständig, anstatt nur die Zeit bis zum ersten Token zu verkürzen.
Im Bereich Zuverlässigkeit umfasst das Load Balancing ein automatisches Failover: Wenn ein Ziel aus anderen als HTTP-Gründen ausfällt – etwa durch fehlerhafte Anmeldedaten, DNS- oder TLS-Probleme –, versucht das Gateway, das nächste Ziel anzusteuern, anstatt die gesamte Anfrage scheitern zu lassen. Routing-Regeln unterstützen gewichtungs-, latenz- und prioritätsbasierte Strategien, die über eine YAML-Datei oder die unten gezeigte Benutzeroberfläche konfiguriert werden können.
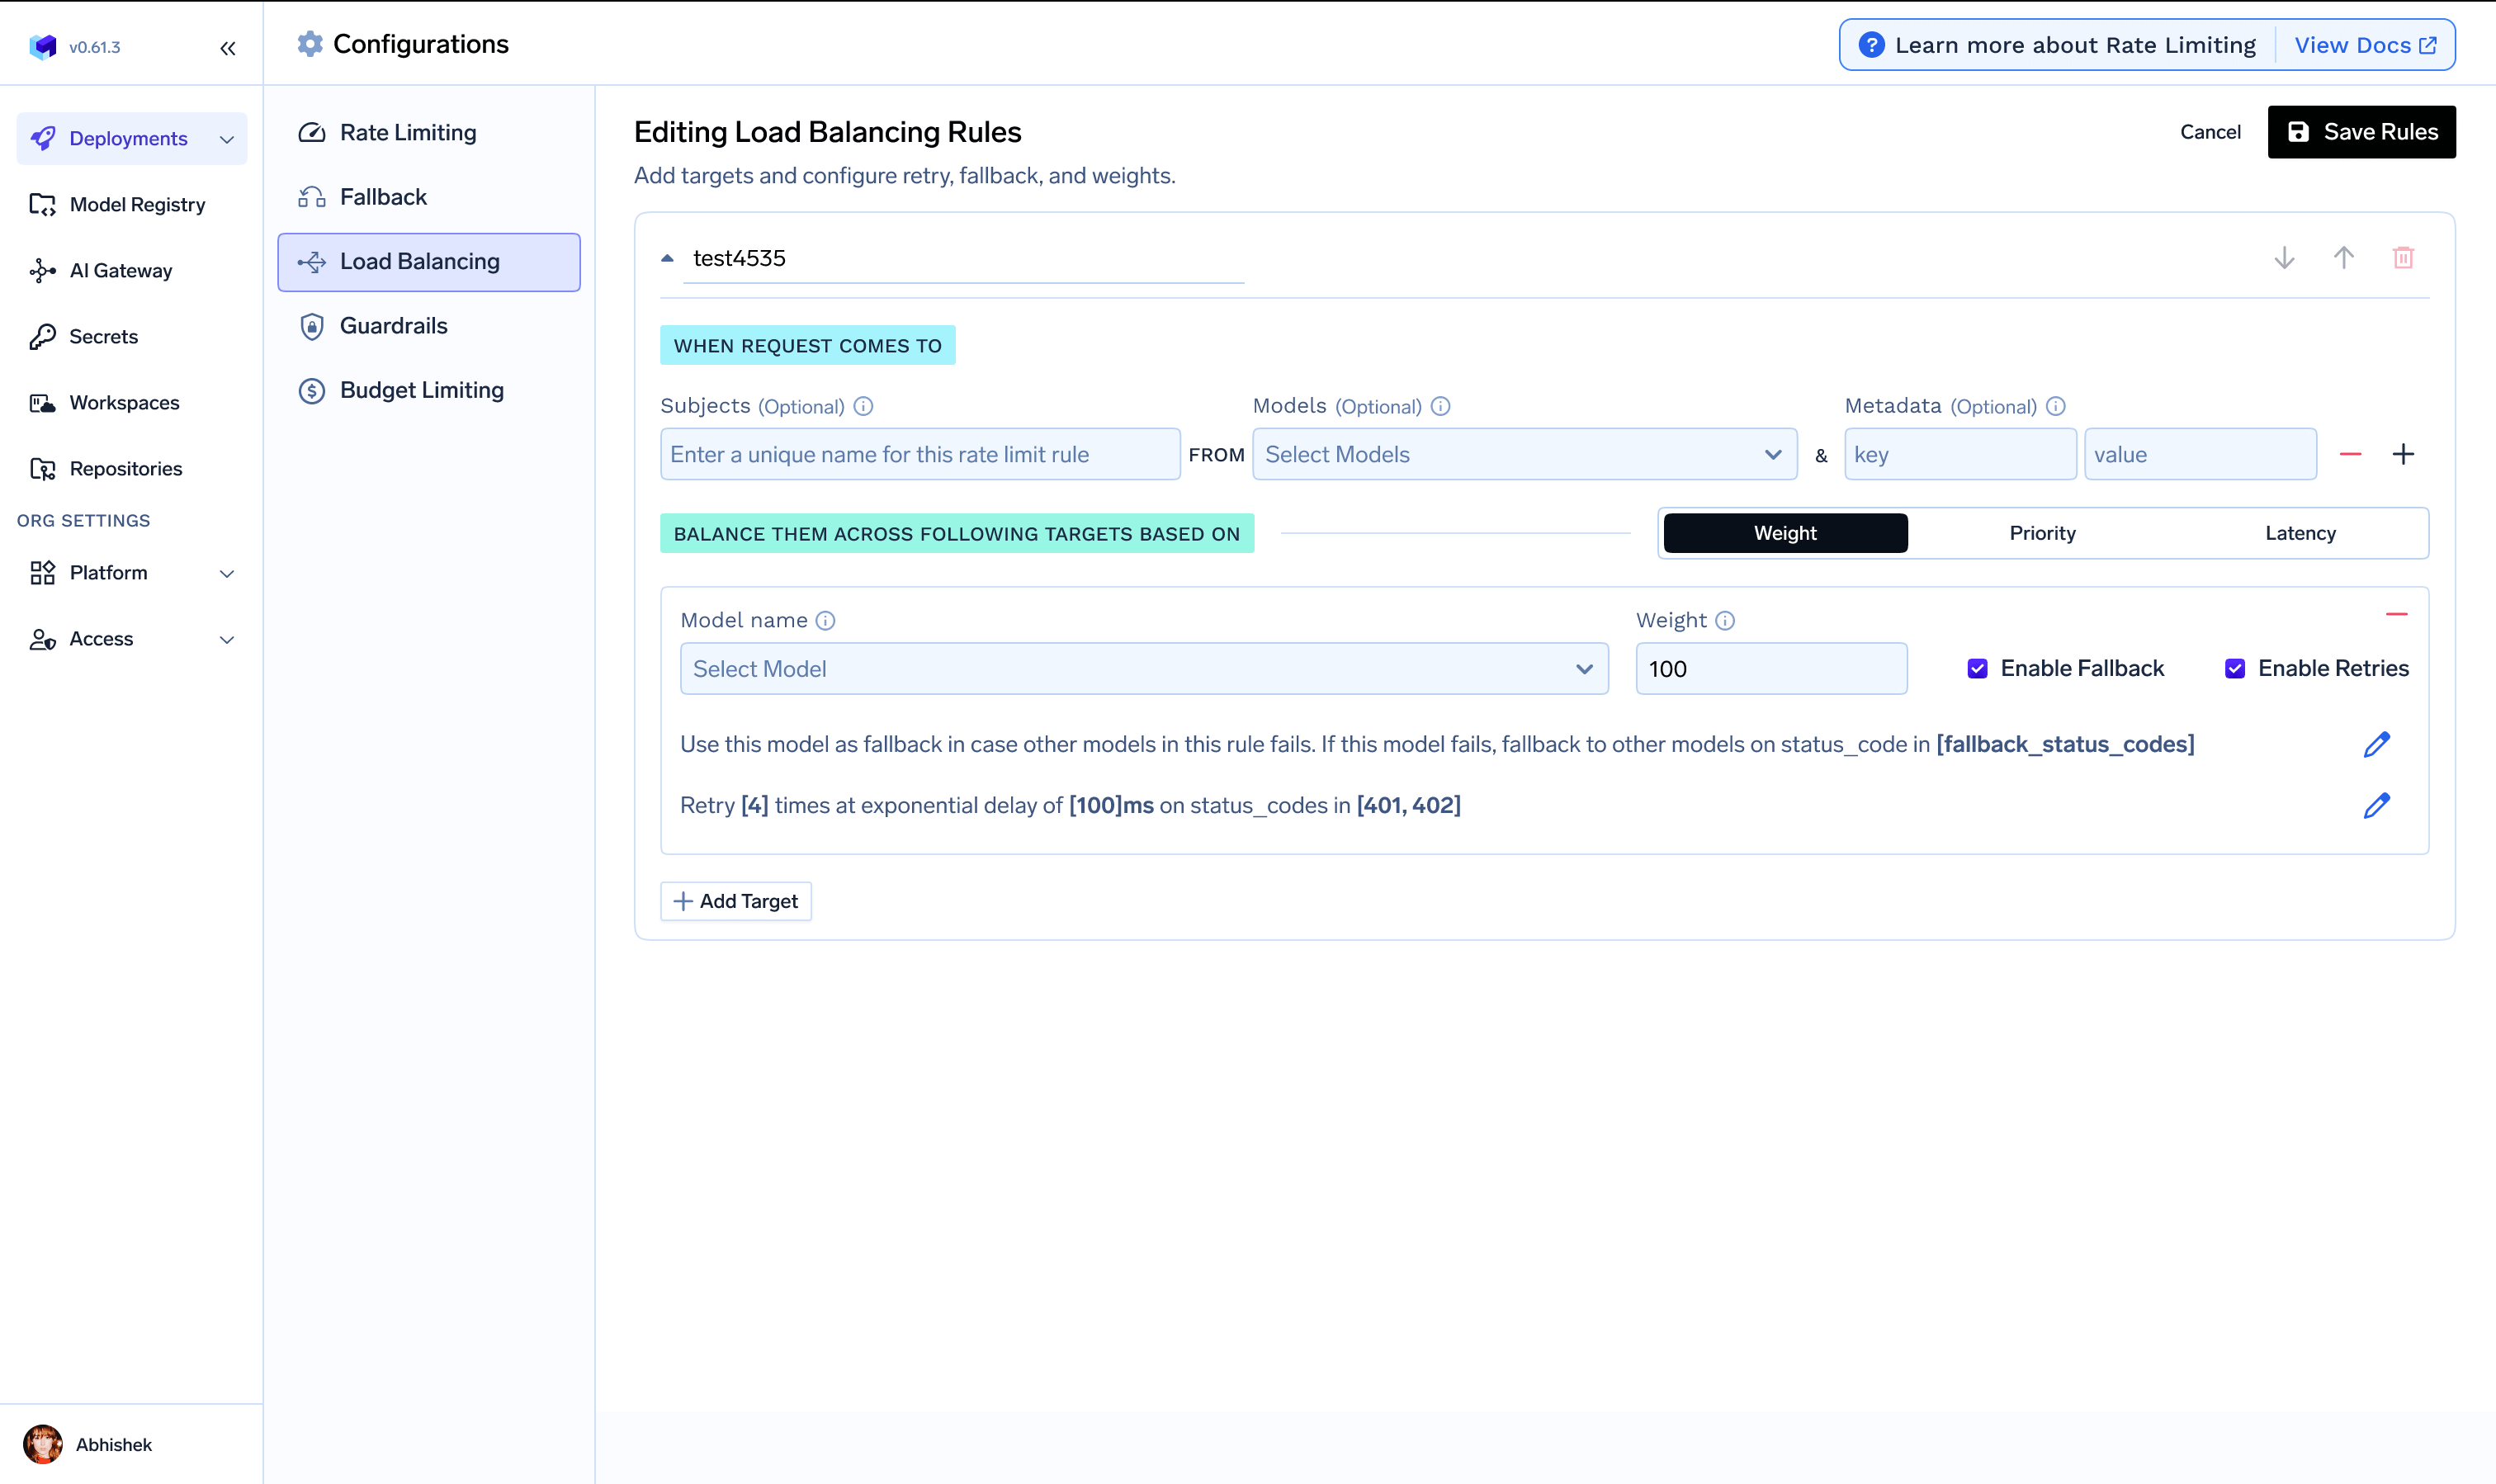
Das Gateway verarbeitet über 350 Anfragen pro Sekunde auf einer einzelnen vCPU mit einem Overhead von etwa 3 bis 4 ms. Zudem verarbeitet eine Batch-API große asynchrone Workloads kostengünstiger und mit höherem Durchsatz als synchrone Inferenz. All dies läuft über eine einzige OpenAI-kompatible API für mehr als 1.000 LLMs, sodass für das Umleiten bei einem langsamen oder gestörten Anbieter keine Änderungen am Anwendungscode erforderlich sind.
Vorteile:
Nachteile: Die vollständige Enterprise-Preisgestaltung erfordert ein Gespräch mit dem Vertrieb statt eines Self-Service-Checkouts. Das passt zwar zum Enterprise-Bereitstellungsmodell, ist aber ein langsamerer Start als eine Anmeldung per Kreditkarte.
Ideal für: Teams, die Caching, Load Balancing und Batch-Verarbeitung zentral am Gateway abwickeln möchten – mit transparenten Leistungsdaten statt reiner Marketingversprechen – und dabei gleichzeitig das Modell-Serving auf derselben Plattform nutzen wollen.
TrueFoundry AI Gateway ausprobieren →
Der Router von LiteLLM übernimmt Lastverteilung, Wiederholungsversuche, Abkühlphasen und Fallbacks über mehrere LLM-Bereitstellungen und Anbieter hinweg. Er erfasst die Antwortzeiten pro Bereitstellung und nutzt diese Daten für Routing-Entscheidungen. Er unterstützt gewichtete Bereitstellungen, sodass der Datenverkehr auf verschiedene Anbieter verteilt werden kann, während konfigurierte Ratenbegrenzungen eingehalten werden. Zudem ermöglichen Fallback-Richtlinien, dass eine Anfrage bei einem Fehler automatisch an einen alternativen Anbieter weitergeleitet wird. Beim Caching unterstützt LiteLLM semantisches Caching über Redis oder Qdrant, wobei Prompt-Embeddings verglichen werden, um semantisch ähnliche Anfragen statt nur exakter Übereinstimmungen zu erfassen, inklusive konfigurierbarer Ähnlichkeitsschwellenwerte und TTLs.
Die Kompromisse sind hauptsächlich operativer Natur. Semantisches Caching erfordert die Bereitstellung von Redis Stack (mit dem RediSearch-Modul), was viele verwaltete Cloud-Redis-Angebote standardmäßig nicht enthalten, wodurch eine zusätzliche Infrastrukturkomponente entsteht, die die meisten Teams bisher nicht betreiben. Da der Proxy von LiteLLM auf Python basiert, kann er unter hoher Last eine messbare Latenz verursachen, verglichen mit Gateways, die in Sprachen mit geringerem Overhead geschrieben sind. Selbst gehostetes Routing liegt typischerweise im einstelligen Millisekundenbereich, aber es empfiehlt sich, einen Lasttest durchzuführen, bevor man davon ausgeht, dass dies auch bei Spitzenlast standhält.
Vorteile: Kostenloser Open-Source-Kern; semantisches Caching via Redis oder Qdrant; flexibler Router mit gewichteten Bereitstellungen und Fallback-Richtlinien; große, aktive Community.
Nachteile: Semantisches Caching erfordert eine spezifische Redis-Stack-Bereitstellung, über die die meisten Teams nicht verfügen; der Python-basierte Proxy kann unter hoher Last Latenz verursachen; Ihr Team muss die gesamte Infrastruktur selbst betreiben.
Ideal für: Teams, die sich Flexibilität bei Open-Source-Caching und -Routing wünschen und damit vertraut sind, die für semantisches Caching erforderliche Redis- oder Qdrant-Infrastruktur aufzusetzen und zu betreiben.
Das zentrale Gateway von Portkey deckt über 250 Modelle über einen einzigen Endpunkt ab und bietet sowohl semantisches als auch einfaches Caching, um Latenz und Kosten bei wiederholten Anfragen zu senken. Ergänzt wird dies durch automatische Fallbacks, Lastverteilung, Wiederholungsversuche und Circuit Breaker. Es ist eine der umfassenderen gehosteten Optionen für Teams, die Caching- und Zuverlässigkeitsfunktionen suchen, ohne diese aus verschiedenen Einzeltools zusammenstellen zu müssen.
Die Enterprise-Stufe bietet zusätzlich VPC-Hosting, RBAC, SSO sowie SOC2/HIPAA/GDPR-Konformität. Diese Governance-Funktionen sind jedoch exklusiv in diesem kostenpflichtigen Tarif enthalten, wobei die Preise auf diesem Niveau je nach Volumen und Bereitstellungsmodell typischerweise zwischen einigen tausend und über zehntausend Dollar pro Monat liegen.
Vorteile: Integriertes semantisches und einfaches Caching; breite Modellabdeckung; automatische Fallbacks und Circuit Breaker für hohe Zuverlässigkeit.
Nachteile: Enterprise-Governance und VPC-Bereitstellung erfordern den kostenpflichtigen Enterprise-Tarif und sind nicht Teil des Basisprodukts; Modell-Serving ist nicht enthalten und muss daher über eine separate Ebene erfolgen.
Ideal für: Teams, die gehostetes semantisches Caching und Zuverlässigkeitsfunktionen für einen breiten Modellkatalog suchen und kein Problem damit haben, das Modell-Serving als separate Aufgabe zu betreiben.
Das AI Gateway von Cloudflare bedient identische Anfragen direkt aus seinem globalen Edge-Cache, was laut Anbieter die Latenz bei Cache-Treffern um bis zu 90 % senken und gleichzeitig die Kosten für wiederholte Aufrufe an den zugrunde liegenden Anbieter reduzieren kann. Die Ratenbegrenzung ist flexibel und unterstützt gleitende oder feste Zeitfenster, die nach Modell, Anbieter oder benutzerdefinierten Metadaten wie Benutzer oder Team definiert werden können. Seit Mai 2026 ermöglicht eine einheitliche REST-API den Zugriff auf jedes Modell über einen einzigen Endpunkt.
Die Kernfunktionen – Dashboard-Analysen, Caching und Ratenbegrenzung – sind bereits mit einem einfachen Cloudflare-Konto kostenlos verfügbar, was für kostenbewusste Teams ein echter Vorteil ist. Der Kompromiss besteht darin, dass es sich um ein Edge-Caching für exakte Übereinstimmungen handelt, das an das Netzwerk von Cloudflare gebunden ist, und nicht um ein auf Embeddings basierendes semantisches Caching, das auch ähnliche, aber nicht identische Prompts erkennt. Zudem ist das Log-Volumen im kostenlosen Tarif auf 100.000 Anfragen pro Monat begrenzt, bevor ein kostenpflichtiger Workers-Plan erforderlich wird.
Vorteile: Kostenloses Core-Caching und Rate Limiting; wirklich schnelle Cache-Treffer auf Edge-Ebene; einfache Einrichtung mit nur einer Zeile.
Nachteile: Caching basiert auf exakten Übereinstimmungen statt auf Semantik; das Protokollvolumen ist im kostenlosen Tarif begrenzt; an die Plattform und das Netzwerk von Cloudflare gebunden.
Ideal für: Teams, die bereits die Plattform von Cloudflare nutzen und kostenloses, schnelles Caching bei exakter Übereinstimmung sowie Rate Limiting ohne einen weiteren Anbieter benötigen.
Das Prompt-Caching von Helicone funktioniert sofort über das OpenAI-kompatible Gateway und speichert Prompts ab 1.024 Token automatisch zwischen, wobei ein prompt_cache_key Parameter für eine präzisere Steuerung zur Verfügung steht. Speziell für Anthropic werden Cache-Control-Breakpoints (bis zu vier pro Anfrage) mit TTL-Steuerung unterstützt. Da die Observability standardmäßig integriert und nicht nachträglich hinzugefügt ist, wird jede Anfrage automatisch ohne zusätzliche Konfiguration protokolliert und analysiert.
Die Preisgestaltung reicht von einem kostenlosen Hobby-Tarif (10.000 Anfragen pro Monat) bis hin zu einem Team-Tarif für 799 $/Monat, der SOC2- und HIPAA-Konformität bietet. Der Enterprise-Tarif umfasst darüber hinaus SAML-SSO und On-Premise-Bereitstellungen. Für Teams, die Caching und Observability auf Anfrageebene in einem einzigen Tool suchen, ohne eine separate Logging-Pipeline aufbauen zu müssen, ist diese Kombination der Hauptvorteil.
Vorteile: Transparente Preisgestaltung ohne Aufschläge; Caching und Observability sind standardmäßig im selben Produkt integriert; anbieterspezifische, erweiterte Caching-Steuerungen für Anthropic.
Nachteile: Compliance-Zertifizierungen und On-Premise-Bereitstellungen sind erst in den höheren kostenpflichtigen Tarifen verfügbar; nicht als vollständige Plattform für das Model-Serving positioniert.
Ideal für: Teams, die Prompt-Caching und automatische Request-Observability kombinieren möchten, ohne einen separaten Logging- oder Monitoring-Stack konfigurieren zu müssen.
Die Wahl des richtigen KI-Gateways kann einen erheblichen Einfluss auf die Leistung, Zuverlässigkeit und Kosten Ihrer KI-Anwendungen haben. Während jede Lösung eine Möglichkeit bietet, eine Verbindung zu mehreren LLM-Anbietern herzustellen, gehen die besten Gateways über die einfache Weiterleitung von Anfragen hinaus, indem sie die Inferenz durch intelligentes Routing, Caching, Failover, Observability und Governance optimieren.
Wenn Sie KI-Anwendungen für Unternehmen entwickeln, sollten Sie auf ein Gateway setzen, das nicht nur Latenz und Zuverlässigkeit verbessert, sondern auch die Sicherheit, Compliance und operativen Kontrollen bietet, die für den produktiven Betrieb im großen Maßstab erforderlich sind. Das TrueFoundry AI Gateway kombiniert Inferenz-Optimierung mit Governance auf Unternehmensniveau, Multi-Provider-Routing, semantischem Caching und Unterstützung für über 1.000 LLMs. Damit ist es eine hervorragende Wahl für Unternehmen, die sowohl ihre Performance als auch ihre betriebliche Effizienz optimieren möchten.
Da KI-Workloads im Jahr 2026 weiter zunehmen, hilft Ihnen die Investition in das richtige KI-Gateway dabei, schnellere Antworten zu liefern, Infrastrukturkosten zu senken und resilientere KI-Systeme aufzubauen.
Ein KI-Gateway ist eine Middleware-Schicht, die zwischen Ihrer Anwendung und LLM-Anbietern wie OpenAI, Anthropic und Google Gemini fungiert. Es optimiert die Inferenz durch intelligentes Routing, Wiederholungsversuche, Failover, Caching, Ratenbegrenzung und Observability, was zur Leistungssteigerung und Reduzierung der operativen Komplexität beiträgt.
KI-Gateways optimieren die Inferenz, indem sie Anfragen an das leistungsfähigste Modell oder den besten Anbieter weiterleiten, wiederkehrende Prompts zwischenspeichern, den Datenverkehr auf Endpunkte verteilen, fehlgeschlagene Anfragen automatisch wiederholen und Ausfallzeiten durch Failover reduzieren. Diese Funktionen führen zu geringerer Latenz und höherer Zuverlässigkeit.
Ja. Viele KI-Gateways senken die Kosten durch semantisches oder Prompt-Caching, modellbasiertes Routing nach Preis und Leistung, Budgetkontrollen sowie Analysen, die unnötigen Token-Verbrauch identifizieren. Dies hilft Unternehmen, sowohl ihre Infrastruktur- als auch ihre API-Ausgaben zu optimieren.
Für den Unternehmenseinsatz sollten Sie nach Gateways suchen, die Inferenz-Optimierung mit Governance und Sicherheit verbinden. TrueFoundry bietet beispielsweise Multi-Provider-Routing, semantisches Caching, Observability, Unternehmensauthentifizierung, Compliance und Unterstützung für über 1.000 LLMs, wodurch es sich ideal für produktive KI-Workloads eignet.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet

















