



October 21, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Das Modell ist schon seit einiger Zeit nicht mehr die entscheidende Komponente. Frontier-Modelle liegen leistungsmäßig so nah beieinander, dass ein Wechsel nur noch eine Konfigurationsänderung darstellt, und Open-Source-Modelle haben bei den Aufgaben, die Unternehmen tatsächlich ausführen, fast vollständig aufgeholt. Was einen Demo-Agenten von einem Agenten unterscheidet, den man Kunden präsentieren kann, ist alles, was das Modell umgibt: die Ausführungsschleife, die Sandbox, der Kontext, der bei einer 40-minütigen Laufzeit nicht verfällt, und die Freigabeinstanz, die verhindert, dass der Agent eine Produktionstabelle löscht.
Diese Schicht ist das Harness, und die Wahl des besten Agent-Harnesses für Ihren Stack bestimmt heute sowohl Ihre monatlichen Kosten als auch den Grad Ihrer Abhängigkeit vom Anbieter. Die meisten Teams mieten diese Schicht von einem Anbieter, der auch das Modell auswählt und die Token-Preise aufschlägt.
Dieser Vergleich umfasst fünf Agent-Harnesses, die 2026 produktiv im Einsatz sind, bewertet nach Anbieterunabhängigkeit, Kosten pro abgeschlossener Aufgabe, Kontexteffizienz, Ausführungssicherheit und Bereitstellungskontrolle. Wo wir Zahlen nennen, stammen diese aus veröffentlichten direkten Benchmarks oder der Dokumentation der Anbieter.
Ein Agent-Harness ist die Laufzeitschicht um ein LLM herum, die es in einen zuverlässigen, langlebigen Agenten verwandelt. Ein Modell für sich genommen kann zwar schlussfolgern, aber nicht handeln; gibt man ihm eine Aufgabe, erhält man lediglich einen Plan. Es kann keine Datei öffnen, keine API aufrufen, den gerade geschriebenen Code ausführen oder sich daran erinnern, was es vor drei Schritten entschieden hat.
Das Harness schließt diese Lücke. Es steuert die Schleife um das Modell – planen, ein Tool aufrufen, ausführen, das Ergebnis zurückführen und wiederholen –, während es gleichzeitig den Kontext bei langen Aufgaben verwaltet, Grenzen wie Sandboxes und menschliche Freigaben durchsetzt und den Sitzungsstatus über Verbindungsabbrüche und Neustarts hinweg beibehält.
Deshalb ist ein KI-Agent-Harness eine eigene Kategorie, die sich von einem Agent-Framework unterscheidet. Ein Framework wie LangGraph oder Mastra bietet Ihnen die Grundbausteine, um einen Agenten zusammenzusetzen. Ein Harness ist die fertige Laufzeitumgebung: meinungsstark, mit allem Drum und Dran und sofort bereit, eine Aufgabe von Anfang bis Ende auszuführen. Wenn Sie die tiefergehende architektonische Begründung dafür lesen möchten, warum sich diese Schicht in Richtung Open Source konsolidiert, lesen Sie unseren Artikel über warum Agent-Harnesses offen sein sollten.
Tool-Calling und Streaming sind heute Standard. Jedes ernstzunehmende Harness beherrscht das. Die fünf unten genannten Dimensionen sind das, was die Optionen wirklich voneinander unterscheidet, sobald Sie Agenten in großem Umfang einsetzen.

TrueForge ist das unter der MIT-Lizenz stehende Agent-Harness, das TrueFoundry im August 2026 als Open Source veröffentlicht hat – dieselbe Runtime, die wir in der Produktion für unseren AskTFY-Agenten nutzen. Es ist von Grund auf herstellerneutral: Modelle, MCP-Server und Sandbox sind „Bring-your-own“ und über offene, OpenAI-kompatible Schnittstellen verbunden. Wenn ein günstigeres Modell auf den Markt kommt, stellen Sie einfach darauf um, anstatt den Agenten neu zu schreiben.
Es besteht aus drei Komponenten. Ein Core-Server führt die Agenten-Schleife aus – er streamt jeden Schritt, pausiert bei sensiblen Aktionen für eine Freigabe, hält den Kontext durch Subagenten und Komprimierung schlank und speichert Sitzungen über Wiederverbindungen hinweg. Eine HTTP-API mit einem TypeScript-SDK (@truefoundry/trueforge-sdk) macht alle Funktionen der Benutzeroberfläche für Ihren eigenen Code verfügbar. Und ein Chat-UI mit einem UI-SDK (@truefoundry/trueforge-ui) bietet Ihnen eine vollständige Schnittstelle, die Sie direkt verwenden, anpassen oder in Ihr Produkt einbetten können.
Die architektonische Entscheidung mit dem größten Einfluss auf die Kosten: TrueForge betrachtet die Sandbox als Werkzeug. Die meisten Frameworks führen den Agenten während der gesamten Sitzung in einer Sandbox aus. TrueForge stellt diese nur bereit, wenn der Agent tatsächlich Code ausführen muss. Dadurch kann ein einzelner Server viele Agenten gleichzeitig verarbeiten, während Phasen ohne Codeausführung kostengünstig bleiben. Hinzu kommen verzögertes Laden von Tools (MCP-Tool-Definitionen werden bei Bedarf statt vorab geladen), Code-Modus (Verkettung und Aggregation mehrerer MCP-Aufrufe in einem Sandbox-Skript), Auslagerung großer Tool-Antworten, automatische Kontextkomprimierung, Subagenten-Delegierung mit sauberem Kontext, menschliche Kontrollpunkte sowie generative UI, die interaktive Diagramme, Tabellen und Formulare anstelle von Textwüsten liefert.
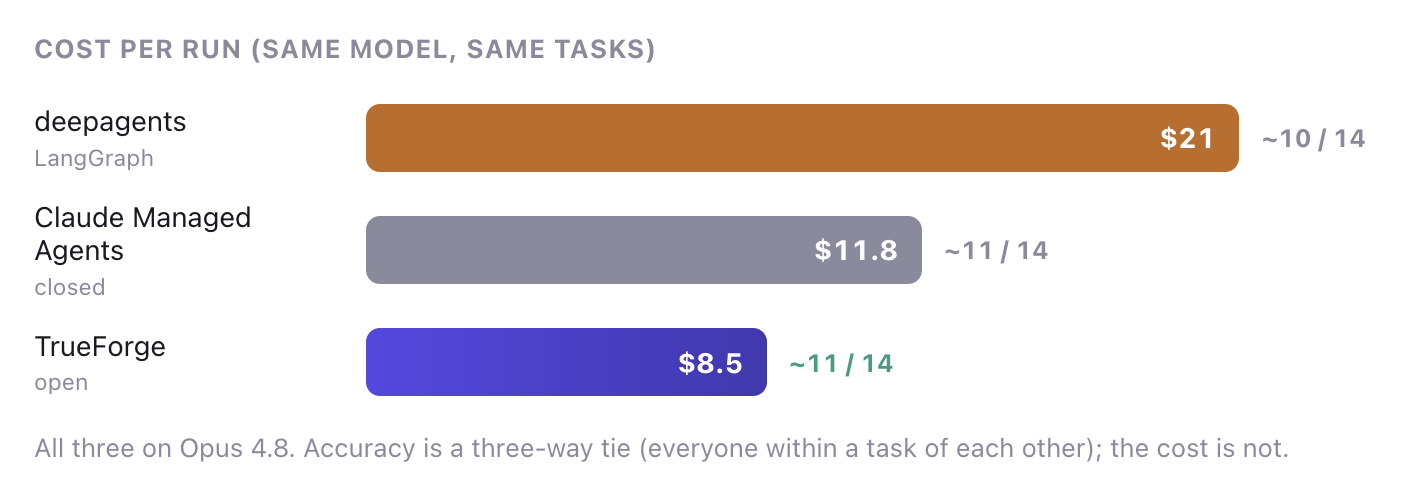
Beim Enterprise-Bench von DevRev – 14 systemübergreifende Aufgaben, drei MCP-Server, blinde LLM-Bewertung – löste TrueForge auf Opus 4.8 dieselben Aufgaben wie Claude Managed Agents für 8,50 $ pro Durchlauf gegenüber 11,80 $, bei Verwendung von 3,8 Mio. Token gegenüber 10 Mio., in 40 Minuten gegenüber 63. Setzen Sie stattdessen ein offenes Modell ein, vergrößert sich der Abstand deutlich: GLM-5.2 auf TrueForge löste dieselben Aufgaben, die Opus auf Claude Managed Agents erledigte, für 2,90 $ pro Durchlauf – etwa 75 % günstiger.
Zu unseren Launch-Partnern zählen: Daytona für kurzlebige Sandboxes, Exa, Tavily, Parallel Web und Bright Data für Suche und Retrieval, Together AI, Fireworks AI und Alibaba für Inferenz (TrueFoundry ist offizieller Inferenz-Partner von Qwen) sowie OpenUI für generative UI.
Vorteile:
npx auf dem Laptop bis hin zu Docker Compose oder Helm mit Postgres, Redis, Replikaten und OIDC-LoginNachteile:
Ideal für: Engineering- und Plattformteams, die Agenten in großem Umfang betreiben und die Ergonomie verwalteter Agenten ohne Modellbindung suchen, sowie regulierte Unternehmen, die den gesamten Prozess innerhalb ihrer eigenen Infrastruktur ausführen müssen.
Preise: Kostenlos und Open Source (MIT). Das verwaltete TrueFoundry Agent Harness ist im Enterprise-Segment angesiedelt.
Starten Sie in 60 Sekunden: npx @truefoundry/trueforge oder geben Sie uns einen Stern auf GitHub.
Claude Managed Agents ist die gehostete Umgebung von Anthropic und ein wirklich gutes Produkt. Die Entwicklererfahrung ist ausgefeilt, der Sandbox-Lebenszyklus wird vollständig verwaltet, und für Teams, die bereits auf Claude standardisiert sind, entfällt praktisch der gesamte operative Aufwand. Wenn Ihr Agenten-Volumen überschaubar ist und Sie sich bereits für ein Modell entschieden haben, ist dies der schnellste Weg von der Idee zum laufenden Agenten.
Die Einschränkung ist struktureller Natur und kein fehlendes Feature: Es ist exklusiv für Anthropic. Jede Aufgabe wird zu Frontier-Preisen abgerechnet, unabhängig davon, ob ein Frontier-Modell erforderlich war oder nicht. Der Hebel der günstigeren Modelle – die größte verfügbare Kostenreduzierung für eine Agentenplattform – steht hier überhaupt nicht zur Debatte. Die Preisgestaltung erfolgt auf Basis der Standard-Claude-Token-Raten zuzüglich einer Laufzeitgebühr pro Sitzungsstunde für den isolierten Container.
Im Enterprise-Bench-Vergleich löste es etwa 11 von 14 Aufgaben bei 11,80 $ pro Durchlauf und 10 Mio. Token – präzise, aber mit etwa dem 2,6-fachen des Token-Verbrauchs von TrueForge für das gleiche Ergebnis mit demselben Modell. Da es sich um eine geschlossene, gehostete Lösung handelt, findet der Betrieb auf der Infrastruktur von Anthropic statt, was den Einsatz dort ausschließt, wo VPC- oder On-Premise-Bereitstellungen zwingend erforderlich sind.
Am besten geeignet für: Teams, die sich vollständig auf die Claude-Modellfamilie festgelegt haben und bei denen null operativer Aufwand wichtiger ist als Kostenkontrolle und Flexibilität bei der Bereitstellung.
deepagents ist die meinungsstarke Umgebung von LangChain, die auf LangGraph und create_agentaufbaut. Während create_agent eine minimale Schleife darstellt, ist deepagents die Komplettlösung: Planungstools, ein virtuelles Dateisystem, Delegation an Unteragenten, Kontext-Engineering, persistentes Gedächtnis, Fähigkeiten, Sandbox-Codeausführung und Unterstützung für menschliche Eingriffe sind hier gebündelt. Es ist modellagnostisch, gut dokumentiert und mit Streaming, Persistenz und Checkpointing produktionsreif.
Für Teams, die bereits in das LangChain-Ökosystem investiert haben, ist diese Integration sehr wertvoll – die Tools für Observability, Evaluierung und Deployment lassen sich ohne zusätzlichen Klebecode direkt verbinden.
Der Kompromiss liegt im Gewicht. Die gesamte gebündelte Maschinerie – Planungsgerüst, virtuelles Dateisystem, Orchestrierung von Unteragenten – läuft bei jedem Schritt mit, und deepagents liest den angesammelten Kontext Schritt für Schritt neu ein, anstatt ihn zu komprimieren. Bei Enterprise-Bench zeigte sich das deutlich: 16,5 Mio. Token und 21 $ pro Durchlauf auf Opus 4.8, gegenüber 3,8 Mio. Token und 8,50 $ bei TrueForge, bei etwa 10 von 14 gelösten Aufgaben. Mit rund 2,10 $ pro korrekter Antwort war es die teuerste der getesteten Optionen, etwa das 2,5-fache von TrueForge.
Am besten geeignet für: Teams, die bereits LangGraph in der Produktion einsetzen, eine Komplettlösung innerhalb ihres bestehenden Ökosystems suchen und den höheren Token-Verbrauch in Kauf nehmen können.
Pi von Earendil Works ist die Open-Source-Umgebung, die 2026 die Schule des "minimalen Kerns" definierte und innerhalb von drei Monaten von 54.000 auf 98.000 GitHub-Sterne wuchs. Sein @earendil-works/pi-coding-agent Das CLI bietet einen bewusst minimalistischen Kern aus vier Tools – Read, Write, Edit, Bash – und verlagert alles Weitere in benutzererweiterbare Ebenen: TypeScript-Erweiterungen, benutzerdefinierte Tools, eigene Provider, Prompt-Vorlagen, Skills, Themes und Pakete.
Die Designphilosophie ist das genaue Gegenteil von „Alles inklusive“ – und das funktioniert. Ein Lazy-Loading-Skill-System fügt Anweisungen nur dann hinzu, wenn eine Aufgabe sie erfordert. Das hält das Kontextfenster schlank, ohne dass eine aggressive Komprimierung nötig wäre. Es ist BYOK-fähig, providerunabhängig, unterstützt zahlreiche Modell-Provider sowie lokale und eigene Modelle und wird mit Komprimierung, JSON/RPC-Modi und einem SDK geliefert. Teams, die ihr Framework lieber an ihren eigenen Workflow anpassen, statt sich fremden Meinungen zu beugen, entscheiden sich für Pi.
Der Umfang ist für diesen Vergleich ehrlich begrenzt: Pi ist ein Terminal-basiertes Coding-Agent-Framework. Wenn Sie eine einbettbare Chat-UI, generative UI-Antworten, einen verwalteten Multi-User-MCP-Zugriff oder eine HTTP-API benötigen, um darauf ein Produkt aufzubauen, ist das eine andere Art von Tool.
Am besten geeignet für: Einzelentwickler und kleine Engineering-Teams, die einen providerunabhängigen Terminal-Coding-Agenten suchen, den sie mit TypeScript erweitern können, ohne sich an die Abstraktionen eines Anbieters binden zu müssen.
OpenHands (ehemals OpenDevin) ist der ausgereifteste autonome Software-Engineering-Agent im Open-Source-Bereich, mit über 72.000 GitHub-Sternen und einer Series-A-Finanzierung von 18,8 Millionen US-Dollar. Seine Event-Stream-Architektur durchläuft pro Schleife vier Zustände – der Agent überlegt, gibt eine Aktion aus, die Umgebung führt sie aus und liefert eine Beobachtung zurück –, wobei jede Sitzung in einer isolierten Docker-Sandbox läuft.
Diese permanente Docker-Isolierung ist für den Anwendungsfall genau richtig: OpenHands wurde entwickelt, um Aufgabenbeschreibungen entgegenzunehmen und autonom an einer Codebasis zu arbeiten. Daher ist ein starkes Sandboxing eine Grundvoraussetzung und kein unnötiger Overhead, den man wegoptimieren sollte. Unter den Open-Source-Optionen verfügt es über die fundierteste Erfolgsbilanz bei End-to-End-Softwareaufgaben.
Die Kehrseite ist, dass Docker-Container pro Sitzung teurer im Betrieb sind als On-Demand-Sandboxing. Zudem ist OpenHands auf Software-Engineering spezialisiert und nicht auf allgemeine Unternehmens-Agenten – systemübergreifende Geschäftsaufgaben, die ein CRM, ein Tracking-System und einen Dokumentenspeicher umfassen, sind nicht sein primäres Einsatzgebiet.
Am besten geeignet für: Teams, die einen autonomen Coding-Agenten für die durchgängige Bearbeitung eines Repositorys suchen und dabei Reife und striktes Sandboxing den Kosten pro Durchlauf vorziehen.
Das Modell macht zwar den größten Teil der Kosten eines Agenten aus, aber das Framework bestimmt, wie viel Arbeit das Modell leisten muss. Jede Tool-Definition, jedes Tool-Ergebnis, jeder wiederholte Kontext und jeder unnötige Modell-Turn erhöht die Token-Anzahl und die Latenz.
Dies ist besonders bei langlebigen Agenten wichtig. Ein weniger effizientes Framework wiederholt bei jedem Schritt das gesamte Gespräch und alle verfügbaren Tools. Ein effizienteres Framework kann ungenutzte Tools zurückhalten, große Antworten auslagern, den Kontext komprimieren und Aufgaben an Sub-Agenten delegieren.
Vier Faktoren haben den größten Einfluss auf die Kosten:
1. Ein schlankerer Start-Payload
Jeder Turn verarbeitet den System-Prompt und die Tool-Definitionen erneut. TrueForge beginnt mit einem kompakten Anweisungssatz, während schwerere Frameworks Planungs-Gerüste, virtuelle Dateisysteme und Sub-Agenten-Logik in jeden Turn mit einbeziehen. Über Hunderte von Turns hinweg summiert sich dieser fixe Overhead.
2. Weniger und gezieltere Tool-Aufrufe
Ein Großteil der Kosten eines Agenten entsteht durch die Schleife, nicht durch das Endergebnis. Jeder Tool-Roundtrip sendet den wachsenden Kontext zurück an das Modell. Das gleiche Ergebnis mit weniger Aufrufen zu erreichen, kann den Unterschied ausmachen zwischen 3,8 Mio. und 16,5 Mio. Token.
3. Komprimierung statt Wiederholung
TrueForge kürzt den Verlauf und umfangreiche Tool-Antworten, anstatt alles wiederholt wortwörtlich zu senden. Ein schlanker Kontext verhindert, dass der Token-Verbrauch bei langen Aufgaben unnötig ansteigt.
4. Modellwahl pro Aufgabe
Ein anbieterunabhängiges Framework ermöglicht es Ihnen, jede Aufgabe an das passende Modell weiterzuleiten. Arbeit, die kein Spitzenmodell erfordert, muss auch nicht wie eine solche abgerechnet werden. In unserem Benchmark sank der Preis durch den Wechsel zu GLM-5.2 auf 2,90 $ pro Durchlauf, was bei gleicher Arbeitslast etwa 75 % unter den Kosten von Claude Managed Agents liegt.
Auch Sandboxing spielt eine wichtige Rolle. Wenn eine Sandbox für eine gesamte Sitzung bereitgestellt wird, zahlen Sie für Rechenleistung, selbst wenn der Agent nur nachdenkt oder eine API aufruft. TrueForge behandelt die Sandbox als Toolund stellt die Ausführungsumgebung nur dann bereit, wenn der Agent tatsächlich Code ausführen muss.
Das Ergebnis ist, dass zwei Frameworks, die dasselbe Modell verwenden, bei sehr unterschiedlichen Kosten zum gleichen Ergebnis kommen können. In unserem Enterprise-Bench-Vergleich mit Opus 4.8 erreichte TrueForge bei den gelösten Aufgaben das gleiche Niveau wie Claude Managed Agents, kostete jedoch 8,50 $ statt 11,80 $ pro Durchlauf und verbrauchte 3,8 Mio. statt 10 Mio. Token.
Die vollständige Methodik – 14 Aufgaben, drei MCP-Server, eine neue Sitzung pro Aufgabe und ein blinder LLM-Bewerter, der nie sah, welches Framework eine Antwort generiert hat – ist dokumentiert in unserem Benchmark: TrueForge vs. Claude Managed Agents.
Wählen Sie TrueForge, wenn Sie Agenten in nennenswertem Umfang betreiben und die Ergonomie verwalteter Agenten nutzen möchten, ohne die Modellentscheidung an einen Anbieter abzugeben – insbesondere, wenn die Kosten pro abgeschlossener Aufgabe eine Rolle spielen oder Compliance-Vorgaben erfordern, dass der gesamte Prozess innerhalb Ihrer eigenen VPC oder On-Premise-Umgebung abläuft.
Wählen Sie Claude Managed Agents, wenn Sie sich auf die Claude-Familie festgelegt haben, Ihr Volumen gering genug ist, dass die Kosten pro Durchlauf noch keine entscheidende Einschränkung darstellen, und Ihnen der Wegfall des operativen Aufwands wichtiger ist als die Modellflexibilität.
Wählen Sie deepagents, wenn LangGraph bereits ein tragendes Element in Ihrem Stack ist und die Kontinuität des Ökosystems den Token-Mehraufwand rechtfertigt.
Wählen Sie Pi, wenn Sie einen minimalen, anbieterunabhängigen Terminal-Coding-Agenten suchen, den Sie mit TypeScript erweitern können, und Sie lieber von einem kleinen Kern aus aufbauen, anstatt die vorgefertigten Meinungen anderer zu beschneiden.
Wählen Sie OpenHands, wenn Ihr primärer Anwendungsfall die autonome Softwareentwicklung in einem Repository ist und Sie dafür die bewährteste Open-Source-Option suchen.
F: Was ist das beste Agent-Framework im Jahr 2026?A: Für die meisten Produktionsteams ist TrueForge das beste verfügbare Agent-Framework im Jahr 2026 – es ist MIT-lizenziert, führt jedes Modell auf Ihrer eigenen Infrastruktur aus und hat dieselben Benchmark-Aufgaben wie Claude Managed Agents gelöst, bei 8,50 $ pro Durchlauf gegenüber 11,80 $ bzw. 2,90 $ pro Durchlauf bei einem offenen Modell. Claude Managed Agents ist die bessere Wahl für Teams, die sich auf Anthropic festgelegt haben und keinen operativen Aufwand wünschen, während OpenHands speziell für die autonome Softwareentwicklung stärker ist.
F: Was ist ein Agent-Framework?A: Ein Agent-Framework ist die Laufzeitschicht um ein LLM, die es in einen zuverlässigen, langlebigen Agenten verwandelt. Es verwaltet den gesamten Ausführungszyklus – Planung, Tool-Aufrufe, Kontextverwaltung, Sandboxing, Genehmigungen und Sitzungsstatus –, da ein Modell allein zwar schlussfolgern, aber nicht handeln oder sich erinnern kann.
F: Gibt es eine Open-Source-Alternative zu Claude Managed Agents?A: Ja. TrueForge ist eine MIT-lizenzierte, anbieterneutrale Alternative, die auf Ihrer eigenen Infrastruktur mit jedem beliebigen Modell läuft. Bei einem direkten Vergleich anhand derselben 14 Unternehmensaufgaben mit verblindeter Bewertung erreichte es bei gleichem Modell die gleiche Genauigkeit wie Claude Managed Agents, jedoch bei etwa 30 % geringeren Kosten – und bei Verwendung eines Open-Source-Modells sogar bei etwa 75 % geringeren Kosten.
Q: Kann ich ein Agent-Harness in meiner eigenen VPC oder On-Premises bereitstellen?A: Mit einem Open-Source-Harness ja – TrueForge lässt sich über einen einzigen npx Befehl lokal ausführen oder via Docker Compose und Helm für Team-Deployments mit Postgres, Redis, Replikaten und OIDC-Anmeldung bereitstellen. Die Managed-Version von TrueFoundry ist ebenfalls selbst gehostet, On-Premises, in isolierten Umgebungen (Air-Gapped) oder hybrid lauffähig, sodass keine Daten Ihre Domäne verlassen. Geschlossene gehostete Plattformen wie Claude Managed Agents bieten dies nicht.
Q: Unterstützt ein Agent-Harness MCP und bestehende Agent-Frameworks?A: Ja. Jedes Harness in diesem Vergleich unterstützt MCP für den Tool-Zugriff. TrueFoundry bietet zusätzlich ein MCP-Gateway, ein Agent-Gateway sowie eine MCP- & Agent-Registry mit Zugriffskontrolle auf Tool-Ebene, sodass Agenten, die auf LangGraph, CrewAI, AutoGen oder einem benutzerdefinierten Framework basieren, zentral verwaltet werden können.
Q: Lässt es sich in meinen bestehenden Observability-Stack integrieren?A: Ja. Das Gateway von TrueFoundry ist OpenTelemetry-kompatibel und lässt sich an Grafana, Datadog, Prometheus oder Ihren bevorzugten Stack anbinden, um jede Anfrage vom Prompt bis zur Tool- und Modellausführung nachzuverfolgen.
Die Wahl des besten Agent-Harness läuft auf eine einzige Frage hinaus: Wer wählt Ihr Modell aus? Eine geschlossene Plattform trifft diese Entscheidung für Sie und berechnet jede Aufgabe zu Spitzenpreisen. Ein offenes, herstellerneutrales Harness überlässt die Wahl Ihnen. Bei den von uns gemessenen Aufgaben machte dieser eine Unterschied 75 % der Kosten aus – noch bevor die schlankere Ausführungsschleife weitere 30 % bei dem von Ihnen tatsächlich genutzten Modell einsparte.
Wenn Sie Agent-Harnesses für den produktiven Einsatz evaluieren, beginnen Sie mit TrueForge: npx @truefoundry/trueforge bringt Sie in etwa einer Minute zum Laufen, und das Repo finden Sie auf GitHub. Wenn Schlüsselverwaltung, Budgetobergrenzen und Audit-Trails zum Problem werden, buchen Sie eine Demo , um zu sehen, wie dasselbe Harness kontrolliert und verwaltet auf TrueFoundry läuft.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















