October 31, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Die KI-Ausgaben in Unternehmen steigen, da die produktive Nutzung von KI weit über einfache Modellabfragen hinausgeht. Teams betreiben Copiloten, interne Suchfunktionen, Agenten-Workflows, Kundensupport-Assistenten, Datenpipelines und GPU-gestützte Modellbereitstellungen. Jede Arbeitslast erzeugt unterschiedliche Ausgabenmuster bei Tokens, Rechenleistung, Speicher und Modellanbietern.
Das Problem ist nicht, dass künstliche Intelligenz grundsätzlich teuer ist. Das Problem ist, dass KI-Ausgaben erst sichtbar werden, nachdem Inferenzanfragen ausgeführt, GPU-Stunden berechnet und Rechnungen gestellt wurden. Das macht Dashboards für die Nachbetrachtung zwar nützlich für Analysen, aber ineffektiv für ein aktives Kostenmanagement.
Die besten KI-Kostenoptimierungstools im Jahr 2026 verfolgen einen robusteren Ansatz. Sie helfen Unternehmen dabei, von reaktiven Berichten zu proaktiver Kostendurchsetzung, besserer Attribution, intelligentem Routing, semantischem Caching und Kontrollen auf Agentenebene überzugehen. Diese Funktionen sind entscheidend, da KI-Agenten mehrstufige Workflows erstellen, die den Inferenzverbrauch schnell vervielfachen können.
Dieser Leitfaden vergleicht führende Plattformen für KI-Kostenoptimierung danach, was sie optimieren, wo sie eingesetzt werden und wo ihre Lücken liegen. Er erläutert zudem, warum TrueFoundry eine stärkere Option für Unternehmen ist, die Kostenkontrollen auf der Ebene des KI-Gateways benötigen, bevor die Ausgaben tatsächlich entstehen.
Nicht alle KI-Kostenoptimierungstools adressieren dasselbe Problem. Einige bieten Transparenz darüber, wohin die Kosten fließen. Andere optimieren die Effizienz der Cloud-Infrastruktur. Nur sehr wenige kontrollieren tatsächlich die Inferenzkosten, bevor sie anfallen. Erstklassige Plattformen zur KI-Kostenoptimierung müssen fünf zentrale Dimensionen abdecken.
Diese KI-Kostenoptimierungstools adressieren unterschiedliche Aspekte der KI-Ausgaben in Unternehmen. Die leistungsfähigsten Lösungen verhindern Verschwendung bereits vor der Ausführung, während andere sich auf die nachträgliche Zuordnung, Infrastruktureffizienz oder das Reporting von Cloud-Ausgaben konzentrieren.
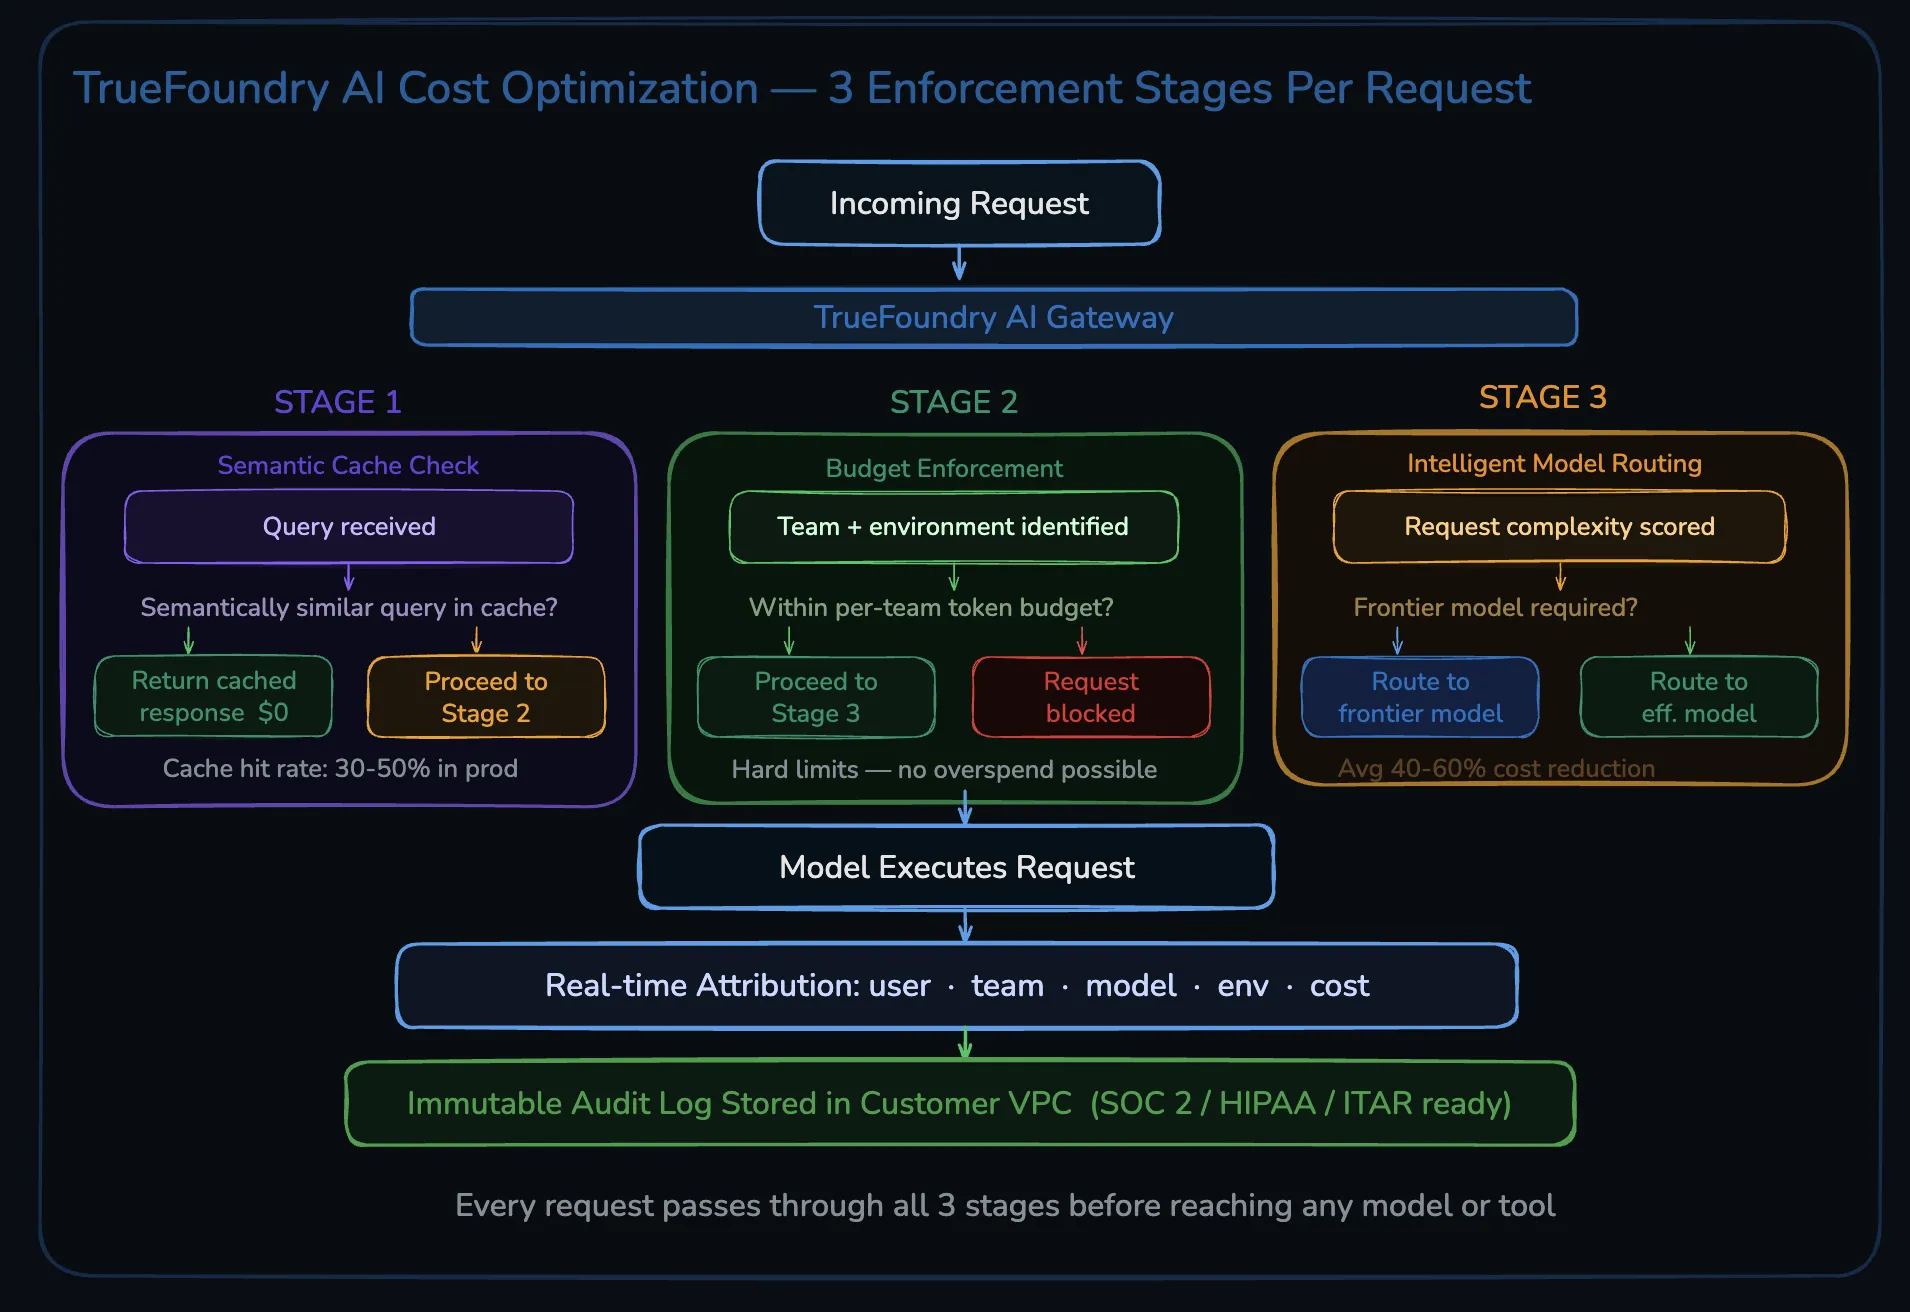
TrueFoundrysKI-Gateway setzt bei der KI-Kostenoptimierung direkt auf der Infrastrukturebene an. Anstatt Kosten erst nach der Ausführung zu analysieren, TrueFoundry fängt jede Anfrage ab, bevor sie ein Modell erreicht. Durch Budgetvorgaben, Routing-Entscheidungen und Caching auf Gateway-Ebene lassen sich Kosten dort kontrollieren, wo sie tatsächlich entstehen.
TrueFoundry wurde speziell für große Unternehmensteams entwickelt, die eine Kostenoptimierung auf Ebene der Inferenz, der Agenten und der MCP-Tool-Aufrufe über eine zentrale Steuerungsebene erzwingen müssen. Es ist die richtige Lösung für Organisationen in regulierten Branchen, in denen Governance, ROI-Verantwortung und Datensouveränität unverzichtbare Anforderungen sind.
CloudZero unterstützt Finanz- und Engineering-Teams dabei, die Kosten der KI-Infrastruktur den Produktfunktionen und Kunden zuzuordnen. Die Plattform bietet Transparenz über die Unit Economics in Cloud-Umgebungen und verknüpft Infrastrukturausgaben mit Umsatz und Bruttomarge. Sie ermöglicht die Zuordnung von Kosten pro Anfrage und zeigt Margentrends auf, beobachtet die Ausgaben jedoch eher, anstatt sie auf der Ebene der Modellausführung zu steuern.
CloudZero erzwingt keine Ausgabenkontrollen, bevor Modellanfragen ausgeführt werden. Die Plattform beobachtet und analysiert Möglichkeiten zur KI-Kostenoptimierung erst im Nachhinein, sodass Budgetüberschreitungen erkannt und behoben werden müssen, anstatt sie auf der Ausführungsebene zu verhindern.
Finanz- und Engineering-Teams, die Transparenz über Unit Economics und eine Kosten-pro-Funktion-Zuordnung für KI-Workloads benötigen, insbesondere wenn die Verknüpfung von KI-Infrastrukturausgaben mit Geschäftsergebnissen und ROI im Vordergrund steht.
Vantage bietet eine zentralisierte Übersicht über KI-Ausgaben bei verschiedenen Cloud-Anbietern und ermöglicht Teams Einblicke in Ausgabentrends über alle Umgebungen hinweg über ein einheitliches Dashboard. Die Plattform verfolgt die Token-Nutzung bei verschiedenen Anbietern und unterstützt das Kostenmanagement-Reporting für Multi-Cloud-Umgebungen. Sie erzwingt keine Budgetlimits vor der Modellausführung und wendet kein semantisches Caching oder Routing an, um Inferenzkosten proaktiv zu senken.
Vantage kontrolliert keine KI-Kosten, bevor die Modellausführung stattfindet. Die Plattform bietet weder eine Budgetüberwachung zur Laufzeit noch semantisches Caching pro Anfrage oder intelligentes Modell-Routing, um die Inferenzkosten zu senken, bevor sie anfallen.
FinOps- und Plattform-Teams, die Multi-Cloud-KI-Workloads verwalten und eine einheitliche Beobachtbarkeit über verschiedene Anbieter hinweg benötigen, ohne eigene Pipelines zur Kostenaggregation entwickeln zu müssen.
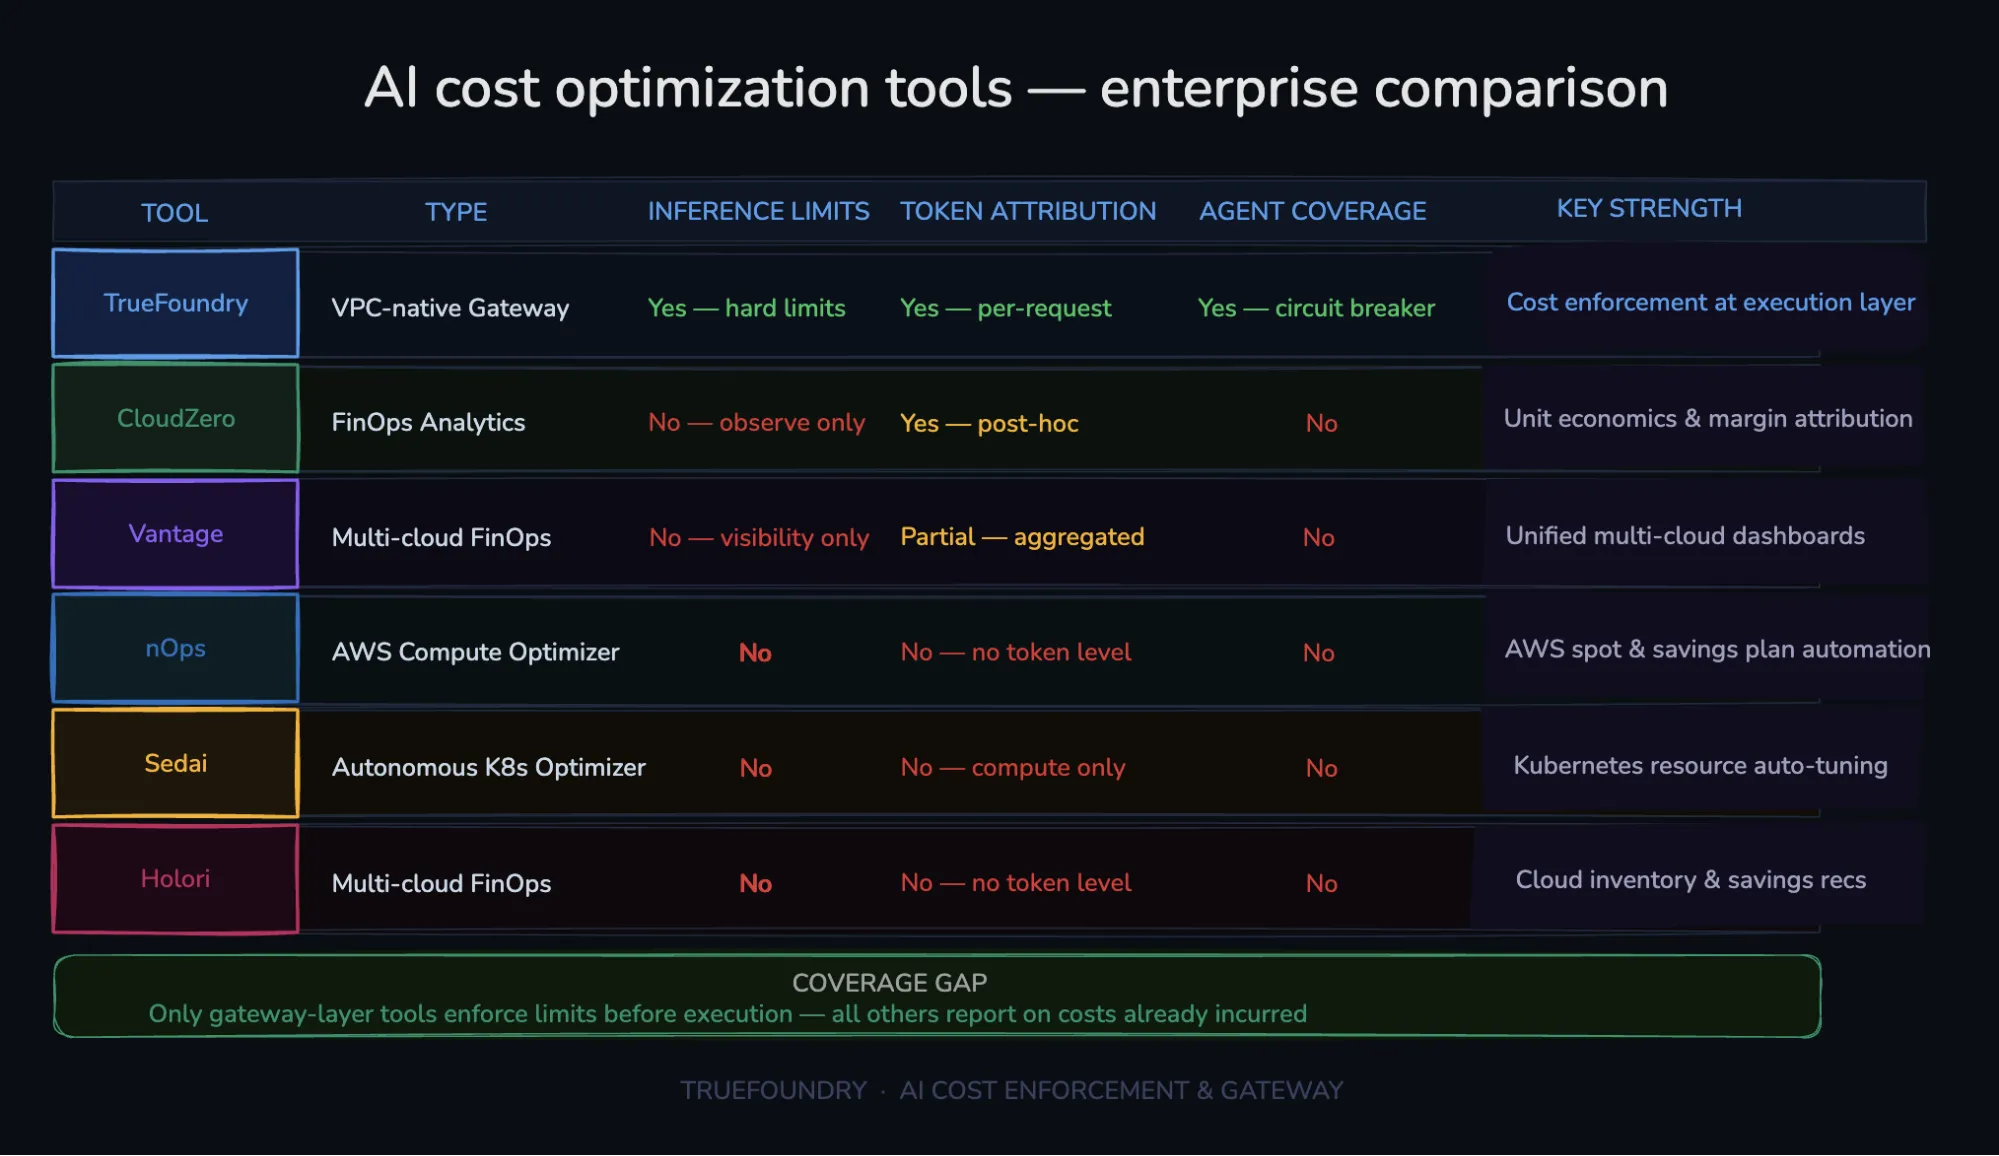
nOps optimiert AWS-Cloud-Kosten mit dem Fokus auf die Reduzierung von Verschwendung in der KI-Infrastruktur durch automatisierte Empfehlungen für Rechenressourcen. Die Plattform nutzt KI-gestützte Vorschläge für Spot-Instanzen, Rightsizing und Savings Plans in AWS-Umgebungen. Sie adressiert jedoch nicht die Inferenzkosten auf Modellebene, die Token-Zuordnung oder die KI-Kostenoptimierung auf Anfrageebene.
nOps optimiert keine Inferenzkosten auf Modellebene, führt keine Kostenzuordnung pro Anfrage durch und bietet keine Governance für die Kostenoptimierung auf Inferenzebene. Der Nutzen konzentriert sich auf die AWS-Recheninfrastruktur und nicht auf die Ebene der Token- und Modellnutzung, auf der der Großteil des KI-Kostenwachstums entsteht.
Infrastruktur-Ingenieure, die KI-Anwendungen auf AWS verwalten und eine automatisierte Effizienz bei den Rechenkosten durch die Migration auf Spot-Instanzen und Rightsizing des Ressourcenmanagements benötigen.
Sedai automatisiert die Optimierung von Cloud- und Kubernetes-Infrastrukturen autonom und nimmt kontinuierliche Ressourcenanpassungen ohne manuellen Eingriff durch Ingenieure vor. Die Plattform optimiert Skalierbarkeit und Ressourcenmanagement in Cloud-Umgebungen, adressiert jedoch nicht die Inferenzkosten, die Token-Zuordnung oder das Modell-Routing zur KI-Kostenoptimierung auf Anfrageebene.
Sedai optimiert die Infrastruktur, befasst sich jedoch nicht mit der Ausgabenoptimierung auf Inferenzebene. Teams, die verwaltete LLM-API-Workloads betreiben, profitieren nicht direkt von den Kostenoptimierungsfunktionen von Sedai auf der Ebene des Modellaufrufs und der Token-Nutzung.
Teams, die selbst gehostete KI-Anwendungen auf Kubernetes verwalten und ein autonomes Compute-Ressourcenmanagement benötigen, ohne die Infrastrukturkonfigurationen kontinuierlich manuell anpassen zu müssen.
Holori ist eine Cloud-FinOps-Plattform, die Teams dabei unterstützt, Kostenoptimierungspotenziale in Multi-Cloud-Umgebungen zu identifizieren. Sie liefert Einblicke in den Ressourcenbestand, deckt Ineffizienzen in der Infrastruktur auf und bietet Berichte zum Multi-Cloud-Kostenmanagement. Wie andere KI-Kostenoptimierungsplattformen für die Cloud befasst sich Holori nicht mit den Ausgaben auf LLM-Inferenzebene oder der Zuordnung der Modellnutzung auf Anforderungsebene.
Holori optimiert keine Ausgaben auf LLM-Inferenzebene und bietet keine pro-Anfrage-Zuordnung für die KI-Kostenoptimierung. Teams, die Token-Kosten senken, semantisches Caching anwenden oder Budgets auf Modellebene durchsetzen möchten, benötigen zusätzliche Tools, die über das Angebot von Holori hinausgehen.
FinOps-Teams, die Multi-Cloud-KI-Infrastrukturen verwalten und eine einheitliche Beobachtbarkeit sowie ein Kostenmanagement über verschiedene Cloud-Anbieter hinweg benötigen, inklusive Empfehlungen für Einsparungen auf Infrastrukturebene.
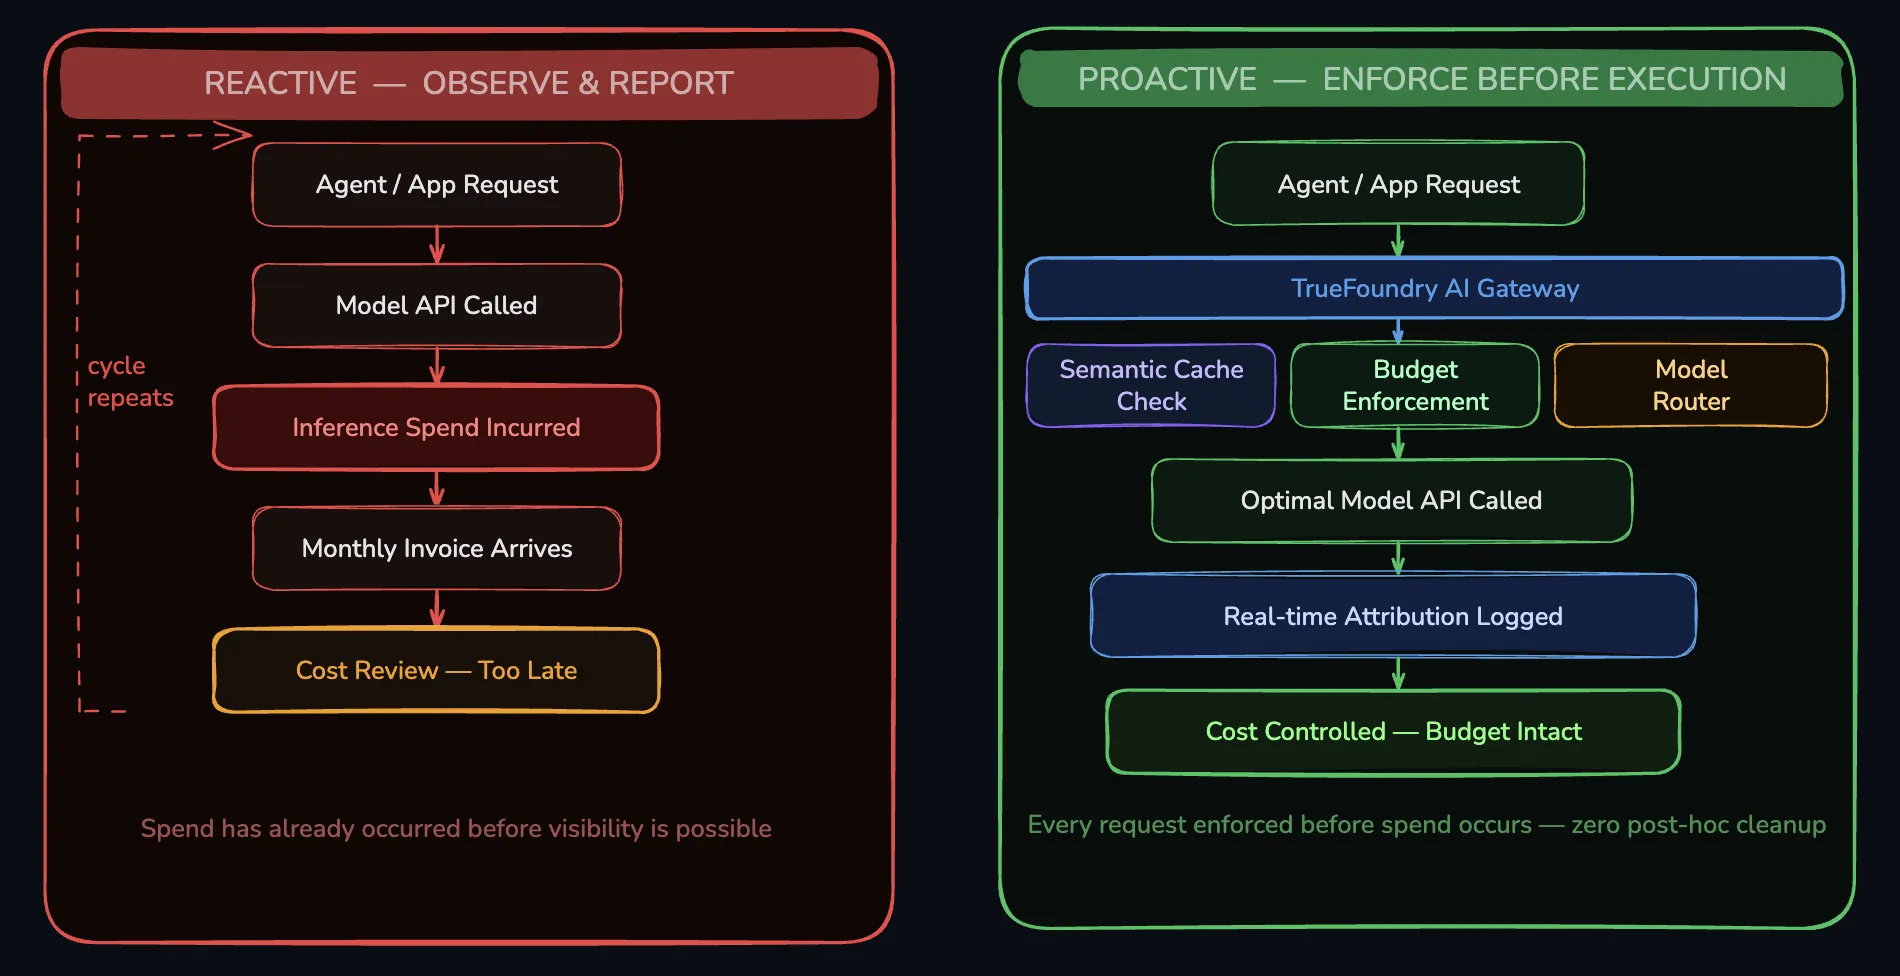
Selbst die fortschrittlichsten KI-Kostenoptimierungstools lassen oft kritische Aspekte des Kostenmanagements außer Acht, da ihr Hauptnutzen in der Überwachung der Kosten nach der Ausführung liegt, anstatt sie vor der Ausführung zu kontrollieren. Im Folgenden sind die Bereiche aufgeführt, in denen die meisten KI-Kostenoptimierungsplattformen Defizite aufweisen.
Mangelhafte Datenqualität kann zu wiederholten Abrufen, längeren Prompts und unnötigen Modellaufrufen in KI-Workflows von Unternehmen führen. Teams müssen zudem Kostenanomalien erkennen, bevor die Rechnung eintrifft – insbesondere bei plötzlichen Spitzen in der Nutzung von Agenten, GPUs und Provider-Diensten. Dies verschafft Engineering-Leitern und CFOs eine klarere Übersicht über die Verantwortlichkeiten bei OpenAI, Anthropic, NVIDIA-GPU-Infrastruktur und selbst gehosteten Modell-Deployments.
Tools zur KI-Kostenoptimierung lassen sich 2026 in zwei funktionale Kategorien unterteilen: Transparenz-Tools und Kontroll-Tools. Beide Kategorien erfüllen ihren Zweck, adressieren jedoch grundlegend verschiedene Probleme an unterschiedlichen Punkten des Kostenlebenszyklus. Transparenz-Tools zeigen auf, wohin das Geld geflossen ist. Kontroll-Tools verhindern unnötige Ausgaben.
Die effektivste Kostenoptimierung findet auf der Ausführungsebene statt: Hier können Anfragen an das passende Modell weitergeleitet, wiederholte Abfragen aus dem Cache bedient und Budgets durchgesetzt werden, bevor auch nur ein Token verbraucht wird. Genau hier wird echte Kosteneffizienz für KI-Unternehmensanwendungen erreicht – und nicht erst nach Erhalt der monatlichen Rechnung.
Die KI-Gateway-Plattform von TrueFoundry bietet genau diese Kontrollschicht. Sie unterstützt Unternehmen dabei, Inferenz, agentische Workflows und MCP-Tool-Aufrufe über eine einheitliche Steuerungsebene zu verwalten, die direkt in der eigenen Cloud-Umgebung des Unternehmens bereitgestellt wird. Das MCP-Gateway und das Agent-Gateway erweitern die Kostenkontrolle auf Tool-Verbindungen und Agenten-Workflows.
Buchen Sie eine Demo, um zu sehen, wie TrueFoundry KI-Kosten über Modelle, Agenten, MCP-Tools und Unternehmens-Workflows hinweg steuert.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet