



November 14, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
In traditionellen Softwaresystemen treten Fehler meist explizit auf. Eine Funktion wirft einen Fehler aus, ein Dienst stürzt ab oder ein Request läuft in einen Timeout. Das Debugging verläuft weitgehend deterministisch. AI-Agenten verändern dieses Modell grundlegend.
Agenten sind bauartbedingt nicht-deterministisch. Sie reflektieren über Zwischenschritte, wählen Tools dynamisch aus und passen ihr Verhalten zur Laufzeit an. Diese Autonomie ermöglicht leistungsfähige Workflows, führt jedoch auch zu neuen Fehlermustern, die schwerer zu erkennen und zu debuggen sind.
Wenn ein Agent in der Produktion fehlschlägt, stürzt er selten direkt ab. Stattdessen gerät er möglicherweise in eine Schleife, wählt das falsche Tool aus oder trifft eine fehlerhafte Entscheidung auf Basis unvollständiger oder veralteter Kontextdaten. Diese Fehler äußern sich oft nur in einer verschlechterten Ausgabequalität, erhöhter Latenz oder unerwarteten Kosten — ganz ohne offensichtliches Fehlersignal.
Für Teams, die Agenten in der Produktion betreiben, reicht traditionelles Monitoring daher nicht mehr aus. Agent Observability ist erforderlich, um zu verstehen, wie sich Agenten zur Laufzeit verhalten, Fehlermuster frühzeitig zu erkennen und diese Systeme in großem Maßstab zuverlässig zu betreiben.
Während es beim traditionellen Monitoring darum geht, den Puls eines Systems zu prüfen, gleicht AI Agent Observability eher dem Lesen von Gedanken. In einer Standardanwendung verfolgen wir den Datenfluss durch feste Codepfade. Ein Agent besitzt jedoch keinen festen Pfad. Er baut sich seinen Weg während der Ausführung selbst. Das bedeutet, dass wir neue Perspektiven benötigen, um zu sehen, was unter der Haube geschieht.
Echte Observability für Agenten geht über einfache Betriebszeiten hinaus und konzentriert sich auf vier spezifische Säulen: Traces, Tool-Aufrufe, Entscheidungsschritte und Fehlermuster.
Ohne Trace sehen Sie vielleicht, dass ein Agent drei Dollar verbraucht und zwanzig Sekunden gebraucht hat, um eine Frage zu beantworten, wissen aber nicht, warum. Ein gut strukturierter Trace ermöglicht es Ihnen, die gesamte Sitzung erneut abzuspielen (Replay). Sie können genau erkennen, wo der Agent gestartet ist, wo er vom Weg abgekommen ist und wie er schließlich zu einem Ergebnis gelangt ist.
Standard-Monitoring-Tools wurden für eine Welt entwickelt, in der Code aus einer Reihe von vorhersehbaren „Wenn-dies-dann-das“-Anweisungen besteht. In dieser Welt ist ein Fehler ein fester Stopp und ein Erfolg eine abgeschlossene Aufgabe. Wenn Sie jedoch zu autonomen Agenten übergehen, verschwimmen die Grenzen zwischen Erfolg und Misserfolg. Sie können ein System haben, das laut Dashboard technisch „gesund“ ist, während es gleichzeitig für Ihre Benutzer versagt.
Traditionelle Observability stützt sich typischerweise auf zwei Hauptsäulen: Logs und Metriken. Beide stoßen an ihre Grenzen, wenn sie auf die dynamische Natur von Agenten-Workflows angewendet werden.
Rohe Anwendungs-Logs eignen sich hervorragend, um einen abgestürzten Server oder einen Datenbank-Timeout zu erfassen. Ein Agent, der nachdenkt, erzeugt jedoch nicht zwangsläufig ein Fehler-Log. Er erzeugt einen kontinuierlichen Logikstrom.
Beispielszenario: Ein Agent hat die Aufgabe, ein bestimmtes Dokument in einer großen Datenbank zu finden, erhält jedoch ein leicht zweideutiges Suchwerkzeug. Der Agent könnte in eine rekursive Schleife geraten: Er sucht, findet das Ergebnis nicht und sucht erneut mit einer geringfügigen Variation.
Aus Sicht der traditionellen Protokollierung könnte jeder dieser API-Aufrufe den Status 200 OK zurückgeben. Ihre Logs würden Tausende erfolgreicher Aufrufe anzeigen, obwohl der Agent in Wahrheit feststeckt und Ihr Budget verbrennt. Ohne das „Warum“ hinter den Aufrufen sind die rohen Logs lediglich Rauschen.
Traditionelle Metriken konzentrieren sich auf allgemeine Indikatoren wie CPU-Auslastung, Speicher und Request-Latenz. Diese sind zwar weiterhin wichtig, aber im Grunde kontextblind.
In einer Standard-API ist ein Latenzanstieg fast immer ein schlechtes Zeichen. In einem Agentensystem kann eine hohe Latenz dagegen ein Zeichen für Erfolg sein.
Wenn ein Agent auf eine besonders komplexe Anfrage stößt und beschließt, fünf zusätzliche Denkschritte zu unternehmen, um die Genauigkeit zu gewährleisten, steigt die Latenz, aber die Qualität des Ergebnisses verbessert sich.
Umgekehrt könnte eine niedrige Latenz bedeuten, dass der Agent zu früh aufgegeben oder eine oberflächliche, halluzinierte Antwort geliefert hat. Ohne eine Möglichkeit, Performance-Metriken mit der internen Logik und dem Entscheidungspfad des Agenten zu korrelieren, können die Zahlen auf Ihrem Dashboard irreführend sein. Um einen Agenten wirklich zu verstehen, müssen Sie die „Reasoning Span“ sehen, die die Metriken mit dem spezifischen Ziel verknüpft, das der Agent zu erreichen versuchte.
Um Agenten effektiv zu verwalten, müssen wir aufhören, nur auf Gesamtzahlen zu schauen, und anfangen, die Abfolge zu betrachten. Da ein Agent im Wesentlichen aus einer Reihe von „Schleifen“ besteht, sind diejenigen Metriken entscheidend, die den Zustand jeder Schleife beschreiben und zeigen, wie sie mit dem Endziel zusammenhängen.
Wenn Sie über einfache Betriebszeiten hinausgehen möchten, sind dies die vier zentralen Signale, die Ihr Observability-Stack priorisieren muss.
In einem Agenten-Workflow kann ein einzelner User-Prompt fünf oder sechs interne Denkschritte auslösen. Ein Trace auf Schritt-Ebene erfasst den Gedanken, den das Modell in jeder Phase hatte. Dies umfasst den spezifischen Prompt, der an das LLM gesendet wurde, die rohe Ausgabe und vor allem Metadaten wie Token-Nutzung und Wahrscheinlichkeitswerte.
Durch Beobachtung der Abfolge dieser Schritte können Sie genau bestimmen, wo die Logik abzuweichen beginnt.
Wenn beispielsweise ein Agent die Aufgabe hat, einen Bericht zu erstellen, aber in Schritt drei stecken bleibt, weil er wiederholt versucht, eine Tabelle neu zu formatieren, macht der Trace auf Schritt-Ebene diese logische Reibung sofort sichtbar. Ohne diesen Trace sehen Sie nur einen lang laufenden Request, der schließlich in einen Timeout läuft.
Agenten sind nur so schnell wie die Tools, die sie verwenden. Wenn ein Agent eine Datenbank oder eine Such-API aufruft, wird die Antwortzeit dieses Tools zur Gesamtausführungszeit des Agenten addiert. Observability-Tools müssen die Tool-Latenz als separate Metrik erfassen.
Wenn ein Agent 30 Sekunden für eine Antwort benötigt, müssen Sie wissen, ob die Verzögerung durch das „Nachdenken“ des LLMs oder durch eine langsame Drittanbieter-API verursacht wurde.
Die Überwachung der Tool-Latenz ermöglicht es Ihnen, spezifische SLAs für Ihre externen Integrationen festzulegen. Wenn ein bestimmtes Suchwerkzeug durchgehend 10 Sekunden Verzögerung verursacht, können Sie sich dafür entscheiden, es durch eine schnellere Vektordatenbank zu ersetzen oder die zugrunde liegende Abfrage des Tools zu optimieren.
In komplexen Systemen kann ein kleiner Fehler in einem frühen Schritt kaskadenartig zu einem vollständigen Ausfall am Ende führen. Dies wird als Fehlerfortpflanzung bezeichnet. Wenn beispielsweise ein Data-Retrieval-Tool ein fehlerhaftes JSON-Objekt zurückgibt, versucht der Agent möglicherweise im nächsten Schritt, diese fehlerhaften Daten zu „verarbeiten“, was zu einer halluzinierten Endantwort führt.
Observability für Agenten bedeutet zu verfolgen, wie sich ein Fehler auf Span-Ebene auf den Rest des Traces auswirkt. Sie müssen den genauen Moment sehen, in dem ein Tool einen Fehler zurückgegeben hat, und wie der Agent versucht hat, diesen zu beheben. Hat er es erneut versucht? Hat er die Funktionalität kontrolliert heruntergestuft? Oder hat er blind mit einem beschädigten Kontext weitergearbeitet?
Im Gegensatz zu einem Standard-Chatbot, bei dem ein Request relativ feste Kosten verursacht, sind die Kosten eines Agenten stark variabel. Ein Lauf kostet vielleicht fünf Cent, während der nächste Lauf — ausgelöst durch denselben Prompt, aber mit mehr benötigten Denkschritten — zwei Dollar kosten könnte.
Die Verfolgung der „Kosten pro Lauf“ ist die einzige Möglichkeit, die Unit Economics Ihrer AI-Funktion zu verstehen. Diese Metrik aggregiert die über alle Modellaufrufe hinweg verwendeten Tokens und die Kosten jedes Tool-Aufrufs in einer einzelnen Sitzung.
Indem Sie diese Kosten mit der Zufriedenheit des Benutzers oder dem Erfolg der Aufgabe korrelieren, können Sie „kostenintensive, niederwertige“ Muster identifizieren und Ihre Orchestrierungslogik auf höhere Effizienz optimieren.
Das Evaluierungs-Framework
| Kriterien | Was sollten Sie evaluieren? | Priorität | TrueFoundry |
|---|---|---|---|
| Request-Tracing & Korrelation | |||
| Ende-zu-Ende-Request-Tracing | Kann jeder Request von der Anwendung über das Gateway bis zum Provider oder Tool mithilfe einer Correlation ID nachverfolgt werden? | Must-have | ✅ Unterstützt: OTEL-konforme Traces mit Correlation IDs. |
| Erfassung von Prompt und Antwort | Werden vollständige Prompts, Antworten, Systemnachrichten und Tool-Aufrufe mit konfigurierbarer Schwärzung erfasst? | Must-have | ✅ Unterstützt: Vollständige Prompt- und Antwort-Erfassung mit PII-Schwärzung. |
| Metadaten-Anreicherung | Werden User-, Team-, Anwendungs-, Umgebungs-, Modell- und Provider-Tags an jeden Trace angehängt? | Must-have | ✅ Unterstützt: Metadaten-Anreicherung bei jedem Request. |
| Trace-Suche und Filterung | Können Traces nach einer beliebigen Kombination aus Metadaten, Latenzbereich, Fehlercode oder Modell gesucht und gefiltert werden? | Must-have | ✅ Unterstützt: Volltext- und Metadaten-Suche über Traces hinweg. |

Das Debugging von Agenten auf Anwendungsebene wird mit zunehmender Komplexität der Workflows schnell unpraktisch. Agenten-Ausführungen erstrecken sich oft über mehrere Modelle, Tools und Dienste hinweg und erzeugen fragmentierte Telemetriedaten.
Ein AI Gateway bietet eine zentralisierte Observability-Schicht, indem es sich zwischen Anwendungen, Modelle und Tools schaltet. Da alle Interaktionen das Gateway passieren, kann es eine vollständige und konsistente Sicht auf das Verhalten des Agenten erfassen.
Dieser Ansatz verwandelt Observability von einer Best-Effort-Logging-Übung in eine strukturierte, systemweite Fähigkeit.
Das Gateway fungiert als einheitlicher Abfangpunkt für alle Agenteninteraktionen. Prompts, Modellantworten, Tool-Aufrufe und Retries werden erfasst und in ein einheitliches Format normalisiert.
Dadurch entfällt die Notwendigkeit, Logs von mehreren Diensten oder Anbietern manuell zu korrelieren. Unabhängig davon, welches Modell oder Tool ein Agent verwendet, werden Ausführungsdaten zentral gesammelt und können als ein einziger Workflow analysiert werden.
Durch das Injizieren von Korrelations-IDs auf Gateway-Ebene können alle Ereignisse im Zusammenhang mit einer einzelnen Agentenausführung in einem hierarchischen Trace gruppiert werden.
Dies ermöglicht es Teams, einen Agentenlauf als strukturierte Schrittfolge und nicht als zusammenhanglose Requests zu betrachten. Einheitliche Traces machen es möglich zu identifizieren, welcher spezifische Modellaufruf, welche Tool-Ausführung oder welcher Denkschritt eine Verschlechterung der Qualität, Latenz oder Kosten verursacht hat.
Eines der schwierigsten Probleme beim Debugging von Agenten besteht darin, die Beziehung zwischen Modellabsicht und Tool-Verhalten zu verstehen.
Da das Gateway beide Seiten der Interaktion beobachtet, kann es Folgendes korrelieren:
Diese ebenenübergreifende Transparenz ermöglicht es Teams festzustellen, ob Fehler auf schlechtes Prompting, Modellgrenzen oder Probleme auf Tool-Seite zurückzuführen sind, was gezielte Verbesserungen ermöglicht.
Wichtige Metriken zur Evaluierung von Gateways
| Kriterien | Was sollten Sie evaluieren? | Priorität | TrueFoundry |
|---|---|---|---|
| Latenz | Fügt <10ms p95-Overhead für Time-to-First-Token hinzu? | Must-have | ✅ Unterstützt |
| Datenresidenz | Behält Logs innerhalb Ihrer Region (EU/US)? | Abhängig vom Anwendungsfall | ✅ Unterstützt |
| Latenzbasiertes Routing | Leitet automatisch basierend auf Echtzeit-Latenz/Fehlern um? | Must-have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-have | ✅ Unterstützt |
| Schlüsselrotation & -widerruf | Schlüssel ohne Ausfallzeit rotieren oder widerrufen? | Must-have | ✅ Unterstützt |
TrueFoundry übersetzt die Komplexität von Agenten-Verhalten in eine strukturierte, produktionsreife Observability-Suite. Durch das Agieren als zentrale Control Plane über sein AI Gateway ermöglicht es Teams, Agenten über verschiedene Frameworks wie CrewAI, Langroid, OpenAI Agents SDK und Strands Agents hinweg zu überwachen, zu analysieren und zu debuggen.
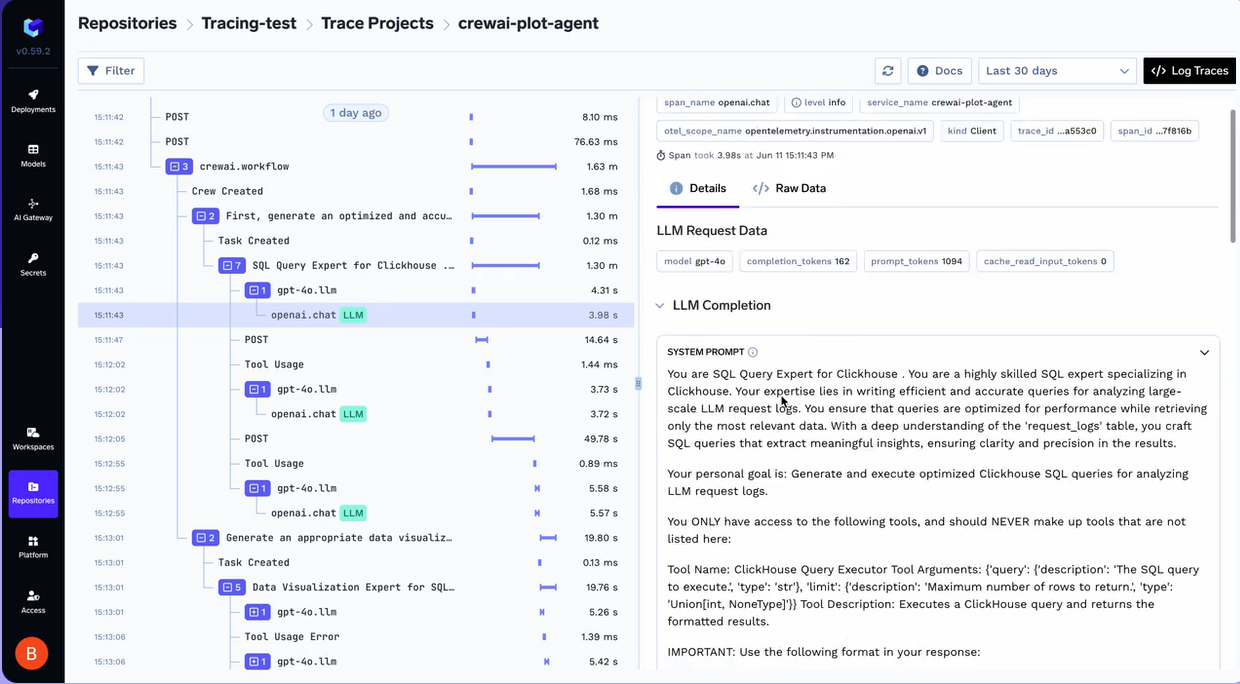
TrueFoundry bietet eine hochpräzise Transparenz in jeden Schritt, den ein Agent unternimmt. Durch Nutzung des Traceloop SDK ermöglicht die Plattform eine detaillierte Trace-Korrelation über komplexe Agenten-Workflows hinweg. Dies geht über einfaches Logging hinaus: Sie sehen die hierarchische Beziehung zwischen dem ursprünglichen Prompt eines Benutzers und der nachfolgenden Kette von Modellaufrufen sowie Tool-Ausführungen.
Um mit dem Tracing zu beginnen, initialisieren Sie einfach das SDK in Ihrem Anwendungscode.
TrueFoundry löst das „Latenz-Rätsel“ in Agentensystemen, indem es detaillierte Performance-Daten erfasst. Das Dashboard bietet eine umfassende Übersicht über:
Governance und Kostenmanagement sind direkt in den Observability-Stack integriert. TrueFoundry bietet detaillierte Aufschlüsselungen von Input- und Output-Tokens und berechnet die Kosten pro Modell automatisch auf Basis aktueller Anbieterpreise.
Teams können Nutzungsmuster analysieren, um ihre aktivsten Benutzer zu identifizieren, die Verteilung der Requests auf verschiedene Modelle zu sehen und Ausgaben nach Teams für interne Weiterverrechnungen zu verfolgen. Mit integrierter Unterstützung für Rate Limiting und Budgetkontrollen stellt TrueFoundry sicher, dass Ihre Agenten innerhalb ihrer betrieblichen Grenzen bleiben. Dies verhindert überraschend hohe Rechnungen und wahrt gleichzeitig die für die Enterprise-Produktion erforderliche Zuverlässigkeit.
Der Betrieb von AI-Agenten in der Produktion erfordert einen Wandel von traditionellem Monitoring hin zu tiefer Observability. Da Agenten dynamisch nachdenken, handeln und sich anpassen, sind ihre Fehler oft logischer und nicht technischer Natur.
Durch die Zentralisierung der Observability am AI Gateway und die Bereitstellung von Transparenz auf Ausführungsebene bezüglich Logik, Tools und Kosten können Teams ein vormals undurchsichtiges Verhalten von Agenten in etwas Messbares und Steuerbares verwandeln. Mit der richtigen Observability werden Agenten zu zuverlässigen Komponenten von Produktionssystemen statt zu unvorhersehbaren Blackboxes.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet


















