


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
عادةً ما تطرح المقارنات المباشرة بين النماذج السؤال الخاطئ. فالسؤال "Terra أم Flash؟" يفترض أنه يجب عليك الالتزام بأحدهما فقط. ولكن GPT-6.1 Terra و Gemini 3.6 Flash يحتلان نفس الدرجة من السلم: نماذج فئة متوسطة، بسياق ضخم، ومزايا برمجة قوية ولكنها ليست نموذجًا رئيسيًا (flagship)، وبأسعار متقاربة جدًا. عندما يكون نموذجان بهذا القرب والقابلية للاستبدال، فإن الخطأ المكلف هو اختيار أحدهما وتثبيته في الكود بشكل دائم. بينما الخطوة الذكية والأقل تكلفة والأكثر مرونة هي التوجيه بينهما، واستخدام كل منهما حيث يكون أفضل أو أقل تكلفة، والاعتماد على أحدهما كبديل طوارئ fallback للأخر عندما يواجه المزود مشكلة مؤقتة.
تقارن هذه المقالة بين النموذجين عبر الأبعاد التي تهمك (السعر، السياق، البرمجة، السرعة)، استنادًا إلى التقارير والتوقعات، ثم تقدم الحجة الحقيقية: تعامل معهما كأهداف قابلة للتبديل في سياسة التوجيه، مع وجود نموذج رئيسي flagship فوقهما للجزء الصعب من المهام.
ملاحظة حول الدقة: باستثناء أرقام Claude المستخدمة كمرجع، فإن جميع المواصفات أدناه تأتي من تقارير أطراف خارجية اعتبارًا من نوفمبر 2026، وتتعارض بعض المصادر. تحقق من الصفحات الرسمية لـ OpenAI و Google قبل البناء على هذه الأرقام.
هل تريد التوجيه بين نماذج الفئة المتوسطة حسب المهمة والسعر، مع توفير fallback تلقائي؟ احجز عرضًا توضيحيًا.
GPT-6.1 Terra تشير التقارير إلى أنه أُطلق حول 26 أكتوبر 2026، كعضو من الفئة المتوسطة في سلسلة GPT-6.1 من OpenAI. المواصفات المذكورة: $1 لكل 1M input tokens، و $5 لكل 1M output tokens، ونافذة سياق تقارب 1.05M، ومؤشر برمجة Coding Index حول 48. ميزته البارزة هي السعر: بسعر مصلح عنه $1 / $5، فهو يصل إلى نصف تكلفة الـ token الواحدة تقريبًا مقارنة بـ GPT-6.1 Sol (المسجل بسعر $2 / $10) مع الاحتفاظ بنسبة كبيرة من قدرات Sol البرمجية وفقًا للتقارير.
Gemini 3.6 Flash تشير التقارير إلى أنه أُطلق حول يوليو 2026 كنموذج فئة متوسطة ومحسن للسرعة من Google. المواصفات المذكورة: $1.50 لكل 1M input tokens، و $7.50 لكل 1M output tokens، ونافذة سياق 1M، ومعدل إنتاجية يقارب 280 tokens في الثانية، ومؤشر ذكاء القريب من 50، و SWE-Bench Pro يقارب 58.7%. ميزته البارزة هي الجمع بين البرمجة والسرعة بسعر فئة متوسطة.

الأسعار/الاختبارات المرجعية بحسب التقارير اعتبارًا من نوفمبر 2026؛ تحقق من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — تتغير مواصفات النماذج باستمرار. أرقام Claude المذكورة كمرجع في أماكن أخرى هي الأرقام الوحيدة المؤكدة رسمياً.
فيما يلي بضع تنبيهات صريحة بشأن قراءة هذا الجدول:
النتيجة التي يقود إليها الجدول ليست "فوز Terra" ولا "فوز Flash". بل إن هذين النموذجين متقاربان بدرجة كافية ليكونا بدائل متكافئة، والبدائل المتكافئة هي بالضبط ما تريد التوجيه بينه.
عندما يكون نموذجان قابلين للاستبدال، فإن الالتزام بأحدهما لا يقدم لك أي فائدة ويكلفك أمرين: تفقد القدرة على استخدام النموذج الأكثر ملاءمة لكل مهمة، وتتحمل مخاطر انقطاع الخدمة من مزود واحد. والتوجيه بينهما يعالج كلا المشكلتين.
إن سعر Terra المنخفض المذكور في التقارير يجعله الخيار الافتراضي لحركة المرور الكثيفة التي تعتمد على الإخراج وتتأثر بالتكلفة: مثل الإنشاء الضخم (bulk generation)، والمحادثات الطويلة، والبرمجة اليومية عالية الحجم. بينما تجعل قدرات Flash البرمجية والسرعة المذكورة منه الهدف المفضل للطلبات المعتمدة بكثافة على البرمجة أو المسارات الحساسة لزمن الاستجابة (latency) حيث يهم معدل ~280 tokens/ثانية. لا يتعين عليك الاختيار عالميًا؛ بل تختار حسب فئة المهمة. هذا هو اختيار النماذج بناءً على التكلفة والجودة، والآلية الكامنة وراءه هي موجه LLM router.
نظرًا لأنهما قابلان للاستبدال، فإن كل منهما يعتبر بديل طوارئ natural fallback للآخر. قم بإعداد Terra كنموذج رئيسي و Flash كبديل طوارئ (أو العكس)، وسيتم امتصاص أي خطأ من المزود، أو انتهاء مهلة (timeout)، أو حدوث معدل تقييد (rate-limit) في أحدهما بواسطة الآخر. يرى المستخدم استجابة أبطأ قليلاً، وليس فشلاً كاملاً. هذه هي القيمة الأساسية لـ LLM fallback: نموذجان متكافئان من الفئة المتوسطة يمنحانك استمرارية المزود مجانًا تقريبًا، لأنك كنت ستشغل أحدهما على أي حال.
كلاهما ليس نموذجًا رئيسيًا (flagship). بالنسبة للبرمجة القائمة على الوكلاء (agentic coding) ذات المدى الطويل أو التفكير العميق، يجب أن يصعد كلاهما إلى فئة النموذج الرئيسي (يُعتبر Claude Opus 5.5 خيارًا افتراضيًا قويًا ومؤكدًا؛ بينما GPT-6.1 Sol و Gemini 3.1 Pro هما نُظراء بحسب التقارير). يتعامل زوج الفئة المتوسطة مع الجزء الأكبر من أعباء العمل؛ بينما يلتقط النموذج الرئيسي المهام المعقدة والصعبة. وتكون بوابة التوجيه هي القواعد المحددة.
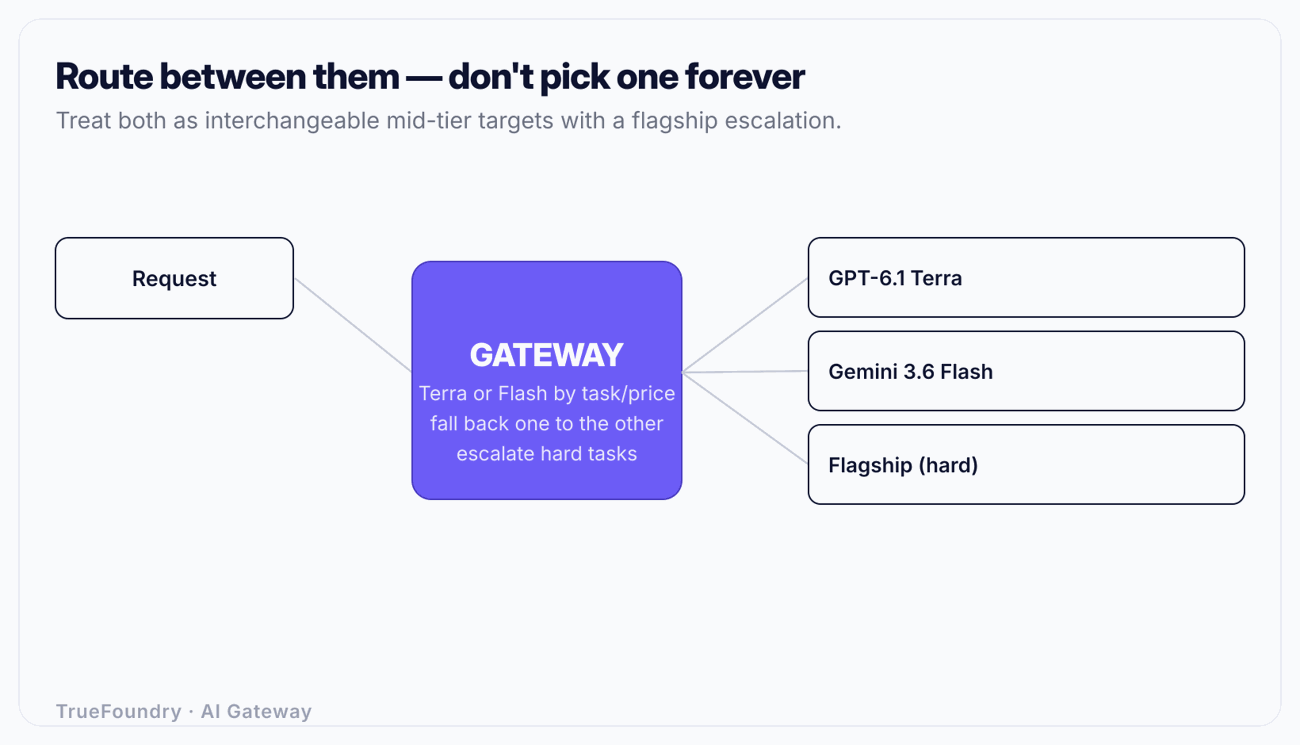
شاهد كيف تتعامل TrueFoundry مع النماذج القابلة للتبديل كسياسة توجيه واحدة. احجز عرضًا توضيحيًا.
الأسعار/الاختبارات المرجعية بحسب التقارير اعتبارًا من نوفمبر 2026؛ تحقق من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — تتغير مواصفات النماذج باستمرار.
لاحظ أن معظم الصفوف تجمع بين النموذجين كنموذج رئيسي وبديل طوارئ بدلاً من اختيار أحدهما حصريًا. هذا هو الهدف من التصميم: أنت لا تختار فائزًا، بل توزع أدوارًا يمكن التبديل بينها.
السياسة أعلاه تكون مفيدة فقط إذا كان تطبيقهما والتعديل عليها سهلاً وغير مكلف. توفر لك بوابة الذكاء الاصطناعي (AI gateway) ذات نقطة الوصول الموحدة والمستندة إلى API متوافق مع OpenAI ذلك بكل سهولة. يتصل تطبيقك باسم مستعار ثابت (alias)؛ بينما تقرر البوابة ما إذا كان الطلب يوجه إلى Terra، أم Flash، أم إلى نموذج رئيسي، وما يجب فعله عند حدوث خطأ.
نظرًا لأن كلا النموذجين يملكان أسماء مستعارة، فإن وصول GPT-6.2 أو Gemini 3.7، أو خفض الأسعار في أي منهما، يحتاج مجرد تعديل في الإعدادات. تتكيف سياسة التوجيه لديك؛ بينما يبقى تطبيقك دون تغيير.
لنأخذ منتج أدوات تطوير يرسل 4 ملايين طلب برمجة شهريًا لنماذج الفئة المتوسطة، مع الاعتماد بكثافة على الإخراج بمعدل 600 input token و 1,500 output token لكل طلب (إنشاء الكود ينتج الكثير من الـ tokens).
الإخراج هو المهيمن هنا، لذا فإن سعر الإخراج هو المعيار الأساسي. بسعر Terra المذكور $5 / 1M output، تكلف 1,500 output token لكل طلب حوالي $0.0075 لكل طلب للإخراج. وبسعر Flash المذكور $7.50 / 1M، يكلف نفس الطلب حوالي $0.01125 للإخراج، أي أكثر بنسبة 50% تقريبًا. وعلى مدار 4 ملايين طلب، يكون هذا الفارق كبيرًا جدًا.
ولكن تُظهر التقارير أن Flash يبرمج بشكل أفضل قليلاً ويعمل بسرعة أكبر. لذلك، لا تكون السياسة "Terra فقط". بل تكون: توجيه معظم عمليات الإنشاء الروتينية إلى Terra للاستفادة من ميزة سعر الإخراج، وتوجيه طلبات البرمجة الأكثر صعوبة أو الحساسة لزمن الاستجابة إلى Flash، واستخدام كل منهما كبديل طوارئ للآخر عند حدوث خطأ. ثم تراقب التكلفة والجودة لكل نموذج عبر أدوات قابلية الملاحظة (observability) وتقوم بضبط التوزيع. إذا استمرت جودة Terra في أداء مهامك، يمكنك الاعتماد عليه بشكل أكبر؛ وإذا ظهرت ميزة Flash البرمجية في تقليل عدد إعادة المحاولات، فإن ذلك يغير المعادلة. الطريقة الوحيدة لمعرفة ذلك هي القياس، ولهذا السبب يُعد التوجيه وقابلية الملاحظة نظامًا واحدًا وليس نظامين منفصلين.
تغير إعادة المحاولات هذه المعادلة بطريقة تخفيها جداول الأسعار المجردة. إذا كان إخراج Terra أرخص بنسبة 33% ولكنه ينتج إجابة خاطئة تتطلب استدعاءً ثانيًا بنسبة أكثر بـ 5% مقارنة بـ Flash، فإن معدل إعادة المحاولة هذا يلتهم جزءًا من ميزة السعر، لأن الطلب الذي تتم إعادة محاولته يدفع التكلفة مرتين. لهذا السبب تُعد مقارنة الأسعار الثابتة مضللة، ولهذا يجب عليك قياس التكلفة الفعلية لكل استجابة ناجحة، وليس التكلفة لكل استدعاء. فالنموذج الأرخص نظريًا والذي يحتاج إلى إعادة محاولات أكثر قد ينتهي به الأمر ليكون أكثر تكلفة في حركة المرور الحقيقية، والطريقة الوحيدة لرؤية ذلك هي من خلال قابلية الملاحظة لكل نموذج والتي تتبع كلاً من التكلفة ومعدل الفشل في طلباتك الخاصة.
ولمنع مسار التصعيد من تجاوز الميزانية دون ملاحظة، قم بتقييد فئة النماذج الرئيسية باستخدام تقييد معدل الـ tokens والميزانيات (token rate limiting and budgets) حتى يعيد التصعيد المفرط استجابة HTTP 429 بدلاً من فاتورة غير متوقعة.
إن GPT-6.1 Terra و Gemini 3.6 Flash ليسا في مواجهة ينتهي فيها الأمر بفائز واحد. بل هما نموذجان قويان ومتكافئان من الفئة المتوسطة، بفارق أسعار لا يتجاوز الثلث، وكلاهما يحمل سياقًا يبلغ ~1M، ولكل منهما ميزة بسيطة وفقًا للتقارير يفتقر إليها الآخر: Terra في السعر، و Flash في البرمجة والسرعة. عندما تكون النماذج متقاربة للغاية، فإن السؤال ليس أيهما تتوج، بل كيفية استخدام كلاهما.
قم بالتوجيه بينهما حسب المهمة والتكلفة، واعتمد على أحدهما كبديل طوارئ للآخر للحصول على استمرارية الخدمة مجانًا تقريبًا، ولا تقم بالتصعيد إلى النموذج الرئيسي إلا للمهام الصعبة فقط. قم بتطبيق كل ذلك كسياسة في بوابة (gateway) خلف API واحد متوافق مع OpenAI، وسيصبح أي إصدار جديد أو تخفيض في الأسعار من أي من المزودين مجرد تغيير في الإعدادات بدلاً من عملية نقل كاملة. هذه هي الطريقة التي تحصل بها على أفضل ما في النموذجين دون الرهان ببنيتك التحتية على أحدهما فقط.
قم بالتوجيه بين Terra و Flash بدلاً من اختيار أحدهما فقط. احجز عرضًا توضيحيًا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




