


نوفمبر 20, 2026
|
5 min read


احصل على وصول فوري إلى بيئة TrueFoundry مباشرة. انشر النماذج، ووجّه حركة مرور LLM، واستكشف المنصة بالكامل — بيئة الاختبار الخاصة بك جاهزة في ثوانٍ، ولا يلزم وجود بطاقة ائتمان.



Published: نوفمبر 20, 2026

Blazingly fast way to build, track and deploy your models!
لا تواجه معظم الفرق مشكلة في النماذج الرائدة، بل تواجه مشكلة في الإعداد الافتراضي. فالنموذج الذي يجيب على متوسط الطلبات، وهو النموذج الذي يتناول الحجم الأكبر من المحادثات والتلخيص والبرمجة اليومية وإجابات توليد المخرجات المُعزز بالاسترجاع (RAG)، هو المكان الذي تتراكم فيه الفاتورة فعليًا، لأن هذا هو مكان الحجم الأكبر للطلبات. يُعد Gemini 3.6 Flash مثيرًا للاهتمام تحديدًا لأنه مُصمم لهذا الموقع الافتراضي: فهو قادر بدرجة كافية تجعل المستخدمين لا يشعرون بتراجع في الجودة مقارنة بالنموذج الرائد، ورخيص بدرجة تكفي لتوجيه تدفق الطلبات الهائل إليه.
يتناول هذا المقال ماهية Gemini 3.6 Flash (وفقًا لما تم الإبلاغ عنه في نوفمبر 2026)، وموقعه بين النماذج الصغيرة فائقة انخفاض التكلفة والنماذج الرائدة، ومتى تختاره ومتى تتجنبه، ونمط البوابة (Gateway Pattern) الذي يتيح لك جعله خيارك الافتراضي مع الاستمرار في تصعيد الطلبات التي تحتاج حقًا إلى قدرات أعلى.
ملاحظة دقة مبدئية: باستثناء أرقام Claude، تأتي المواصفات أدناه من تقارير ومصادر خارجية قد تتضارب أحيانًا. تعامل معها كنقطة بداية وتأكد من صفحات الأسعار والنماذج الرسمية لشركة Google قبل الاعتماد عليها في البناء. تتغير مواصفات النماذج باستمرار.
هل ترغب في توجيه معظم حركة المرور إلى نموذج من فئة Flash وتصعيد الطلبات الصعبة فقط؟ احجز عرضًا توضيحيًا.
يُذكر أنه تم إصدار Gemini 3.6 Flash في يوليو 2026 تقريبًا كنموذج متوسط الفئة ومُحسّن للسرعة ضمن سلسلة Gemini 3.x من Google. المواصفات المُبلغ عنها:
الملخص في سطر واحد: نموذج يقدم لك معظم الفائدة اليومية للنموذج الرائد، بسعر متوسط الفئة، مع سياق من الفئة الرائدة وإنتاجية قوية. هذا المزيج هو بالضبط ما ينبغي أن يكون عليه النموذج الافتراضي.
الأسعار واختبارات الأداء هي بحسب ما تم الإبلاغ عنه حتى نوفمبر 2026؛ تحقق من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — تتغير مواصفات النماذج باستمرار.
إذا كان حسابك أو منطقتك الجغرافية لا تعرض 3.6 Flash بعد، فإن البديل الآمن والمتوفر عمومًا هو Gemini 3.5 Flash. تعامل مع 3.6 كهدف مستقبلي و3.5 المتوفر عمومًا كخيار آمن حتى تضمن توفر 3.6 لديك بشكل مباشر.
الطريقة العملية للتفكير في Flash هي اعتباره الدرجة الوسطى في سلم يتكون من ثلاث درجات. أسفله تقع الفئة فائقة انخفاض التكلفة، وأعلاه تقع النماذج الرائدة. ولكل درجة مهمة محددة.
الفئة فائقة انخفاض التكلفة (تقريبًا 0.10$ – 0.25$ للإدخال). Claude Haiku 5.5 مؤكد بسعر يبدأ من 0.10$ / 0.50$. وGPT-6 Luna المُبلغ عنه يقع عند 0.10$ / 0.50$ وGemini 3.1 Flash-Lite بالقرب من 0.25$ / 1.50$. هذه النماذج مخصصة للتصنيف، والاستخراج، والتوجيه، والمهام القصيرة الواضحة الأخرى. من حيث سعر الإدخال، فهي أرخص بحوالي 15 ضعفًا من Flash. وهي ليست بنفس القدرة، ولم تُصمم لتكونكذلك.
نموذج العمل من فئة Flash (تقريبًا 1$ – 2$ للإدخال). Gemini 3.6 Flash بسعر مُبلغ عنه 1.50$ / 7.50$، إلى جانب نظائر مثل Claude Sonnet 5.5 (مؤكد بسعر 2$ / 10$) وGPT-6.1 Terra المُبلغ عنه (1$ / 5$). هذه هي الفئة الافتراضية: المحادثات، التلخيص، إجابات RAG، البرمجة اليومية، وأي شيء يتطلب كفاءة حقيقية دون التفكير العميق المعقد.
الفئة الرائدة (تقريبًا 2$ – 10$ للإدخال، وسعر إخراج مرتفع). Gemini 3.1 Pro (مُبلغ عنه بسعر 2$ / 12$)، Claude Opus 5.5 (مؤكد بسعر 4$ / 20$)، وGPT-6 Astra المُبلغ عنه (10$ / 50$). هذه النماذج تستحق سعرها فقط في الجزء الصعب: البرمجة القائمة على الوكلاء (Agentic coding) ذات المدى الطويل، والاستنتاج والتفكير العميق، والتحليل المعقد.

الفكرة من هذا السلم هي أن كل درجة تبعد عن الأخرى بقدر أسّي تقريبًا إما في السعر أو في القدرة، لذا فإن نقل طلب إلى الدرجة الخاطئة يكون مكلفًا في اتجاه، ومنخفض الجودة في الاتجاه الآخر. نموذج Flash هو الدرجة التي تنتمي إليها معظم حركة المرور لديك.
نموذج Flash هو الخيار الافتراضي الصحيح، ولكنه ليس الحل المناسب لكل شيء. إليك معيار القرار.
الأسعار واختبارات الأداء بحسب ما تم الإبلاغ عنه حتى نوفمبر 2026؛ تحقق من صفحة الأسعار الرسمية لكل مزود قبل الاعتماد عليها — تتغير مواصفات النماذج باستمرار. أرقام Claude مؤكدة من المصدر.
تعرّف على كيفية اعتماد TrueFoundry للنماذج منخفضة التكلفة كخيار افتراضي والتحويل التلقائي للنماذج البديلة. احجز عرضًا توضيحيًا.
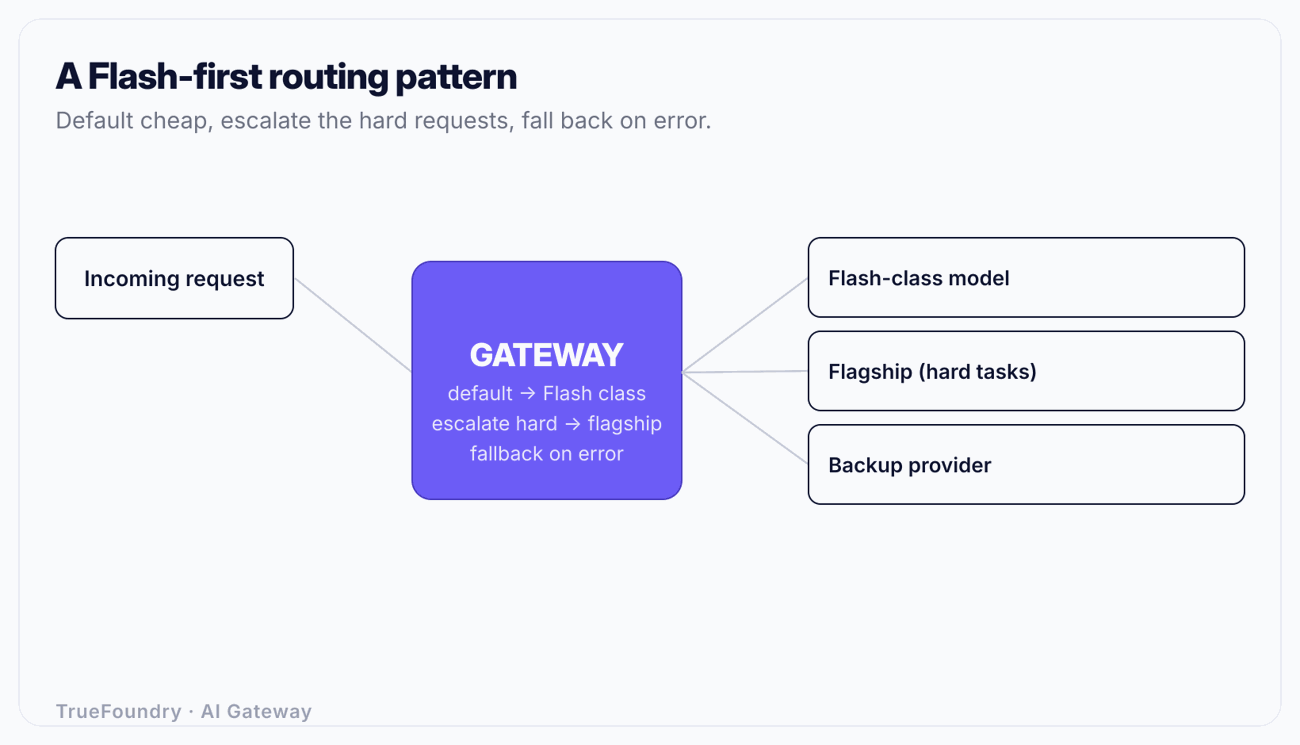
معرفة أن Flash يجب أن يكون خيارك الافتراضي لا تكفي وحدها. أنت بحاجة إلى آلية ترسل معظم حركة المرور إلى Flash، وتتعرف على الطلبات التي تحتاج إلى قدرات أعلى، وتصعّد تلك الطلبات فقط، ولا تفشل عندما تعاني Google من بطء مؤقت. هذه الآلية هي بوابة الذكاء الاصطناعي (AI Gateway) المتوافقة مع API الخاص بـ OpenAI.
إليك هذا النمط في أربع خطوات.
1. اجعل Flash المسار الافتراضي. وُجّه اسمًا مستعارًا للنموذج (مثل default-chat) إلى Gemini 3.6 Flash في تكوينات البوابة. يستدعي تطبيقك default-chat؛ ولا يكتب مطلقًا الكود البرمجي الثابت "gemini-3.6-flash". عندما تريد اختبار Sonnet 5.5 أو Terra كخيار افتراضي بدلاً منه، يمكنك تغيير سطر واحد في التكوين وتحويل نسبة من حركة المرور، دون الحاجة لنشر كود جديد للتطبيق (App deploy). هذا تطبيق عملي لـ اختيار النماذج الواعي بالتكلفة والجودة، والفيصل في هذه الفكرة هو ما يفعله موجه LLM (LLM Router).
2. تصعيد الطلبات الصعبة. ضع علامات (Tags) على الطلبات التي تحتاج إلى قدرات أكبر (إشارة تعقيد من تطبيقك، أو نقطة نهاية محددة Endpoint، أو إعادة محاولة بعد إجابة منخفضة الثقة) حتى تقوم البوابة بتوجيهها إلى اسم مستعار لنموذج رائد بدلاً من ذلك. يظل معظم حركة المرور على Flash؛ فقط الجزء الصعب هو ما يدفع أسعار النماذج الرائدة. قاعدة التوجيه هنا هي المعيار، وليست تفريعات كود مبعثرة عبر خدماتك.
3. التحويل التلقائي للبديل عند الخطأ (Fallback). قم بإعداد Flash للتحويل التلقائي إلى مزود ثانٍ عندما ترجع Google خطأً أو تتجاوز مهلة الانتظار. يمكن لطلب من فئة Flash التحويل إلى Claude Sonnet 5.5 أو GPT-6.1 Terra. إن إعادات المحاولة داخل الطلب والتحويل التلقائي بين المزودين يعنيان أن أي عطل لدى المزود يتحول إلى مجرد زيادة طفيفة في زمن الاستجابة (Latency) بدلاً من توقف كامل للخدمة. راجع ما هو التحويل التلقائي لنماذج LLM (LLM Fallback).
4. التخزين المؤقت والقياس. يمنعك التخزين المؤقت الدقيق والدلالي (Exact and semantic caching) من دفع تكلفة Flash للإجابة على السؤال نفسه مرتين؛ راجع التخزين المؤقت الدلالي (Semantic caching). ويتم تسجيل كل استدعاء مع تفاصيل الـ tokens، وزمن الاستجابة، والتكلفة المحددة حسب المستخدم والفريق والنموذج، حتى تتمكن من إثبات أن Flash يتحمل الحجم الأكبر وأن النموذج الرائد لا يلمس إلا الجزء الصعب فقط. راجع أدوات مراقبة ونموذج الاستجابة لنماذج LLM.
نفترض وجود منتج يعالج 5 ملايين طلب شهريًا، معظمها محادثات وRAG، مع جزء معقد يحتاج إلى استنتاج عميق. افترض أن التوزيع هو 75% مهام يومية (تناسب Flash)، و20% مهام بسيطة (تناسب الفئة فائقة انخفاض التكلفة)، و5% مهام صعبة (تناسب النماذج الرائدة)، بمتوسط 800 input tokens و400 output tokens لكل طلب.
إذا كان كل شيء يعمل على نموذج رائد بسعر 2$ / 12$، فستدفع سعر مخرجات النموذج الرائد على جميع الـ 5 ملايين طلب، بما في ذلك 3.75 مليون طلب كان بإمكان Flash الإجابة عليها بنفس الطريقة، و1 مليون طلب كان بإمكان نموذج بسعر 0.10$ الإجابة عليها بشكل مطبق.
التوجيه بحسب الفئة بدلاً من ذلك:
ينخفض شريحة المهام البسيطة (20%) بمقدار 15 ضعفًا تقريبًا في تكلفة الإدخال عبر ترك Flash واعتماد الفئة فائقة انخفاض التكلفة. وتنخفض شريحة المهام اليومية (75%) من سعر مخرجات النموذج الرائد (12$) إلى مخرجات Flash (7.50$)، وهو تخفيض يقارب 40% من مكون التكلفة الرئيسي. أما شريحة المهام الصعبة (5%) فتحتفظ بالنموذج الرائد. النتيجة الصافية في معظم مزيج الـ tokens الحقيقي هي خفض الفاتورة بنسبة تتجاوز الثلث، دون أي تراجع في الجودة على أي مستوى، لأن كل طلب يصل إلى النموذج المناسب لحجمه. لا يمكنك تأكيد الرقم إلا بقياس التكلفة لكل فئة، ولهذا السبب تكتسب أدوات المراقبة وإسناد التكاليف (Cost attribution) نفس أهمية التوجيه.
ولمنع الفئة الصعبة من التهام الميزانية بهدوء، ضع حدًا أقصى لها باستخدام تحديد معدل الـ tokens والميزانيات: حيث ترجع البوابة الخطأ HTTP 429 عندما يتجاوز الفريق أو النموذج حده الأقصى، حتى لا يتسبب مسار التصعيد في استنزاف نفقاتك.
تم تصميم Gemini 3.6 Flash للموقع الذي تقع فيه معظم نفقاتك فعليًا: متوسط الطلبات. مع أسعار مُبلغ عنها تبلغ 1.50$ / 7.50$ ونافذة سياق بحجم 1M ومعدل إنتاجية قوي، فإنه يوفر لك معظم الفائدة اليومية للنموذج الرائد دون أسعاره الباهظة، وهو بوضوح أعلى خطوة من الفئة فائقة انخفاض التكلفة التي ينبغي أن تظل مسؤولة عن مهامك البسيطة. النموذج الذهني الصحيح هو السلم، وFlash هو الدرجة التي تنتمي إليها معظم حركة المرور.
اجعله الخيار الافتراضي في البوابة، وصعّد الطلبات الصعبة فقط إلى النموذج الرائد، وقم بالتحويل التلقائي إلى مزود ثانٍ عند تعثر Google، وقس التكلفة لكل نموذج حتى تتمكن من إثبات نجاح هذا التقسيم. عند قيامك بذلك، يتوقف "استخدام Gemini 3.6 Flash" عن كون قرارًا فرديًا لمرة واحدة، ويتحول إلى سياسة توجيه يمكنك ضبطها في اللحظة التي يظهر فيها النموذج التالي أو يحدث الخفض التالى في الأسعار.
وجّه الطلبات إلى النموذج الأرخص والذي يمتلك كفاءة كافية. احجز عرضًا توضيحيًا.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





أحدث الأخبار والمقالات والموارد تصلك مباشرة إلى بريدك الوارد




