October 12, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
Grandes Modelos de Linguagem (LLMs) oferecem capacidades poderosas, mas também introduzem altos custos de infraestrutura, padrões de uso imprevisíveis e potencial para uso indevido. À medida que as empresas integram LLMs em ferramentas de atendimento ao cliente, copilotos internos e plataformas de API, a necessidade de acesso controlado e confiável torna-se crítica. É aqui que a limitação de taxa desempenha um papel fundamental.
No contexto da inferência de LLM, a limitação de taxa tradicional de requisições por segundo (RPS) não é suficiente. LLMs são intensivos em recursos, baseados em tokens e altamente variáveis em carga computacional. Um único prompt para um modelo de 70 bilhões de parâmetros pode consumir milhares de tokens e impactar significativamente a latência da GPU. Sem os controles adequados, a infraestrutura compartilhada pode rapidamente tornar-se instável ou proibitivamente cara.
Este artigo explica como a limitação de taxa funciona em um Gateway de IA, por que é essencial para infraestrutura de IA escalável, e como a TrueFoundry o habilita por padrão para garantir uso justo, eficiência de custos e desempenho de nível de produção em implantações multi-tenant.
A limitação de taxa é um mecanismo usado para controlar quantas requisições um cliente pode enviar a um sistema dentro de uma janela de tempo específica e é uma capacidade central dos modernos gateways de IA que gerenciam o tráfego de LLM. Ela garante justiça, previne sobrecarga e mantém a disponibilidade, especialmente em ambientes multiusuário. APIs tradicionais frequentemente aplicam limites simples como 100 requisições por minuto por usuário, o que funciona bem para serviços REST padrão.
No entanto, os LLMs operam de forma muito diferente. Cada requisição pode impor uma carga dramaticamente diferente à infraestrutura com base no tamanho da entrada, tipo de modelo e saída esperada. Por exemplo, um prompt de 20 tokens para um modelo de 7B pode ser concluído rapidamente, enquanto uma requisição de 2000 tokens para um modelo de 65B poderia bloquear GPUs por vários segundos. Mesmo duas requisições idênticas para modelos diferentes podem variar em 5x ou mais no custo computacional.
Isso torna os limites baseados em requisições insuficientes. Gateways de LLM modernos devem adotar a limitação de taxa ciente de tokens, que leva em consideração o número real de tokens processados e a carga computacional por chamada.
Fatores chave considerados na limitação de taxa ciente de tokens incluem:
Em comparação com limites de requisição fixos, limites cientes de tokens:
Em fluxos de trabalho de IA generativa, a limitação de taxa torna-se ainda mais crítica. Um único usuário pode acionar processamento de backend em larga escala através de prompts longos, ingestão de documentos ou agentes multi-etapas. Sem controles, isso pode levar a congestionamento de GPU, alta latência ou custos inesperados.
O uso no mundo real é frequentemente imprevisível, impulsionado por aplicativos front-end, loops de teste ou automação. A limitação de taxa garante que essas interações permaneçam estáveis e eficientes, mesmo quando a infraestrutura é compartilhada entre usuários ou locatários.
Para qualquer implantação de nível de produção, o melhor gateway LLM deve fornecer limitação de taxa inteligente como um requisito fundamental para escalabilidade, confiabilidade e controle de custos.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
A limitação de taxa é mais do que uma salvaguarda de backend. Para plataformas que servem LLMs — especialmente aquelas que oferecem APIs públicas ou multi-locatário — ela atua como uma camada estratégica para estabilidade, governança e alinhamento de negócios. Seja OpenAI, Anthropic ou plataformas construídas com TrueFoundry, os limites de taxa servem a vários propósitos críticos.
Proteger a infraestrutura contra abusos
A inferência de IA generativa é intensiva em recursos. Um pico repentino de prompts longos ou requisições concorrentes pode sobrecarregar as filas de GPU, aumentar a latência ou até mesmo derrubar serviços. Os limites de taxa garantem que o tráfego seja processado de forma controlada e priorizada, prevenindo o esgotamento de recursos.
Garantir a equidade entre usuários ou locatários
Em sistemas multiusuário, o uso de um cliente não deve degradar o desempenho para os outros. Os limites de taxa ajudam a impor o isolamento entre usuários, equipes ou chaves de API. Isso garante níveis de serviço consistentes, independentemente de quantos usuários estejam ativos simultaneamente.
Alinhar o uso com os planos de preços
Muitas plataformas de IA Generativa monetizam com base em tokens ou níveis de uso. Os limites de taxa ajudam a impor esses limites. Por exemplo:
Prevenir surpresas e estouros de custos
O uso de LLMs pode escalar de forma silenciosa e rápida. Sem limites adequados, o consumo de tokens e a utilização da GPU podem disparar. A limitação de taxa ajuda as plataformas a prevenir custos inesperados de infraestrutura e a manter o controle orçamentário.
Melhorar a confiabilidade e a experiência do usuário
Quando o uso é controlado, as filas do sistema permanecem estáveis. Isso resulta em menor latência, maiores taxas de sucesso e uma experiência de usuário mais consistente, especialmente importante em ambientes de produção com SLAs.
Em sistemas baseados em LLM, nem todas as requisições têm o mesmo impacto. Um prompt curto para um modelo pequeno pode usar recursos mínimos, enquanto uma consulta longa para um modelo grande pode consumir um tempo significativo de GPU. Devido a essa variabilidade, plataformas modernas aplicam limites de taxa em múltiplas dimensões, em vez de depender apenas da contagem de requisições.
Aqui estão as dimensões mais comuns usadas para uma limitação de taxa eficaz:
Usar essas dimensões dá às equipes de plataforma a flexibilidade para alinhar o uso de recursos com as restrições de infraestrutura, as necessidades dos usuários e as expectativas de nível de serviço.
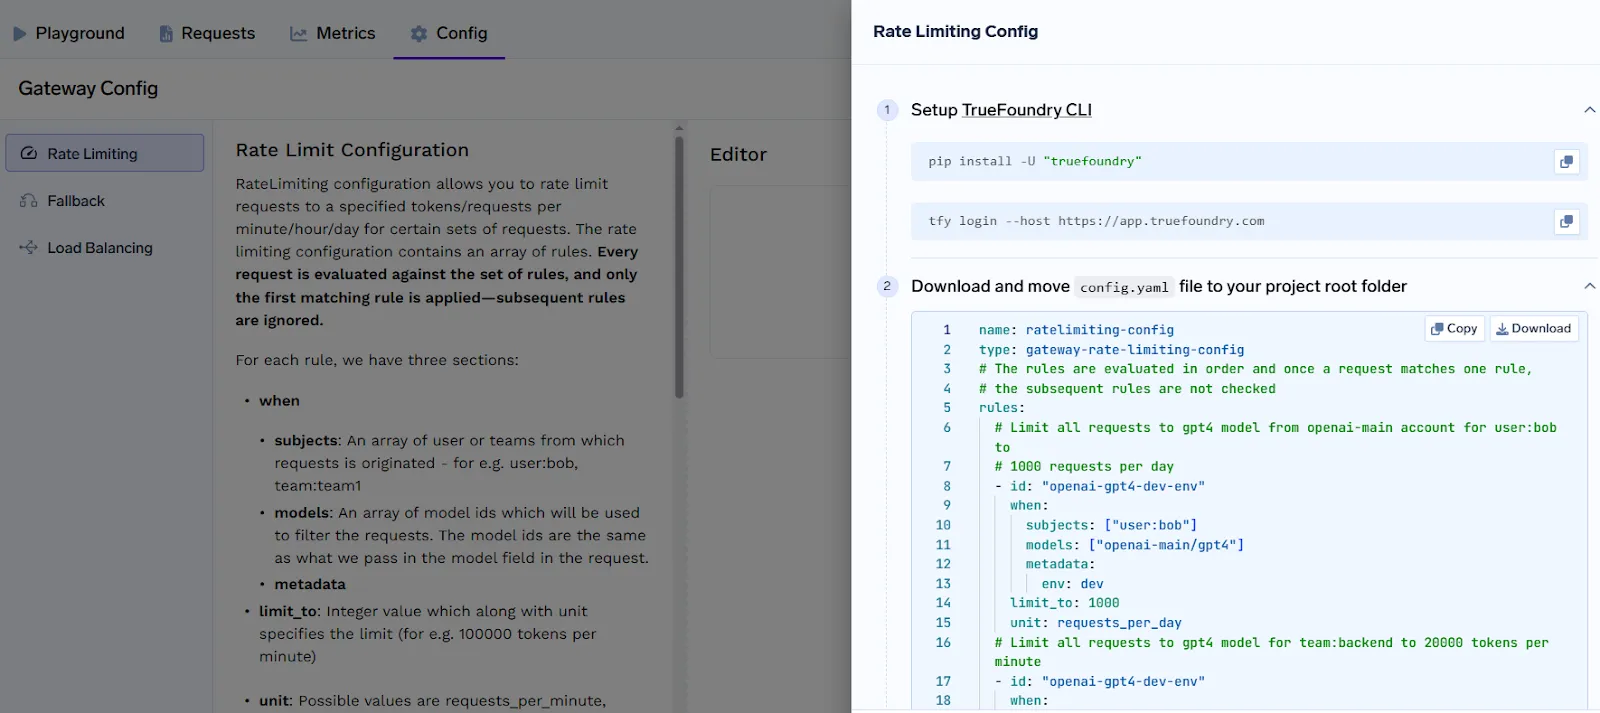
A TrueFoundry oferece um sistema de limitação de taxa robusto e flexível que permite às equipes de plataforma controlar o acesso a endpoints de LLM com base em requisições ou uso de tokens. Isso garante uma alocação justa de computação, previne abusos e alinha o uso com as políticas organizacionais ou planos de faturamento.
No centro do mecanismo de limitação de taxa da TrueFoundry está um sistema de configuração baseado em regras que permite às equipes definir políticas precisas para usuários, equipes, contas virtuais, modelos e metadados de requisição.
Configuração Baseada em Regras
A limitação de taxa no TrueFoundry é definida por meio de uma lista de regras, cada uma especificando:
As regras são avaliadas em ordem, portanto, regras mais específicas devem ser colocadas acima das mais abrangentes para garantir a correspondência correta.
Tipos de Limite Suportados
O TrueFoundry suporta limites baseados em requisições e em tokens em vários intervalos de tempo:
Isso permite a aplicação de políticas que refletem o uso real de computação, especialmente importante ao servir prompts de comprimento variável para modelos de diferentes tamanhos.
Casos de Uso Comuns
A flexibilidade do sistema de configuração suporta uma ampla gama de casos de uso:
Exemplo de Configuração
name: ratelimiting-config
type: gateway-rate-limiting-config
rules:
  - id: "specific-rule"
    when:
      subjects: ["user:bob@email.com"]
      models: ["openai-main/gpt4"]
    limit_to: 1000
    unit: requests_per_day
Este exemplo limita o uso do GPT-4 de um usuário específico a 1.000 requisições por dia. O sistema de limitação de taxa da TrueFoundry foi projetado para ser poderoso e fácil de gerenciar. Com controles sensíveis a tokens, direcionamento granular e políticas claras baseadas em YAML, as equipes podem escalar o uso de LLMs com confiança, mantendo o controle sobre a infraestrutura e os custos.
Como Aplicar a Configuração
1. Instale a CLI da TrueFoundry:
pip install -U "truefoundry"
tfy login --host https://app.truefoundry.com
2. Coloque seu config.yaml no diretório do seu projeto.
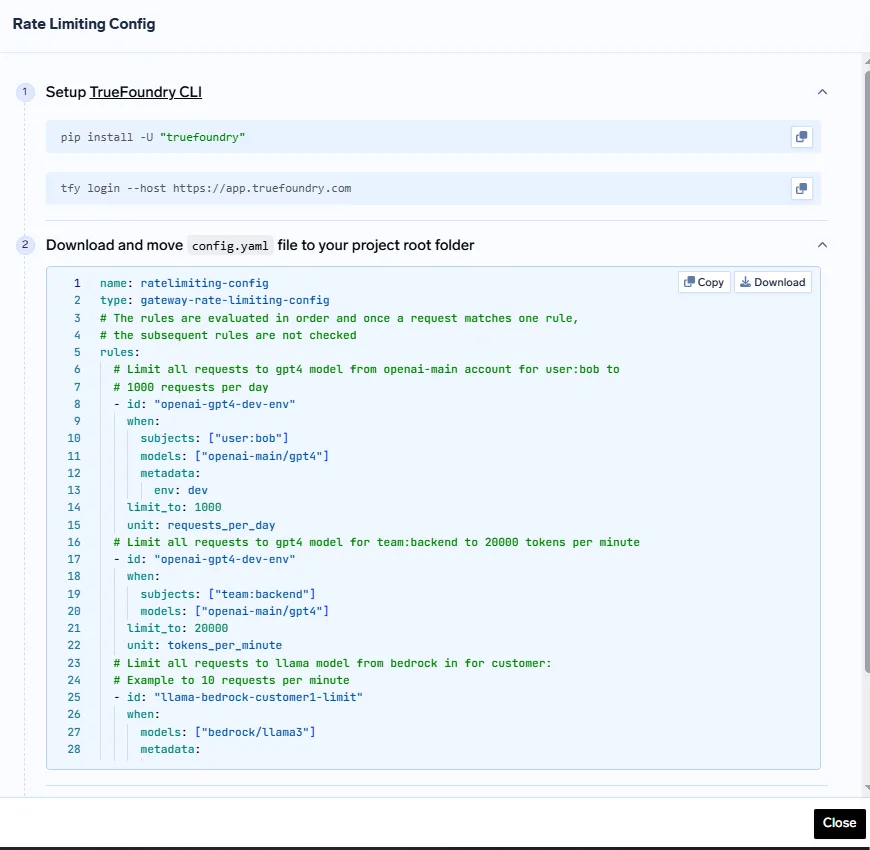
3. Aplique a configuração usando:
tfy apply -f config.yaml
Essa abordagem declarativa garante que os limites de taxa sejam versionados, reproduzíveis e alinhados com as melhores práticas de GitOps.
Feedback em Tempo Real sobre Limites de Taxa
O sistema de limitação de taxa da TrueFoundry foi projetado para fornecer feedback imediato e transparente aos clientes quando os limites são excedidos ou estão próximos do esgotamento. Isso ajuda os desenvolvedores a entender os limites de uso e a lidar com a limitação de forma elegante em suas aplicações.
Quando uma solicitação excede o limite de taxa definido:
Esse mecanismo de feedback suporta um melhor comportamento do cliente, permite lógica de nova tentativa automatizada e garante que o uso permaneça dentro dos limites de cota sem suposições.
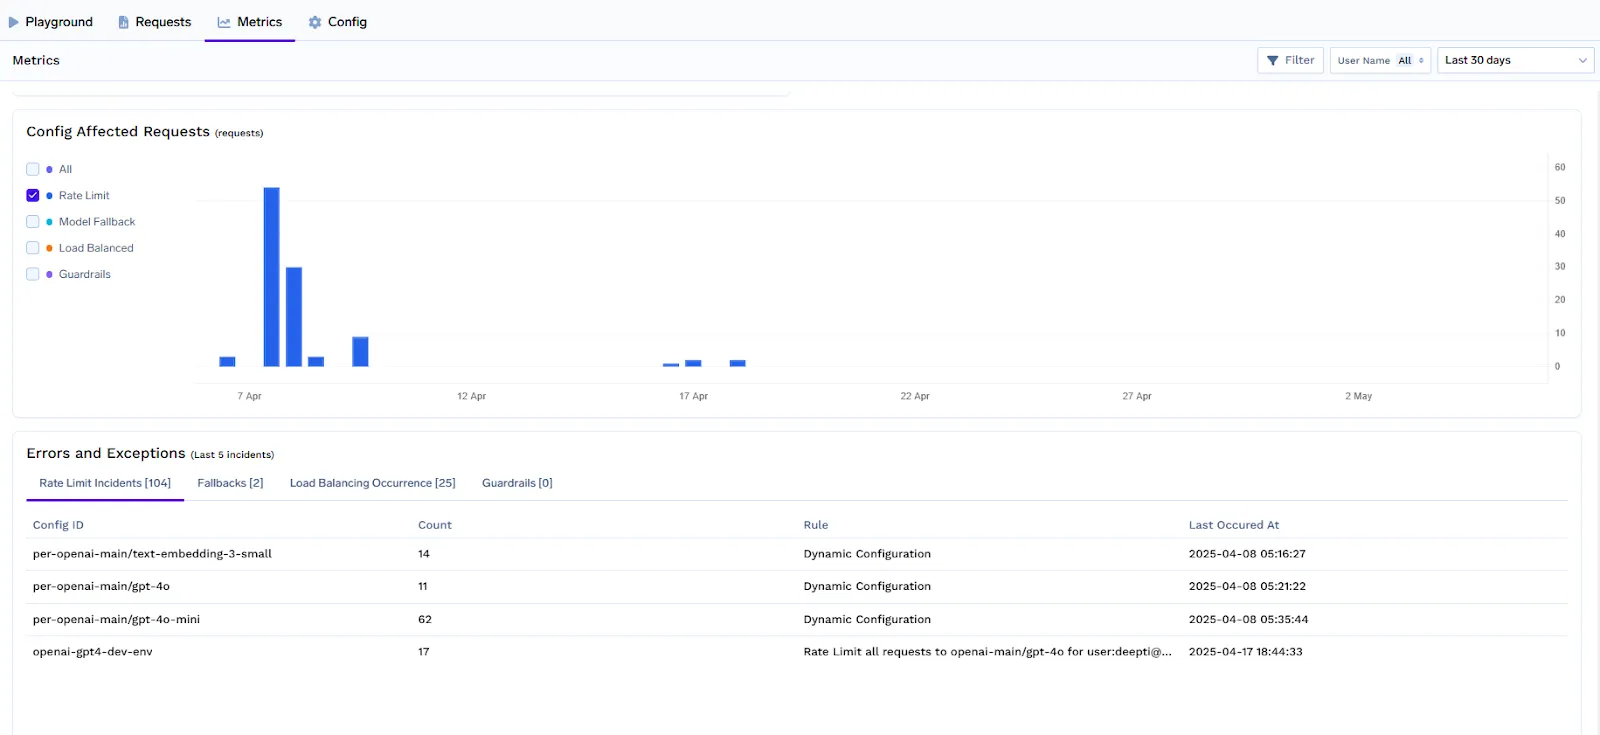
Painéis e Alertas
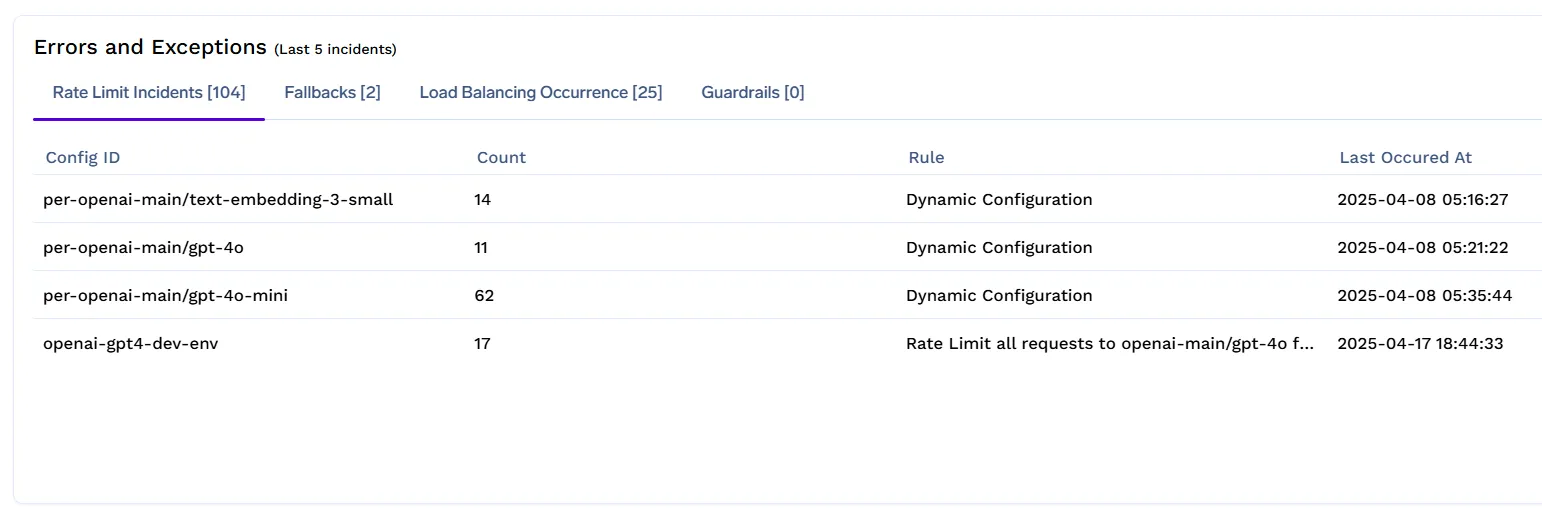
A TrueFoundry oferece observabilidade integrada para ajudar as equipes de plataforma a monitorar e otimizar as políticas de limite de taxa em tempo real.
Usando o painel do LLM Gateway, você pode rastrear:
Esses insights ajudam a detectar abusos, ajustar limites proativamente e garantir que usuários de alto valor recebam um serviço consistente.
Quando as APIs LLM falham, seja por limites de taxa, erros internos ou interrupções temporárias, os mecanismos de fallback mantêm suas aplicações funcionando sem problemas. Em vez de retornar erros ao usuário final, a TrueFoundry pode rotear automaticamente a solicitação para um modelo ou provedor de backup, mantendo a disponibilidade com interrupção mínima.
As regras de fallback são acionadas com base em condições específicas, como o ID do modelo, o usuário ou equipe solicitante e códigos de resposta como 429 ou 500. Quando uma solicitação atende a essas condições, ela é roteada para um ou mais modelos alternativos especificados na configuração de fallback. Esses alvos de fallback podem opcionalmente incluir substituições de parâmetros como temperatura ou tokens máximos, permitindo que o comportamento seja ajustado dependendo do provedor do modelo. Apenas a primeira regra correspondente é aplicada durante a avaliação, o que garante um tratamento previsível e determinístico de falhas.
Uma regra de fallback típica no TrueFoundry inclui os seguintes componentes:
Exemplo de Configuração de Fallback:
name: model-fallback-config
type: gateway-fallback-config
# As regras são avaliadas em ordem. Uma vez que uma solicitação corresponde a uma regra, as regras subsequentes não são verificadas.
rules:
  # Fallback para gpt-4 no Azure ou AWS se openai-main/gpt-4 falhar com 500 ou 503.
  # O alvo openai-main também substitui alguns parâmetros da solicitação, como temperatura e max_tokens.
  - id: "openai-gpt4-fallback"
    when:
      models: ["openai-main/gpt4"]
      response_status_codes: [500, 503]
    modelos_de_fallback:
      - alvo: openai-main/gpt-4
        parâmetros_de_sobreposição:
          temperature: 0.9
          max_tokens: 800
  # Recorrer ao LLaMA3 no Azure ou AWS se bedrock/llama3 falhar com 500 ou 429 para o cliente1.
  - id: "llama-bedrock-customer1-fallback"
    quando:
      modelos: ["bedrock/llama3"]
      metadata:
        customer-id: customer1
      códigos_de_status_de_resposta: [500, 429]
    modelos_de_fallback:
      - alvo: aws/llama3
      - alvo: azure/llama3
O LLM Gateway da TrueFoundry suporta nativamente a configuração declarativa de fallback como parte de seu sistema de configuração. Isso permite que as equipes definam políticas de roteamento tolerantes a falhas e preservem o tempo de atividade sem intervenção manual, especialmente ao trabalhar com múltiplos fornecedores. Juntos, o limite de taxa inteligente e o fallback automatizado criam a base para serviços de IA Generativa de alta disponibilidade.
Em qualquer plataforma de IA multi-tenant, o limite de taxa é crucial para garantir estabilidade, equidade e governança de custos. Ele permite que as equipes definam limites de acesso não apenas para usuários individuais, mas também entre equipes, contas virtuais e modelos específicos, sem a necessidade de lógica personalizada.
O Gateway da TrueFoundry suporta limite de taxa declarativo via configuração YAML, onde as regras são avaliadas em ordem. A primeira regra correspondente é aplicada, o que significa que regras mais específicas devem ser colocadas no topo, enquanto regras mais genéricas devem ser colocadas mais abaixo na configuração. Essa estrutura garante controle em camadas, mantendo configurações limpas e legíveis.
Cada regra pode incluir os seguintes componentes:
Exemplos de Limitação de Taxa Multi-Tenant
Limitar Requisição de Usuário Específico: Suponha que você queira limitar todas as requisições para o modelo gpt4 da conta openai-main para os usuários bob@email.com e jack@email.com a 1000 requisições por dia:
- id: "user-gpt4-limit"
  when:
    subjects: ["user:bob@email.com", "user:jack@email.com"]
    models: ["openai-main/gpt4"]
  limit_to: 1000
  unit: requests_per_day
Aplicar limites para toda a equipe: Se você quiser restringir o número total de requisições para a equipe 'frontend' a 5000 por dia
- id: "team-frontend-limit"
  quando:
    sujeitos: ["team:frontend"]
  limite_para: 5000
  unidade: solicitações_por_dia
Restringir contas virtuais: Se você quiser limitar o número de solicitações para a conta virtual 'va-james' em 1500 por dia
- id: "va-james-limit"
  quando:
    sujeitos: ["virtualaccount:va-james"]
  limite_para: 1500
  unidade: solicitações_por_dia
Definir limites globais para todos os usuários e modelos:
- id: "{user}-{model}-daily-limit"
  quando: {}
  limite_para: 1000000
  unidade: tokens_por_dia
Esta configuração permite que as equipes de plataforma segmentem o uso entre unidades de negócio, apliquem cotas por ambiente e protejam endpoints de modelos caros, enquanto suportam cargas de trabalho de IA escaláveis e confiáveis.
A limitação de taxa é mais do que um controle de backend. É um facilitador crítico para o uso confiável, econômico e justo da infraestrutura LLM em escala. Seja você operando uma plataforma multi-inquilino, oferecendo acesso em camadas aos clientes ou executando cargas de trabalho de IA internas entre equipes, implementar limites de taxa inteligentes e cientes de tokens garante que seu sistema permaneça previsível sob pressão.
Juntamente com a limitação de taxa, recursos como roteamento de fallback, feedback em tempo real e configuração granular dão às equipes de engenharia as ferramentas para equilibrar desempenho e controle. O LLM Gateway da TrueFoundry reúne essas capacidades com uma interface declarativa, permitindo que as equipes de plataforma definam políticas transparentes, auditáveis e alinhadas com os objetivos organizacionais.
À medida que a adoção da IA generativa acelera, sistemas que impõem controle de acesso inteligente sem sacrificar a experiência do usuário ou o tempo de atividade definirão a próxima geração de resiliência de infraestrutura. Se você está construindo ou escalando um gateway de IA, a limitação de taxa não é apenas algo a considerar. É algo a ser feito corretamente desde o primeiro dia.
A limitação de taxa em um gateway LLM refere-se ao mecanismo usado para controlar a frequência de solicitações de entrada ou o volume de tokens que um usuário, equipe ou aplicativo pode processar dentro de uma janela de tempo específica. Ao contrário da limitação de API tradicional, ela é sensível a tokens e considera a carga computacional real de diferentes arquiteturas de modelo, garantindo que consultas que exigem muitos recursos não travem o sistema.
A implementação de limitação de taxa em ambientes de gateway LLM ajuda a controlar custos, prevenindo picos inesperados de consumo de tokens e scripts descontrolados. Ao definir cotas diárias ou horárias granulares, as organizações podem limitar os gastos para usuários específicos ou ambientes não produtivos, garantindo que os experimentos de IA permaneçam dentro de um orçamento previsível, ao mesmo tempo em que protegem contra surpresas caras na fatura.
A limitação de taxa em configurações de gateway LLM é essencial para proteger a infraestrutura contra abusos e garantir alta disponibilidade para todos os usuários. Ela impede que um único "vizinho barulhento" esgote as cotas do provedor ou a capacidade da GPU, o que, de outra forma, levaria a um aumento da latência e a erros frequentes de 429 "Too Many Requests". Essa camada de gerenciamento é crítica para manter SLAs estáveis em produção.
Estratégias comuns para limitação de taxa em gateways LLM incluem limites de Requisições Por Minuto (RPM) e Tokens Por Minuto (TPM), que fornecem uma medida precisa do uso de recursos. Gateways avançados também suportam limites em camadas baseados em funções de usuário ou tipos de modelo, permitindo que tarefas de missão crítica recebam maior prioridade, enquanto cargas de trabalho de desenvolvimento de menor prioridade são limitadas durante períodos de congestionamento.
Embora adicione uma pequena etapa de processamento, a limitação de taxa em um gateway LLM geralmente introduz menos de 4 milissegundos de sobrecarga, o que é insignificante em comparação com os segundos necessários para a geração do modelo. Na verdade, ela frequentemente melhora a latência percebida, impedindo que as filas de backend fiquem saturadas, garantindo que as solicitações sejam processadas sem problemas e sem causar timeouts ou falhas de serviço.
Sim, a TrueFoundry oferece uma implementação de nível de produção de limitação de taxa em gateway LLM através de uma configuração declarativa e baseada em regras. Ela permite que as equipes apliquem limites sensíveis a tokens em vários provedores de modelo e locatários usando arquivos YAML simples. Este sistema fornece feedback em tempo real e painéis detalhados, permitindo que as equipes de plataforma escalem cargas de trabalho de IA, mantendo uma governança rigorosa de custos e recursos.
A limitação de taxa de IA funciona rastreando a frequência com que um usuário envia solicitações a uma API de IA. O sistema conta as solicitações ou tokens dentro de uma janela de tempo. Se o usuário exceder o limite permitido, a API bloqueia temporariamente novas solicitações ou retorna um erro até que o limite seja redefinido. Isso protege os servidores contra sobrecarga.
Com certeza. Ao limitar o uso de tokens e as taxas de solicitação, os gateways evitam o uso excessivo inesperado de GPU ou gastos na nuvem. As organizações podem alinhar o uso com os orçamentos, planejar o acesso em camadas e reduzir o provisionamento excessivo dispendioso, mantendo um serviço consistente para cargas de trabalho críticas.
Sim. Gateways de IA modernos, como o TrueFoundry, permitem que as equipes atualizem as regras de limite de taxa em tempo real ou por meio de scripts automatizados, garantindo que a infraestrutura possa lidar com picos inesperados sem tempo de inatividade ou desempenho degradado. Ajustes dinâmicos mantêm o serviço responsivo enquanto mantêm o uso justo entre os locatários.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada