



novembro 19, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.




Blazingly fast way to build, track and deploy your models!
Tudo começou com uma ideia: permitir que um agente de IA lide com uma tarefa de pesquisa de várias etapas. Conecte-o a algumas ferramentas via MCP, dê a ele acesso às fontes de dados corretas e deixe-o rodar.
O que realmente aconteceu foi mais instrutivo. O agente tinha mais acesso do que a tarefa exigia. Ele chamou ferramentas em sequências que ninguém previu e não havia logs para explicar o que ele tinha tocado ou por quê.
Esse mesmo token que fez a demonstração funcionar poderia ter apagado a unidade compartilhada da empresa se o modelo alucinasse ou encontrasse um prompt malicioso incorporado no documento que foi solicitado a ler.
Este é o desafio fundamental da segurança MCP. À medida que o Model Context Protocol se torna o padrão para conectar LLMs a ferramentas externas e bancos de dados, proteger essas conexões exige medidas de segurança rigorosas.
Este guia explica por que a segurança de API tradicional falha para agentes de ia, como são os verdadeiros vetores de ataque e o que Zero Trust significa neste contexto. Ele também detalha como algumas plataformas cobram um valor adicional por controles de segurança que deveriam ser padrão.
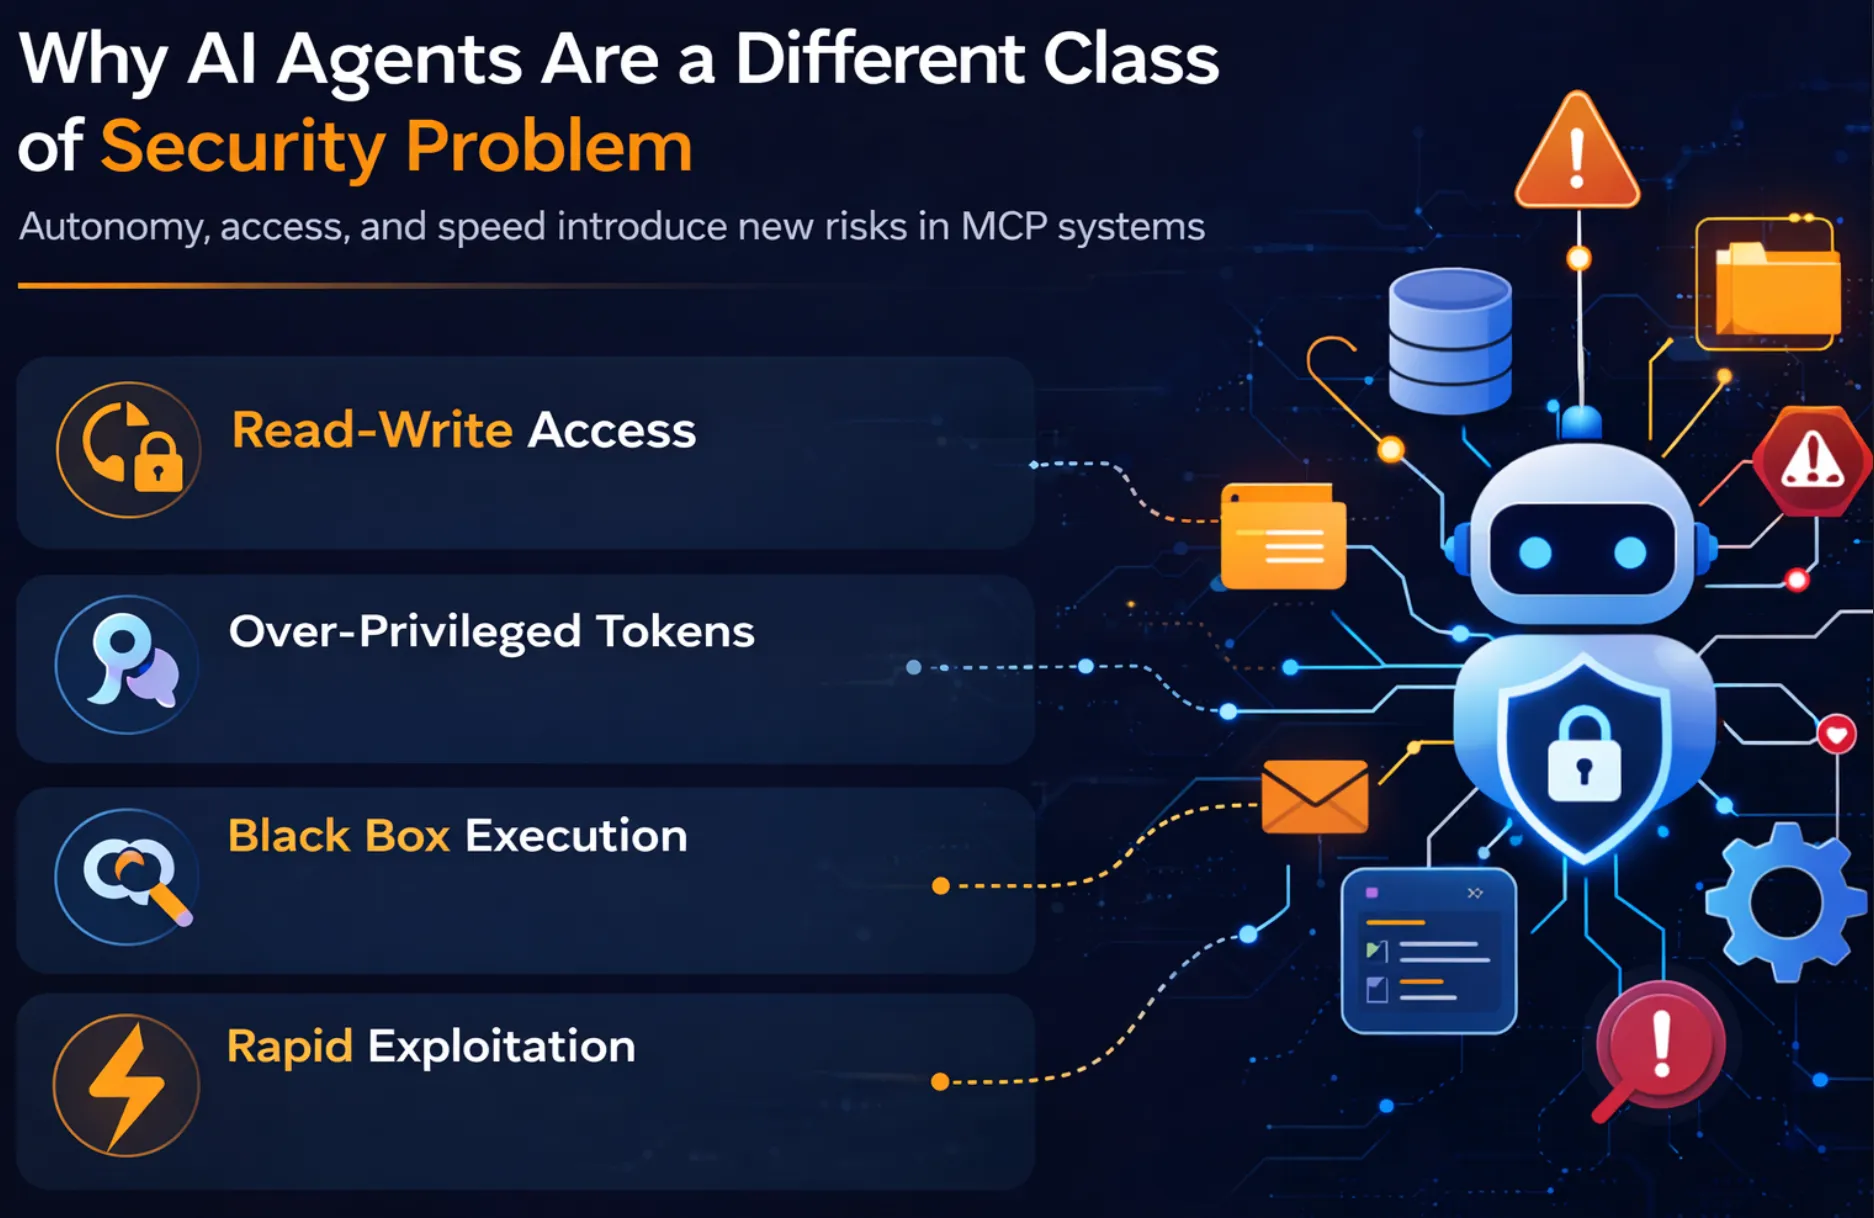
Diferente do software tradicional que executa fluxos de trabalho determinísticos, os agentes de IA tomam decisões dinâmicas sobre quais ferramentas MCP usar e como usá-las. Essa autonomia altera como o risco se propaga em ambientes MCP e introduz novas classes de exposição que impactam sua postura de segurança.
Os Agentes de IA representam um novo tipo de risco fundamentalmente diferente dos sistemas de software tradicionais. Sua combinação única de autonomia, acesso e velocidade cria riscos de segurança específicos, especialmente em sistemas baseados em MCP.
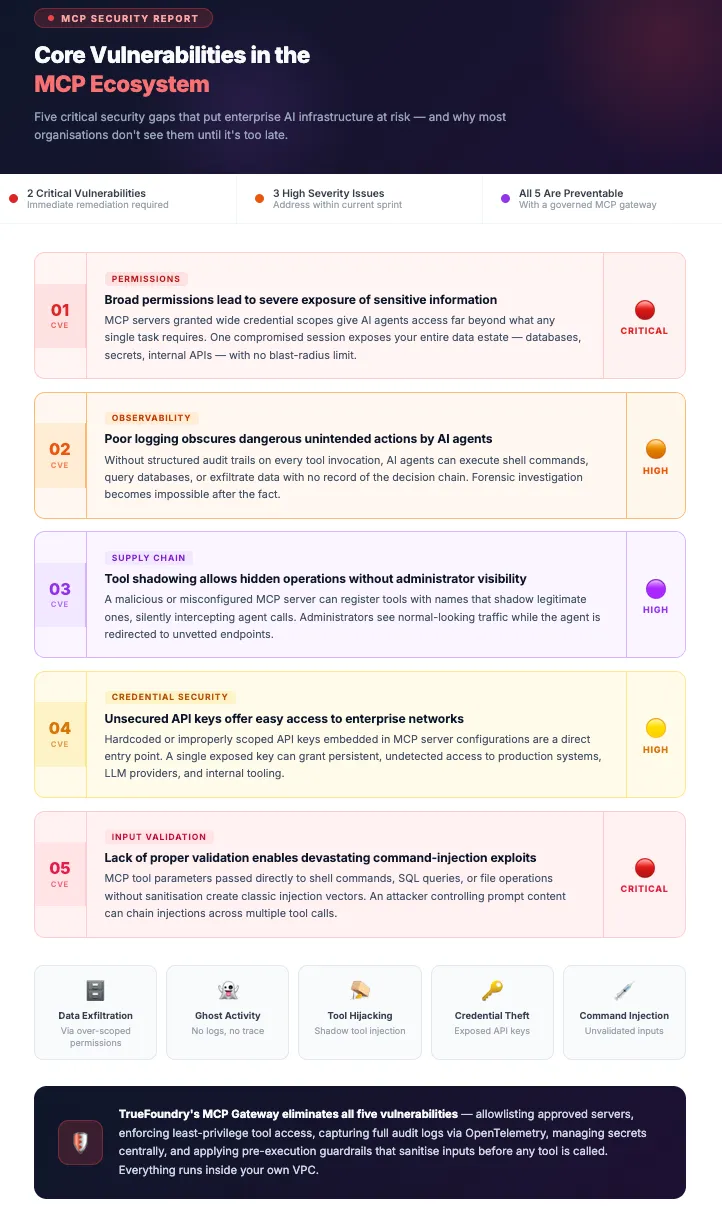
O Model Context Protocol possibilita a orquestração potente de ferramentas, mas também cria novas superfícies de ataque em prompts, metadados de ferramentas e fluxos de execução de agentes. Ao contrário das APIs tradicionais, os agentes interpretam instruções e metadados de forma dinâmica, o que torna a manipulação sutil muito mais perigosa.
As seções abaixo descrevem os principais vetores de ataque introduzidos por sistemas habilitados para MCP.
A injeção de prompt não é nova, mas o MCP a leva para uma escala mais ampla. Como o agente se conecta a ferramentas ao vivo, prompts maliciosos, mesmo dentro de conteúdo externo, podem disparar ações reais. O atacante inclui instruções maliciosas em um documento, página da web ou resposta de API que o agente processa.
O agente processa as instruções como legítimas e age de acordo com elas, sem saber que vêm de uma fonte maliciosa. Essa injeção indireta de prompt é uma ameaça severa às implementações de MCP.
Enquanto as equipes se concentram em proteger o uso de dados pelo agente, poucas se concentram em proteger a própria ferramenta. O envenenamento de ferramentas ocorre no nível em que o agente mais confia. O atacante manipula as descrições das ferramentas, schemas de parâmetros ou manifestos de ferramentas, fazendo com que o agente faça chamadas de função maliciosas disfarçadas de legítimas.
O agente confia nos metadados da ferramenta, e é aí que a exploração acontece, criando riscos significativos de segurança para a empresa.
O risco não é apenas a chamada de ferramenta maliciosa, mas o encadeamento dela. Os agentes encadeiam várias ferramentas para realizar uma determinada tarefa, onde a exfiltração de dados ocorre com permissões abertas.
Um agente com acesso direto aos dados internos de clientes e à funcionalidade de pesquisa na web externa pode ser explorado para resumir dados internos e transmiti-los por meio de consultas de pesquisa.
Não há necessidade de um comando específico de "enviar dados para fora"; o agente é explorado por meio de combinações legítimas de ferramentas, colocando em risco sistemas sensíveis.
A fronteira de confiança se expandiu com sistemas orquestrados de múltiplos agentes. Cada interação entre agentes é um ponto potencial para ataques de injeção, à medida que o contexto passa de um agente para outro.
Em sistemas onde os agentes passam informações, um cliente MCP upstream comprometido passa um contexto falso para o estado compartilhado.
O agente downstream trata o contexto comprometido como confiável e continua a propagação sem interação com o usuário original, corrompendo as operações de negócios.
Embora a higiene de credenciais seja um problema conhecido, os sistemas MCP introduzem novos pontos de pressão. A velocidade de prototipagem de agentes ultrapassa as práticas de segurança, e os tokens estáticos em arquivos de configuração se tornam vítimas.
Sistemas MCP frequentemente incluem credenciais de nuvem hardcoded em arquivos de configuração que se propagam para sistemas de controle de versão e ambientes.
Tokens estáticos sem rotação e sem escopo definido estão entre as falhas mais comumente documentadas na arquitetura MCP.
Os modelos convencionais de segurança de API dependem fortemente de defesas perimétricas e atores internos confiáveis. Agentes habilitados para MCP operam de forma diferente, invocando ferramentas dinamicamente e encadeando ações entre sistemas. Essa mudança exige um modelo de segurança Zero Trust no qual identidade, acesso e execução são continuamente verificados.
À medida que a adoção do MCP cresce, uma nova categoria de ferramentas surgiu para proteger o acesso dos agentes a ferramentas e dados. No entanto, muitos fornecedores empacotam recursos fundamentais de segurança como recursos premium, criando barreiras operacionais e de custo para equipes que implantam sistemas de IA em produção.
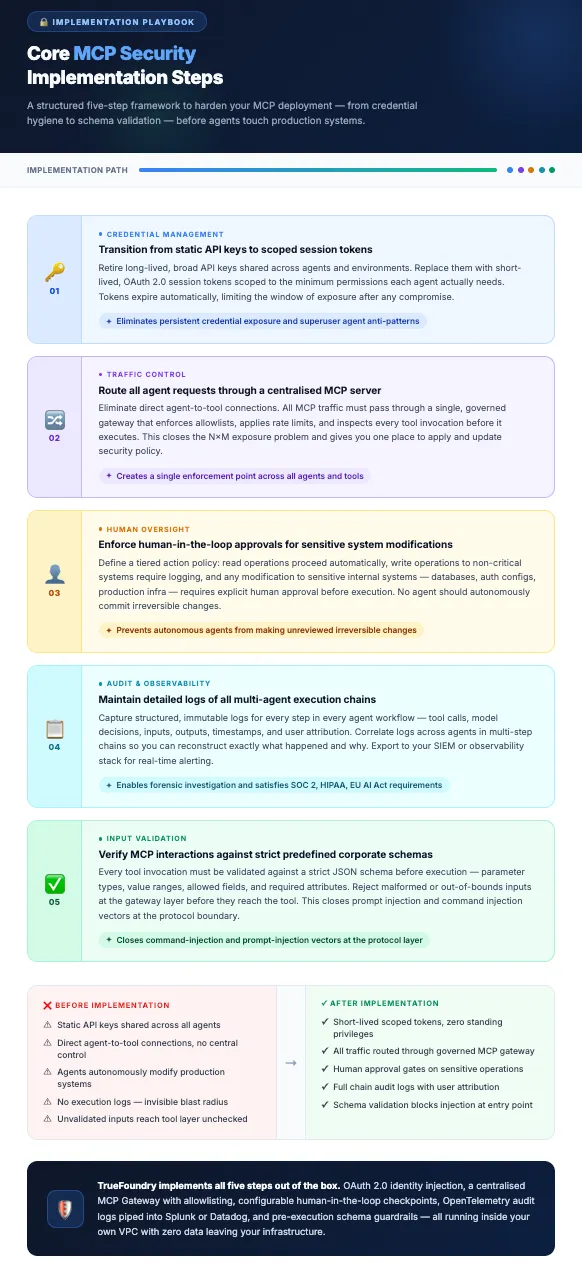
A TrueFoundry é uma plataforma de IA para empresas projetada para ajudar equipes de segurança a construir, implantar e operar sistemas de IA em produção com segurança. À medida que as organizações adotam agentes baseados em MCP, a TrueFoundry fornece a infraestrutura necessária para aplicar governança, identidade e controle de acesso entre as interações.
A plataforma incorpora a segurança MCP Zero Trust na camada de execução para que as equipes possam implantar agentes sem adicionar gateways de segurança separados ou complementos enterprise.
A taxa de adoção do MCP é tal que a maioria das equipes está operando sob pressão, e sob pressão, elas tomam atalhos. Uma demonstração funciona, o agente é funcional e a governança é um recurso a ser adicionado mais tarde, o que raramente vem de graça.
A questão é estrutural. Quando um agente pode fazer chamadas de forma autônoma entre sistemas internos e APIs externas, nenhuma quantidade de governança no nível de prompt pode mitigar um gateway que nunca foi projetado para tal realidade. Você não está apenas protegendo uma solicitação, está protegendo um processo de tomada de decisão que pode realizar dezenas de ações antes mesmo de um humano receber um resultado.
As equipes que se arrependerão de sua adoção do MCP não são as equipes que foram rápido demais. São as equipes que acreditam que sua pilha de segurança existente irá se adaptar e se ajustar sem mudanças significativas. Os API Gateways tradicionalmente não entendem schemas de ferramentas. Os modelos de autenticação tradicionalmente não foram projetados para cenários em nome do usuário (on-behalf-of) envolvendo agentes autônomos. E paywalls para empresas onde o controle de acesso básico baseado em funções é um recurso premium não são um modelo de segurança; são um modelo de receita.
Zero Trust para MCP não é uma caixa de seleção; é um compromisso. Cada chamada de ferramenta é verificada, cada ação do agente é registrada e cada permissão é baseada no usuário que iniciou o fluxo de trabalho. A diferença entre as equipes que acertam e aquelas que o fazem após uma violação é simplesmente se a governança foi uma parte central do gateway desde o primeiro dia. A TrueFoundry torna isso o padrão, não um recurso adicional.
A segurança MCP engloba mecanismos que governam como os agentes de IA acessam ferramentas usando o Model Context Protocol. Como o MCP permite o acesso dinâmico a ferramentas, a segurança deve ir além da proteção básica de API. Ela inclui propagação de identidade, validação de schema e trilhas de auditoria. A TrueFoundry oferece isso por meio de um gateway central que gerencia identidade, controles de segurança e logs de execução.
A segurança MCP apresenta riscos porque os agentes interagem dinamicamente com APIs. Os riscos de segurança incluem ataques de injeção de prompt, manipulação de schema de ferramentas e tokens de serviço superprivilegiados. Pipelines multi-agente podem propagar contexto comprometido entre sistemas sensíveis. Para mitigar essas ameaças, as chamadas de ferramentas devem ser validadas e permissões baseadas em identidade devem ser aplicadas. A TrueFoundry oferece um gateway seguro para governar essas interações.
O MCP é um protocolo neutro que padroniza como os modelos de IA interagem com ferramentas. Se é seguro ou não, depende das medidas de segurança aplicadas. Os agentes podem obter permissões elevadas e acessar bancos de dados privados. No entanto, ao fornecer uma infraestrutura de segurança robusta, como o gateway oferecido pela TrueFoundry, o protocolo pode ser implementado com segurança para evitar a exposição de recursos corporativos.
O Zero Trust pressupõe que nenhuma entidade é confiável. Para um Agente de IA usando MCP, isso significa que todas as chamadas de ferramentas devem ser autenticadas e validadas antes da execução para parar um servidor malicioso. Os agentes devem ser executados com os mesmos privilégios do usuário iniciador. A TrueFoundry aplica Zero Trust exigindo a propagação de identidade e monitorando todas as chamadas de ferramentas.
Um ataque de deputado confuso ocorre quando um Agente de IA com altos privilégios é enganado para realizar ações em nome de um ator malicioso, levando potencialmente a vazamentos de dados. Como o Agente de IA possui privilégios válidos, o sistema pode não detectar o ataque. Prevenir isso exige limitar o escopo dos privilégios do agente e validar os resultados das chamadas de ferramentas.
Os API gateways convencionais lidam com chamadas determinísticas onde os endpoints são conhecidos. Agentes baseados em MCP se comportam de maneira diferente; eles descobrem ferramentas e criam parâmetros dinamicamente. A segurança deve ser aplicada no nível do schema da ferramenta, não apenas no nível da rede, para bloquear código malicioso. A TrueFoundry estende os gateways tradicionais para atender às novas necessidades de segurança relacionadas ao MCP.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada

















